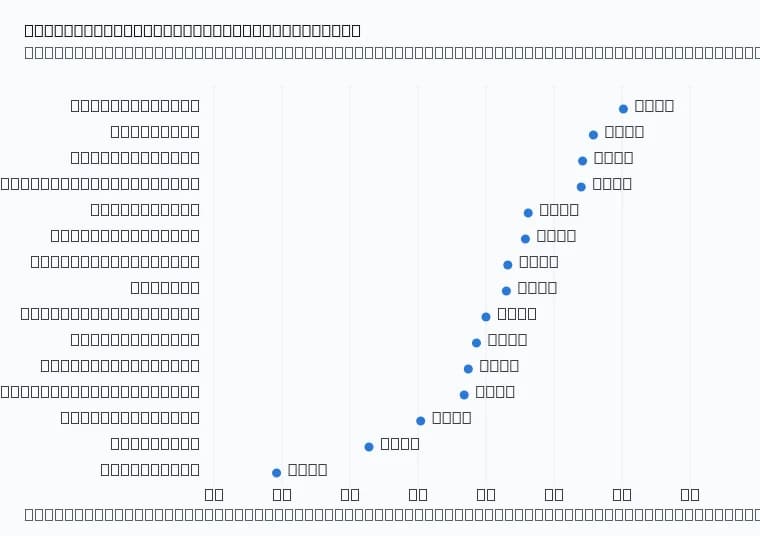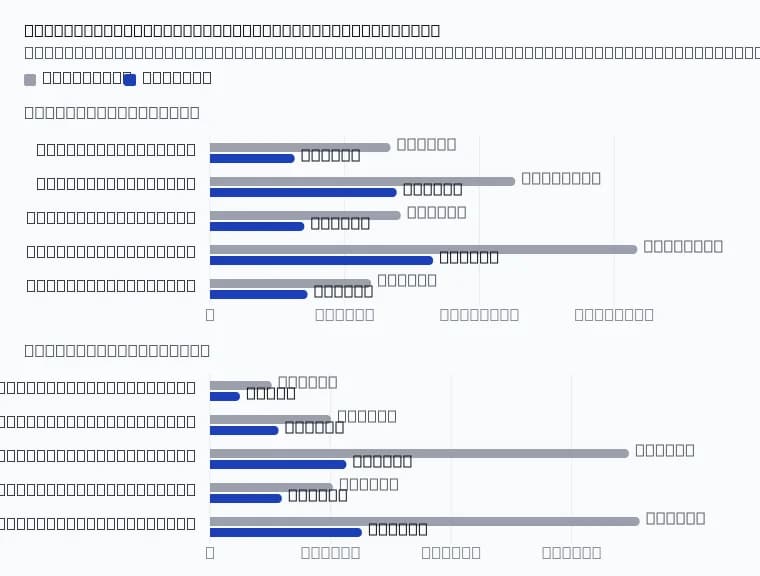
На этой неделе API Datalab стал работать быстрее в тех частях, которые не связаны с обработкой документов: прием ваших загрузок и ответы на запросы результатов. Медианное время отправки документа на /api/v1/marker составляет 314 мс против 670 мс на прошлой неделе. Проверка результата теперь занимает 62 мс вместо 128 мс. Для 1% самых медленных запросов проверки время сократилось с 869 мс до 283 мс.
Мы также выпустили Python SDK версии 0.9.1. Он проверяет наличие результата каждые 0,3 секунды в течение первых 8 секунд, поэтому обнаруживает готовую страницу быстрее.
Вам не нужно ничего менять, чтобы получить более быстрый API. Для более быстрого поллинга обновите SDK.
Что изменилось
Каждый вызов API к Datalab состоит из трех частей:
- Отправка. Вы загружаете файл и получаете ID запроса.
- Обработка. Мы парсим или извлекаем данные из документа.
- Проверка результата. Вы опрашиваете URL проверки запроса, пока результат не будет готов.
В этом посте рассматриваются части 1 и 3. Вот данные о времени на сервере из наших производственных трассировок запросов, сравнивающие периоды с 29 по 31 октября и с 3 по 6 ноября:
Это время измерено на наших серверах. Время загрузки через вашу собственную сеть добавляется к нему, поэтому большой файл при медленном соединении все равно отправляется дольше.
Мы также измерили все время ожидания вне процесса обработки для одностраничных задач — от момента принятия запроса до готовности результата, за вычетом времени обработки. Медианное значение снизилось с 1,30 с до 1,19 с. Время обработки одной страницы на этой неделе не изменилось. Мы отдельно рассматривали скорость моделей, в последний раз в посте о Chandra 2.6.
Почему это важно
Одна страница в быстром режиме готова за несколько секунд, поэтому секунда накладных расходов составляет значительную часть времени ожидания пользователя. Выигрыш суммируется в трех местах:
- Отправки. Каждая отправка возвращает ответ примерно на 350 мс быстрее. Если один воркер отправляет документы один за другим, это экономит около часа на каждые 10 000 документов.
- Проверки результатов. Проверка возвращает результат примерно в два раза быстрее в среднем, а медленные запросы перестали быть таковыми. Если ваш клиент опрашивает сотни запросов одновременно, он тратит меньше времени на ожидание ответа API.
- Интервал поллинга. Если вы опрашиваете раз в секунду, готовый результат ждет в среднем 0,5 с, прежде чем следующая проверка его увидит. При 0,3 с время ожидания составляет в среднем 0,15 с.
Как это использовать
Python SDK
Обновитесь до версии 0.9.1:
Вам не нужно менять код. Клиент проверяет статус каждые 0,3 секунды в течение первых 8 секунд запроса, а затем каждые poll_interval секунд (по умолчанию 1 секунда):
Бюджет времени остался прежним: время ожидания между проверками в сумме составляет max_polls * poll_interval секунд. Если вы установите poll_interval больше 1 секунды, например для долгих пакетных заданий, клиент пропускает быстрые проверки:
Мы увеличили лимит запросов на проверку результатов в три раза, поэтому команда, достигшая лимита запросов, может выполнять поллинг каждые 0,3 секунды без получения ответов 429.
Ваш собственный HTTP-клиент
Если вы вызываете API напрямую, начните с короткого интервала и постепенно увеличивайте его:
В руководстве по быстрому старту показан тот же запрос с использованием cURL и SDK.
Примеры использования
- Загрузка в вашем приложении. Пользователь перетаскивает отсканированную квитанцию и ждет появления полей. Благодаря более быстрой отправке, быстрым проверкам и опросу каждые 0,3 с в SDK 0.9.1 большую часть времени ожидания занимает сам парсинг.
- Агенты, читающие документы. Агент, который вызывает /extract один раз за страницу в цикле, тратит время на отправку и проверку на каждой странице. Медианное время отправки для /extract сократилось с 708 мс до 350 мс.
- Высокообъемные одностраничные задачи. Пайплайны, которые отправляют множество одностраничных изображений, таких как удостоверения личности, транспортные накладные или формы, тратят большую часть времени на отправку и проверку. Они получают наибольший относительный прирост.
Попробуйте
- Обновите SDK с помощью pip install -U datalab-python-sdk.
- Прочитайте документацию по API.
Если вы видите медленные ответы от API, отправьте письмо на [email protected] с указанием ID запроса, и мы изучим трассировку.