БЛОГ · БЕНЧМАРКИ
4 ноября 2026 г., авторы: Вик Паручури (Vik Paruchuri), Поль Семама (Paul Scemama), 9 минут чтения
Мы проверили 15 бенчмарков парсинга документов: прогнали семь открытых моделей через 13 бенчмарков с общедоступными данными, привлекли три модели-судьи для подсчета их реальных ошибок в каждом результате и выяснили, какие бенчмарки ранжируют модели в том же порядке, в каком идут их ошибки.
Если вы выбираете парсер документов, самое полезное, что вы можете сделать, — это самостоятельно запустить бенчмарк для тех парсеры, между которыми вы выбираете. Опубликованные лидерборды объединяют запуски с разными датами, настройками и людьми. Самостоятельный запуск оставляет один вопрос: дают ли данные бенчмарка, эталонные ответы (ground truth) и инструмент оценки честный результат?
Мы проверили это для 15 бенчмарков. Мы прогнали семь открытых моделей через 13 бенчмарков с общедоступными данными, привлекли три модели-судьи для подсчета реальных ошибок чтения в каждом выводе и проверили, ранжирует ли каждый бенчмарк модели в том же порядке, в котором располагаются их ошибки. LogicsDocBench и XDocParse держат свои тестовые данные в секрете, поэтому мы оцениваем их только по тем проверкам, которые не требуют запуска.
Мы создали OmniParseBench и продаем парсер, имейте это в виду, когда будете читать статью. Мы публикуем оценки, результаты работы судей для каждого бенчмарка, пробы ошибок и критерии оценки, чтобы вы могли проверить наши цифры (см. раздел «Данные»).
Краткий ответ
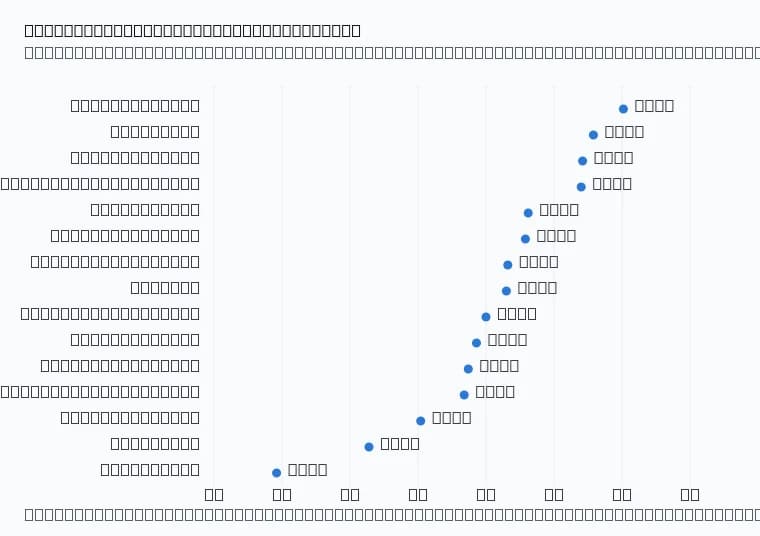
Как читать график:
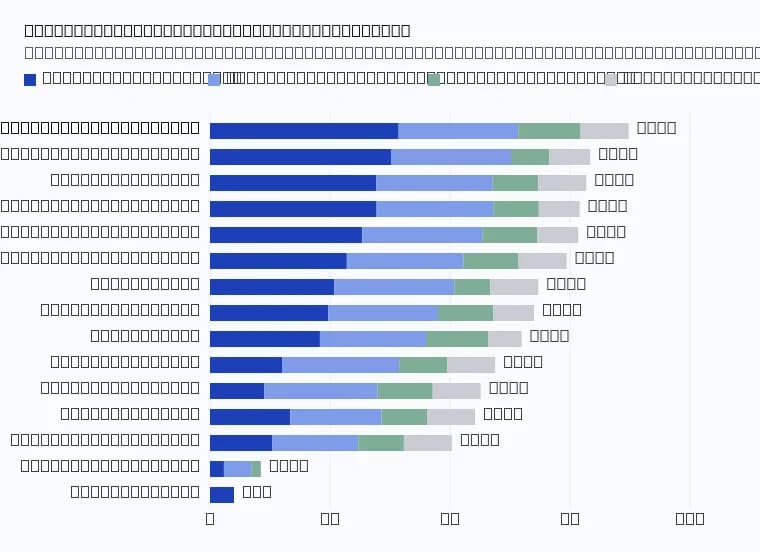
- Каждый бенчмарк получает до 100 баллов по четырем категориям за вычетом штрафов: правильное чтение (50), справедливость по отношению к каждому парсеру (25), возможность самостоятельного запуска (15) и разделение парсеров (10);
- Самый весомый отдельный показатель — это согласованность, которая оценивается в 25 баллов: доля из 21 пары наших семи моделей, которую бенчмарк располагает в том же порядке, что и подсчеты ошибок судьями (где 1,00 означает совпадение для каждой пары, а 0,50 — это подбрасывание монетки);
- Около половины бенчмарков ранжируют парсеры примерно правильно: для 7 из 13 протестированных нами бенчмарков нижняя граница 90%-го интервала согласованности (диапазон, в котором она остается при повторной выборке страниц) составляет не менее 0,70; и
- Места со 2 по 6 находятся в пределах 5 баллов друг от друга (от 74,3 до 79,2), а их интервалы согласованности пересекаются с интервалом OmniParseBench, поэтому первые шесть мест можно считать близкими по результатам.
Как мы проводили тестирование
Каждый общедоступный бенчмарк прошел через одни и те же этапы. Главный показатель бенчмарка — это основной результат, который он сообщает. Выберите шаг, чтобы просмотреть его.
Как мы ранжировали бенчмарки
выборка страниц: по 200 страниц из каждого из 13 общедоступных бенчмарков
7 открытых моделей парсят каждую страницу
7 результатов на страницу
оценка с помощью инструмента бенчмарка
ранжирование моделей
подсчет реальных ошибок по оценке 3 моделей + изображение страницы
ранжирование моделей
сравнение рейтингов
другие проверки
оценка по 100-балльной шкале
1 / 6
Ограничения:
- Семь моделей дают всего 21 пару, поэтому одна модель может сильно повлиять на показатель согласованности; и
- Судьи — это модели, а не люди, хотя они тесно согласованы друг с другом.
Мы зафиксировали критерии оценки до проведения любых вычислений, а затем внесли девять изменений, большинство из которых — после просмотра результатов. Два из них:
- Оценка от 134 до 200 страниц на бенчмарк вместо 60 изменила показатели согласованности шести бенчмарков на 0,14–0,24, поэтому мы используем все эти страницы и оцениваем согласованность по нижней границе ее интервала; и
- Формулы в Surya OCR 2 сначала получили оценки около нуля, что привело к исправлению разделителей математических формул на шаге 1.
В критериях оценки перечислено каждое изменение, причины его внесения, а также степень согласия судей друг с другом.
Результаты по бенчмаркам
В порядке ранжирования. На каждой вкладке указаны ранг бенчмарка, балл и согласованность с судьями, описание бенчмарка, наши выводы и рекомендации по его запуску.
Что мы выяснили:
- Реальные ошибки обходятся дорого: при 5% слов слова на неправильном языке снижают оценку на 14,0, опечатки — на 9,9, а неверные цифры — на 4,0;
- Выдуманный текст не стоит ничего;
- Судьи обнаружили, что 2,3% из 1 135 проверенных фактов неверны, причем 11 из них содержатся в тестах таблиц;
- 225 тестов текста проверяют текст в верхнем или нижнем колонтитуле, например «Страница 1 из 5», поэтому парсер, который удаляет колонтитулы, не проходит их, и мы не документируем это правило (около 1% от общего результата); и
- Наш прогон не включал тесты макета, которые проверяют тип каждого блока на странице и составляют треть от общего результата.
Если вы запускаете его:
- Сохраняйте верхние и нижние колонтитулы страниц.
1 / 14
Насколько бенчмарки согласены друг с другом
Два бенчмарка согласны друг с другом лишь немногим чаще, чем при подбрасывании монетки. Из 78 пар бенчмарков они располагают заданную пару моделей в одном и том же порядке примерно в 59% случаев (а при подбрасывании монетки получается 50%). Пять разных моделей занимают первое место как минимум в одном бенчмарке.
Расхождения обусловлены тремя факторами:
- Бенчмарки охватывают разные документы, поэтому часть расхождений реальна;
- Формат и соглашения: olmOCR-bench требует удаления колонтитулов страниц, а OmniParseBench — их сохранения, а в ParseBench диаграммы оцениваются только у тех моделей, которые преобразуют диаграммы в таблицы; и
- Модель каждого разработчика имеет тенденцию показывать лучшие результаты на собственном бенчмарке. Имея один или два бенчмарка на разработчика, мы не можем сказать, какая часть этого обусловлена соглашениями, а какая — настройкой (тюнингом).
Пять проверок, прежде чем доверять цифре
Каждая занимает несколько минут. В скобках указано то, что мы наблюдали во время наших прогонов.
- Оцените эталонные данные (ground truth) так, будто это результат работы парсера. Оценка должна быть близка к 100 (OmniDocBench v1.5 оценивает каждую формулу в 0 баллов без scikit-image);
- Сделайте 5% цифр неправильными. Оценка должна заметно снизиться (она падает на 0,1–0,4 из 100 в бенчмарках на основе расстояния редактирования);
- Напишите одну и ту же корректную таблицу в двух форматах, например в формате Markdown и HTML, либо в компактном HTML и HTML с красивым форматированием (pretty-printed). Оценка должна измениться менее чем на 1 из 100 (форматированный HTML снижает оценку таблиц в DP-Bench на 38 баллов);
- Исключите одну страницу. Оценка должна снизиться, либо инструмент оценки должен выдать предупреждение (оценка не падает в 7 из 13 бенчмарков, и лишь некоторые из них предупреждают об этом); и
- Сравните 20 неудачных результатов с изображением страницы. Большинство из них должны быть реальными ошибками (в OCRFlux-bench безобидное изменение формата сильнее влияет на оценку, чем реальные ошибки).
Проверка самих себя
Мы продаем парсер, поэтому у нас может возникнуть искушение занизить оценку бенчмарка, если наши продукты показывают на нем плохие результаты. Мы проверили это следующим образом:
- Мы взяли восемь бенчмарков, помимо нашего, в лидербордах которых представлены наши продукты;
- Для каждого из них мы сравнили место нашего лучшего продукта в лидерборде с оценкой этого бенчмарка в нашей статье;
- Если бы мы были предвзяты, бенчмарки, в которых мы занимаем низкие места, получили бы здесь низкие оценки.
Результат оказался противоположным: бенчмарки, в которых мы занимаем низкие места, имеют тенденцию получать здесь более высокие оценки (ранговая корреляция +0,66, где +1 означает полное совпадение двух порядков). При наличии всего восьми бенчмарков это все еще может быть случайностью: вероятность того, что такая сильная связь возникла случайно, составляет 8% (p = 0,08). Если включить OmniParseBench, связь становится намного слабее (+0,15).
Большая часть оценки формируется на основе прогонов, проб ошибок и подсчетов судей, которые не зависят от того, кто занимает первое место в лидерборде. Мы не можем исключать, что наши приоритеты отдают предпочтение бенчмаркам, которые похожи на наши продукты.
Данные
- Критерии оценки: каждое правило, формула и изменение;
- Оценки: баллы каждого бенчмарка за каждую проверку;
- Прогоны: оценка и ранг каждой модели в каждом бенчмарке, а также в olmOCR-bench с удаленными колонтитулами;
- Согласованность: пары каждого бенчмарка в правильном порядке и 90%-й интервал;
- Согласованность по моделям: средняя оценка страницы для каждой модели и среднее количество ошибок судей на страницу в каждом бенчмарке — две стороны, которые сравниваются при оценке согласованности;
- Проверки эталонных данных: элементы, проверенные факты и неверные факты в каждом бенчмарке (от одного до трех судей проверяли каждый элемент; мы используем среднее из трех значений или среднее из двух, поэтому некоторые значения заканчиваются на .5);
- Зонды ошибок и форматов: как меняется оценка каждого бенчмарка при добавлении ошибки или изменении формата; и
- Рейтинги: четыре оценки «вы можете это запустить» для каждого бенчмарка.