Chandra 2.6 доступна в Datalab API, и все режимы (быстрый, сбалансированный и точный) работают на ней. Вам не нужно ничего менять для ее использования, а цена осталась прежней.
Что нового:
- Точнее передовых моделей от Google, Anthropic и OpenAI. В тесте OmniParseBench точный режим Datalab набирает 94,1 балла против 92,7 у Gemini 3.8 Flash, 91,4 у GPT-6.1 Sol и 90,7 у Claude Opus 5.5.
- В 2,5 раза быстрее, чем Chandra OCR 2.4. На фиксированном наборе из 1187 страниц OmniParseBench среднее медианное время обработки страницы сократилось с 17,0 с до 6,7 с.
- Выше надежность. По нашим логам, доля сбоев запросов снизилась с 1 на каждые 6400 в Chandra 2.5 до 1 на 112 000, а медленные страницы стали появляться гораздо реже, чем в Chandra OCR 2.4.
Быстрее
Для честного сравнения релизов мы запустили каждый из них на тех же 1187 страницах OmniParseBench на одном и том же графическом процессоре:
Chandra 2.6 работает в 2,5 раза быстрее Chandra OCR 2.4 по медиане и на 37% быстрее Chandra 2.5. Это время работы модели на наших графических процессорах без учета загрузки и постановки в очередь, включая сегодняшнее обновление сервиса.
Пользователи API также видят изменения. На 200 страницах OmniParseBench, которые мы используем для проверки задержки бенчмарка и которые отправлялись через API по 8 штук за раз, медианное время обработки страницы сократилось с 9,6 с для Chandra 2.5 до 6,0 с в сбалансированном режиме и с 14,8 с до 11,4 с в точном режиме.
В продакшене для одних и тех же клиентов во всех периодах медианное время ожидания одной страницы от начала до конца составило:
Тест задержки API: те же 200 страниц и настройки от 9 октября (Chandra 2.5) и сегодня, после обновления сервиса (Chandra 2.6). Фиксированные страницы: те же 1187 страниц, среднее значение по нескольким запускам для каждого релиза. Продакшен: одностраничные запросы API от начала до конца для одних и тех же клиентов за каждый период. Chandra OCR 2.4: с 30 сентября по 6 октября 2026 г. Chandra 2.5: с 15 по 23 октября. Chandra 2.6: с 23 по 27 октября.
Более надежная работа
Меньше сбоев в запросах и меньше медленных страниц.
В наших логах 1 из 6400 одностраничных запросов API завершался ошибкой в последние дни работы Chandra 2.5. После релиза Chandra 2.6 этот показатель снизился до 1 на 112 000, причем каждая ошибка была связана с входным изображением, которое не удалось открыть.
Медленные страницы стали попадаться реже. На фиксированных страницах показатель p90 снизился с 33,3 с у Chandra OCR 2.4 до 14,1 с. В продакшене показатель p90 ниже на 68% в сбалансированном режиме и на 77% в точном режиме.
Одностраничные запросы /convert и /marker. Chandra 2.5: с 21 по 23 октября 2026 г. Chandra 2.6: с 23 по 27 октября.
Выше точность
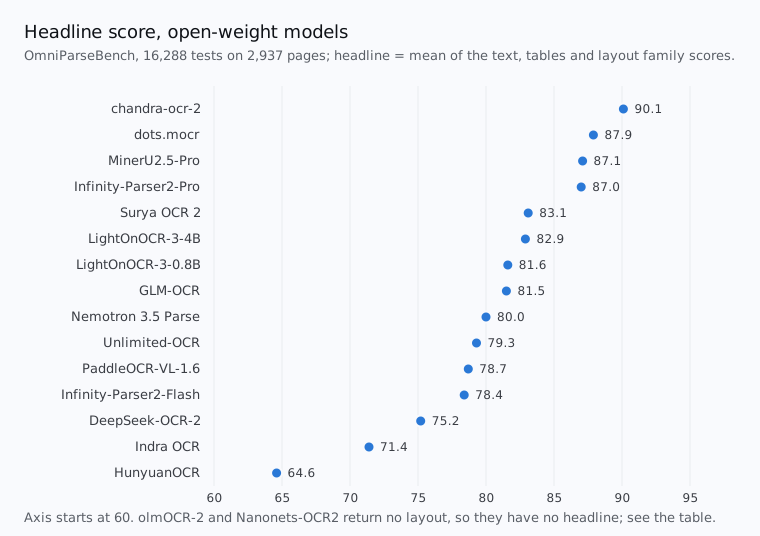
Chandra 2.6 занимает первое место в опубликованных результатах OmniParseBench, опережая передовые модели от Google, Anthropic и OpenAI. OmniParseBench — это наш открытый бенчмарк синтаксического анализа, включающий 16 288 тестов на прохождение/сбой на 2937 страницах на 92 языках. Точный режим Datalab набирает 94,1 балла против 92,7 у Chandra 2.5, опережая Gemini 3.8 Flash с ее 92,7 баллами. Сбалансированный режим Datalab набирает 92,6 балла по сравнению с 91,6 ранее, что также выше результатов GPT-6.1 Sol (91,4) и Claude Opus 5.5 (90,7).
На сложных страницах точный режим набирает больше баллов, чем Gemini 3.8 Flash, в тестах с таблицами (95,6 против 93,8), многоколоночными страницами (94,9 против 92,3), повернутыми страницами (95,1 против 92,5) и ухудшенными сканами (89,7 против 85,4).
* Использовалось при создании и проверке по крайней мере некоторых тестов. Оценки Datalab представляют собой повторный запуск продакшен-API от 23 октября 2026 года на тех же 16 288 тестах. † Наши запуски от 27 октября 2026 года со стандартным адаптером модели бенчмарка. Страницы, которые модель отказалась обрабатывать, засчитываются как сбои в ее общем балле. Баллы по категориям охватывают страницы, которые она успешно обработала. Полные результаты, включая все сложные срезы, представлены в разделе результаты OmniParseBench.
Та же цена
Цена остается прежней: быстрый и сбалансированный режимы стоят 4 доллара за 1000 страниц, а точный — 10 долларов. См. тарифы.
Попробуйте
Chandra 2.6 доступна в API и песочнице. Для локальных развертываний (on-premises) свяжитесь с нами по адресу [email protected].
Если у вас есть сложные документы, которые вы хотите протестировать, отправьте их нам на [email protected] или найдите меня в Twitter.