Если вы разбираете документы для поиска или RAG, вы обрабатываете каждую проиндексированную страницу. API разметки от Azure, Google и AWS берут за это от $5 до $15 за 1 000 страниц, поэтому архив на 10 миллионов страниц обойдется в сумму от $50 000 до $150 000 за разовый разбор.
Упрощенный режим Datalab стоит $0.50 за 1 000 страниц. Архив на 10 миллионов страниц обойдется в $5 000. Каждая страница возвращается со своим текстом, таблицами, заголовками, списками и порядком чтения, а также с рамкой разметки для каждого блока.
По сравнению с API разметки от Azure, lite-режим работает следующим образом:
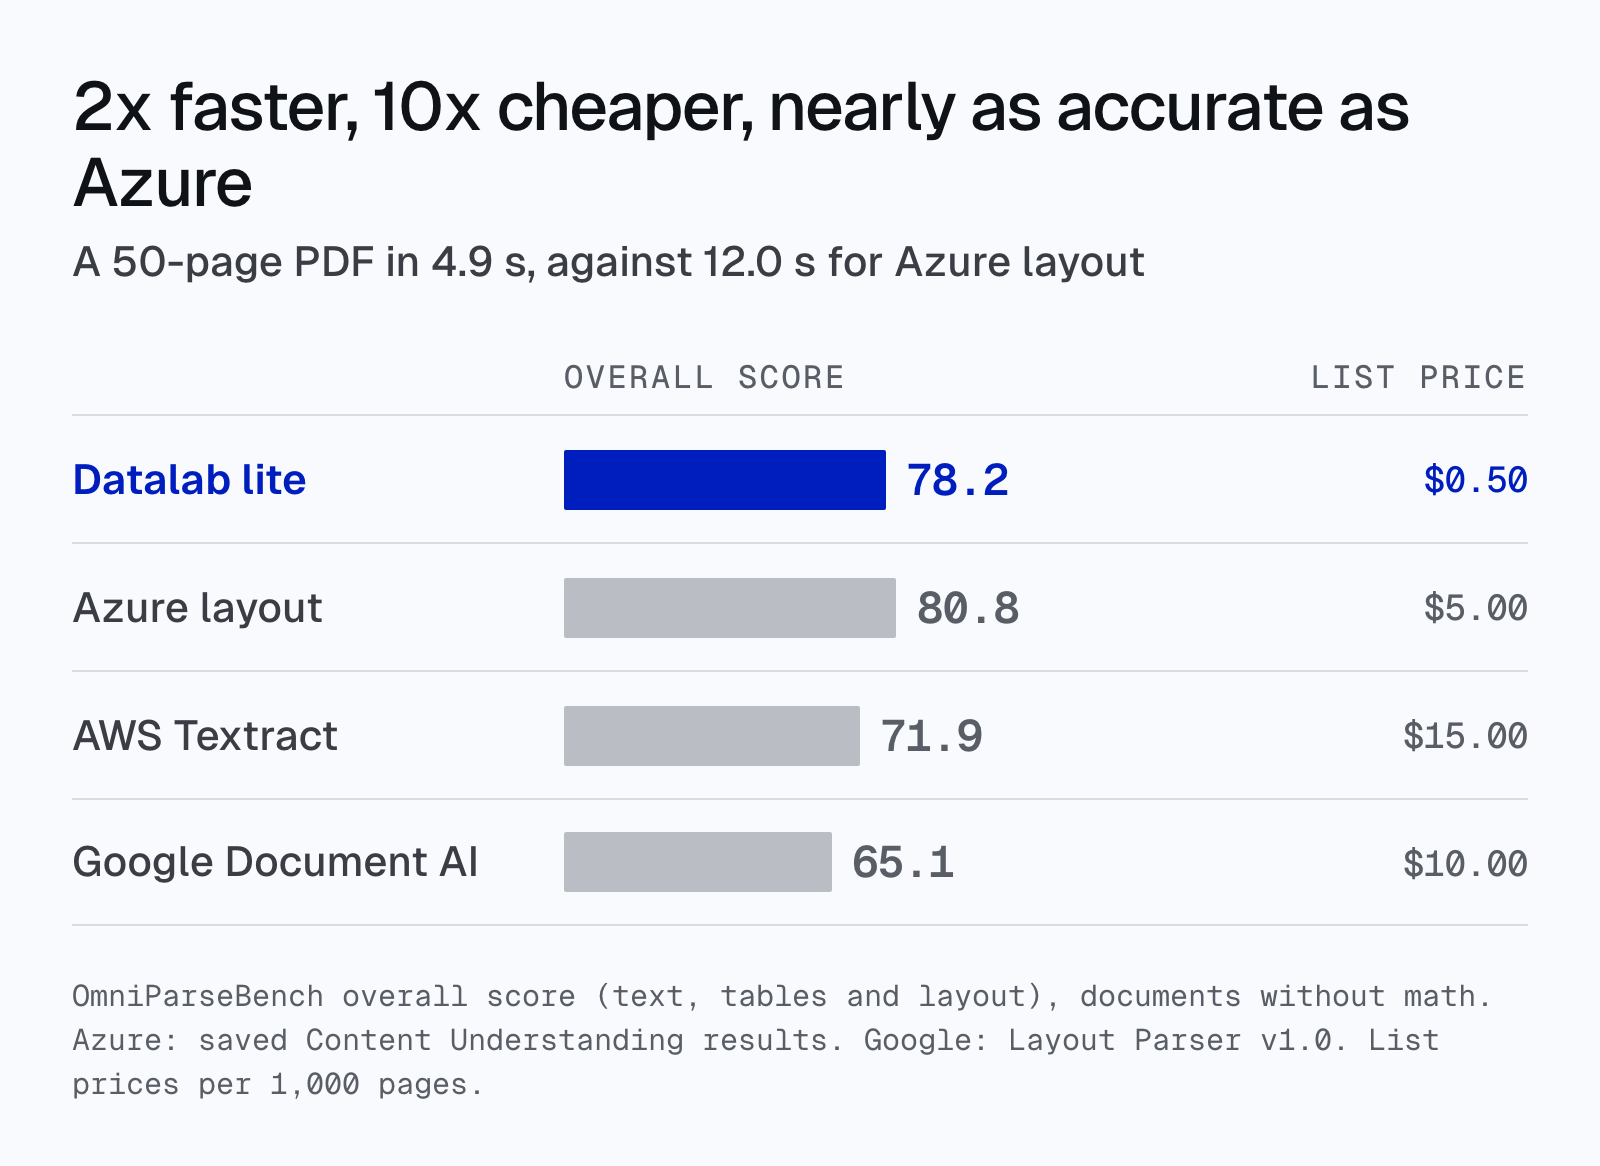
- В 2 раза быстрее на длинных документах. 50-страничный PDF обрабатывается за 4,9 секунды по сравнению с 12,0 секундами у Azure.
- В 10 раз дешевле, а также в 20–30 раз дешевле Google Document AI и AWS Textract.
- Практически такая же точность: 78,2 в общем зачете против 80,8 у Azure. Lite набирает больше баллов, чем Textract (71,9) и Google (65,1).
Бесплатный тариф включает до 40 000 lite-страниц в месяц при регистрации на рабочий email. Карта не требуется.
Что вы получаете на выходе
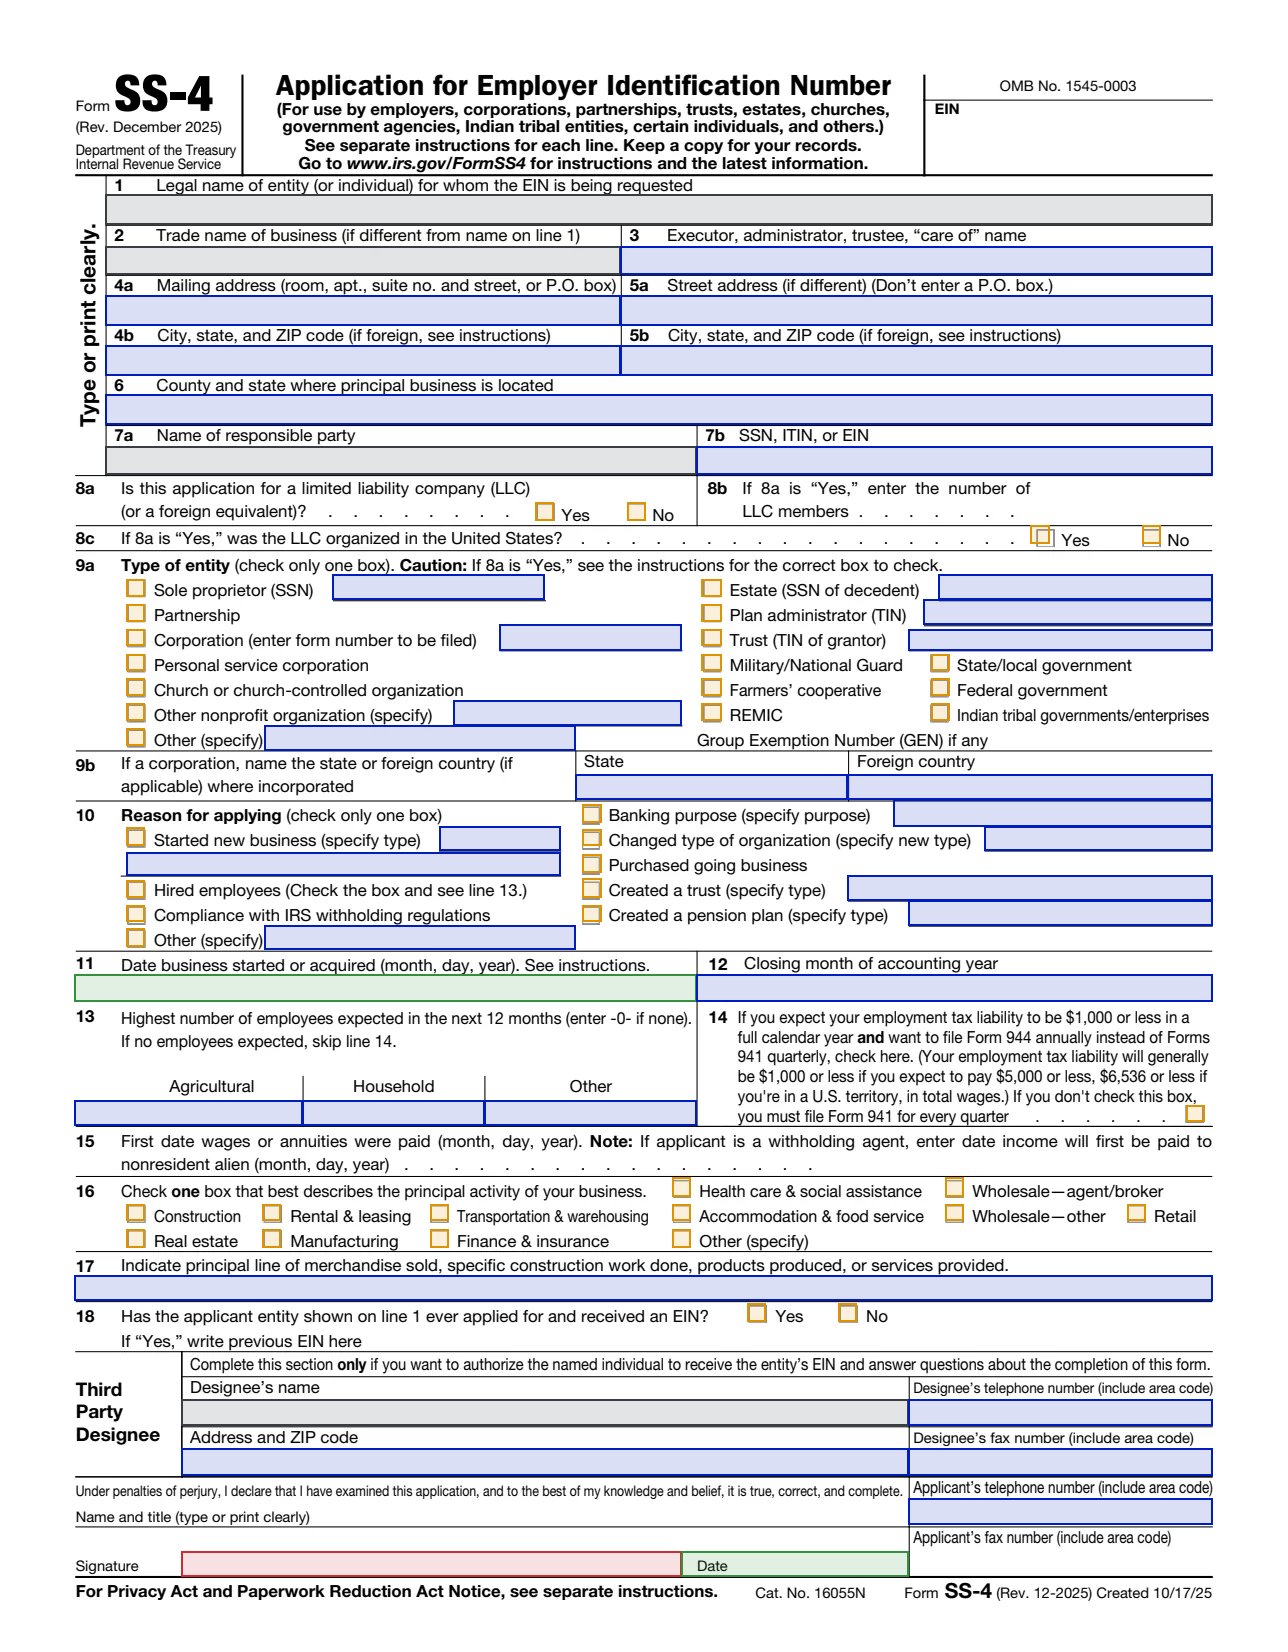
Lite размечает каждый блок на странице: заголовки, абзацы, списки, таблицы, верхние и нижние колонтитулы. У каждого блока есть рамка разметки, и блоки возвращаются в порядке чтения. Таблицы сохраняют свои строки и столбцы. Один запрос может возвращать markdown, JSON и чанки для извлечения.
Вот какой результат выдает lite на странице из годового отчета Berkshire Hathaway:
С помощью рамок вы можете связать ответ с конкретным местом на странице, откуда он взят. Поскольку таблица сохраняет свою структуру, конвейер RAG может извлекать строку вместе с заголовками ее столбцов.
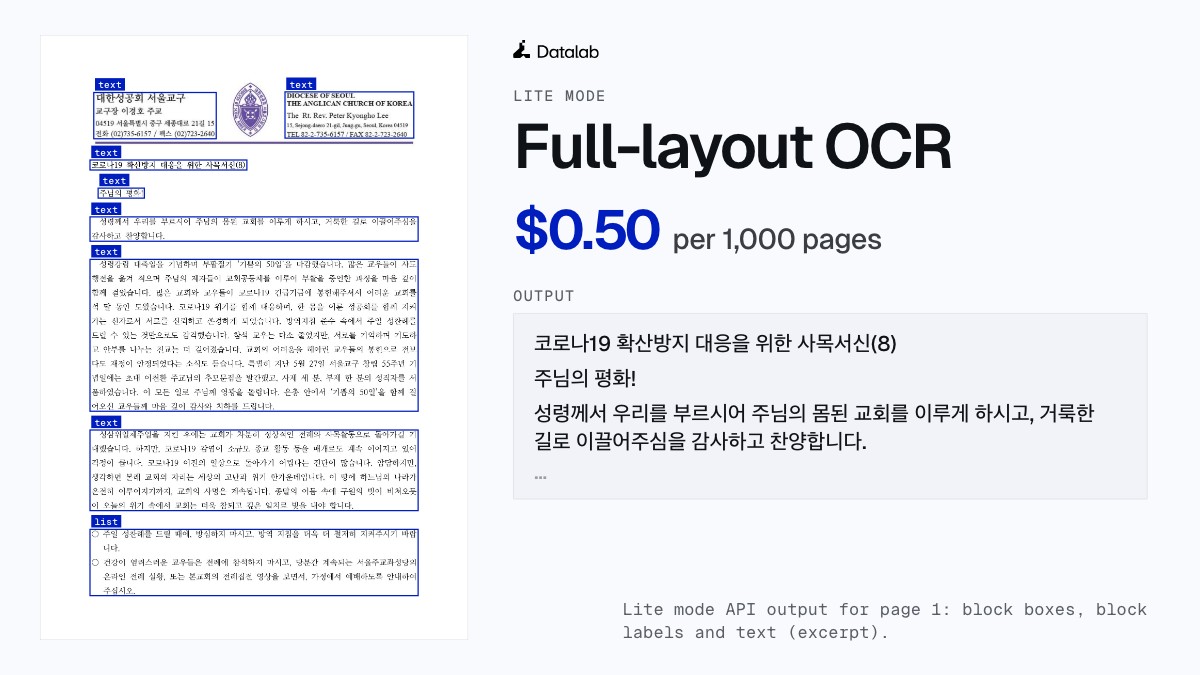
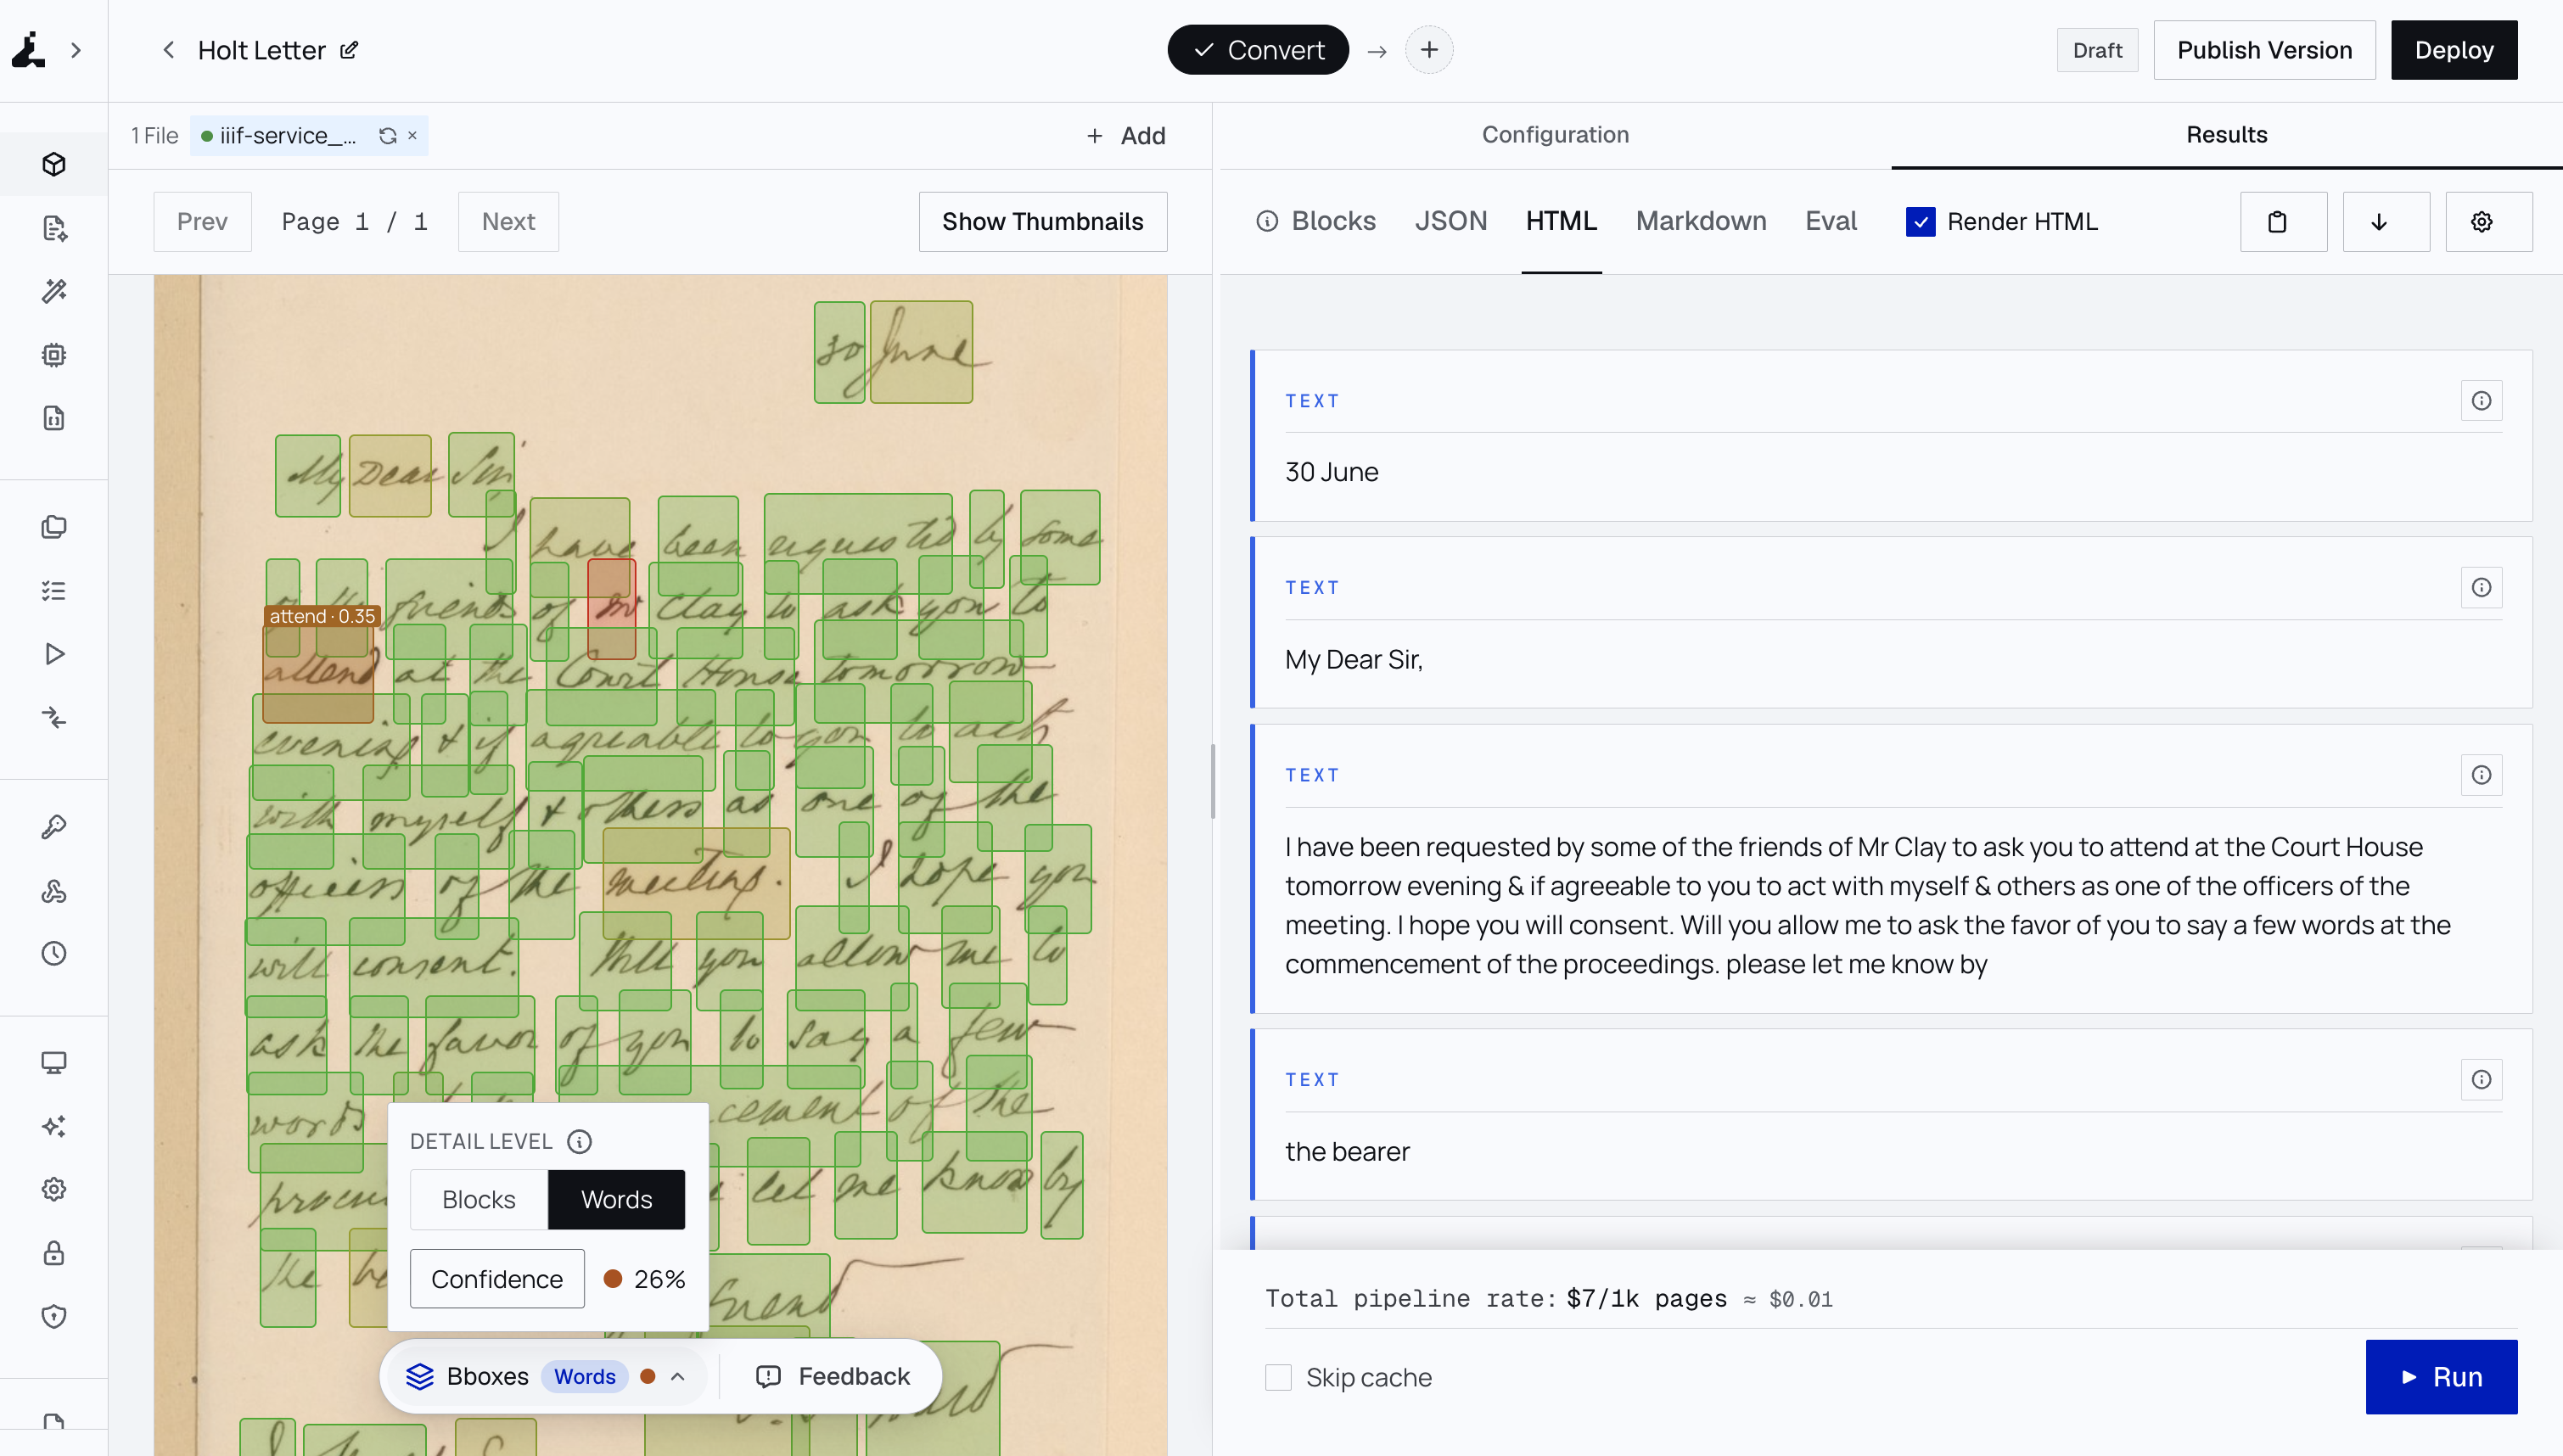
Тот же запрос работает со сканированным корейским письмом:
Цена
Стоимость lite составляет $0.50 за 1 000 страниц, без тарифных уровней и минимальных платежей. Облачные API разметки стоят от $5 до $15 по прейскуранту:
При цене $500 за миллион страниц вы можете разобрать целый архив. Когда вы измените правила разбивки на чанки или схему, вы сможете разобрать его заново.
Источники: цены Datalab, розничные цены Azure (Восточная США, асинхронное извлечение стандартного контента Content Understanding), цены Google Document AI и цены AWS Textract (us-east-1, первый миллион страниц в месяц). Цены по прейскуранту, без учета бесплатных лимитов, обязательств и налогов. Текстовые API OCR от каждого облачного провайдера стоят дешевле, но не возвращают таблицы или разметку.
Точность
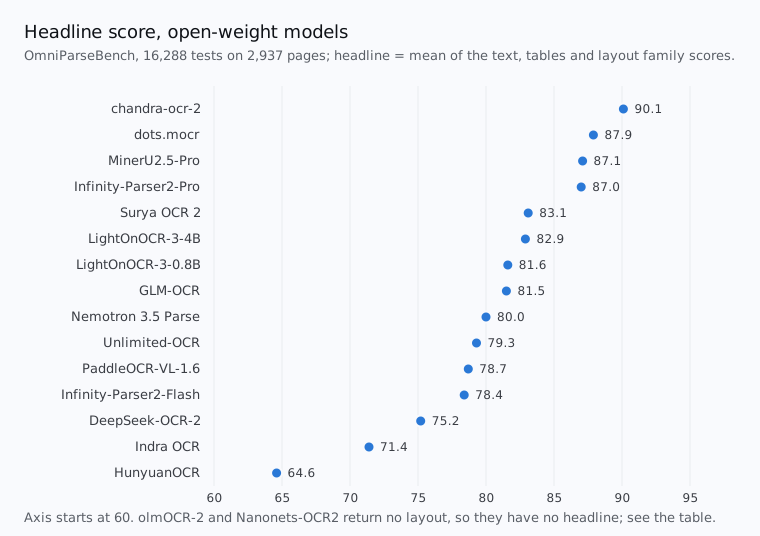
Мы запустили lite и три облачных API на OmniParseBench, нашем бенчмарке для разбора документов. Чтобы сравнение было честным, мы исключили все математические тесты для каждой системы. В итоге осталось 12 972 теста на 2 502 страницах.
В общем зачете lite отстает от Azure менее чем на 3 балла, при этом обходится в десять раз дешевле. В тестах с текстом lite набирает больше баллов, чем Azure и Textract, и на 0,5 балла отстает от Google. В тестах с таблицами lite набирает 74,2 балла: на 30 баллов выше Layout Parser от Google и на 1,6 ниже Textract. Azure показывает лучшие результаты по таблицам и разметке.
Многоязычные документы
Большая часть бенчмарка состоит из английского языка, поэтому за средним значением может скрываться парсинг, который не справляется с другими письменностями. В OmniParseBench содержится 897 текстовых тестов на нелатинских алфавитах:
Textract успешно проходит 2,5% таких тестов, а Azure — 33,9%. Lite успешно справляется с 88% и более тестов на армянском, эфиопском, иврите, каннада, лаосском и телугу:
Если ваши документы написаны на разных языках, вы можете отправлять их все в один и тот же API.
Скорость
Мы отправили пять PDF-файлов разной длины в lite и Azure Layout. Мы выполняли по четыре запроса одновременно и замеряли время выполнения каждого запроса от начала до конца:
Lite работает быстрее при любой длине. Для 50 страниц это занимает 4,9 секунды против 12,0 секунд у Azure, поэтому вы можете разобрать длинный документ прямо во время ожидания пользователя.
Что на этом можно построить
Первый вариант использования — пакетная обработка (бэкфил). Один миллион страниц стоит $500, поэтому вы можете разобрать архив, а затем разобрать его заново при изменении вашего конвейера.
На втором месте — поиск и RAG. Заголовки и таблицы обеспечивают лучшую нарезку на чанки, а рамки позволяют цитировать страницу.
Lite также отлично подходит для встраивания в продукт. 10-страничный документ возвращается за 3,4 секунды, поэтому вы можете разбирать каждый загруженный файл перед маршрутизацией или извлечением данных.
Некоторым документам требуется более мощный режим. Lite может терять структуру таблиц с объединенными ячейками. Он хуже распознает рукописный текст и поврежденные сканы, а также не извлекает изображения. Для таких документов используйте наши быстрые, сбалансированные или точные режимы.
С чего начать
Создайте аккаунт, получите ключ API и установите режим lite:
Бесплатный тариф включает лимит использования на $20 в месяц при регистрации на рабочий email или на $10 — на личный email, без привязки карты. В пересчете только на lite-режим это составляет 40 000 или 20 000 страниц в месяц. Другие режимы расходуют тот же лимит, который обновляется каждый месяц. См. тарифы.
Если у вас большой объем для пакетной обработки, расскажите нам об этом.
Методология
Мы использовали снимок набора данных OmniParseBench 961c0f89a2da701f5ce53afbd5e80aa469b0369a и модуль оценки 1.0.0rc1+49f0c983509e. Снимок содержит 16 288 тестов на 2 937 страницах. Мы исключили 3 316 тестов с меткой математики для каждой системы и сохранили остальные тесты на этих страницах. В результате осталось 12 972 теста на 2 502 страницах: 5 228 тестов текста, 5 382 теста таблиц и 2 362 теста разметки. Общий балл представляет собой среднее арифметическое результатов по тексту, таблицам и разметке, что является главным показателем бенчмарка.
Lite — это производственный API с параметром mode=lite, запущенный 25 октября 2026 года. Azure — это предварительно обученная разметка Content Understanding (prebuilt-layout). Ее результаты были сохранены 30 сентября и 6 октября 2026 года, и мы пересчитали их с помощью того же модуля оценки. Textract — это AnalyzeDocument с параметрами TABLES и LAYOUT в регионе us-east-1. Мы без потерь конвертировали 17 файлов изображений, которые Textract не принимает, в формат PNG. 15 страниц, отклоненных Textract, засчитаны как ошибки. Google — это общедоступный Layout Parser (pretrained-layout-parser-v1.0-2024-06-03) в регионе us, с изображениями, завернутыми в PDF без потерь.
Группа нелатинских языков включает тесты присутствия, порядка и повторения с тегом письменности ISO 15924, отличным от Latn. Каждый тест учитывается один раз.
Для оценки скорости мы использовали первые 1, 5, 10, 25 и 50 страниц пяти общедоступных PDF-файлов с arXiv. Мы отправляли по четыре запроса одновременно с одного клиента и опрашивали статус каждые 0,5 секунды. Запросы к Azure выполнялись 22 октября 2026 года, к lite — 25 октября 2026 года. Все 25 запросов для каждой системы завершились успешно.
Мы создали OmniParseBench. Эти баллы применимы к данному бенчмарку и указанным версиям.
Скачайте полные результаты без математики, со всеми тегами и наборами исходных данных.
Приложение: полные результаты
Все оценки представляют собой долю пройденных тестов без учета математики. Таблицы категорий, письменностей и языков используют тесты текста и таблиц. Теги пересекаются, и многие группы малы, поэтому один тест может изменить результат на несколько баллов.