Иногда вам не требуется самый точный OCR в мире. Вам нужен OCR, который работает достаточно хорошо, дешево и быстро, чтобы обрабатывать каждый документ каждый раз, не задумываясь о стоимости.
Представьте lite-режим как System One OCR: быстрый и интуитивный. Наши сбалансированный и точный режимы — это System Two, для случаев, когда важен каждый символ.
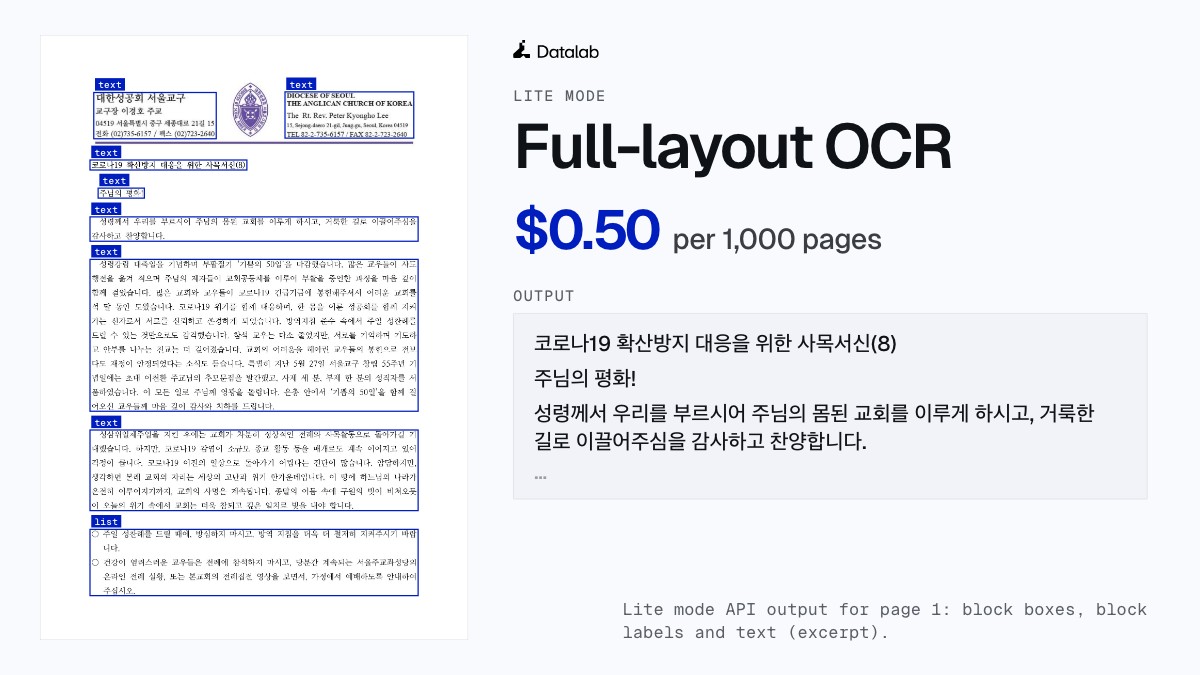
Сегодня мы запускаем lite-режим в Datalab API по цене $0,50 за 1000 страниц. Он возвращает полную структуру документа: текст, таблицы, заголовки, списки, порядок чтения и блок макета для каждого элемента.
При такой цене OCR перестает быть пакетной задачей, закладываемой в бюджет, и становится тем, что вы встраиваете прямо в свой продукт. Распознавайте каждую загрузку, пока пользователь ждет. Индексируйте каждую страницу архива вместо выборки. Перезапускайте весь корпус данных при изменении конвейера. Джевонс был прав: когда OCR становится в 10 раз дешевле, вы не просто экономите деньги на уже обрабатываемых документах. Вы начинаете обрабатывать документы, которые раньше пропускали.
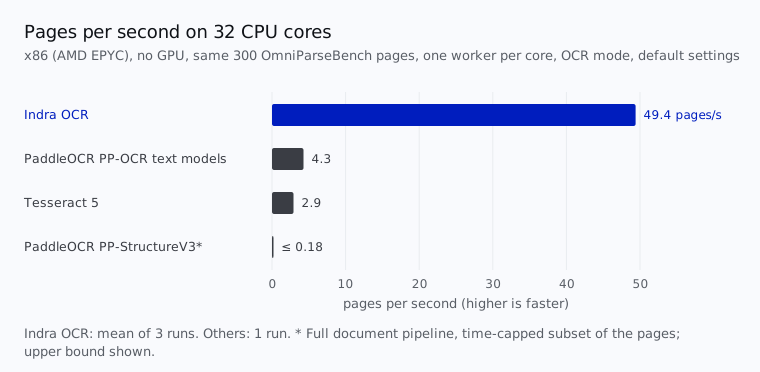
Lite использует версию Indra OCR, нашей модели OCR с 1 млн параметров, работающую на CPU. Именно это делает его дешевым.
- В 10 раз дешевле, чем Azure Layout. Если не считать формул, lite набирает больше баллов, чем Azure Layout, по тексту, не уступает ему по макету и значительно опережает на нелатинских алфавитах.
- В 2 раза быстрее, чем Azure Layout на длинных документах. 50-страничный PDF возвращается за 5,0 секунд против 12,0 секунд у Azure Layout.
- Точнее, чем Azure Read, за полцены. На документах OmniParseBench без формул lite набирает 75,1 балла, а Azure Read — 42,3. Read возвращает только текст, без таблиц и макета.
Цена
Lite стоит $0,50 за 1000 страниц, без уровней и минимальных ограничений. Один миллион страниц стоит $500. Тот же миллион страниц стоит $5000 с Azure Layout, $10 000 с Google Layout Parser и $15 000 с AWS Textract layout and tables. Это в 2–3 раза дешевле текстовых OCR-сервисов от Azure, AWS и Google и в 10–30 раз дешевле их сервисов разметки:
Azure: прейскурант Content Understanding. AWS Textract: API прайс-листа AWS, us-east-1, 20 октября 2026 г. (DetectDocumentText — $1,50; AnalyzeDocument Layout + Tables — $15,00). Google Document AI: каталог облачного биллинга, 21 октября 2026 г. (Enterprise Document OCR — $1,50; Layout Parser — $10,00).
Скорость
На одной странице lite не уступает Azure. Используя метод измерения задержки OmniParseBench (200 страниц, 8 запросов одновременно), медианное значение lite составляет 3,3 секунды на страницу, а Azure — от 2,4 до 3,7 секунды в зависимости от того, откуда вы обращаетесь.
На более длинных документах lite вырывается вперед. Каждый запрос имеет около 2,5 секунд фиксированных затрат, после чего lite добавляет примерно 0,05 секунды на страницу против примерно 0,19 у Azure Layout:
Точность
Мы запустили lite на всех 2937 страницах OmniParseBench, используя собственный инструмент тестирования и оценки бенчмарка через API. Lite не записывает уравнения в формате LaTeX, поэтому для документов без формул (12 972 из 16 288 тестов) результаты сравнения следующие:
Lite набирает больше баллов, чем оба продукта Azure по тексту, и не уступает Azure Layout по макету при десятикратной разнице в цене с Layout. Оставшееся отставание от Azure Layout заключается в сложных таблицах.
По всему бенчмарку, включая формулы:
Azure Read и Azure Layout — это предобученные анализаторы prebuilt-read и prebuilt-layout сервиса Azure Content Understanding по прейскурантным ценам Azure. Azure Document Intelligence указывает Read по цене $1,50 ($0,60 сверх 1 млн страниц) и Layout по цене $10,00. Оценки Azure Layout взяты из таблицы лидеров. Azure Read — наш прогон на том же инструменте тестирования. Категория «Без формул» исключает все тесты с меткой math.
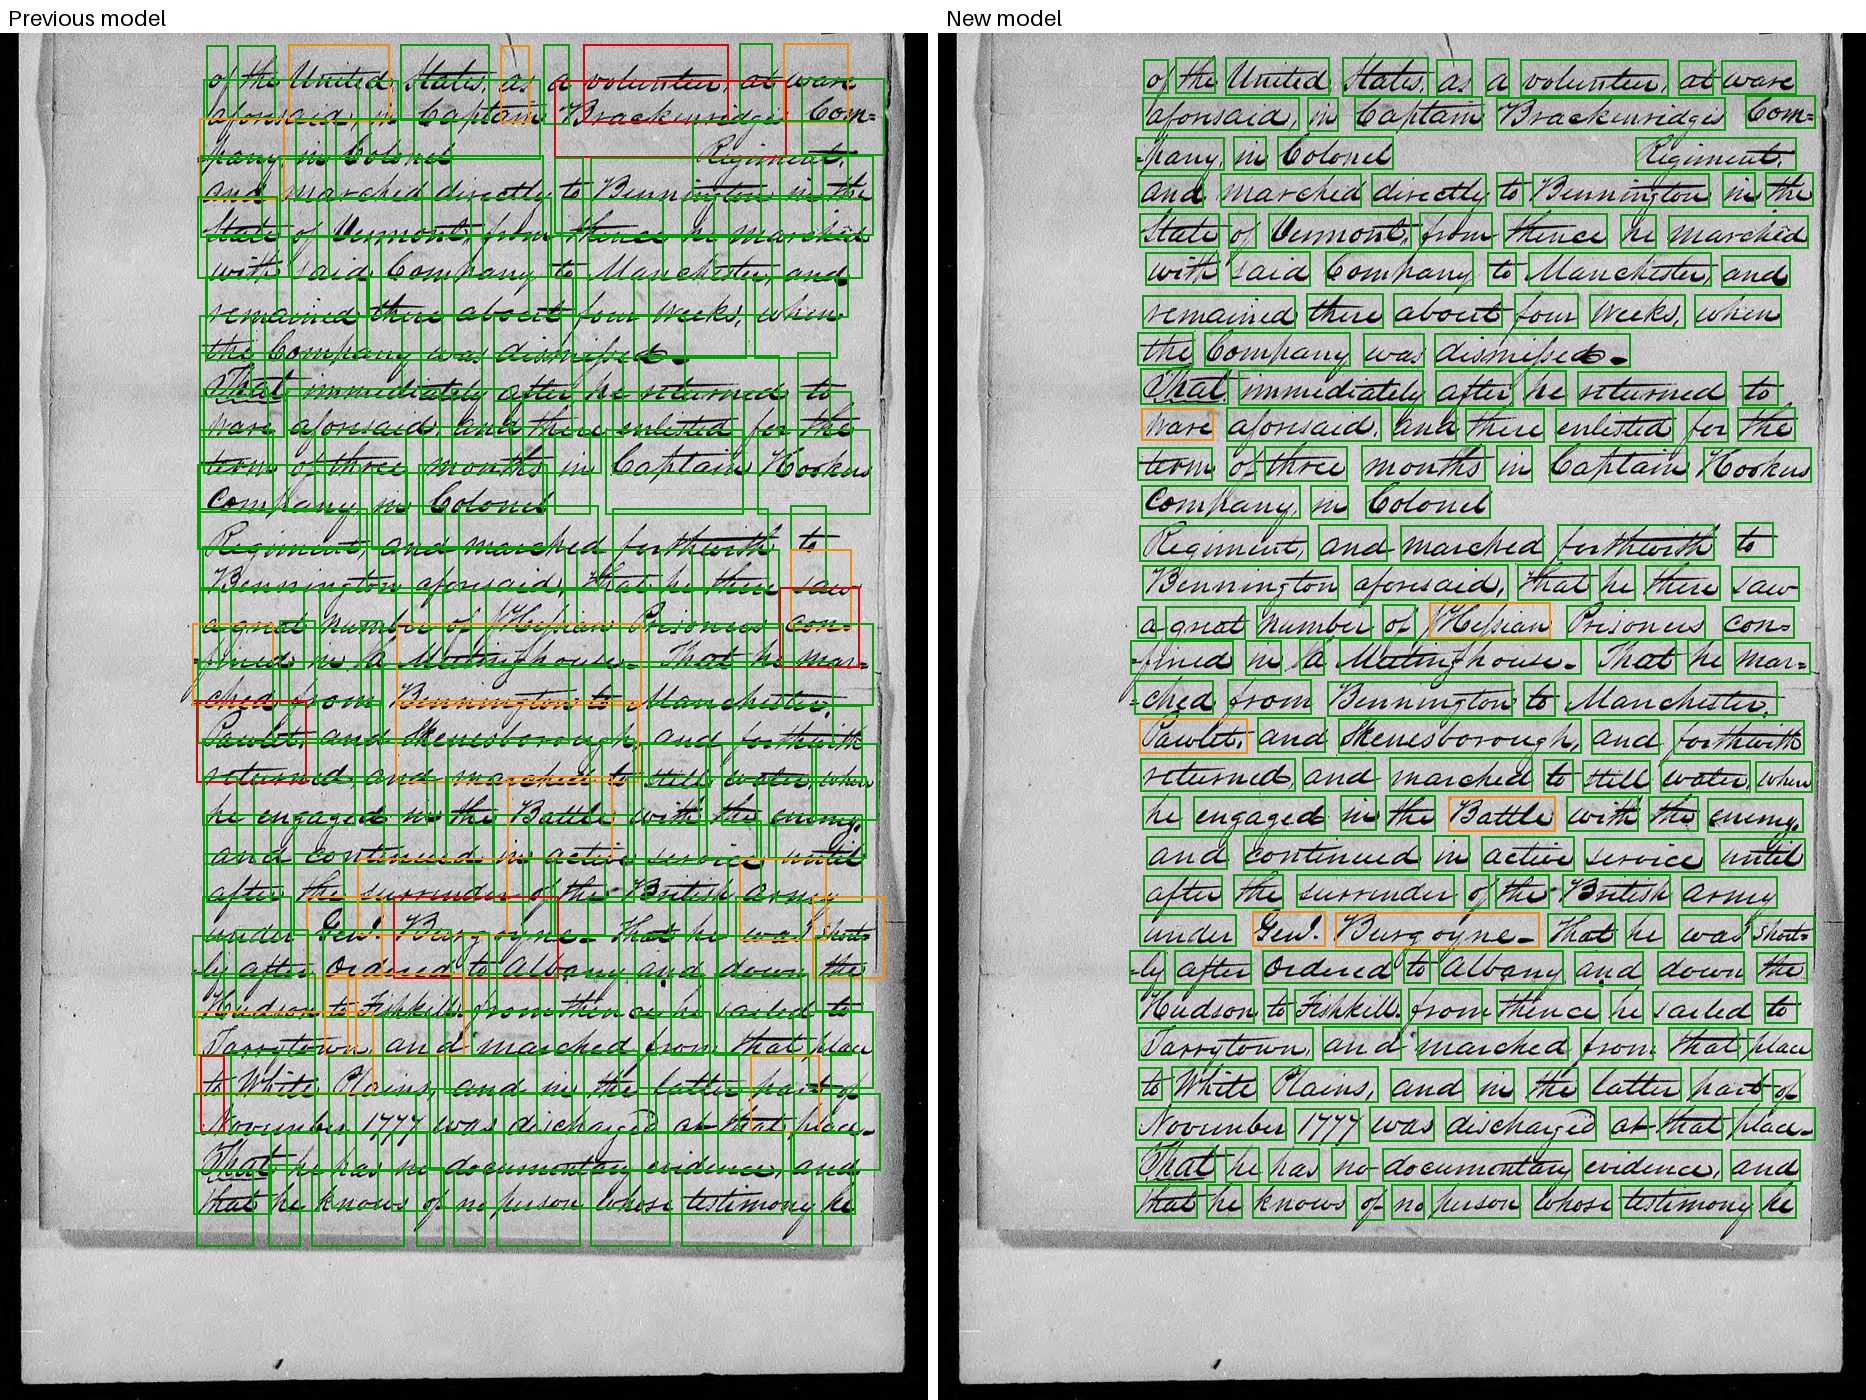
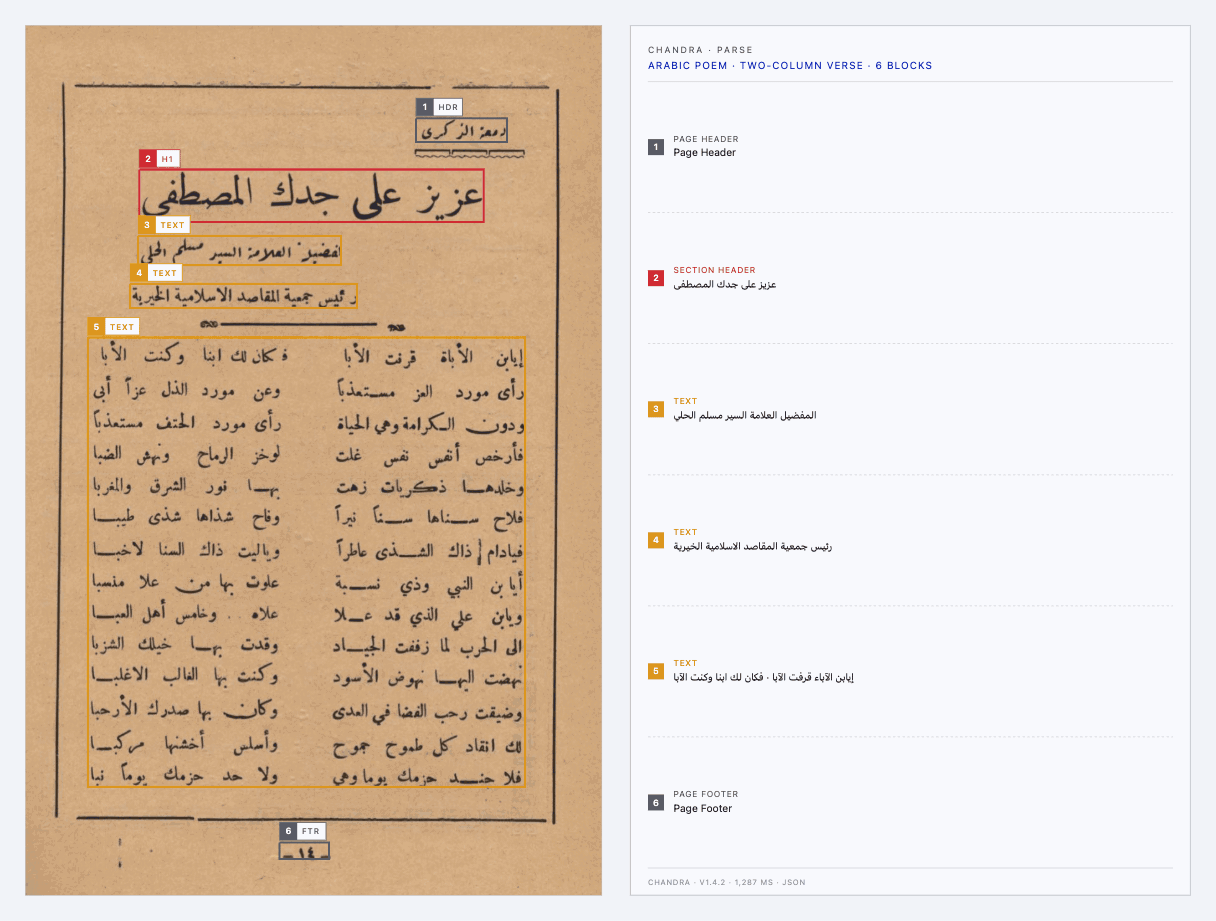
В чем lite вырывается вперед, так это в письменности. В тестах с нелатинскими алфавитами lite успешно проходит 81,1%, а Azure Layout — 49,6%. Например:
Когда использовать lite
Lite создан для больших объемов: архивы, поисковая индексация, RAG-ингестия и любые конвейеры, где вы обрабатываете миллионы страниц и вам нужна структура, а не просто текст.
Он подходит не для каждого документа:
- Формулы: уравнения возвращаются как простой текст, а не LaTeX.
- Сложные таблицы: lite считывает текст ячеек, но таблицы с объединенными ячейками или многоуровневыми заголовками могут терять структуру.
- Рукописный текст, повернутые и поврежденные сканы: они распознаются, но менее точно, чем в других наших режимах.
- Без изображений и подписей: lite не извлекает иллюстрации.
Для этого используйте быстрый (fast), сбалансированный (balanced) или точный (accurate) режимы, которые работают на базе модели Chandra.
Попробуйте
Установите режим в lite:
Lite уже доступен в API. Если у вас высокая рабочая нагрузка, расскажите нам о ней.