Сегодня мы выпускаем Indra OCR — пакет для оптического распознавания символов, построенный на базе модели распознавания с 1 млн параметров. Он считывает 49 страниц в секунду на 32 ядрах CPU, что в 11–17 раз быстрее, чем текстовые модели Tesseract и PP-OCR от PaddleOCR. Задержка при обработке одной страницы составляет ~230 мс. Кроме того, он превосходит обе эти системы в текстовом бенчмарке OmniParseBench.
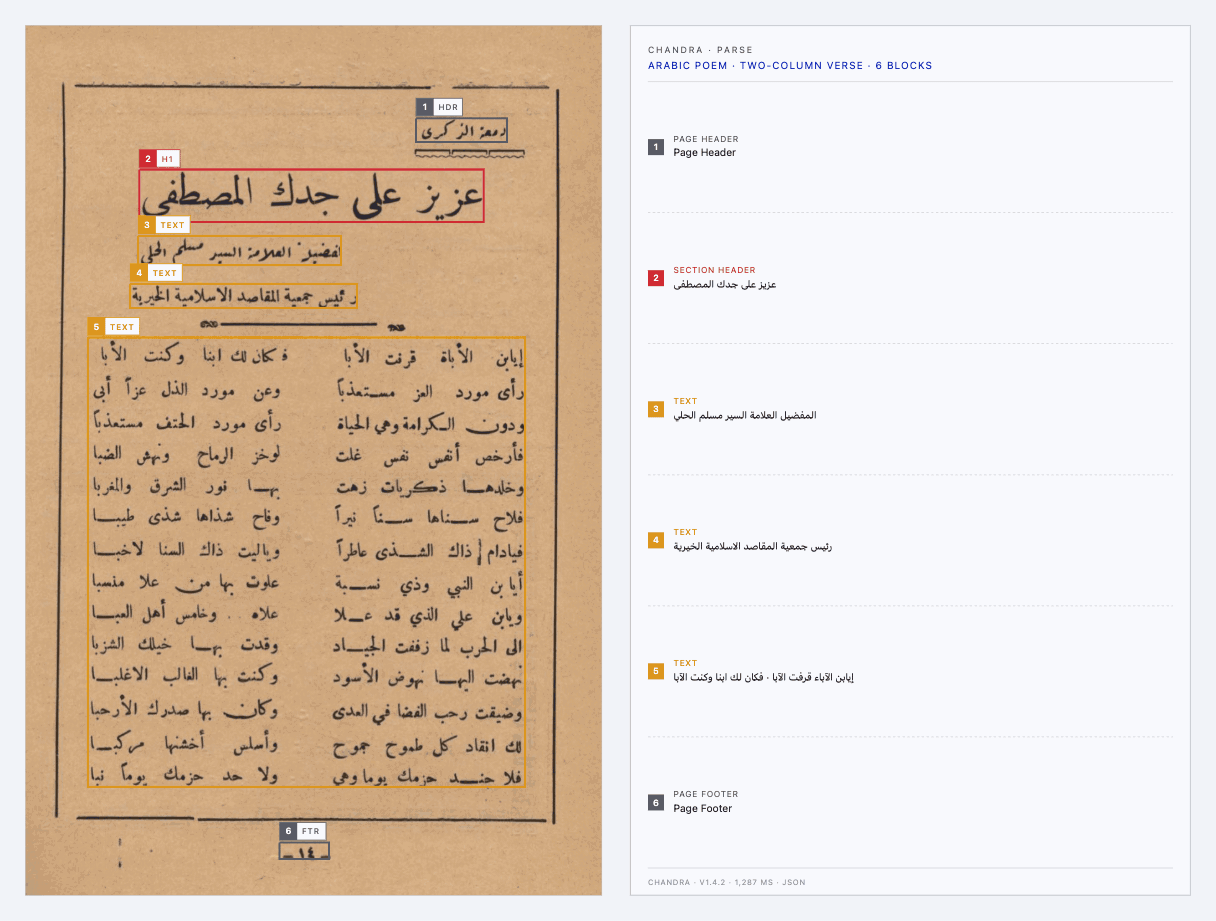
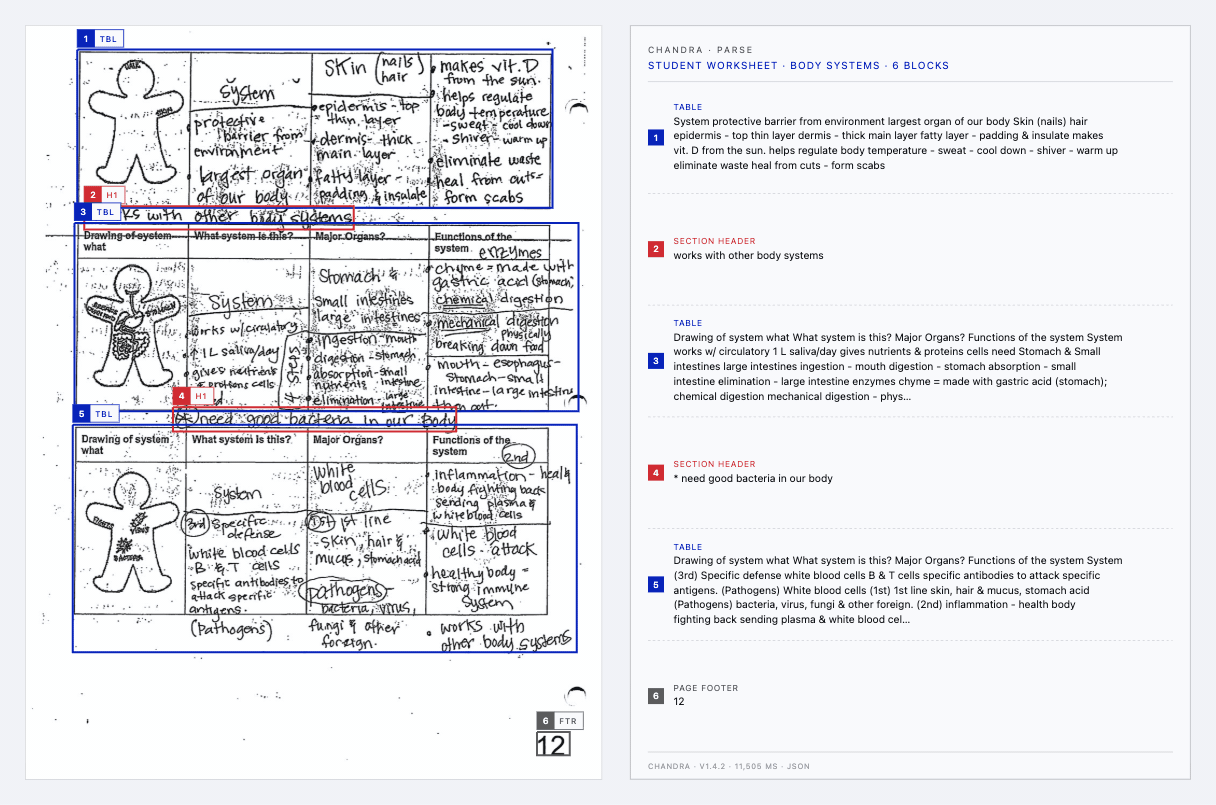
Речь не только о тексте. Indra OCR предоставляет полную разметку: ограничивающую рамку для каждой строки и каждого блока макета, метки блоков (заголовки, списки, таблицы, подписи и многое другое) и порядок чтения в формате Markdown или JSON.
Макет, рамки и чистый Markdown
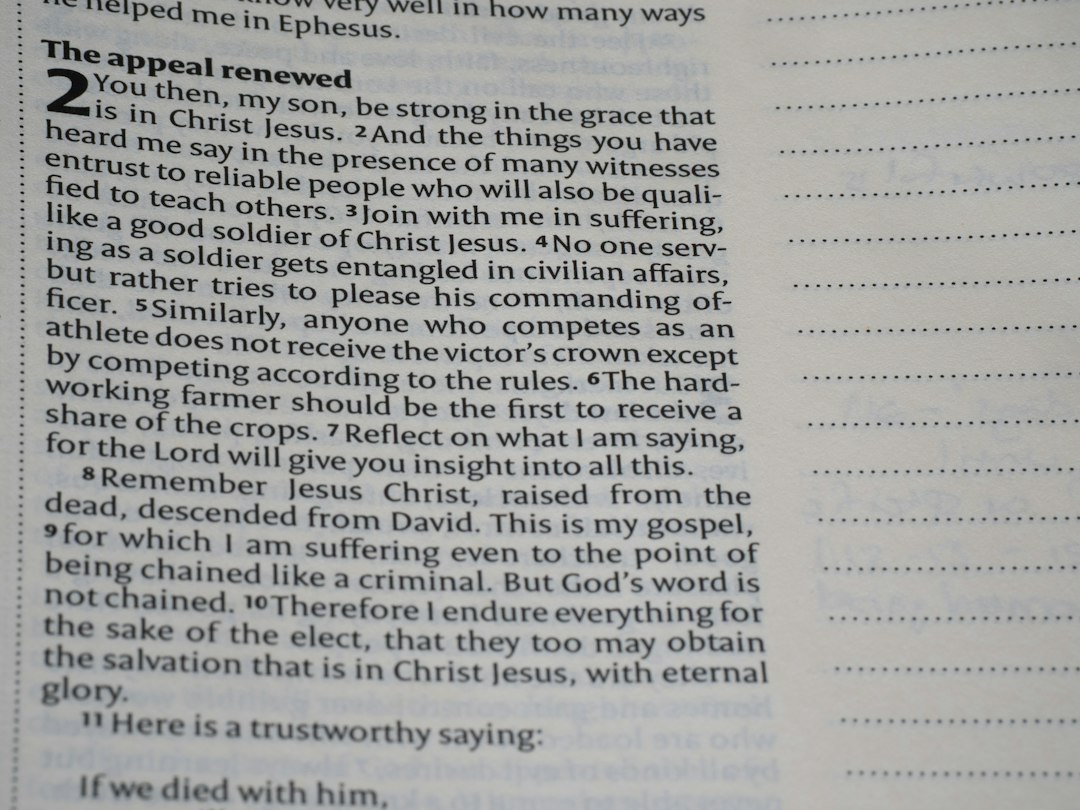
Indra OCR дает вам больше, чем просто текст. Каждая строка получает ограничивающую рамку, а каждый блок макета — рамку, метку (текст, заголовок раздела, список, таблица, подпись, сноска, форма, оглавление, верхний или нижний колонтитул) и свое место в порядке чтения. Страницы, перевернутые вверх ногами или набок, сначала поворачиваются в правильное положение.
Markdown получается чистым: заголовки обозначаются как #, абзацы, списки и таблицы — как HTML, а верхние и нижние колонтитулы по умолчанию исключаются (опция --keep-furniture сохраняет их). Вывод в формате JSON содержит все это вместе с рамками: рамку каждой строки, текст и уровень уверенности, блоки макета в порядке чтения, источник текста каждой страницы (текстовый слой PDF, OCR или оба) и время обработки каждой страницы. Больше реальных примеров вывода можно найти в галерее примеров.
Почему такая маленькая модель?
Для многих цифровых и отсканированных документов скорость важнее точности. Получение «достаточно хорошего» текста позволяет автоматизировать такие рабочие процессы, как классификация и сегментация. Многие пользователи, запускающие эти процессы, могут работать только на CPU (GPU стоят дорого). Существующие OCR-движки в таких случаях работают медленно и неточно. Поскольку модель содержит всего 1 млн параметров и может работать с чрезвычайно высокой пропускной способностью, Indra OCR открывает совершенно новые способы работы с документами.
Результаты
Мы оценили каждый движок в OmniParseBench, нашем новом бенчмарке, состоящем из 16 288 тестов на прохождение/отказ на 2 937 страницах. Каждый движок работал на архитектуре x86 с 4 vCPU, обрабатывая по одной странице за раз, на одних и тех же страницах и с тем же механизмом оценки, при настройках по умолчанию.
* PP-StructureV3 — это полный конвейер обработки документов от PaddleOCR. Один из его сегментов завис на первой странице, поэтому в его строке пропущено 19 страниц. † Задержка --math взята из отдельного запуска на x86 (AMD EPYC Genoa, 4 ядра), где в стандартном режиме она составила 208 мс.
Несколько ключевых моментов:
- В сравнении с OCR-движками Indra OCR выигрывает по обоим показателям. В стандартном режиме его текстовый балл составляет 41,3 против 35,8 у текстовых моделей PP-OCR от PaddleOCR и 19,3 у Tesseract, при этом он работает в 12–24 раза быстрее. Эти движки выводят строки, а не таблицы или макеты, поэтому они не получают итогового балла. Даже при отключенном текстовом слое Indra OCR значительно опережает Tesseract и лишь немного уступает PP-OCR по тексту (33,5 против 35,8) при скорости 303 мс на страницу.
- В сравнении с полным конвейером обработки документов он выигрывает по итоговой оценке. PP-StructureV3 от PaddleOCR добавляет к своему OCR разметку, таблицы и формулы. Indra OCR превосходит его по итоговой оценке (62,1 против 58,4), по таблицам и по макету, затрачивая около 1/180 времени на страницу. В стандартном режиме Indra OCR модель PP-StructureV3 лучше считывает текст (55,6 против 41,3). С опцией --math Indra OCR обходит его и по тексту (57,5 против 55,6), лидируя по всем показателям.
- Цифровые PDF обрабатываются быстрее. Если в PDF есть пригодный для использования текстовый слой, Indra OCR считывает его вместо запуска OCR. В нашем тесте на пропускную способность такие страницы обрабатывались в среднем за 130 мс против 304 мс для страниц, требующих OCR (один однопоточный рабочий процесс на страницу).
Каждый движок работал с настройками по умолчанию. Существуют более быстрые настройки, но мы не оценивали их точность: Tesseract с моделью eng и 1 потоком тратит 3,4 с на страницу, а PP-StructureV3 с отключенными дополнительными модулями и мобильными моделями OCR — 10,5 с. Indra OCR все равно в 15–45 раз быстрее на страницу. Строка Tesseract — это наш запуск (Tesseract 5, латинская модель). Вы можете воспроизвести строки Indra OCR с помощью bench/opb_indra.py в репозитории.
Пропускная способность
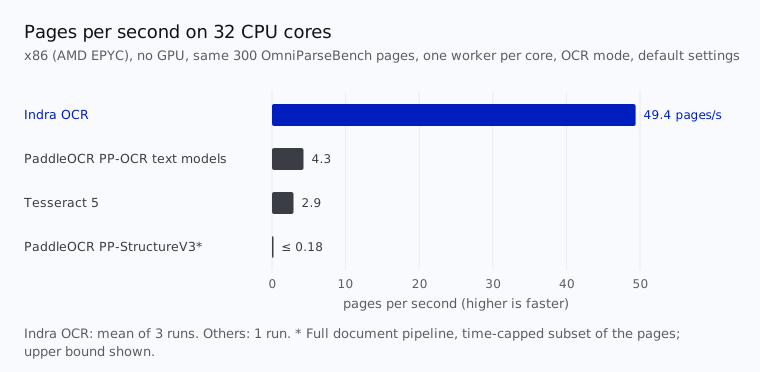
CLI и indra_ocr.convert_many запускают по одному однопоточному рабочему процессу на ядро, по одной странице на задачу, поэтому даже один длинный PDF задействует все ядра. Вот сравнение в страницах в секунду:
Каждый движок работал на одной и той же машине x86 (AMD EPYC, без GPU) на тех же 300 страницах OmniParseBench, с одним однопоточным рабочим процессом на ядро, в режиме OCR и с настройками по умолчанию. Indra OCR — это среднее значение из 3 запусков. На 32 ядрах Indra OCR в 11,5 раз быстрее текстовых моделей PP-OCR от PaddleOCR, в 16,9 раз быстрее Tesseract и примерно в 280 раз быстрее PP-StructureV3 (относительно его верхнего предела).
* PP-StructureV3 обрабатывал ограниченный по времени подмножество страниц, поэтому его цифры являются верхними пределами.
Загрузка модели не включена в эти цифры. Короткое задание на 300 страниц через convert_many, включая загрузку модели, выполняется со скоростью 37,7 страниц в секунду на 32 ядрах.
Математика
Математика по умолчанию отключена. Включите --math, и небольшой классификатор найдет строки с математическими формулами, а второй распознаватель запишет их как текст с встроенным LaTeX. В OmniParseBench итоговая оценка вырастает с 62,1 до 66,8, а оценка текста — с 41,4 до 57,5, поэтому Indra OCR лидирует над PP-StructureV3 от PaddleOCR по всем показателям. Оценка таблиц немного снижается (с 56,4 до 54,8), так как некоторые числа в ячейках таблиц считываются как математические формулы.
Обе строки взяты из одного запуска на всех 2 937 страницах. Строка по умолчанию совпадает с таблицей выше с точностью до 0,1. «Математические тесты» — это 3 252 теста OmniParseBench, проверяющих LaTeX.
На x86 (AMD EPYC Genoa) страница обрабатывается около 360 мс вместо ~210 мс при обработке по одной на 4 ядрах, а пропускная способность примерно на 30–35% ниже, около 30 страниц в секунду на 32 ядрах. Именно поэтому эта функция является опциональной. Математические модели загружаются только при включении этой опции.
Быстрый старт
Или из Python:
Первый запуск загружает модели из Hugging Face. Также имеется локальный просмотрщик indra-ocr-viewer, который рисует рамки и порядок чтения поверх каждой страницы.
Скрипты
- OCR (сканы и изображения): латиница (около 50 языков), кириллица, греческий, деванагари, бенгальский и китайский (упрощенный и традиционный).
- Цифровые PDF: любой скрипт. Благодаря текстовому слою Indra OCR обрабатывает текст на любом языке. Мы проверили это на страницах из 75 языковых семейств, включая арабский, иврит, тайский, кхмерский, грузинский, индийские скрипты, японский и корейский, при этом строки с направлением письма справа налево сохраняют свой порядок.
Ограничения
Indra OCR маленький и быстрый, и у этого есть цена:
- Сложные таблицы. Простые таблицы получаются чистыми, но таблицы с многоуровневыми заголовками, объединенными ячейками или без разделительных линий часто теряют структуру. Его оценка таблиц в OmniParseBench составляет 56,4.
- Рукописный текст. Он пока не читает рукописный текст (тесты рукописного ввода в OmniParseBench: около 8%).
- Скрипты. На сканах и изображениях он распознает только латиницу, кириллицу, греческий, деванагари, бенгальский и китайский. Арабский, иврит, тайский, японская кана, корейский хангыль и другие скрипты считываются только из текстового слоя цифрового PDF. Вертикальный текст, как в традиционных китайских газетах, не поддерживается.
- Математика. Математические формулы выводятся как обычный текст, если вы не включите --math, а старые отсканированные формулы все еще трудно распознать.
Если ваши страницы — это в основном чистая печать на вышеуказанных языках, он должен справиться очень хорошо. Если это рукописный текст, сильно поврежденные документы или страницы, полные сложных таблиц, это не подходящий инструмент.
Попробуйте
- Код: github.com/datalab-to/indra
- Модели: huggingface.co/datalab-to/indra-ocr
- Бенчмарк: OmniParseBench
Мы будем рады узнать, на чем вы его запускаете и где он дает сбои.