Каждую неделю новая модель OCR становится лучшей (state of the art) в каком-нибудь бенчмарке, зачастую в том, который создал и оценил её же разработчик. В итоге каждый — №1, и один только заголовочный балл не скажет вам, какой парсер использовать.
В прошлом месяце я выступил с докладом на эту тему на курсе «AI Evals for Engineers & PMs» (видео). Этот пост — текстовая версия с подробностями, которые не уместились в 25 минут. Он охватывает три аспекта:
- Как понять, что означает балл в бенчмарке, и проверки, которые позволяют выявить плохой результат.
- Какие метрики работают для OCR, какие — нет, и почему.
- Пошаговая оценка на ваших собственных документах на примере реального запуска, который мы провели для годовых отчетов.
Сразу небольшое уточнение. Мы создаем модели OCR и продаем парсер документов, а также разработали один из бенчмарков в этом посте — OmniParseBench. Оценивайте нас по тем же критериям, что и всех остальных.
Ошибки парсинга доходят до вашего приложения
Если ваше приложение читает документы, первым шагом в каждой цепочке (trace) является парсинг. На вход подается PDF или скан, на выходе получается текст, и всё последующее (разбиение на чанки, поиск, извлечение данных, ответ LLM) доверяет этому тексту. Если парсинг выполнен неверно, ошибка обычно проявляется позже и выглядит как ошибка LLM.
Три реальные ошибки парсинга, взятые из оценки в конце этого поста:
- Цифра 3 прочитана как 8. Парсер прочитал $3,915.00 как $8,915.00. Каждый последующий шаг доверял восьмерке. В рабочих процессах KYC или финансах любой результат, основанный на этом числе, будет неверным.
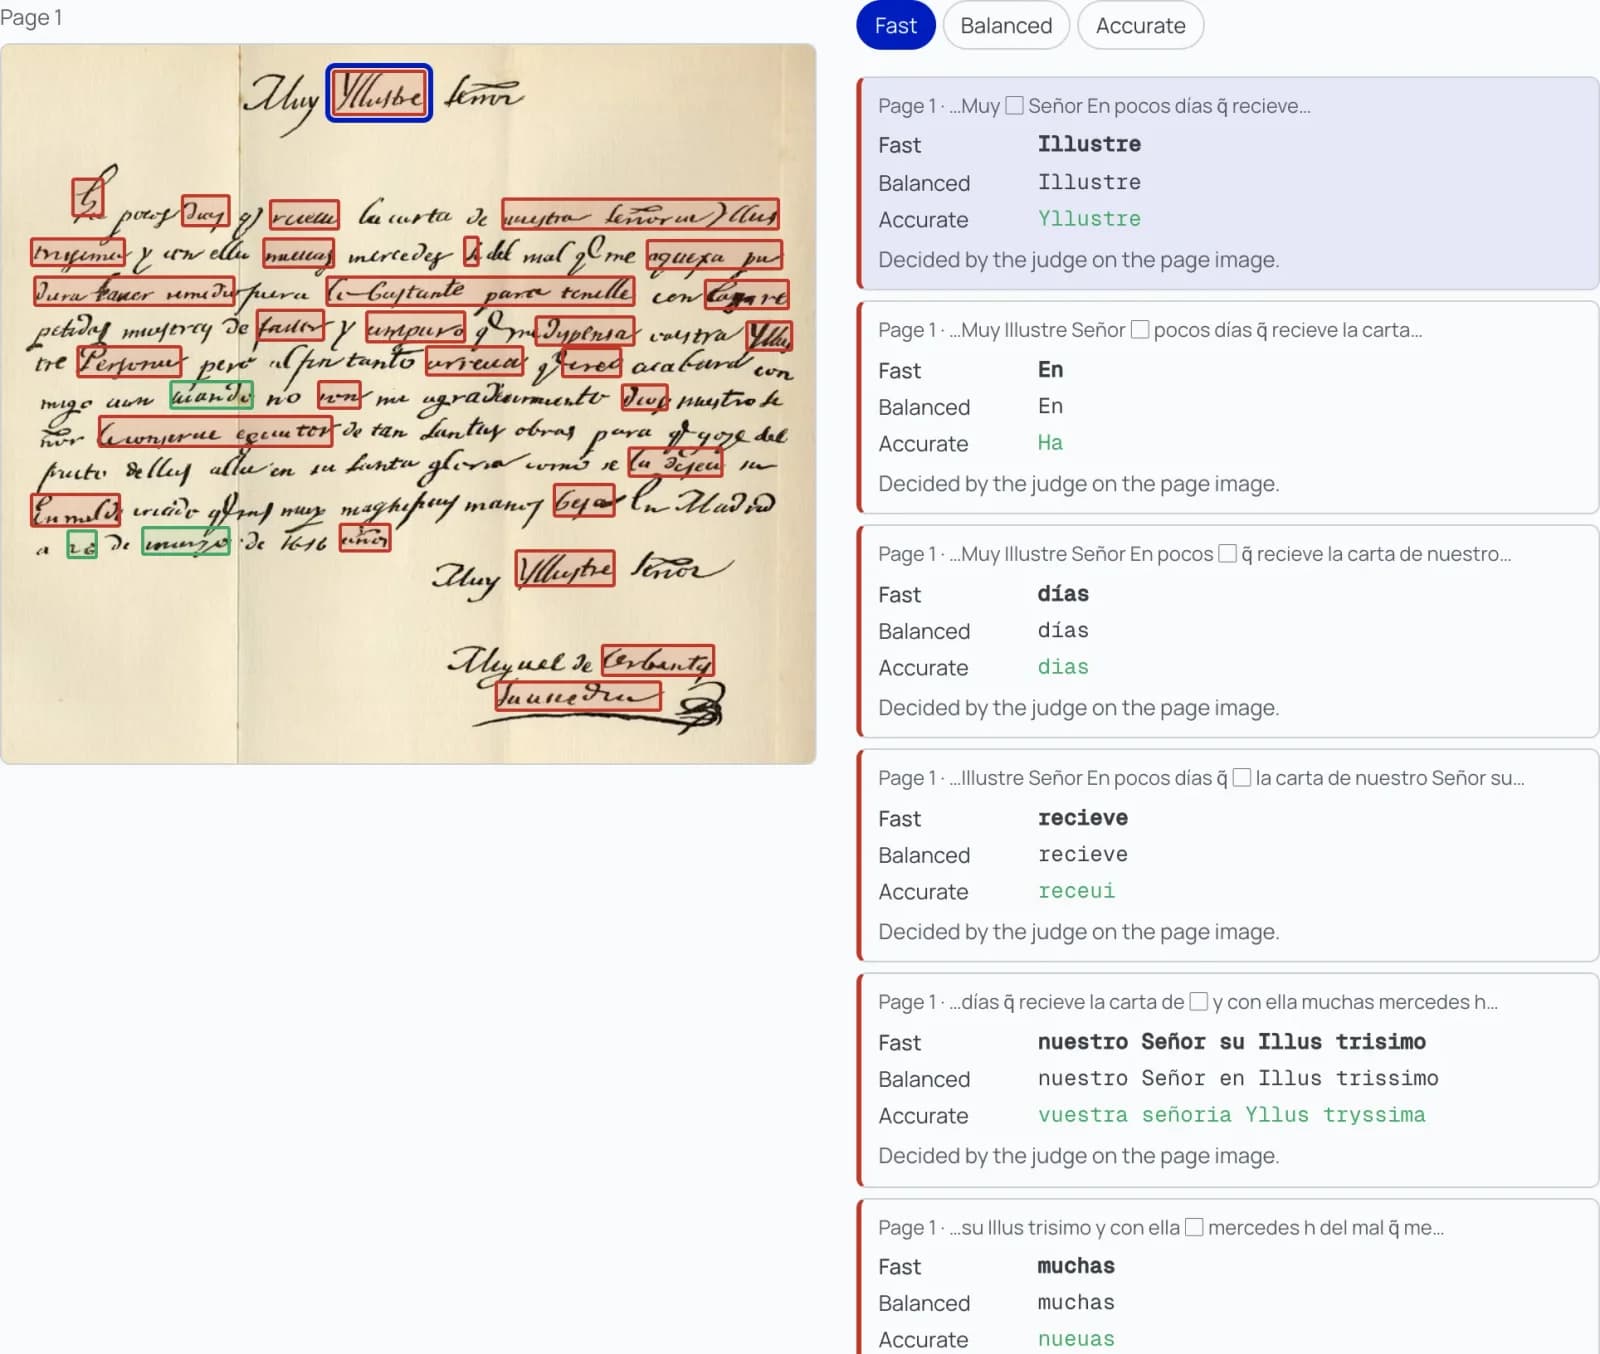
- Правильное слово, но в другом алфавите. Парсер написал метку строки «BHE» кириллицей. На экране это выглядит идентично. Поиск по запросу «BHE» (латиницей) никогда не найдет эту строку. Мы писали об этой проблеме в статье о путанице письменностей (script confusions).
- Таблицы с отступами. Таблица в формате markdown с отступами из пробелов привела к тому, что заголовок таблицы попал в один чанк, а итоговая сумма — в другой. Переключение того же парсера на компактные таблицы увеличило количество правильных ответов с 71 до 80 из 81.
Поэтому, когда вы проводите анализ ошибок в цепочке, открывайте результат парсинга. Многие «ошибки LLM» начинаются именно там.
Чтобы их исправить, нужно выбрать парсер, и большинство людей начинают с бенчмарка.
Балл ничего не значит, пока вы не знаете, что именно он измеряет
В ParseBench, бенчмарке парсинга от LlamaIndex, мы подняли Surya, нашу OCR-модель с 650 млн параметров, с 23-го на 3-е место из 148 систем в рейтинге по четырем измерениям, не связанным с диаграммами. Мы провели 70 шагов обучения с подкреплением (reinforcement learning) для форматирования, а также внесли несколько исправлений в инференс. Мы не обучались на документах ParseBench. Surya читала страницы так же хорошо, как и раньше, но её вывод стал точнее соответствовать форматированию бенчмарка. Мы выпустили чекпоинт, чтобы вы могли проверить это сами, а полная история доступна здесь.
В ExtractBench, бенчмарке извлечения данных от LlamaIndex, наш результат вырос с 64,5% до 93,6% без каких-либо изменений в извлеченных значениях. Его адаптер считал наши метаданные об уверенности и цитировании неверными значениями. Мы исправили это и использовали нейтральное сопоставление чисел.
В обоих случаях качество чтения не улучшилось, но результат сильно изменился: на 20 позиций в ParseBench и на 29 пунктов в ExtractBench. В постах о запусках цитируют подобные бенчмарки, и люди выбирают парсеры на их основе.
Три бенчмарка, три разных порядка
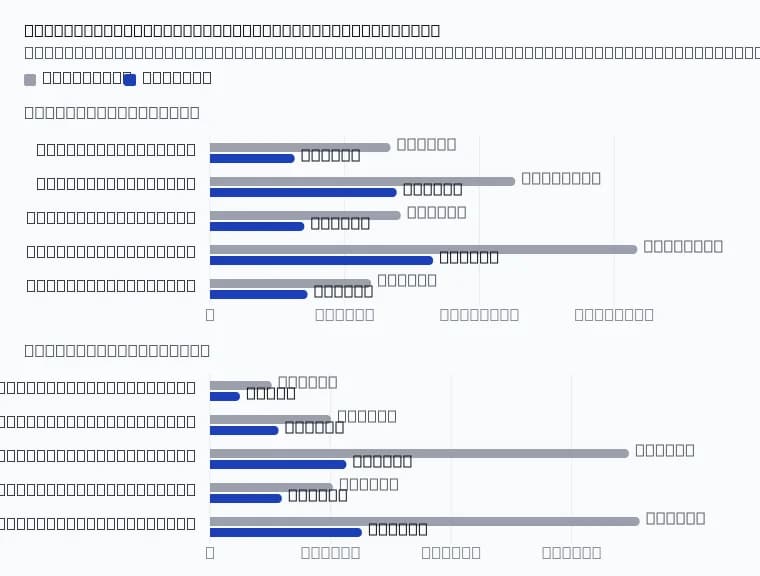
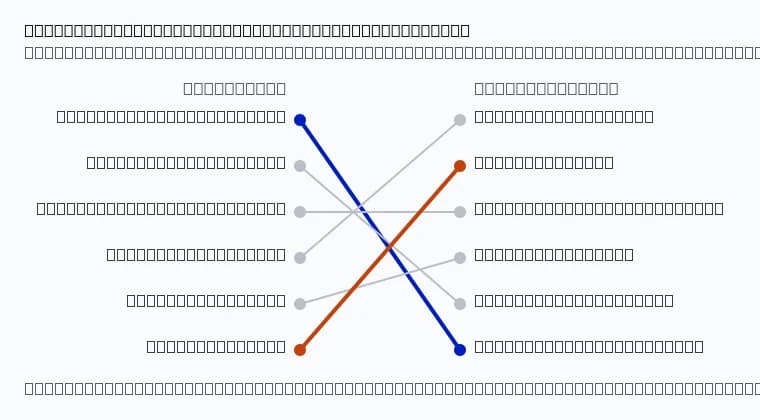
На рис. 1 показаны шесть открытых моделей OCR в ParseBench и OmniParseBench:
Nemotron 3.5 Parse занимает первое место в ParseBench и последнее в OmniParseBench. dots.mocr занимает последнее место в ParseBench и второе в OmniParseBench. В olmOCR-bench, бенчмарке от AllenAI, пять из шести моделей набирают от 83,3 до 87,6 баллов согласно отчетам вендоров (каждый со своей очисткой данных), что слишком близко для ранжирования. Nemotron не предоставляет данных по нему.
Настройки тоже различаются: в ParseBench Nemotron запускает трехпроходный пайплайн, а в OmniParseBench — стандартный однопроходный пайплайн клиентского приложения вендора. Но основная причина в том, что бенчмарки измеряют разные вещи, и некоторые из них не связаны с чтением.
Те же страницы, другая метрика
OmniParseBench включает 81 страницу из самого ParseBench, оцененную с помощью наших собственных тестов. В этих 293 тестах порядок снова меняется: LightOnOCR-3-4B и Infinity-Parser2-Pro — 91,8, Chandra OCR 2 — 90,4, dots.mocr — 84,6, Surya OCR 2 — 81,6, Nemotron 3.5 Parse — 81,2. Выборка невелика, поэтому не стоит придавать значения разрывам менее 3 пунктов. Но Nemotron перемещается с первого места на последнее на тех же самых страницах.
Диаграммы объясняют большую часть этого. Правило для диаграмм в ParseBench требует считать значение со столбца или линии и сверяет его с числом в эталонных данных (ground truth):
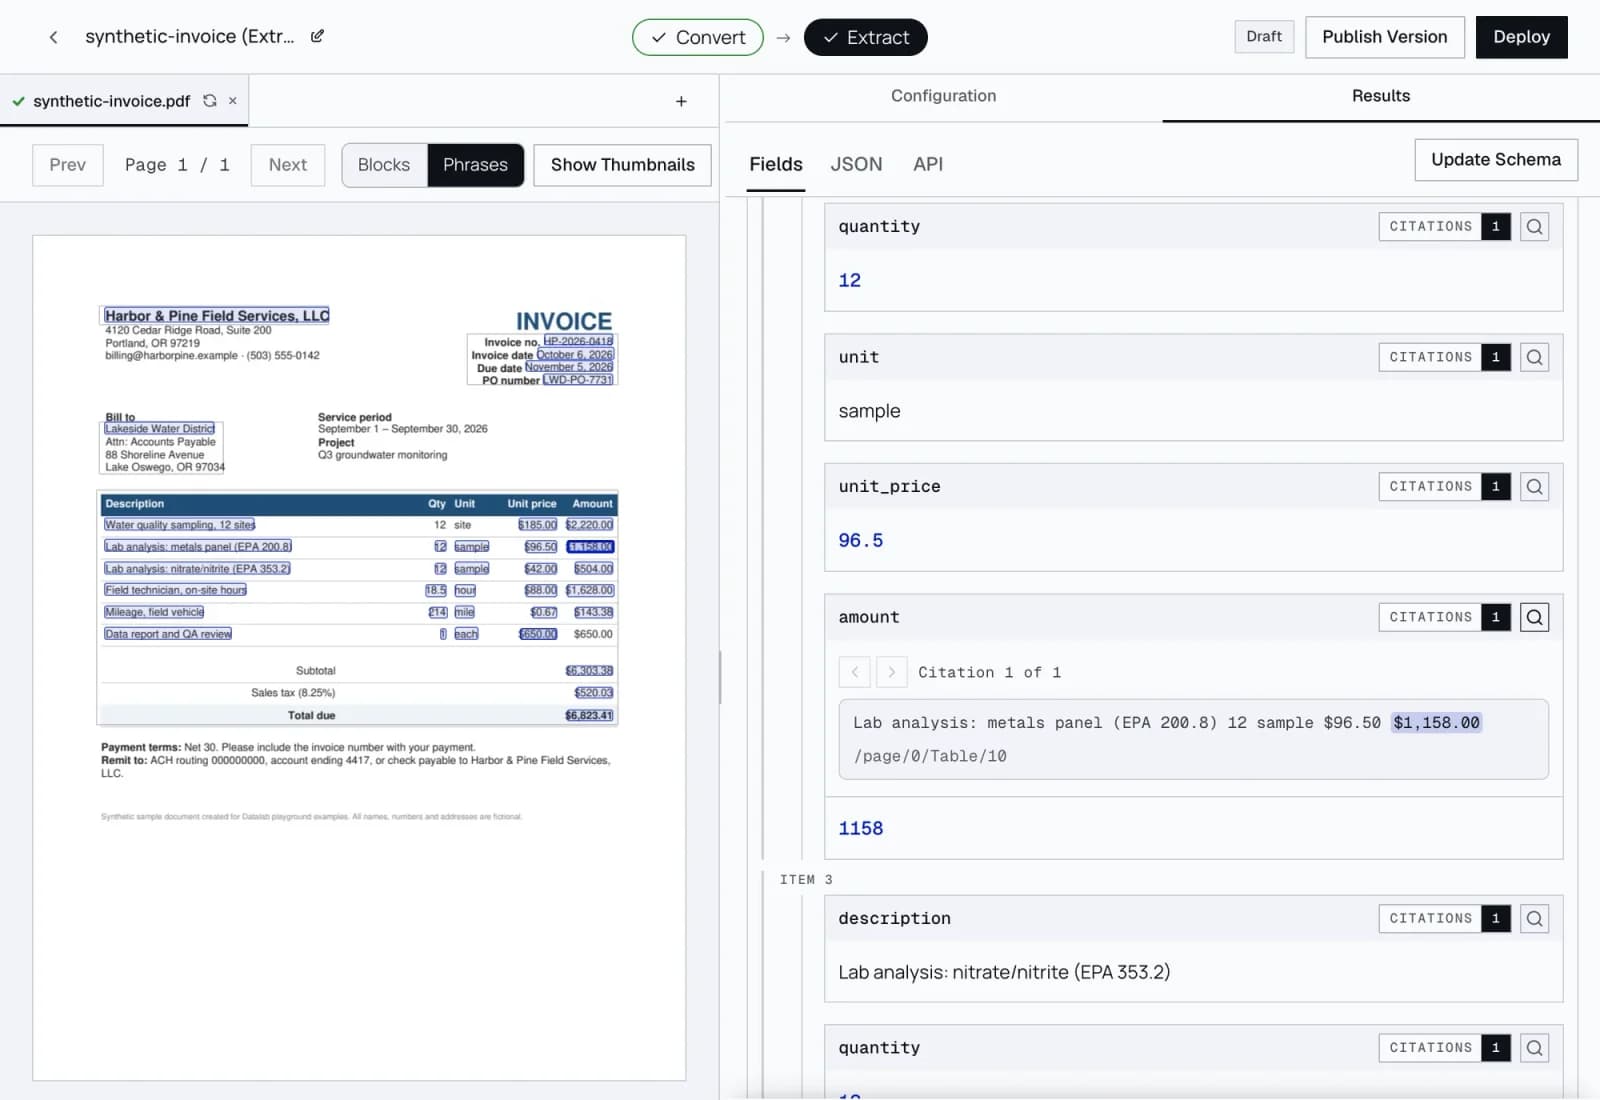
Столбец на странице соответствует 303 ГВт. Правило требует 310 с точностью до 1%. Модель, которая считывает диаграмму правильно, терпит неудачу. 73% правил для диаграмм в ParseBench (3 569 из 4 864) — это значения, которые не напечатаны на диаграмме, поэтому сами «эталонные данные» являются оценкой модели. Кроме того, не существует единственно верного способа представить диаграмму в виде таблицы, поэтому парсер, который назовет ряд данных иначе, также получит ошибку.
dots.mocr не обучена преобразовывать диаграммы в таблицы, поэтому она набирает 0,95 из 100 по этим правилам. Тест OmniParseBench на странице с диаграммой проверяет только напечатанный на ней текст, например подписи к осям, и dots.mocr проходит 92,7% таких тестов:
Эталонные данные, созданные моделью, также дают преимущество этой модели. Если вы размечаете страницы с помощью собственной модели, ваша модель будет делать тот же выбор, что и в разметке, а все остальные будут признаны неправыми за то, что прочитали страницу другим, не менее верным способом.
Что делает метрику хорошей
Хорошая метрика обладает четырьмя свойствами, и для каждого из них есть тест, который вы можете запустить самостоятельно.
Валидность (Validity) кажется слишком очевидной, чтобы её упоминать, но многие бенчмарки ей не соответствуют, как показано в следующем разделе. Специфичность (Specific) отдает предпочтение простым метрикам: если тест не пройден, вы должны знать почему, и простая метрика дает этот ответ. Обоснованность (Sourced) означает, что вы можете объяснить, почему ответ правильный, и вариант «так сказала модель» не подходит. Дискриминативность (Discriminating) означает, что одни системы проходят тест, а другие — нет. Метрика, которую проходят все или не проходит никто, ничего не говорит.
Метрики, которые не работают
Расстояние редактирования (Edit distance)
Расстояние редактирования сравнивает весь вывод с одним эталонным текстом и подсчитывает количество добавленных, удаленных или измененных символов. Звучит как именно то, что нужно: если вывод отличается от эталона, он неверен. OmniDocBench, популярный бенчмарк парсинга, использует его для оценки текста.
Возьмем эталонную таблицу и два варианта вывода:
0 означает идентичность. Вывод А абсолютно правильный, но оценивается как почти полностью неверный, потому что HTML и markdown различаются почти в каждом символе. Вывод B содержит неверную цифру выручки, но оценивается как почти идеальный. Изменение формата «стоит» в 48 раз больше, чем неверное число. Для финансового пайплайна вариант B является опасным. (Это обычные расстояния Левенштейна, деленные на большую длину).
Расстояние редактирования чрезмерно наказывает за форматирование и недостаточно — за ошибки в содержании, которые наносят вред. Некоторые модели пишут в markdown, другие — в HTML, поэтому в бенчмарке с расстоянием редактирования часть оценки зависит от того, какой формат случайно выдала модель. Мы измерили это в 13 бенчмарках парсинга в статье «каким бенчмаркам парсинга доверять»: в бенчмарках с расстоянием редактирования 5% неверных цифр стоят всего от 0,1 до 0,4 балла из 100.
Метрики разметки и таблиц
Метрики разметки и таблиц также наказывают за правильный ответ, представленный в другой форме.
Метрики макета, такие как IoU и mAP, сравнивают рамки, которые модель рисует вокруг блоков, с рамками в эталонных данных (ground truth). Но каждый рисует макет немного по-своему. Допустим, в эталонных данных один блок на абзац, а модель рисует один блок вокруг двух абзацев. Это разумное прочтение страницы. Перекрытие с каждым эталонным блоком составляет менее 0,5 IoU, поэтому оба считаются промахами. Бенчмарк, который оценивает макет таким образом, в основном измеряет, сегментируете ли вы страницу так же, как ее создатель. Когда мы создавали OmniParseBench, мы нашли способ сопоставления блоков, который не наказывает за иную, но валидную сегментацию.
Табличные метрики, такие как TEDS и GriTS, сравнивают структуру таблицы как HTML. Если оценщик не может разобрать ваш формат, правильная таблица получает ноль баллов. Оценщик таблиц в ParseBench считывает только HTML. Его собственный инструментарий сначала преобразует таблицы в формате markdown, но правильная таблица в markdown, которая пропускает этот шаг, получает 0.
LLM в качестве судей
Использование LLM в качестве судьи заманчиво. Это быстро, и она справляется с любым форматом. Но ее нужно проверять, потому что у судьи есть свои предубеждения, и он не дает фиксированного ответа для аудита.
В реальном случае из оценки, приведенной далее в этой статье, промпт судьи гласил, что «NOT FOUND» (НЕ НАЙДЕНО) — это всегда ошибка. Правильным ответом было число со страницы. Модель ответила NOT FOUND, а судья (gpt-4.1) отметил это как правильный ответ. Это происходило от 16 до 19 раз за прогон. Мы заменили судью на точное совпадение чисел.
Судьи также меняются от прогона к прогону, и вы не можете построить стабильную оценку на меняющейся метрике. Используйте их только для узких, хорошо проверенных задач или для быстрой оценки по многим страницам.
Модульные тесты работают, пока тест не окажется неверным
Метод, который лучше всего работает для OCR, — это модульное тестирование, которое AllenAI представил вместе с olmOCR-bench. Каждый тест — это вопрос «да/нет» по одной странице. Три реальных теста olmOCR-bench:
- Тест на наличие: есть ли в выводе предложение «I soaked the water up with a cloth.»?
- Тест на порядок: на двухколоночной странице идет ли ссылка «48: 105-9.» перед «TGF-beta signaling: positive and negative…«?
- Тест на таблицу: есть ли ячейка «0.569» в строке с заголовком «BO»?
Ошибка указывает на один недочет, который можно найти и изучить, что является «конкретным» свойством. Модульные тесты также в основном не заботятся о том, как вы форматируете вывод, только о том, правильное ли содержание. На мой взгляд, это лучший способ бенчмаркинга OCR. Но модульный тест хорош ровно настолько, насколько хорош каждый отдельный тест.
Когда понятие «правильно» неоднозначно
Почти каждый тест в чем-то неоднозначен, и ваша задача как человека, создающего оценку, — прояснить это. Эти два теста olmOCR-bench не проходят правильную транскрипцию:
Тест требует, чтобы имена офицеров были на одной строке, но на странице там стоит разрыв строки. Большинство моделей сохраняют разрыв строки, поэтому модель, которая добросовестно копирует страницу, проваливает этот тест.
В тесте заглавная P, а на странице строчная p. Тест чувствителен к регистру, поэтому пройти его с правильной транскрипцией невозможно.
Еще два примера, каждый на своей странице:
- Математический тест хранит одну строку LaTeX: r-s=2,4 \text{ mod 4}. Модель, которая пишет \text{ mod } 4, выдает точно такое же уравнение, но проваливается. LaTeX может записать одно и то же уравнение разными способами, а тесты в основном сравнивают строки.
- Тест на отсутствие говорит, что сноска в шведском статуте не должна появляться в выводе. Но сноска цитирует юридический источник статута, поэтому внимательный парсер сохраняет ее и проваливает тест.
Это мнения, оформленные как тесты. Когда мы заставили модель перепроверить каждый тест olmOCR-bench, который провалил Chandra, ее оценка выросла с 85,5% до 93,9%, и большинство ошибок были придирками, подобными этим. Около 3–4% тестов неверны или слишком субъективны, поэтому реальный потолок составляет около 96–97%. Мы описали это в статье о насыщении бенчмарка olmOCR.
Вы находите их, внимательно читая свои тесты и свои данные.
Когда хорошие тесты пропускают ваши документы
Даже когда каждый тест верен, бенчмарк может пропустить ваши документы. olmOCR-bench — это в основном англоязычные статьи arXiv и старые сканы. В нем нет форм, его табличные тесты проверяют только соседние ячейки, и в нем почти нет нелатинских шрифтов. Если ваши документы — это формы или японские счета-фактуры, он мало что сможет вам сказать.
Он также насыщен. Пять моделей сейчас набирают от 83,3 до 87,6 баллов, а новые релизы сообщают результаты после все более сложной постобработки, написанной специально для бенчмарка:
Постобработчик из примерно 700 строк добавляет 1–2 балла, что больше, чем большинство разрывов между моделями. Он переписывает вывод в форму, которую ожидают тесты, а сама модель остается прежней. В какой-то момент насыщенный бенчмарк перестает измерять качество и начинает измерять, насколько хорошо вы можете под него подстроиться. Это в конечном итоге случается с каждым бенчмарком, включая бенчмарки AllenAI.
Сегментируйте по тому, что нужно вашему конвейеру
То, что считается правильным, зависит от того, что вы будете делать с текстом дальше:
Поэтому одно число бенчмарка не может сказать вам, какая модель лучше для вас. Бенчмарк, который можно сегментировать по категориям, может. Лучшая из одних и тех же шести моделей меняется от одной категории OmniParseBench к другой:
Выберите категории, которые соответствуют вашим документам, и оценивайте только то, что нужно вашему конвейеру.
Четыре проверки, которые можно запустить для любой метрики
Вы бы запустили те же проверки для судьи LLM, где заведомо хороший вывод должен пройти, а заведомо плохой — не пройти.
- Поменяйте формат. Оцените один и тот же правильный вывод как markdown и как HTML. Хорошая метрика дает одинаковую оценку. Расстояние редактирования называет правильную HTML-таблицу на 77% отличной от той же таблицы в markdown, поэтому она не проходит эту проверку.
- Испортите правильный вывод. Измените цифру, метку строки или год, или переключите регистр. Оценка должна упасть. В нашей оценке ниже мы сделали 143 копии табличных тестов с неверной меткой строки или годом, и 0 из 143 прошли, что и требуется.
- Прочитайте общие ошибки. Посмотрите на тесты, которые проваливают все сильные системы. Когда все они не согласны с эталонными данными, эталонные данные обычно неверны. В нашей оценке 45 из наших первых 192 тестов провалились на всех сильных парсерах, и проблема была именно в тестах.
- Ищите предвзятость. Благоволит ли бенчмарк к одному семейству моделей? В ParseBench самый дешевый уровень LlamaParse отстает от лучшей другой системы по четырем из пяти измерений и лидирует на 3,16 балла только в Visual Grounding, чьи метки следуют за выводом LlamaParse. Подробнее об этом далее.
Кейс: ParseBench
ParseBench показывает, как бенчмарк проваливает эти проверки. Я не пытаюсь придраться к LlamaIndex. У других бенчмарков тоже есть проблемы, но другие вендоры теперь ссылаются на ParseBench в своих запусках, поэтому мы внимательно его изучили. В статье «Почему мы создали OmniParseBench» есть полный анализ.
Один необычный балл определяет рейтинг
Заголовок ParseBench — это простое среднее значение пяти измерений, каждое со своей метрикой:
dots.mocr побеждает в таблицах и контенте, измерениях, которые оценивают чтение, и все равно отстает на 19,4 балла в общем зачете. Только графики дают 12,7 из этих баллов, а 73% правил для графиков — это оценки.
Он вознаграждает форматирование больше, чем чтение
Есть как минимум три способа добиться успеха в ParseBench, не читая лучше:
- Промпт. Pulse, другая компания по обработке документов, изменила свои промпты и конфигурацию, чтобы соответствовать критериям, и поднялась с 51 до 74 баллов по семантическому форматированию в своем собственном повторном прогоне. Это обновление переместило ее с 7-го на 3-е место.
- Параметры вывода. Включение документированных параметров вывода в нашем API повысило наш показатель семантического форматирования с 46 до 77 при использовании того же текста.
- Обучение с подкреплением (RL) для форматирования. Surya поднялась с 23-го на 3-е место, как указано выше.
Некоторые правила форматирования полностью препятствуют правильной транскрипции. Кто-то хочет видеть «Parish Priest:» жирным шрифтом, но на странице он отображается обычным начертанием. Кто-то хочет видеть «ZIA TRUST, INC.» в качестве жирного заголовка, но на странице он представлен основным шрифтом и размером. А верхний индекс, написанный с пробелами внутри тега, <sup> 2 </sup>, никогда не совпадает, поэтому все 318 правил для верхних индексов получают оценку 0.00.
Эталонные данные следуют за одним поставщиком
Самый дешевый тариф LlamaParse за вычетом лучшей другой системы, по измерениям:
Поля визуального обоснования (Visual Grounding) берутся из «нормализованного вывода парсинга», сопоставленного с помощью функции под названием map_llamaparse_raw_label_to_canonical. Открытая модель разметки сопоставила только 68% текстовых полей и 39% заголовков разделов при IoU 0.8 на 273 страницах. Дешевый тариф, который проигрывает по всем остальным параметрам и выигрывает только здесь — это именно то, чего можно ожидать, если эталонные данные следуют его соглашениям.
В нем есть ошибки оценки
Мы обнаружили 11 ошибок оценки. Четыре из них:
Бенчмарки часто создаются в спешке, и такие крупные ошибки оценки являются признаком того, что никто не проверял результаты на адекватность.
У бенчмарков разные цели
Не каждый бенчмарк пытается сделать одно и то же. Некоторые созданы для того, чтобы быть честными, и в основном таковыми являются, например, olmOCR-bench: тщательные модульные тесты, проверенные людьми. Некоторые созданы для того, чтобы быть честными, но имеют недостатки, как ExtractBench, где из-за ошибки оценки правильные значения засчитывались как неверные. Некоторые ориентированы на одно семейство моделей, как ParseBench, чьи критерии и метки обоснования следуют выводу LlamaParse.
Поэтому задавайте вопрос к любому бенчмарку: для чего он был создан? Этот экспресс-тест занимает около пяти минут:
- Кто его создал и занимают ли они первое место?
- Меняет ли оценку изменение только формата?
- Записывает ли каждый тест, откуда взялся его ответ?
- Можете ли вы воспроизвести опубликованные цифры?
- Получил ли какой-либо поставщик индивидуальный промпт?
- Есть ли запас для роста или предел составляет 99%?
- Можете ли вы сегментировать его по типам ваших документов?
Как мы создали OmniParseBench, чтобы пройти эти проверки
Мы создали OmniParseBench и продаем парсер, поэтому мы предъявляем к нему более высокие требования, чем к другим. Каждая страница, тест и адаптер являются публичными, поэтому вы можете проверить их самостоятельно. Каждый тест следует четырем правилам:
- Утверждение визуально верно для страницы.
- Правильная транскрипция проходит проверку.
- Неправильная транскрипция не проходит проверку.
- Если тест нельзя доказать как верный, исключите его.
Каждый тест указывает, откуда взялся его ответ
В нем 16 288 тестов на 2 937 страницах. Каждый тест записывает, откуда взялся его ответ. Крупнейшие источники:
Ни одна из шести моделей в этой статье не помогла создать тест. Две передовые модели, которые помогли создать или проверить некоторые тесты, отмечены в таблице лидеров. Мы также удалили 18 264 тривиальных теста — тех, которые прошла каждая система, которые также прошла простая программа без модели и которые оценочная модель сочла тривиальными, чтобы у бенчмарка был запас для роста. Три примера, каждый со своим источником:
Ни один из этих ответов не был получен от модели, что соответствует свойству «sourced» (источник), упомянутому ранее.
Формат не имеет значения
HTML или markdown, с красивым форматированием или без, $…$ или <math>: каждый вывод проходит через один и тот же конвертер и одну и ту же нормализацию с обеих сторон каждого сравнения. Уравнения сравниваются по тому, как их рендерит KaTeX, а не по строке LaTeX. Числа должны совпадать цифра в цифру, но разделители тысяч не учитываются, поэтому 1,240 равно 1240.
Одинаковые правила для всех, и вы можете сегментировать его
Ни один поставщик не получает индивидуальный промпт. Каждая система получает одинаковое время ожидания и количество повторных попыток. Заголовок — это среднее значение трех семейств (текст, таблицы и макет), поэтому добавление большего количества тестов одного типа не искажает его. И каждый тест имеет теги, поэтому вы можете оценивать только то, что вас интересует: 92 языка, рукописный текст, таблицы, формы. Есть запас для роста: по рукописному тексту лучший парсер в таблице лидеров запуска набирает 81,4%, а медианный — 72,2%.
Создайте свою собственную оценку: практический пример
Ни один публичный бенчмарк не охватывает ваши документы и ваш конвейер в точности. Единственный надежный способ выбора — создать небольшую собственную оценку. Рецепт состоит из восьми шагов:
- Определите задачу и стоимость ошибки.
- Сегментируйте ваши документы.
- Напишите вопросы, которые вы можете проверить.
- Выберите одну метрику на каждую затратную ошибку.
- Разработайте и проверьте каждый тест.
- Запустите каждого кандидата, тестируя чтение и извлечение отдельно.
- Прочитайте ошибки.
- Проверьте саму оценку на наличие багов.
Мы проделали это на практике, чтобы выбрать парсер для RAG по годовым отчетам. Было два запуска: 28 страниц отчетов с 81 вопросом и 25 более сложных сканов с 95 вопросами. Мы сравнили четыре способа получения текста со страниц (текстовый слой PDF, Datalab, Mistral OCR и Reducto) через один конвейер RAG. Это практический пример, и он слишком мал, чтобы ранжировать поставщиков.
Шаг 1: определите задачу и стоимость ошибки
Задача — отвечать на числовые вопросы со страниц 10-K и годовых отчетов. Здесь уверенно неверное число стоит дороже, чем «не найдено», потому что кто-то может принять решение на его основе. Запишите это до того, как выберете какие-либо документы, потому что это определяет, что именно вы измеряете.
Шаг 2: сегментируйте ваши документы, затем сделайте выборку из каждого сегмента
Сегментируйте по тому, что меняет сложность, затем сделайте выборку из нескольких страниц каждого сегмента. Сообщайте оценку по сегментам.
Возьмите от 20 до 50 страниц и охватите каждый сегмент, который вы видите в производстве. Если ваш объем растет, делайте повторную выборку через интервалы, чтобы со временем создать больший набор.
Оценивайте каждый сегмент отдельно, потому что средние значения скрывают ошибки. Бесплатный текстовый слой PDF дает 63 правильных ответа из 81, что звучит неплохо. По сегментам: он получает 63 из 63 на цифровых страницах и 0 из 18 на сканах, потому что у сканов нет текстового слоя. Если в вашем трафике есть сканы, среднее значение вводит вас в заблуждение. (Наши сканы здесь симулированы. Более сложный запуск ниже использует настоящие.)
Шаг 3: напишите вопросы с ответами, которые вы можете проверить
У каждого вопроса есть эталонный ответ, который вы можете проверить:
- Ответ виден на изображении страницы.
- Строка ответа также есть в исходном тексте. Скрипт нашел все 81 из 81, что позволяет обнаружить опечатки в ваших собственных эталонных ответах.
- На каждой странице от 2 до 6 вопросов из каждого сегмента.
- Большинство ответов — числа (70 из 81), некоторые — текст (11).
Один реальный вопрос: «Для обратного выкупа акций Apple в квартале, закончившемся 28 сентября 2024 года, какая приблизительная долларовая стоимость акций (в миллионах) может быть еще выкуплена?» Эталонный ответ — $89 074 миллиона, из строки «Итого» таблицы выкупа в отчете 10-K Apple за 2024 финансовый год. Запомните этот вопрос, потому что одна настройка позже ответит на него неверно, и причина не в OCR.
На сканах без текстового слоя проверяйте эталонный ответ с помощью арифметики самой страницы, где это возможно:
В: Сколько тонн платного груза было перевезено на одну милю в 1903 году? Эталон: 3 721 877 190. Проверка: 3 721 877 190 + 534 777 562 = 4 256 654 752, напечатанный итог, значит, первая цифра — 3. Один парсер прочитал это как 8 721 877 190.
Шаг 4: выберите одну метрику на каждую затратную ошибку
Каждая ошибка, которая стоит денег в этой задаче, получает тест, который ее выявляет:
Последняя строка — самая полезная. Задание каждого вопроса только с той страницей, которая содержит ответ, без использования поиска, позволяет отделить ошибки чтения от ошибок разбиения на фрагменты. Без этого мы бы обвинили парсеры в том, что на самом деле сделал фрагментатор.
Шаг 5: проектирование и проверка каждого теста
Каждый тест должен проходить при правильном ответе и не проходить при неправильном, поэтому проверяйте свои тесты:
- Отрицательный контроль. Мы создали 143 копии табличных тестов с неверной меткой строки или годом. Ни один из 143 не прошел, поэтому мы знаем, что тесты могут выдавать ошибку.
- Формат. 45 из наших первых 192 тестов не прошли из-за символа «$» в ячейке, двухстрочных заголовков и примечаний вроде «Услуги (1)». Все мощные парсеры не справились с ними. Парсеры были правы, и мы исправили тесты.
- Нормализация. Нормализуйте то, что не имеет значения для вашей задачи, с обеих сторон сравнения. Метки строк сравниваются без пробелов, а типы тире приводятся к одному виду, поэтому «0.000% – 4.850%» равно «0.000% -4.850%».
Шаг 6: раздельное тестирование чтения и поиска
Каждый вопрос задается дважды. В режиме чтения модель получает только распарсенную страницу, содержащую ответ, поэтому измеряется качество чтения. В режиме RAG модель получает 5 лучших фрагментов, извлеченных из всех 28 страниц, поэтому измеряется также качество поиска.
Результаты RAG — это медиана из 3 запусков. Все три OCR-парсера прочитали каждую страницу правильно: 81 из 81. С обычным фрагментатором на 1000 символов Datalab и Mistral получают 80, а Reducto — 70, потому что его HTML-таблицы отделяют заголовки от строк. С фрагментатором, учитывающим структуру таблиц, все три получают 77 или 78 — ничья при таком размере выборки. Текстовый слой получает 63, потому что 8 страниц являются сканами без текстового слоя.
Реальная система ищет гораздо больше, чем по 28 страницам, поэтому поиск становится только сложнее. Но этого небольшого корпуса достаточно, чтобы показать, где вывод парсера мешает поиску.
Возврат к шагу 2: более сложные страницы
Чистые документы не позволили различить парсеры, что является признаком того, что ваши документы недостаточно сложны. Поэтому мы вернулись к шагу 2 и добавили более сложный сегмент: 25 реальных сканов из Internet Archive старых канадских годовых отчетов с 1903 по 1983 год, содержащих 95 вопросов. Мы проверили каждый ответ визуально, а большинство — по итоговым суммам, напечатанным на странице.
Теперь результаты чтения различаются. Текстовый слой получает 0, потому что это сканы, состоящие только из изображений. По сегментам: на 10 чистых сканах с 1950 по 1983 год каждый парсер получает 54 из 54. На страницах 1903 года, напечатанных типографским способом, Reducto получает 31 из 48, а остальные — 45 или 46. Широкие альбомные таблицы ломают обычный фрагментатор у всех.
Изучайте эту таблицу внимательно. Мы выбрали 15 из 25 страниц, потому что парсеры выдавали на них разные результаты (в основном Reducto), поэтому эти разрывы больше, чем вы увидели бы на типичных страницах. Мы также продаем один из этих парсеров. Таблица показывает, что более сложные страницы позволяют различить парсеры, а выборка слишком мала и специфична, чтобы ранжировать их.
Шаг 7: прочтите каждый случай сбоя и найдите его причину
Это анализ ошибок. Читайте сообщения об ошибках, записывайте, что пошло не так, и группируйте их. Три примера, каждый с разным решением:
- Заголовок отделен от значения. Вспомните вопрос об Apple. При использовании обычного фрагментатора таблица в формате Markdown с отступами поместила заголовок и итоговое значение в разные фрагменты. Затем модель выполнила собственные вычисления и ответила «около $89,100 млн», что является правдоподобным, но неверным числом. Решением стала опция вывода: компактные таблицы.
- Ошибка невидимого символа. Reducto записал метку строки «BHE» кириллическими буквами. Визуально они идентичны, но поиск по «BHE» не находит их. Вопрос по BHE провалился во всех 6 запусках RAG.
Решения заключаются в настройке фрагментатора, проверке текста и парсере, который считывает цифры, и одна лишь оценка не подскажет вам, что именно нужно исправить.