Когда вы извлекаете значение из документа, вы хотите его проверить. До сих пор цитаты извлечения в Datalab указывали на блок: абзац или всю таблицу, из которой было взято значение. Для итоговой суммы в таблице счета из 40 строк это означало, что вам приходилось самостоятельно искать нужную ячейку.
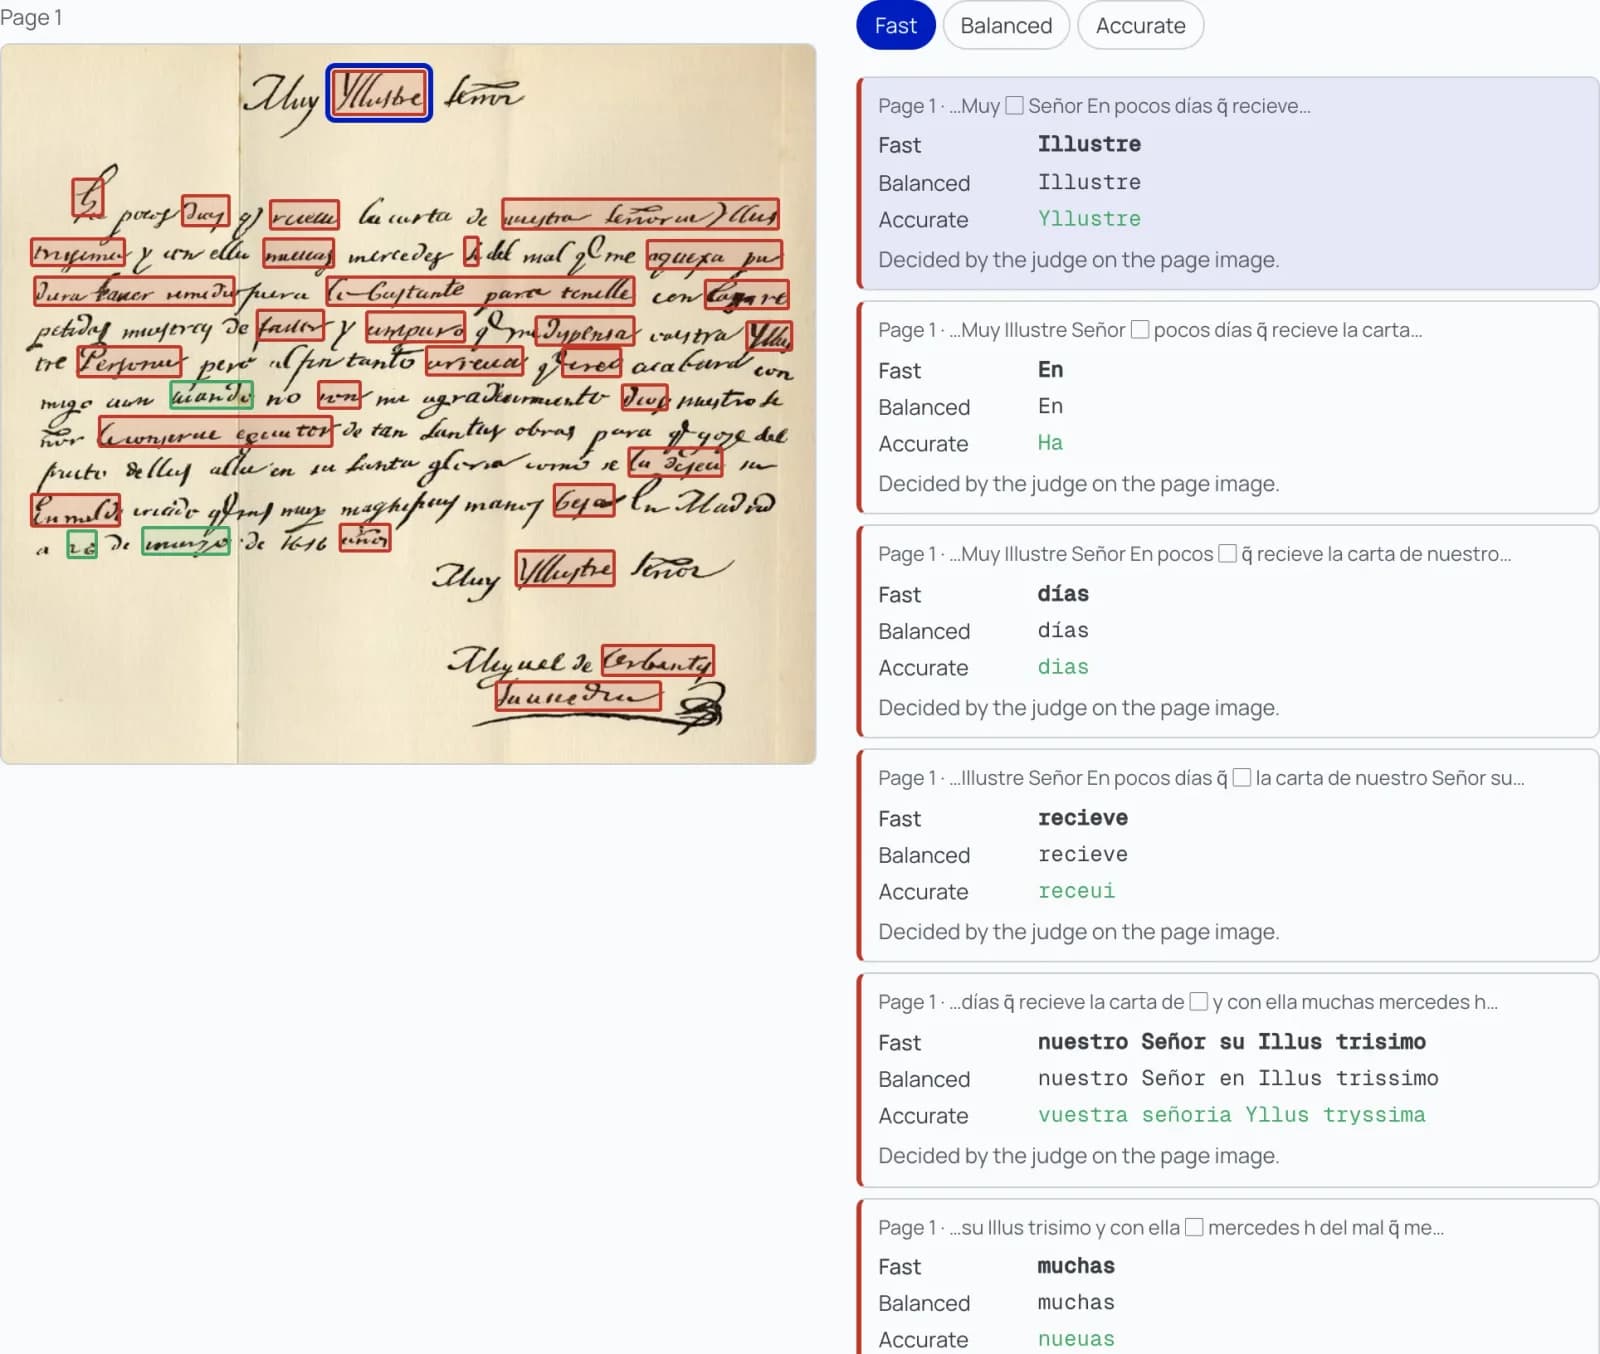
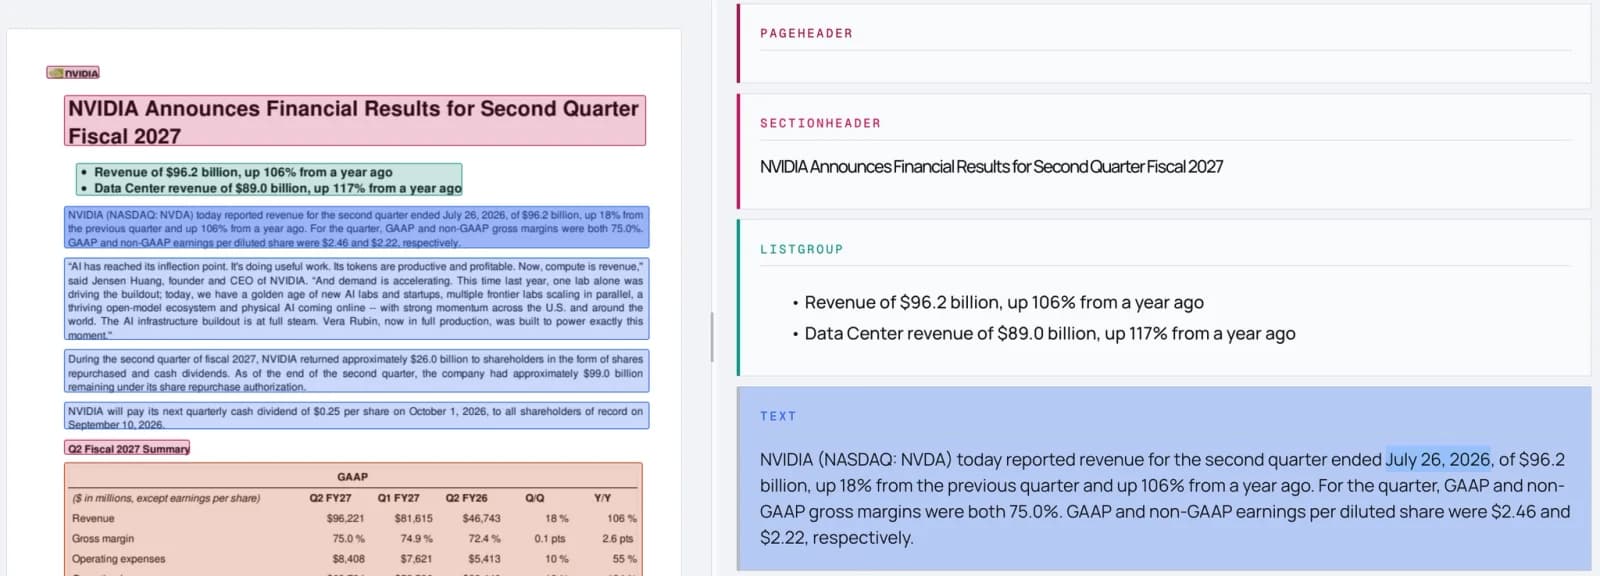
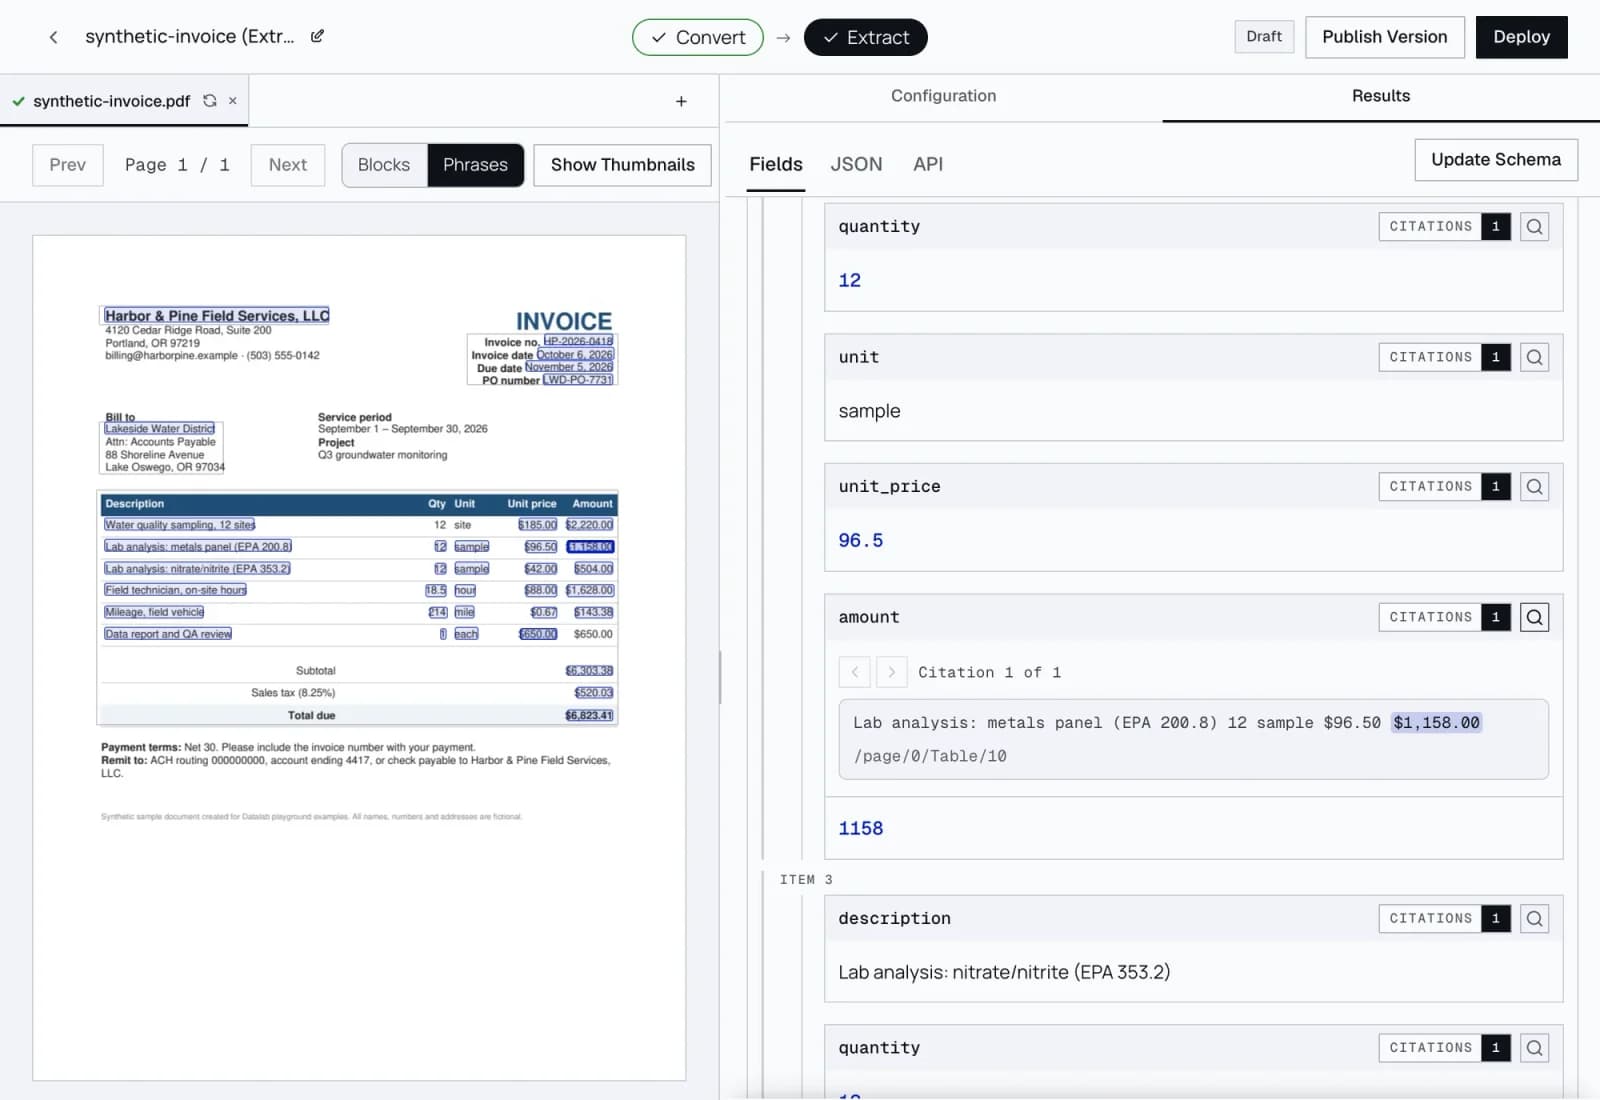
Теперь каждое значение указывает на точные слова или ячейку таблицы, из которой оно было получено. Выберите поле в песочнице, и рамка будет выделять сумму, а не всю таблицу. Когда мы применили фразовые цитаты к 1,6 миллионам цитируемых значений из 2952 недавних производственных извлечений, 91% из них совпали с точными словами или ячейкой таблицы в цитируемом блоке. Для медианного извлечения этот показатель составил 89%.
Что сообщает вам цитата
Каждая фразовая цитата предоставляет текст, с которым произошло совпадение на странице, местоположение этого текста в блоке и рамку вокруг него. В таблице рамкой является ячейка. Значение, занимающее более одной строки, получает рамку для каждой строки.
Она также предоставляет оценку совпадения. Оценка 1.0 означает, что значение напечатано на странице с учетом регистра, интервалов и формата записи числа или даты: «1,234.50» на странице соответствует 1234.5 в вашем результате, а «March 3, 2024» соответствует 2024-03-03. Более низкая оценка означает близкое совпадение, и песочница отображает это как «Close match» (близкое совпадение) с указанием оценки.
Когда система не может определить местоположение значения, она не угадывает
Некоторые значения невозможно привязать к словам: ответ «да/нет», категория или короткое значение, например «1», которое встречается десять раз в столбце, и в строке нет ничего, что позволило бы их различить. Для таких случаев цитата сохраняет только блок и страницу. Она никогда не рисует рамку вокруг слов, которые лишь «похожи» на правильные.
Это предназначено для финансового или юридического специалиста, который проверяет ваши результаты. Выделение неверной «1» хуже, чем отсутствие выделения, потому что это создает видимость того, что неверный ответ был проверен.
Вычисленные значения ссылаются на свои входные данные
Некоторые поля нигде не напечатаны: сумма всех позиций, количество подписантов, итог по всем страницам. Теперь вычисленное значение ссылается на блоки, из которых оно было вычислено, поэтому вы можете проверить итог по строкам, из которых он состоит.
Больше значений получают цитаты
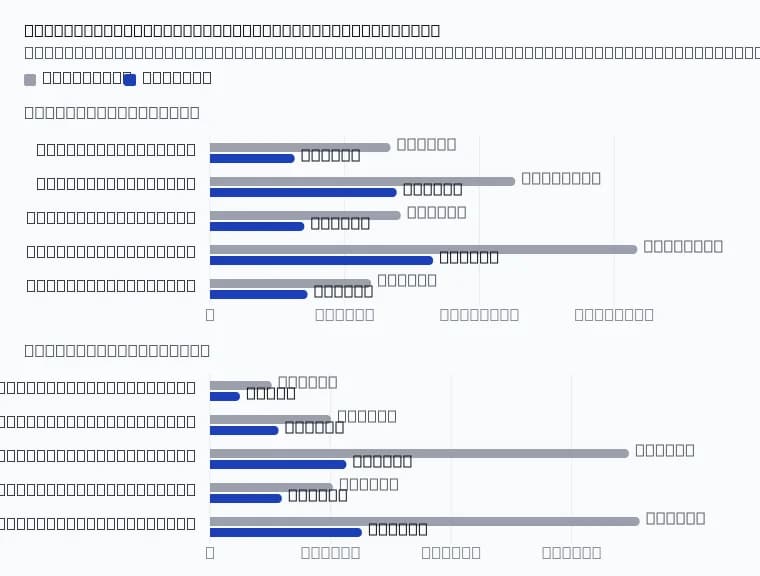
Теперь больше результатов возвращается с цитатой. В LongExtractBench, публичном бенчмарке из 50 длинных документов, доля значений с цитатой выросла в среднем с 69% до 76% на документ. Уровень успешности сохранился: 176 из 200 прогонов документов прошли успешно с этим изменением, против 170 без него, что является разницей в пределах статистической погрешности.
На выборке из 40 документов OmniExtractBench доля значений с цитатой выросла с 78,6% до 79,3%, а точность осталась прежней: 93,7 с изменением и 93,9 без него, что находится в пределах погрешности.
Без дополнительной оплаты
Фразовые цитаты предоставляются бесплатно.
Попробуйте
В песочнице запустите извлечение. Фразовые цитаты включены по умолчанию: переключайтесь между «Blocks» (Блоки) и «Phrases» (Фразы) на панели инструментов страницы, и каждое поле покажет свою подтверждающую цитату. Через API установите citation_granularity="phrase" в запросе /extract. Значение по умолчанию остается "block". Полный формат описан в документации.
Фразовые цитаты находятся в стадии открытого бета-тестирования, и формат цитирования может измениться.
Как мы проводили измерения
LongExtractBench: 50 публичных документов, четыре прогона с изменением и четыре без него на одних и тех же серверах. Документ считается пройденным, если не менее 90% извлеченных значений верны и восстановлено не менее 85% эталонных строк. Покрытие цитированием — это доля извлеченных значений хотя бы с одной цитатой, усредненная по документу для всех 50 документов. OmniExtractBench: фиксированная выборка из 40 документов, пропущенная через наше производственное извлечение, с изменением и без него.