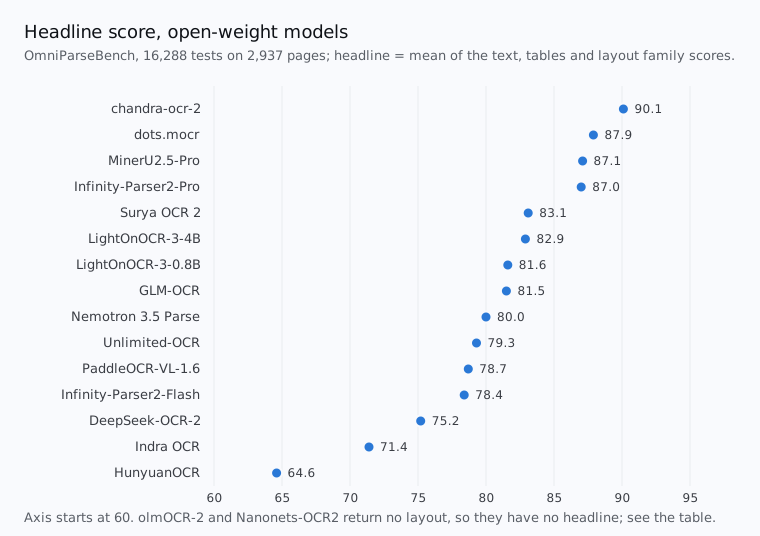
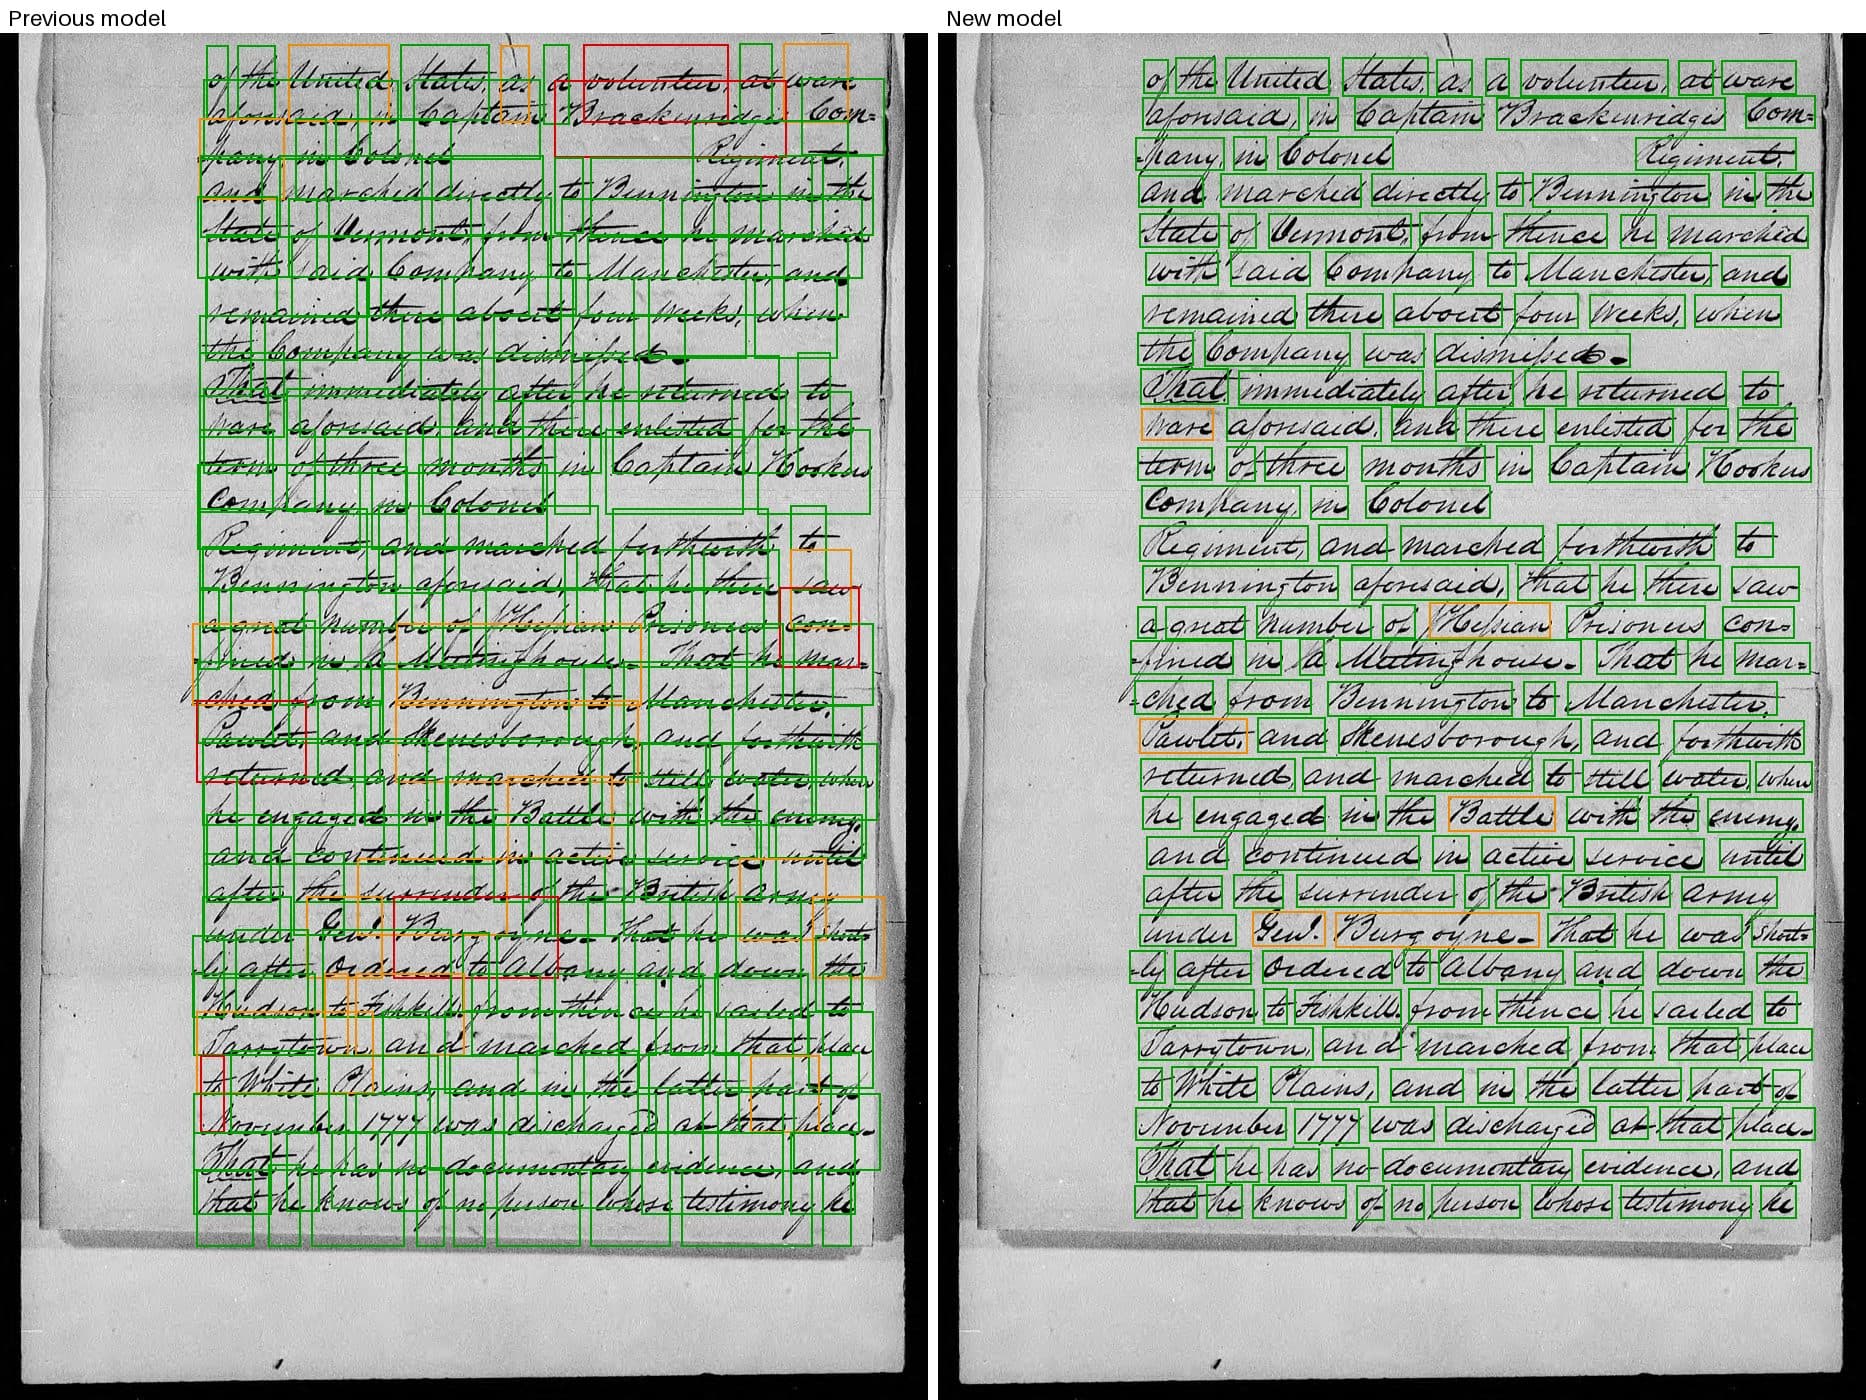
Мы выпускаем Surya 2.5: она в 1,7 раза быстрее Surya 2 и является самой точной открытой OCR-моделью с количеством параметров менее 1 млрд. Она обрабатывает 4,5 страницы в секунду на одной карте H100 по сравнению с 2,7 у Surya 2 (рис. 1) и набирает 85,9 балла в OmniParseBench, что является наивысшим показателем среди всех открытых моделей ее размера (рис. 2). Модель имеет 689 млн параметров, открытые веса и практически никогда не зацикливается.
Вот что появилось нового:
- В 1,7 раза быстрее: 4,5 страницы в секунду на одной H100 по сравнению с 2,7 у Surya 2 с MTP
- Лучшая открытая модель до 1B: 85,9 в OmniParseBench по сравнению с 83,3 у Surya 2; таблицы — 78,3 против 74,3
- olmOCR-bench: 83,7 против 82,8
- Зацикливание: 0,1% запросов зацикливаются до достижения лимита вывода по сравнению с 3,8% у Surya 2 с MTP
- Многоязычность: паритет по тексту на 91 языке, улучшение по таблицам (58,1 против 54,5); на 21 языке набрано 90% и более по сравнению с 15
- Более крупный словарь: 88 526 токенов, включая эмодзи и математические символы, которые Surya 2 не умела писать; на одну страницу уходит в 2,6 раза меньше токенов
- Лицензия: такая же, как у Surya 2: код — Apache 2.0, веса — измененная OpenRAIL-M (бесплатно для исследований, личного использования и стартапов с доходом до $5 млн)
Получить:
- Веса модели
- Песочница — попробуйте Chandra 2.5, нашу более крупную и точную модель, на собственных документах
- API
Результаты других моделей взяты из карточки датасета OmniParseBench, каждый запуск выполнен с рекомендованными поставщиком настройками (настройки для конкретных моделей); Surya 2.5 запускалась аналогичным образом. Количество параметров указано общее в выпущенных весах. olmOCR-2 и Nanonets-OCR2-3B не возвращают разметку, поэтому у них нет общего результата.
Почему мы ее создали
Surya 2 — компактная и точная модель, но у нее было три недостатка. В ее словаре не было токенов для эмодзи, а также для полужирных, курсивных и других стилизованных математических символов, поэтому она не могла их выводить. На каждую страницу у нее уходило много токенов. Кроме того, на нескольких процентах страниц модель зацикливалась, пока не достигала ограничения по токенам.
Surya 2.5 имеет более крупный словарь и более компактный формат страницы. Словарь содержит токен для каждого эмодзи из основных блоков Unicode и каждого стилизованного математического символа, а также около 20 000 частых многосимвольных юнитов, и при этом по-прежнему может писать все символы, которые умела Surya 2. Благодаря обоим улучшениям на запись страницы требуется в 2,6 раза меньше токенов. Кроме того, Surya 2.5 практически никогда не зацикливается.
Результаты бенчмарков
OmniParseBench
OmniParseBench — это наш открытый бенчмарк для парсинга: 16 288 тестов на прохождение/непрохождение по 2 937 страницам на 92 языках, оцениваемых программным путем без использования моделей-судей. Общий балл представляет собой среднее значение оценок текста, таблиц и разметки.
Все 2 937 страниц; обе модели работали через surya-ocr 0.23.0 при 192 DPI с включенным восстановлением всей страницы, поэтому страница с зацикливанием перезапускалась; по одному запуску для каждой. Интервалы представляют собой 95%-ные бутстрэп-интервалы по страницам. Подробности приведены в приложении.
Surya 2.5 лидирует во всех трех категориях; наибольший прирост наблюдается в таблицах (+4,0).
Среди других открытых моделей Surya 2.5 имеет самый высокий балл среди моделей с числом параметров менее 1 млрд (рис. 2) и лучший балл разметки среди всех открытых моделей (95,7).
olmOCR-bench
Среднее значение по трем запускам для каждой модели с одинаковым тестовым окружением и настройками (ревизия olmOCR-bench 54a96a6). С постпроцессингом бенчмарка PP3 от LightOn общие оценки составляют 83,6 и 84,2.
Surya 2.5 показывает чуть более высокий общий результат, причем наиболее заметный прирост наблюдается на многоколоночных страницах. Старые сканы остаются самой сложной категорией для обеих моделей.
Многоязычность
Мы также оцениваем модели на нашем внутреннем бенчмарке из 91 языка, который охватывает точность распознавания текста, разметку, таблицы, формулы и порядок чтения в документах на каждом из языков.
Общий процент успешных прохождений: 74,9% для Surya 2.5 против 74,5% для Surya 2 на 91 языке (36 089 тестов) на более новой и сложной версии бенчмарка по сравнению с 87,2% в посте о Surya 2. Точность текста находится на том же уровне; прирост достигнут за счет таблиц: +3,6 балла (от +2,0 до +5,3). На 21 языке набрано 90% или более (Surya 2: 15), а на 52 языках — 80% или более (47).
Топ-15 наиболее распространенных языков:
Процент успешных прохождений — это доля тестов, завершившихся успешно. Обе модели работали через surya-ocr 0.23.0 при 192 DPI, по одному запуску; интервал для таблиц рассчитан с помощью парного бутстрэпа на уровне страниц. Полная таблица для 91 языка находится в репозитории Surya.
На что способна модель
Surya 2.5 читает страницу целиком за один проход и возвращает каждый блок с указанием его типа, позиции на странице и содержимого: текст и заголовки, таблицы в формате HTML, уравнения в формате LaTeX, подписи, а также верхние и нижние колонтитулы в порядке чтения. Приведенные ниже примеры представляют собой публичные страницы из OmniParseBench, обработанные с помощью bf16 GGUF в llama.cpp на Mac при 192 DPI; на каждом показана страница целиком, фрагмент и вывод Surya 2.5 для этого фрагмента.
Пропускная способность
Surya 2.5 обрабатывает в 1,7 раза больше страниц в секунду, чем Surya 2 с MTP при 192 DPI, и в 2,3 раза при 96 DPI; при 300 DPI разница сокращается до 1,15 раза. Хвостовая задержка (tail latency) снижается еще сильнее: p95 составляет 11,3 с против 26,0 с.
Одна карта H100, vLLM 0.25.1, одинаковые настройки сервера и 300 страниц OmniParseBench для каждой модели. Страницы в секунду, задержка и токены на страницу измерялись при 32 одновременных запросах; срабатывания ограничения по токенам суммировались для 1, 8, 32 и 128 одновременных запросов. Время указано только для сервера модели (страницы рендерились заранее), а показатель страниц в секунду учитывает только те страницы, обработка которых завершилась до достижения лимита токенов. Зависимость задержки от DPI и степени параллелизма приведена в приложении.
Apple Silicon
На чипе M4 Max с использованием llama.cpp (Metal) Surya 2.5 обрабатывает в 3,1 раза больше страниц в секунду, чем Surya 2, при примерно той же скорости генерации токенов в секунду, поскольку она выводит значительно меньше токенов на страницу. Все страницы Surya 2.5 были успешно обработаны; Surya 2 достигла лимита токенов на 4 страницах из 32.
Apple M4 Max с 36 ГБ памяти, питание от сети; llama.cpp bbeb89d, llama-server --parallel 8; OCR всей страницы при 96 DPI; 16 публичных страниц OmniParseBench, два раунда; показатель страниц в секунду учитывает полностью обработанные страницы. Пиковое потребление памяти относится к процессу сервера.
Запуск Surya 2.5
Интерфейс остался прежним по сравнению с Surya 2: менеджер запускает сервер при первом использовании и останавливает его при завершении команды (флаг --keep_server оставляет его запущенным). В surya-ocr версии 0.23.0 и новее Surya 2.5 используется по умолчанию. На графических процессорах NVIDIA менеджер запускает vLLM в Docker; если вы устанавливаете vllm самостоятельно, держите его в отдельной среде, так как пакет фиксирует версию OpenCV, которую vLLM не поддерживает.
Для достижения наивысшей точности без развертывания инфраструктуры можно использовать API Datalab для запуска Chandra 2.5.
Ограничения
- Отсутствие координат таблиц. Surya 2.5 возвращает таблицы только в формате HTML. Задача определения структуры таблиц, возвращающая координаты строк и столбцов, не поддерживается; для этого используйте Surya 2.
- Сложные страницы остаются сложными. Старые сканы набирают 44,3 балла в olmOCR-bench, а арабский язык — 45,4% в нашем многоязычном бенчмарке, что соответствует уровню Surya 2.
Приложение: сведения о воспроизводимости
Пропускная способность
Настройка. Один графический процессор NVIDIA H100 80GB HBM3 на запуск (драйвер 580.126.09). vLLM 0.25.1 для каждого запуска, GPU не используется ничем другим, формат bf16, если не указано иное. Для всех серий используются одинаковые настройки сервера (флаги ниже); Surya 2 с MTP отличается только конфигурацией спекулятивного декодирования (speculative decoding). Кэширование префиксов и кэш мультимодального процессора отключены, поэтому ни одна страница не получает преимуществ от предыдущих запросов.
Рабочая нагрузка. 300 публичных страниц OmniParseBench, отрендеренных из PDF с каждым целевым разрешением DPI и подогнанных под ограничение модели в 3072×2048 пикселей. OCR всей страницы с одинаковым промтом для обеих моделей, жадное декодирование (greedy decoding), ограничение вывода в 12 288 токенов.
Измерение. Фиксированное число параллельных запросов (1, 8, 32 и 128), причем новый запрос отправляется по мере завершения каждого предыдущего. Мы проводим измерения в течение 120-секундного окна после 30-секундного периода разгона и учитываем запросы, которые начались в этом окне, включая медленные и завершившиеся с ошибкой. Задержка измеряется от начала до конца с точки зрения клиента. Страница считается завершенной только в том случае, если обработка завершилась до достижения лимита токенов. Тесты запускаются в случайном порядке, а опорные тесты повторяются три раза для оценки шума между запусками.
Полные флаги vLLM: --dtype bfloat16 --max-model-len 24576 --max-num-seqs 256 --max-num-batched-tokens 8192 --enable-chunked-prefill --kv-cache-dtype auto --gpu-memory-utilization 0.85 --no-enable-prefix-caching --mm-processor-cache-gb 0 --limit-mm-per-prompt '{"image": 1}' --mm-processor-kwargs '{"min_pixels": 3136, "max_pixels": 6291456}'. Surya 2.5 — это datalab-to/surya-ocr-2.5 в версии, выпущенной вместе с весами, Surya 2 — это datalab-to/surya-ocr-2 в ревизии 3b3d4cdf. Для обеих моделей не задана строка остановки.
Задержка в зависимости от DPI и параллельности.
Медианная задержка на страницу (с), 32 параллельных запроса
Задержка p95 на страницу (с), 32 параллельных запроса
Страниц в секунду в зависимости от параллельности, 192 DPI
Задержка p95 на страницу (с) в зависимости от параллельности, 192 DPI
Бенчмарки
OmniParseBench и многоязычный набор. Один запуск на модель, без строки остановки, один B200 на запуск, публичный скрипт оценки v1.0.0. Ревизия датасета 56a3c4f7.
- Обе модели: запуск через предварительную сборку surya-ocr 0.23.0 с собственными промптом и декодированием пакета, на сервере vLLM 0.25.1, настроенном с параметрами лаунчера пакета для этого GPU, при 192 DPI, с включенным восстановлением целых страниц (по умолчанию в пакете выключено): страница, которая зацикливается или не может быть разозвана, запрашивается повторно с повышением температуры до шести раз, после чего читается блок за блоком. Surya 2 — это datalab-to/surya-ocr-2 в ревизии 3b3d4cdf.
- Сканирование DPI (рис. 3): Surya 2.5 через обычный сервер vLLM 0.20.1, с запросом один раз на страницу без восстановления, при 96, 150, 192 и 300 DPI (промпт: «OCR this image to HTML. Each block is a div with data-label and data-bbox (x0 y0 x1 y1, normalized 0-1000).»; температура 0, лимит 32 768 токенов); Surya 2 через surya-ocr 0.22.1 при тех же разрешениях, где для некоторых точек потребовались возобновленные запуски, а точка 300 DPI объединяет запуск с MTP и без него. Эти точки показывают характер компромисса; в таблицах сравнения выше для обеих моделей используется одна и та же настройка.
olmOCR-bench. Инструментарий datalab (пакет surya25), ревизия olmOCR-bench 54a96a6f (1403 страницы), vLLM 0.25.1 на нашем собственном сервере с отключенным MTP, один B200, лимит 12 384 токена, 24 параллельных запроса, цифры как данные, температура 0 и top-p 0.1, без строки остановки, три прогона на модель на одном сервере. Основным результатом является вывод чистой модели; рядом с ним приводится постпроцессинг PP3. Парные интервалы для каждого теста при первом запуске (95%): общие +0,89 (от +0,03 до +1,76), многоколоночные +1,92 (от +0,46 до +3,56), таблицы +3,42 (от −0,60 до +7,69); остальные категории находятся в пределах погрешности.
Если у вас есть отзывы или вы хотите интегрировать Surya 2.5 в свой рабочий процесс, напишите на [email protected] или найдите Вика в Твиттере.