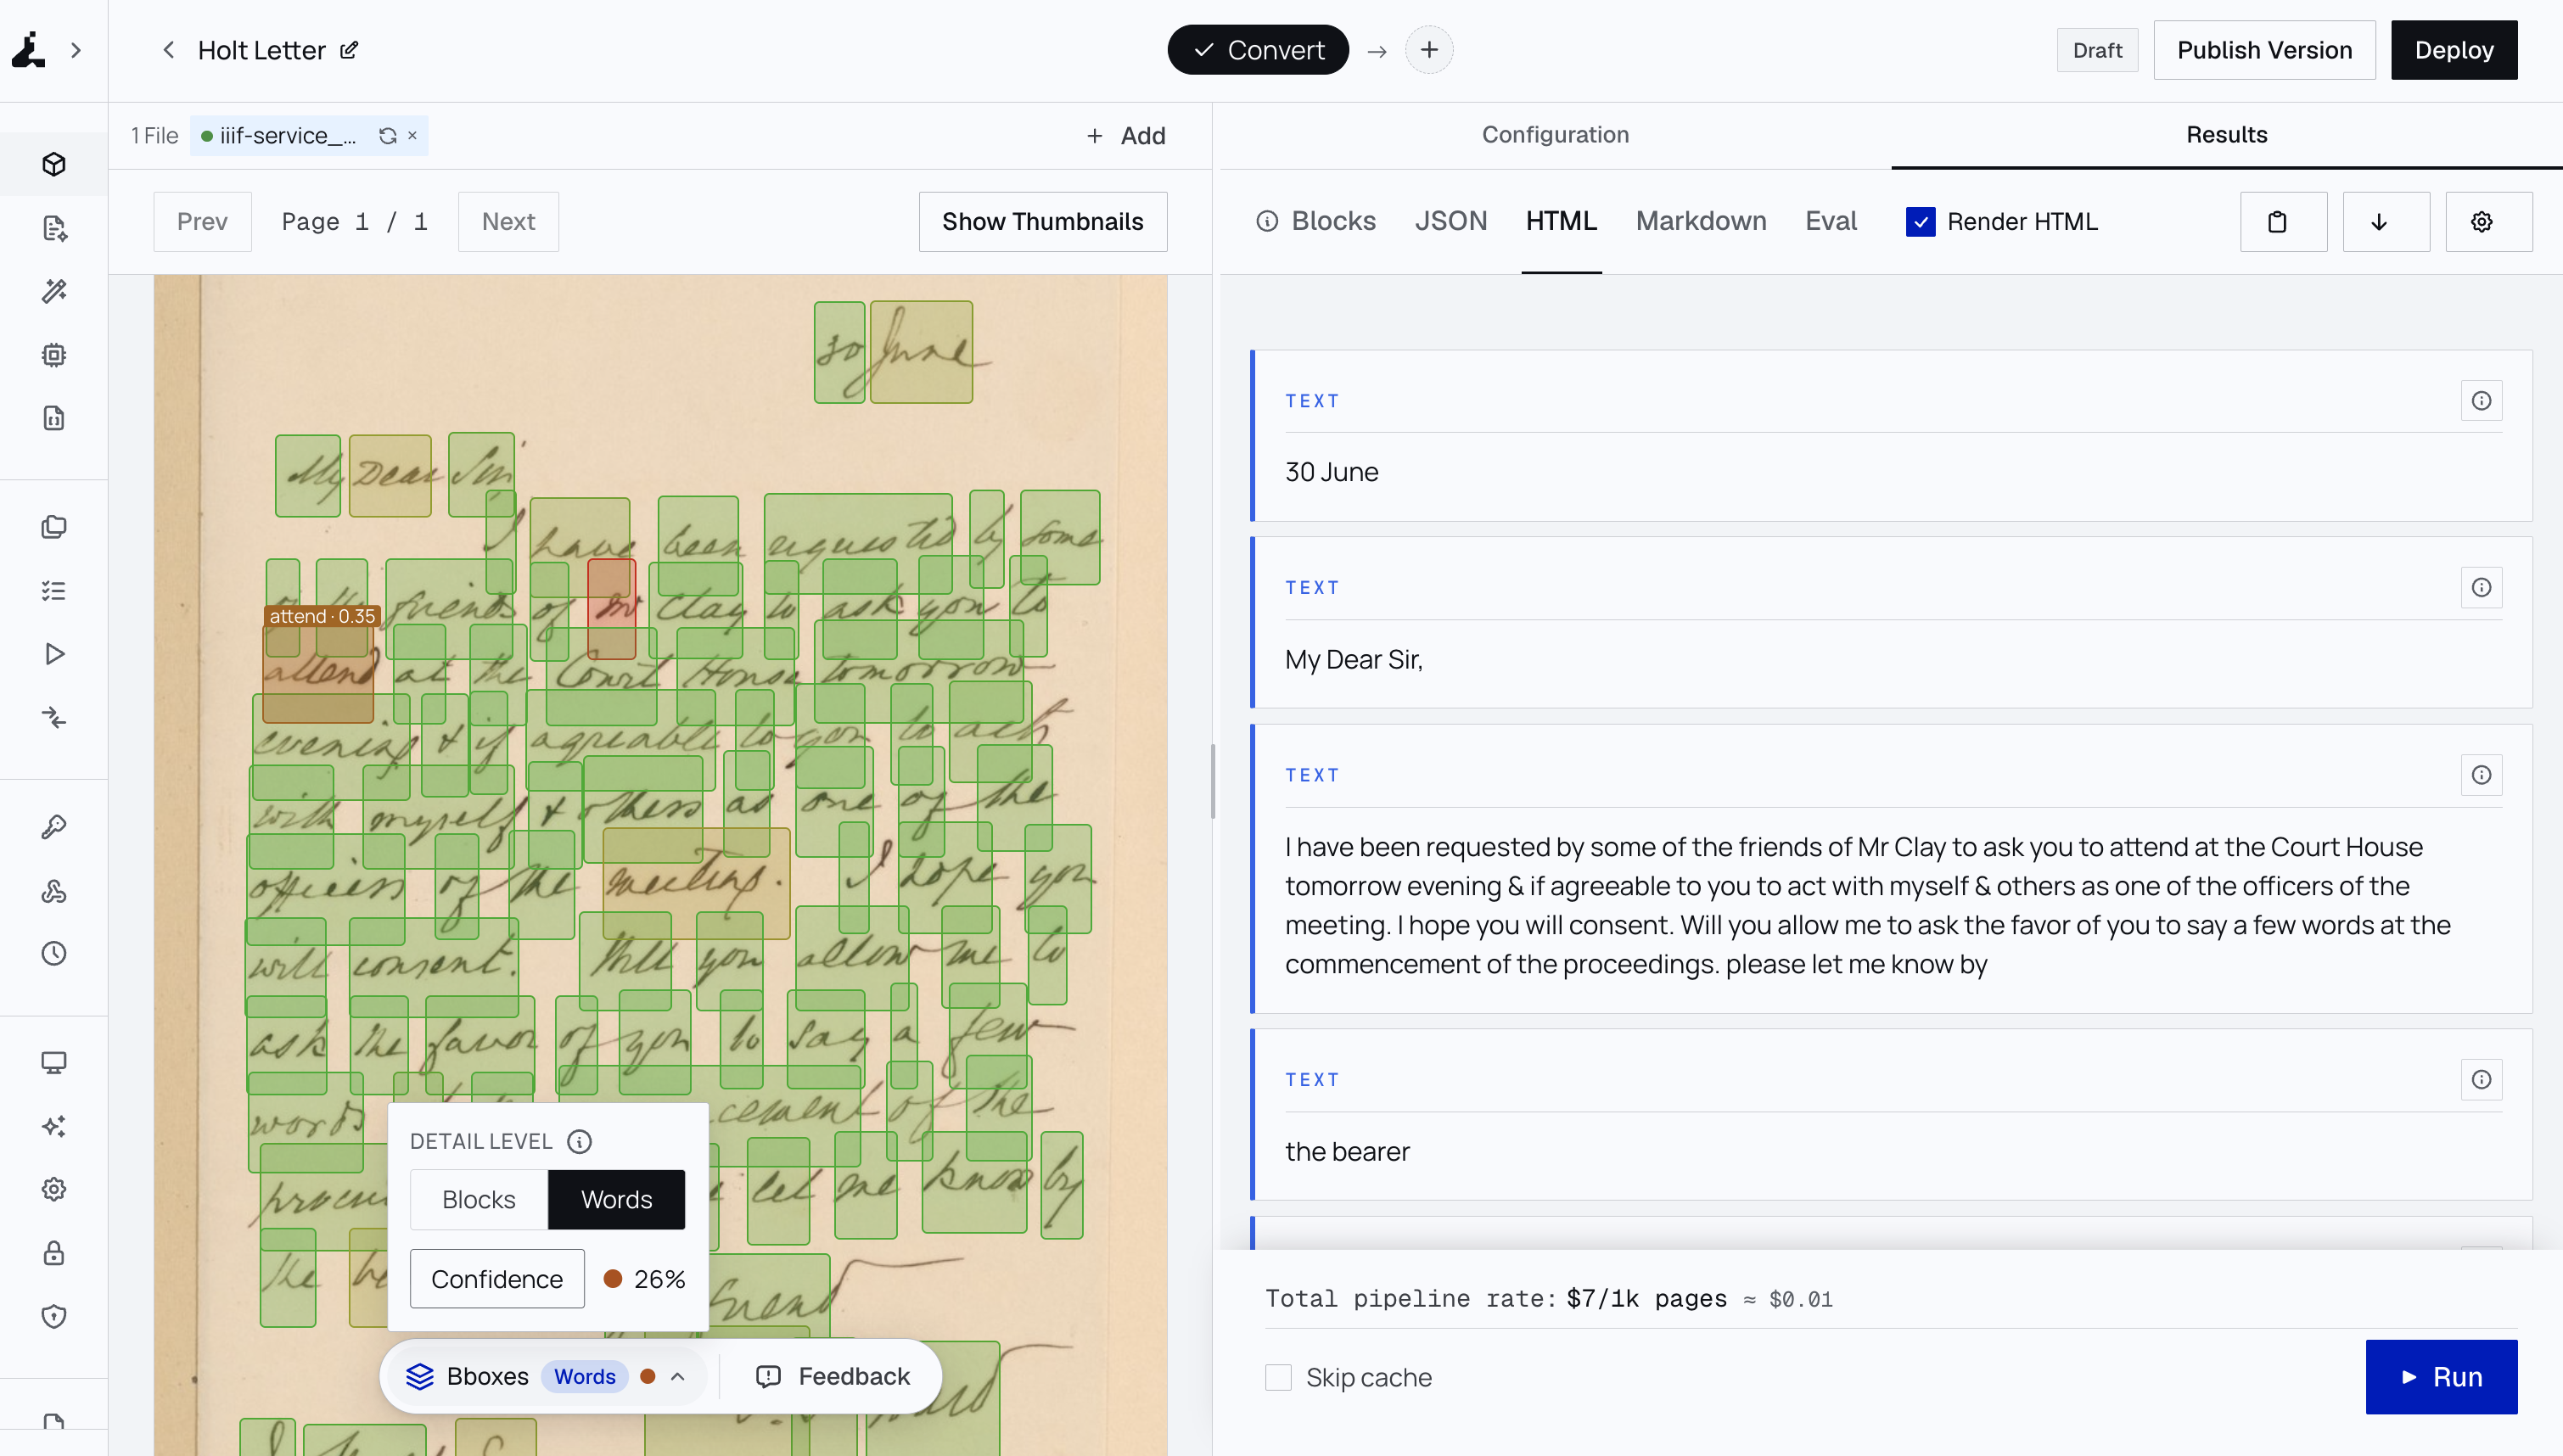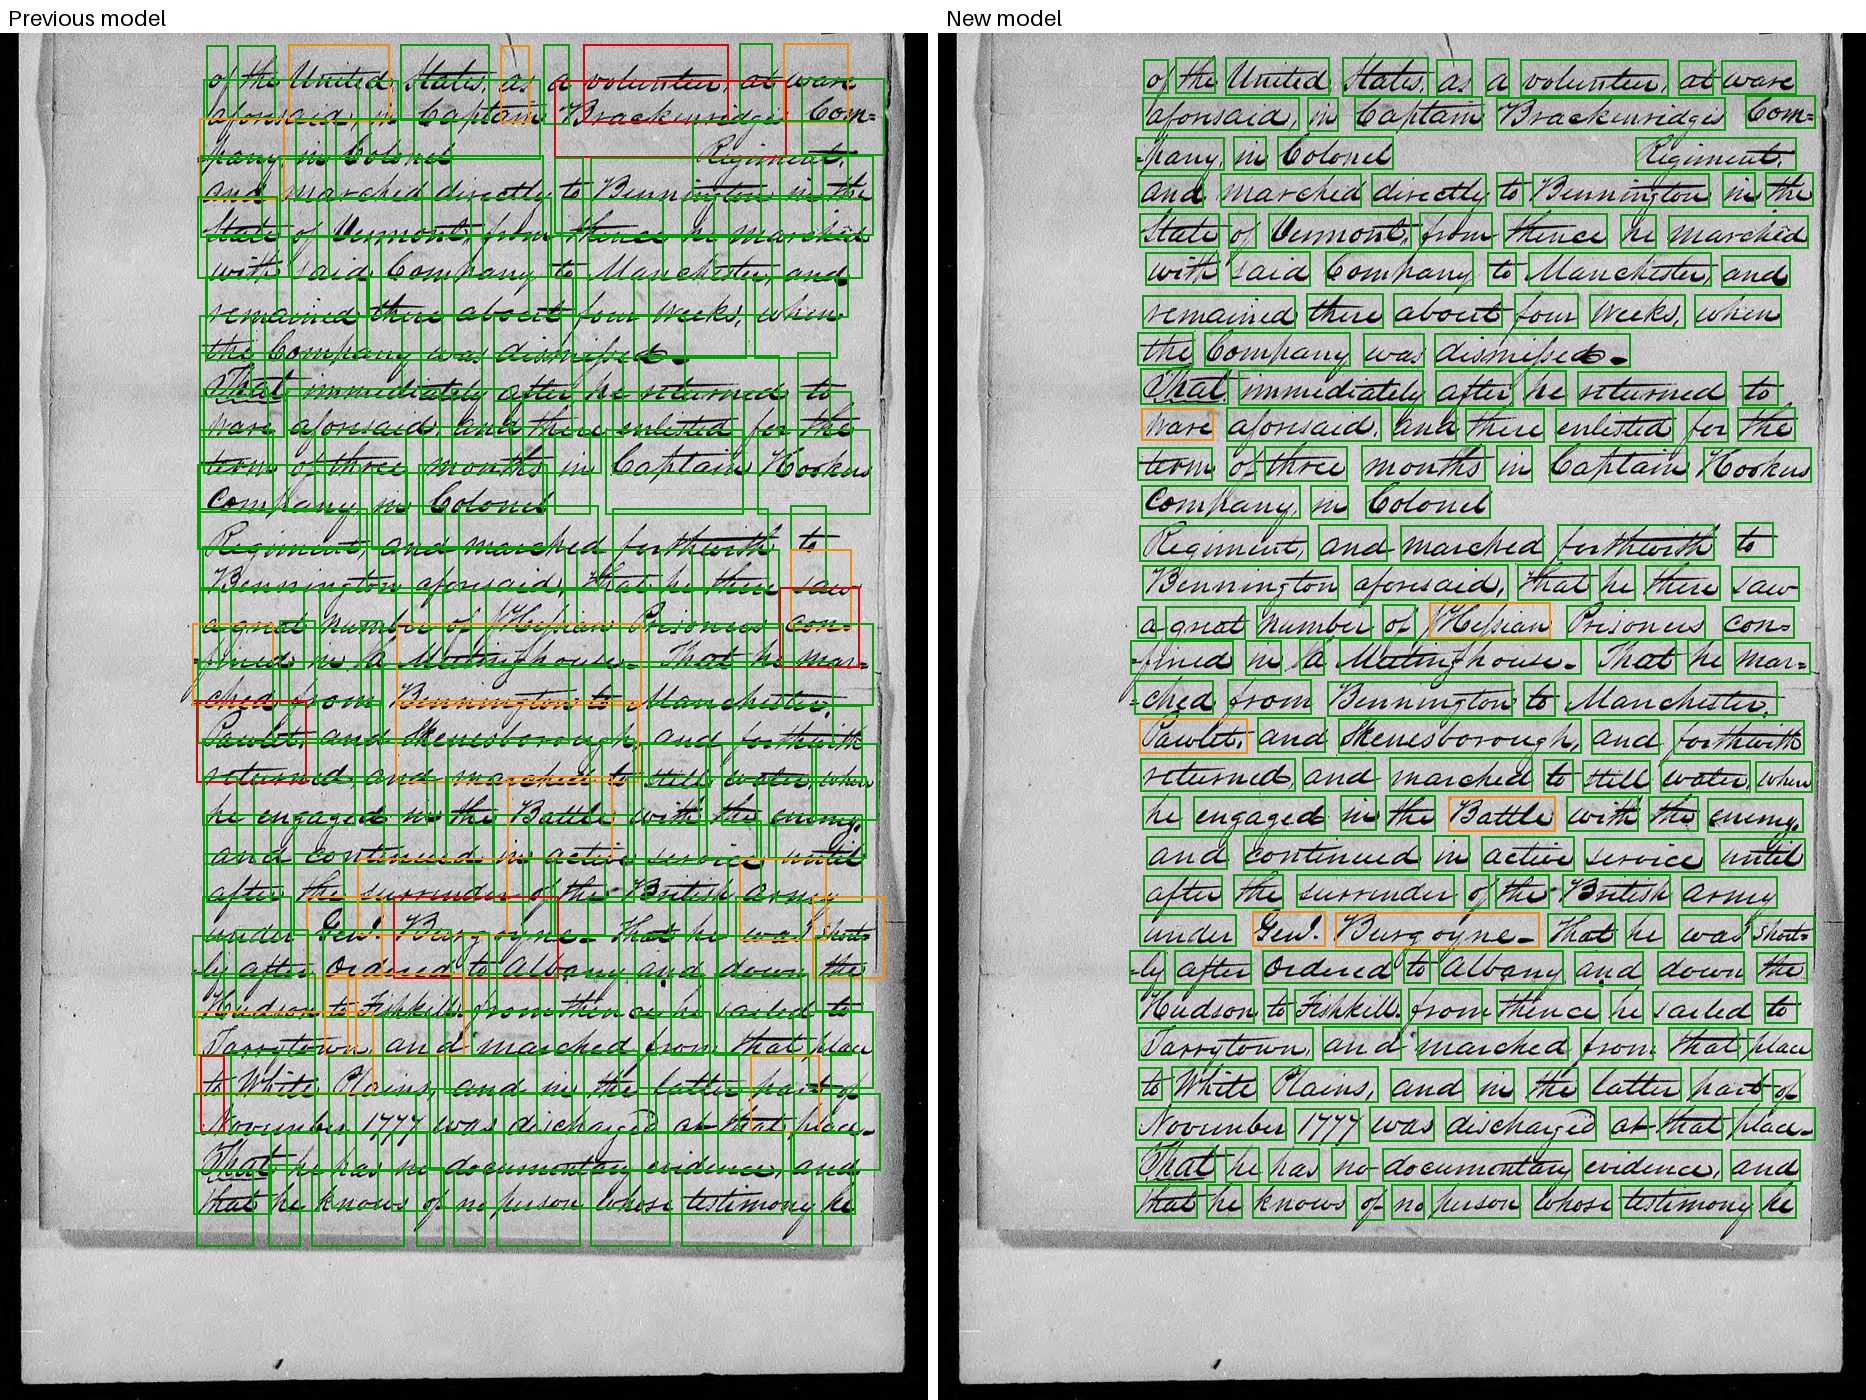
Наша новая модель рамок слов уже доступна в API. На реальных рукописных и отсканированных страницах 93% слов теперь получают корректную рамку (ранее этот показатель составлял 60%), а вероятность того, что правильно распознанные слова будут помечены как имеющие низкую достоверность, значительно снизилась.
Рамки слов и показатели достоверности уже хорошо работали на чистых печатных страницах. Однако на рукописном тексте и старых сканах они были гораздо менее эффективны. Рамки смещались на следующее слово или строку, а многие правильно распознанные слова получали низкую оценку достоверности, из-за чего очереди на проверку заполнялись текстом, который не требовал повторного просмотра.
До и после
Декларация о получении пенсии времен Войны за независимость США из Национального архива США (общественное достояние). Слева: предыдущая модель. Справа: новая модель. Цвет рамки обозначает достоверность слова: зеленый — 0,9 и выше, оранжевый — от 0,5 до 0,9, красный — ниже 0,5.
Измерено с помощью нашего производственного кода на контрольных рукописных и отсканированных страницах в сравнении с эталонными рамками слов. Задержка осталась прежней.
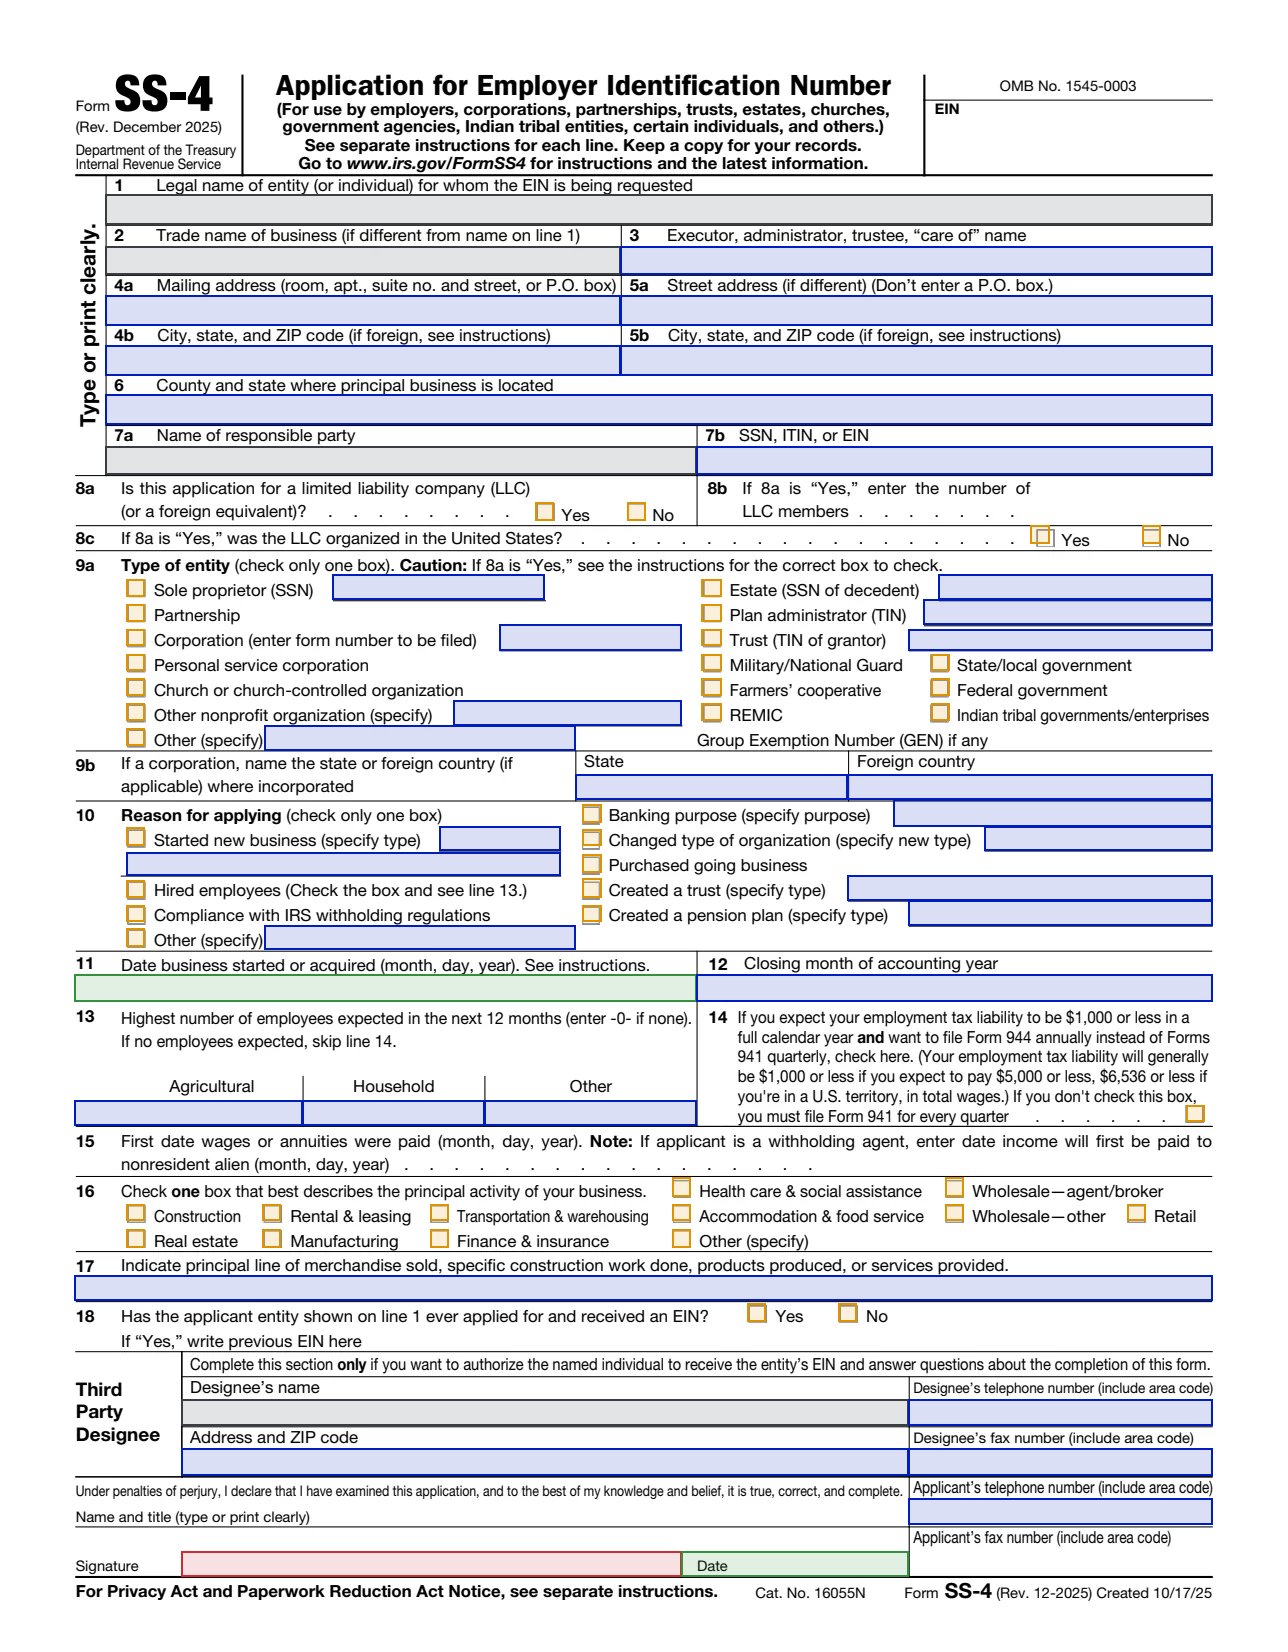
Отсканированные формы также стали обрабатываться лучше. Вот две печатные формы, заполненные от руки:
Заявление на получение паспорта США 1910 года (общественное достояние, через Wikimedia Commons). Слева: предыдущая модель. Справа: новая модель. Рамки предыдущей модели накладываются друг на друга вокруг штампа и рукописных записей. Новая модель выделяет каждое печатное и рукописное слово отдельно, хотя некоторые рукописные слова все еще получают оранжевую или красную оценку.
Регистрационная карточка призывника Первой мировой войны Коула Портера из Национального архива США (общественное достояние, через Wikimedia Commons). Слева: предыдущая модель. Справа: новая модель.
Достоверность, на которую можно положиться
Низкая достоверность должна означать «проверьте это слово». В случае с рукописным текстом это часто означало «это рукописный текст»: 4,4% правильно распознанных слов получали оценку ниже 0,5. В новой модели этот показатель составляет 0,8%, поэтому очередь на проверку, основанная на достоверности, содержит гораздо меньше слов, которые были распознаны верно.
Свидетельство о браке из тех же пенсионных дел. Новая модель выделяет каждое слово в отдельную рамку. Она не идеальна: несколько рамок все еще перекрываются в последних строках над подписью, а некоторые слова по-прежнему получают оранжевую или красную оценку.
Что нужно проверить
Изменений в API нет. Включите word_bboxes, как и раньше, и рамки с достоверностью вернутся в тех же атрибутах data-bbox и data-confidence. Новая модель работает в наших регионах США и ЕС.
Значения достоверности на рукописных и отсканированных страницах будут выше, чем раньше, поскольку гораздо меньше правильных слов получают низкую оценку. Достоверность страницы, которая определяется словами с наименьшим баллом, также возрастает. Если вы настраивали порог проверки на старых оценках, проверьте его на примере своих собственных страниц.
Попробуйте сами
Пропустите рукописное письмо или старый скан через песочницу с включенными рамками слов. Если в вашем архиве есть страницы, где рамки все еще работают некорректно, мы хотели бы их увидеть: [email protected].