Версия Chandra 2.5 уже доступна в API Datalab, и все режимы (быстрый, сбалансированный и точный) работают на ней. Вам не нужно ничего менять, чтобы начать ее использовать.
Вот что изменилось по сравнению с Chandra OCR 2.4, моделью, которую она заменяет:
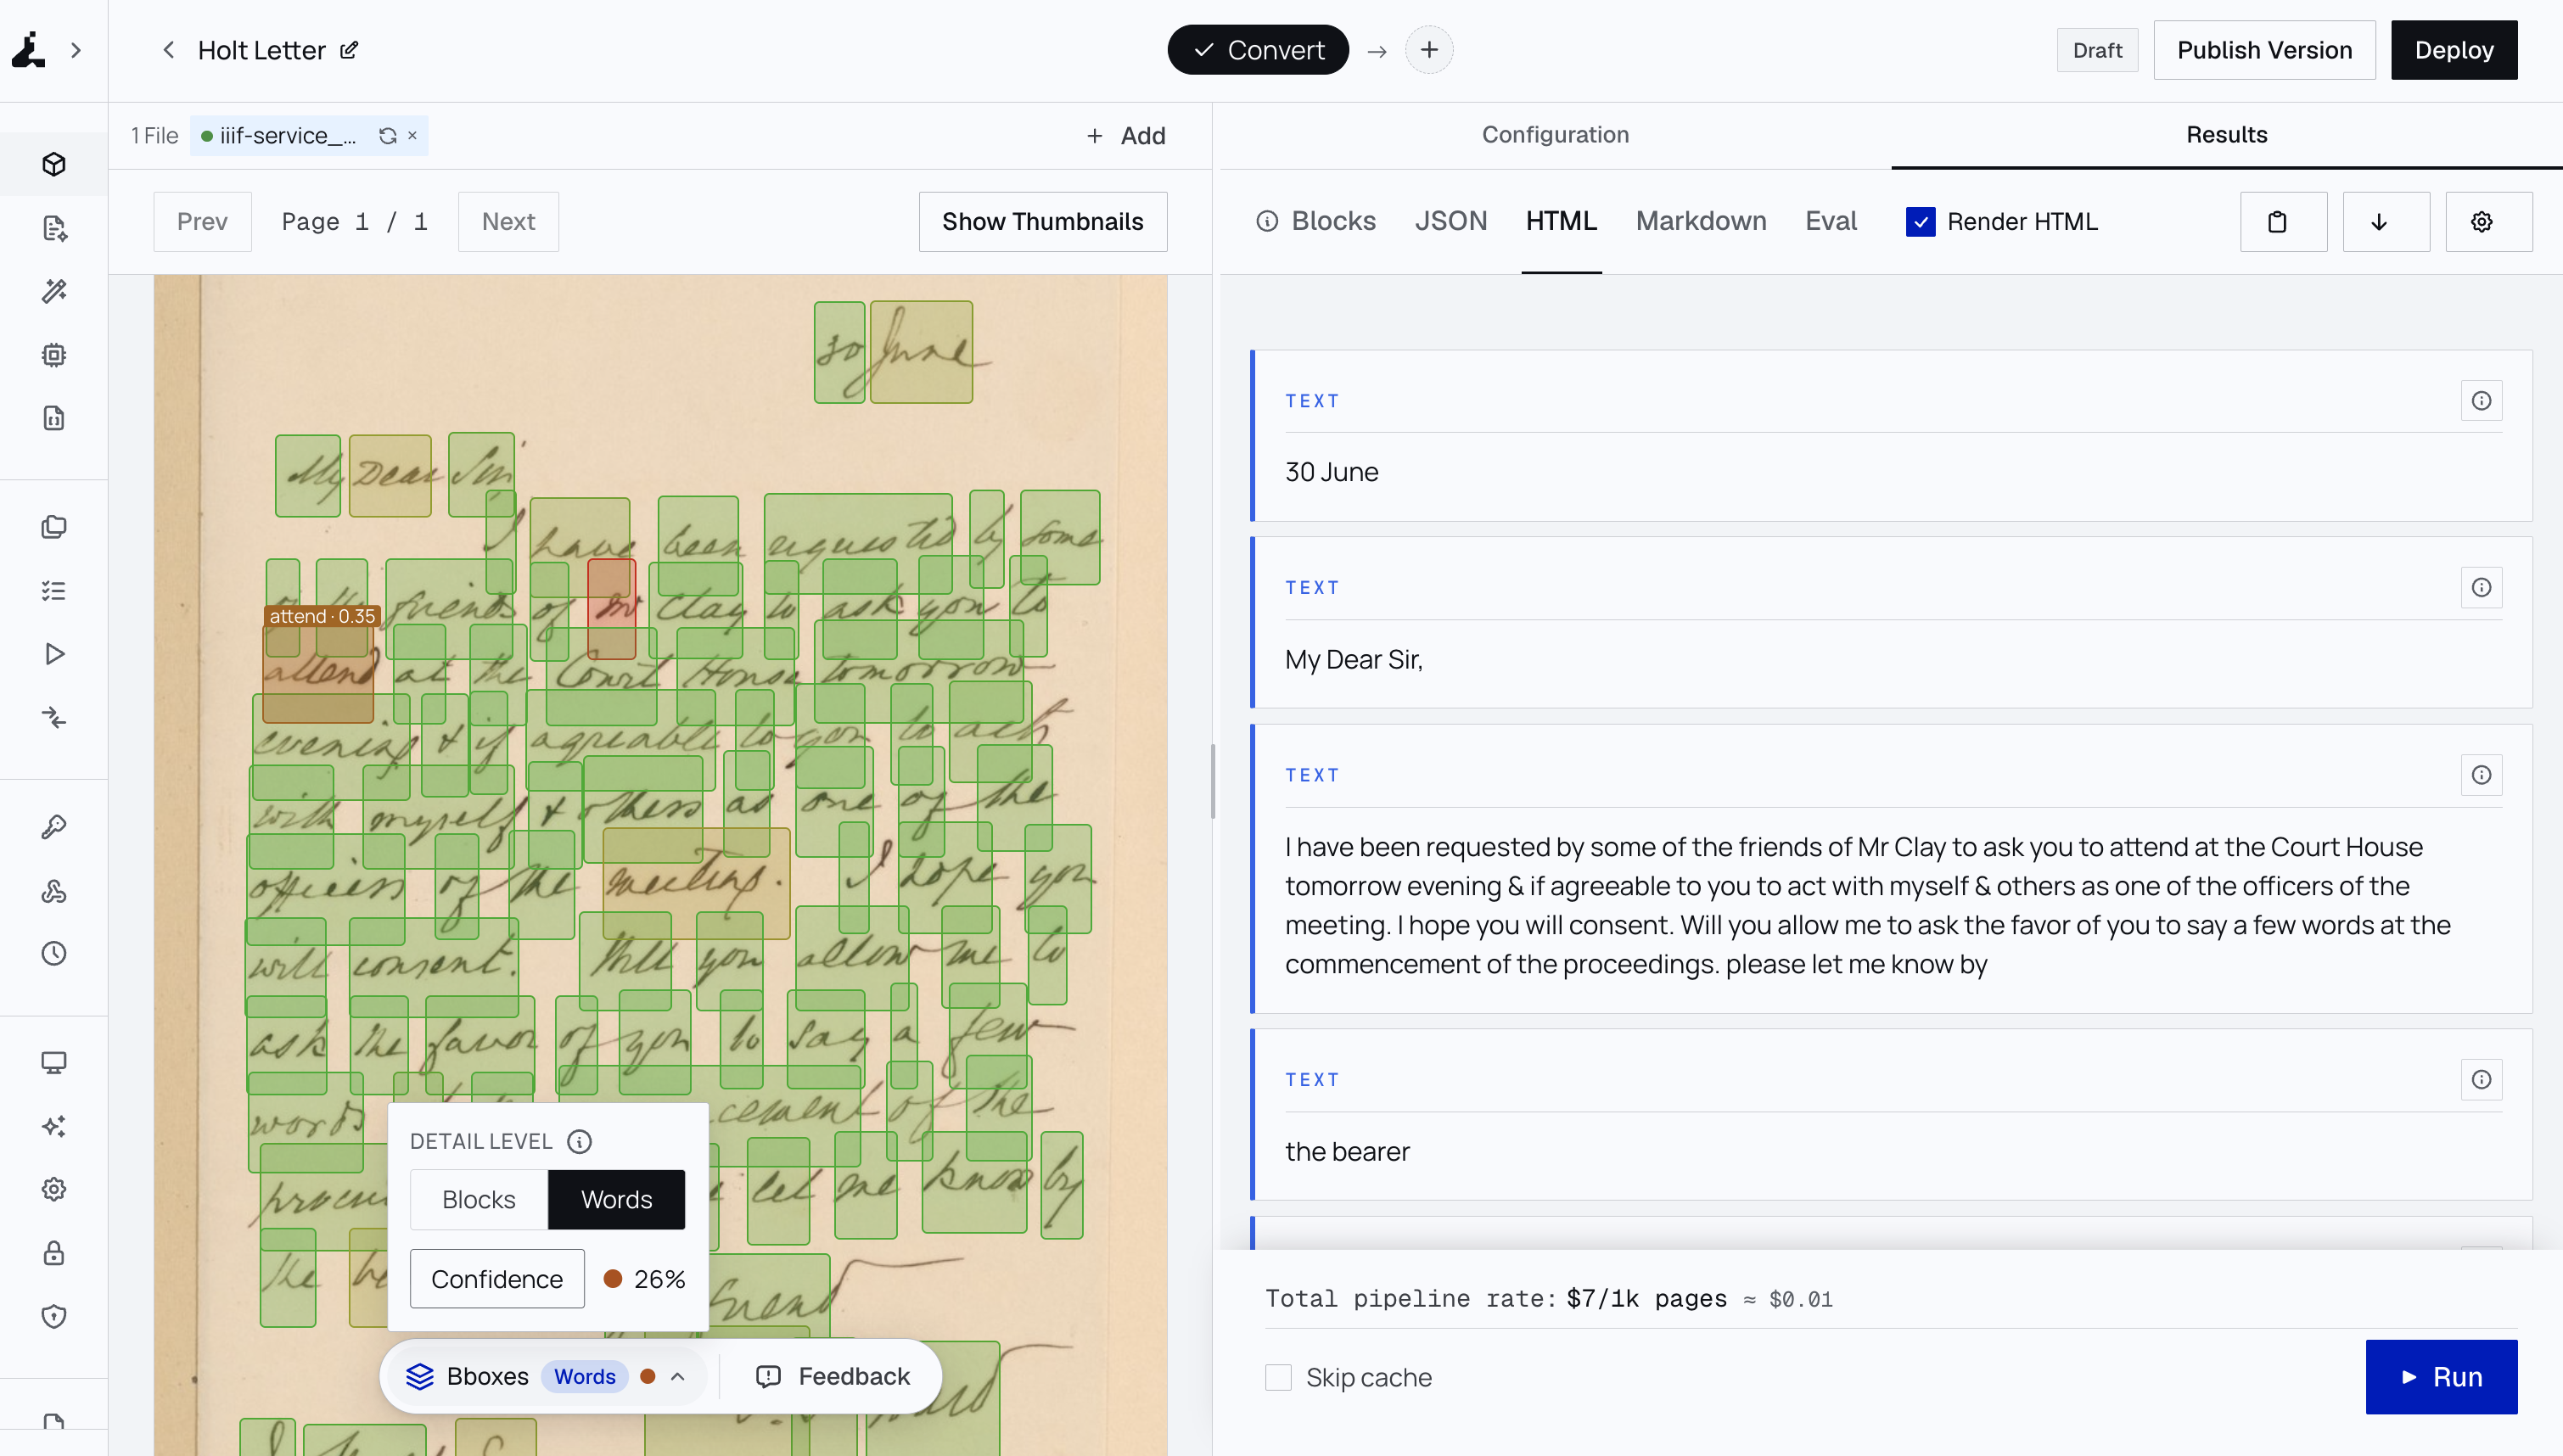
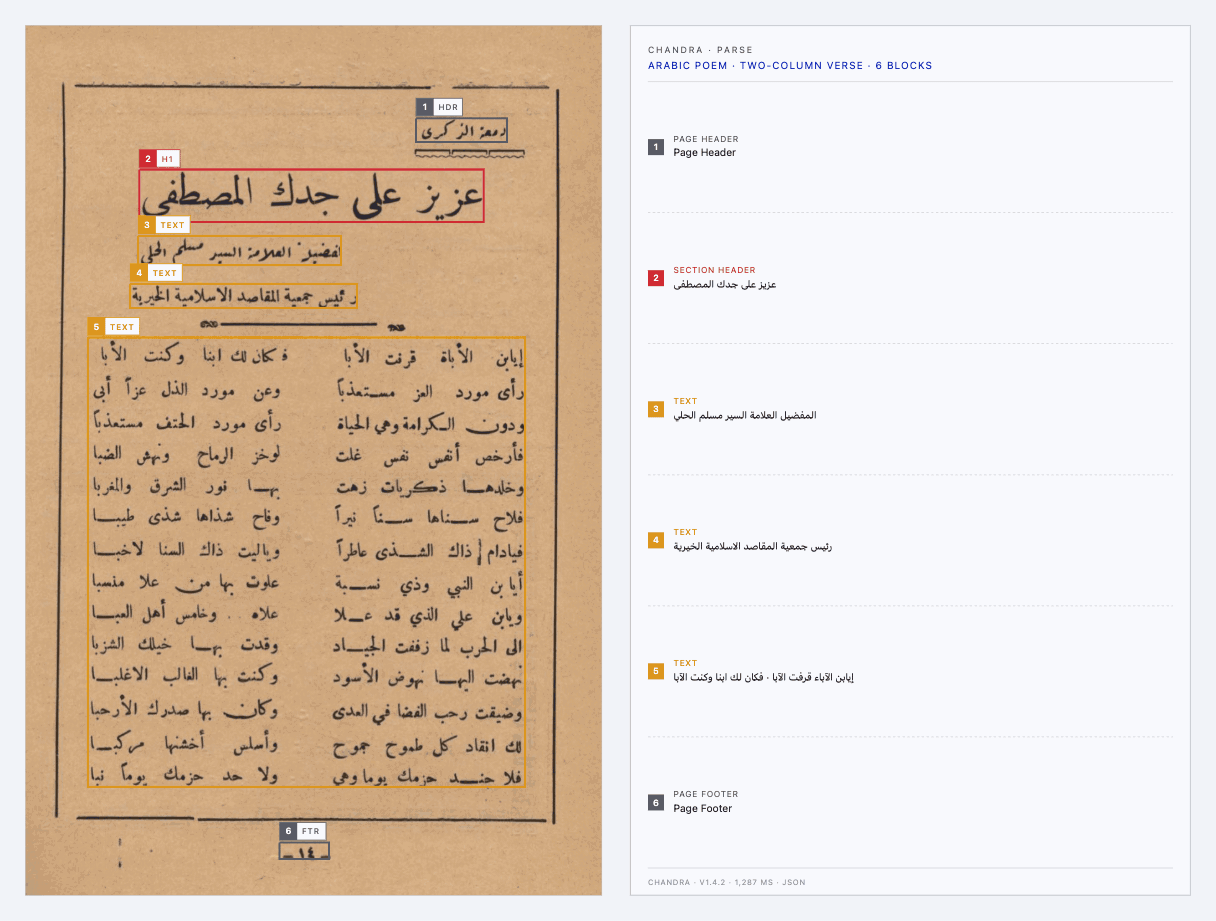
- Описания изображений в едином формате. Каждый график, диаграмма и фотография теперь возвращаются с одинаковыми шестью полями, включая значения графиков и дословный текст внутри рисунка. В выводе JSON и фрагментах они находятся в новом поле «image».
- На 38% меньше зацикливаний. Chandra 2.5 зацикливается на 38% реже, чем Chandra OCR 2.4 на нашем тестовом наборе, и лучше читает повернутые страницы.
- Быстрее в любом режиме. Медианная задержка для одной страницы снизилась на 40–43% во всех режимах. В сбалансированном режиме время сократилось с 12,9 с до 7,5 с.
Описания изображений в едином формате
Chandra OCR 2.4 описывала каждый рисунок свободным текстом: атрибут alt и блок прозы без фиксированных полей. Поэтому структура вывода менялась от рисунка к рисунку.
Chandra 2.5 записывает каждый рисунок в единой структуре, всегда в одном и том же порядке:
Поле имеет значение null, если в рисунке нет соответствующих данных. Вывод в форматах Markdown и HTML сохраняет свою текущую структуру.
Вот гистограмма из отчета Министерства образования США:
Рисунок 5 из «Характеристики учителей государственных школ», The Condition of Education 2023, Национальный центр статистики образования.
Chandra 2.5, сбалансированный режим, поле «image»:
Каждое значение соответствует графику, включая небольшой спад после 25–29 лет. Код может опираться на эту структуру: считывать данные для значений графиков, mermaid для диаграмм и текст для подписей, пропуская прозу.
Чтобы получить поле:
Точность
Chandra 2.5 более надежна на сложных страницах и занимает верхние строчки в двух публичных бенчмарках.
Меньше зацикливаний. Зацикливание — это когда модель OCR повторяет одну и ту же строку или ячейку таблицы вместо того, чтобы двигаться дальше. На нашем тестовом наборе Chandra 2.5 зацикливается на 38% реже, чем Chandra OCR 2.4.
Повернутые страницы. Chandra 2.5 читает страницы, отсканированные боком или вверх ногами.
OmniParseBench. На прошлой неделе мы выпустили OmniParseBench, открытый бенчмарк для парсинга, содержащий 16 288 тестов на прохождение/отказ на 2 937 страницах на 92 языках. С этого момента мы будем сообщать о результатах релизов на нем. С Chandra 2.5 Datalab в точном режиме набирает 92,7 балла, а в сбалансированном — 91,6:
* Использовалось при создании и проверке по крайней мере некоторых тестов. Полные результаты и инструмент для оценки любого среза бенчмарка находятся в публикации об OmniParseBench.
olmOCR-bench. Chandra 2.5 набирает 87,4 балла в olmOCR-bench по сравнению с 86,2 баллами у Chandra OCR 2, нашей модели с открытым исходным кодом. Обе используют PP3 от LightOn — постобработку бенчмарка, используемую в недавних результатах LightOnOCR и Infinity Parser (она включает математические правила из кода оценки Infinity Parser). Мы не считаем постобработку, специфичную для бенчмарка, хорошей практикой, поэтому вот «сырые» баллы: с собственной постобработкой каждой модели и с использованием PP3:
Наши запуски: olmocr 0.4.27, olmOCR-bench ревизия 54a96a6. Верхние и нижние колонтитулы исключены. Собственная постобработка LightOnOCR — это исправление экранированных долларов от LightOn, и столбец PP3 включает его, как и в собственных результатах LightOn. Цифры LightOnOCR-3-4B — это наша репродукция конвейера LightOn. LightOn сообщает о 86,3.
Быстрее в любом режиме
Chandra 2.5 работает быстрее в любом режиме. Вот чего ожидали пользователи API (сквозное время: загрузка, постановка в очередь, полный конвейер и получение результата) для каждого успешного запроса по одной странице к конечным точкам convert и marker:
Запросы по одной странице к /convert и /marker, сквозное время, за неделю до и после релиза.
Медианная задержка ниже на 40–43% во всех режимах, а задержка p90 — на 34–51% ниже.
Попробуйте
Chandra 2.5 доступна в API и в песочнице. Для локальных развертываний свяжитесь с нами по адресу [email protected].
Если у вас есть сложные документы, которые вы хотите, чтобы мы протестировали, отправьте их на [email protected] или найдите меня в Twitter.