Борьба с лженаукой в больших масштабах
Даниэль Акуна — доцент Университета Колорадо в Боулдере. Он также является основателем ReviewerZero AI, платформы проверки достоверности исследований для издателей, редакторов и профильных команд.
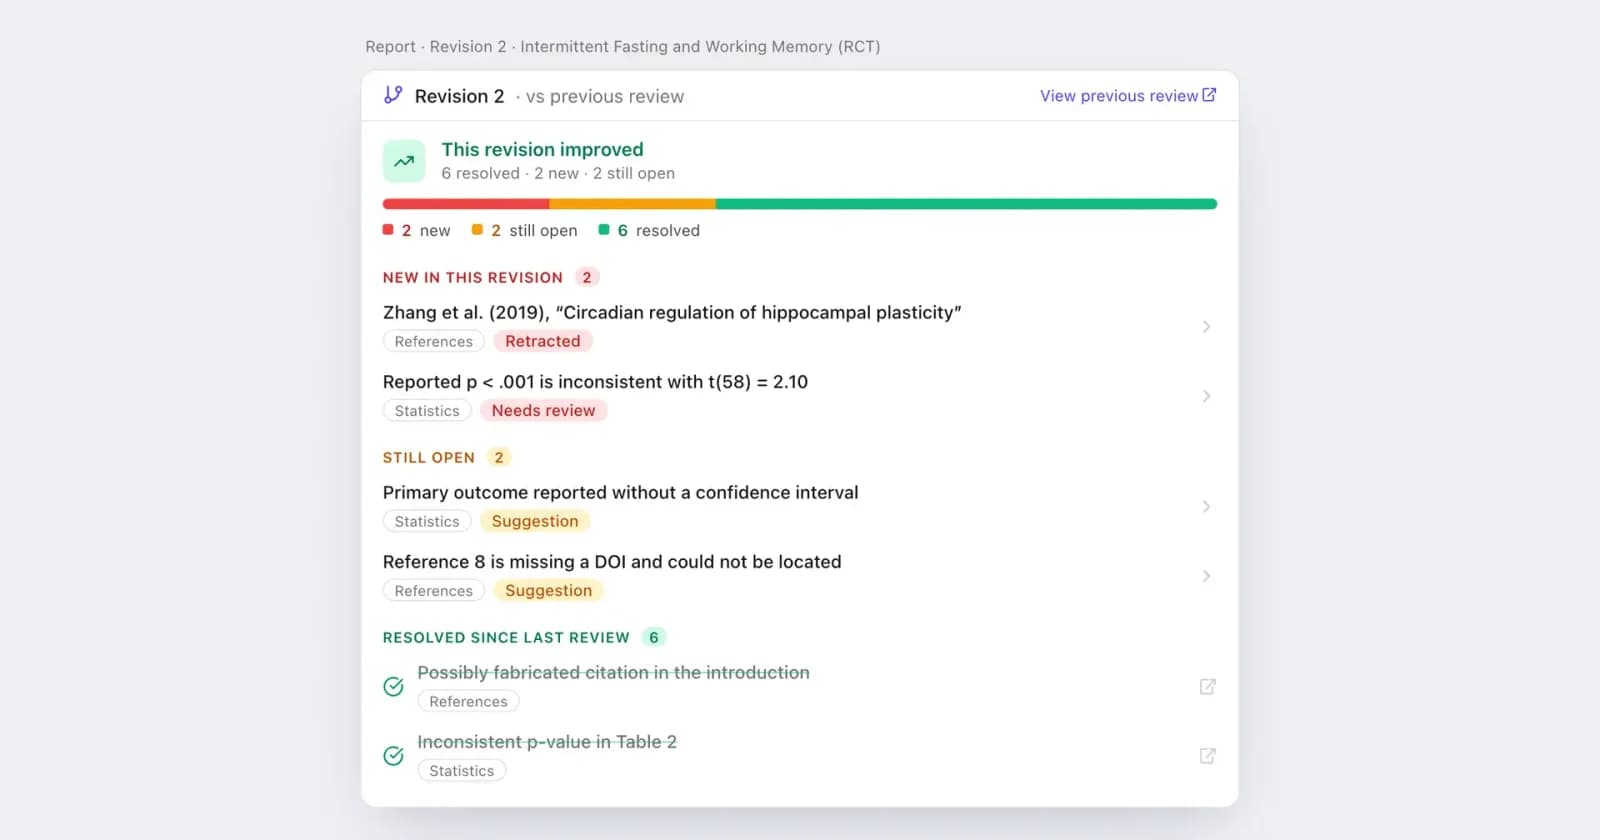
ReviewerZero выполняет более 65 проверок по 12 аспектам достоверности, включая изображения, статистику, ссылки, воспроизводимость, экспертную оценку, и отслеживает каждый флаг до его первоисточника. Когда ReviewerZero сообщает редактору о проблеме в статье, редактор должен увидеть доказательства прямо на странице.
Команда глубоко погружена в две самые сложные проверки: статистические ошибки и галлюцинирующие ссылки. Совсем недавно они добавили таблицы. Все три зависят от одного успешного шага: превращения неструктурированного научного PDF-файла в проверяемый, надежный текст.
Проблема: ложное срабатывание — это обвинение
Галлюцинирующие ссылки бывают двух видов. Во-первых, существует ли цитата, которой вообще нет в документе? Второй тип более тонкий: название может быть настоящим, но авторы вымышлены. Это происходит, когда LLM придумывает правдоподобные имена вместо использования реальных. Для автора обвинение в использовании сфабрикованных ссылок имеет реальные последствия, например, запрет на публикацию в архивах препринтов.
Это серьезное заявление, а значит, точность не подлежит обсуждению.
«Обвинять кого-то в галлюцинирующей ссылке проблематично», — объясняет Даниэль. — «Нам нужны нулевые ложные срабатывания».
«Обвинять кого-то в галлюцинирующей ссылке проблематично», — объясняет Даниэль. — «Нам нужны нулевые ложные срабатывания».
Сложность в том, что большинство ложных срабатываний происходят из-за парсера. Если PDF-файл распарсен неверно, настоящая ссылка выглядит фальшивой. Даже передовые LLM могут неверно прочитать DOI, из-за чего легитимная цитата кажется сгенерированной галлюцинацией.
Научные статьи особенно сложны, потому что в них сочетаются плотный текст, рисунки, таблицы и длинные списки литературы. Таблицы и ссылки часто разрываются на стыках страниц. На рисунках часто бывает несколько панелей. Некоторые материалы состоят из сотен страниц физических документов, сшитых вместе из отдельных частей.
Ранние инструменты ReviewerZero с трудом справлялись с некоторыми из этих сложнейших случаев:
- Amazon Textract работал медленнее и менее точно. Обработка одного длинного документа могла занимать около 30 минут, и результат все равно был неверным.
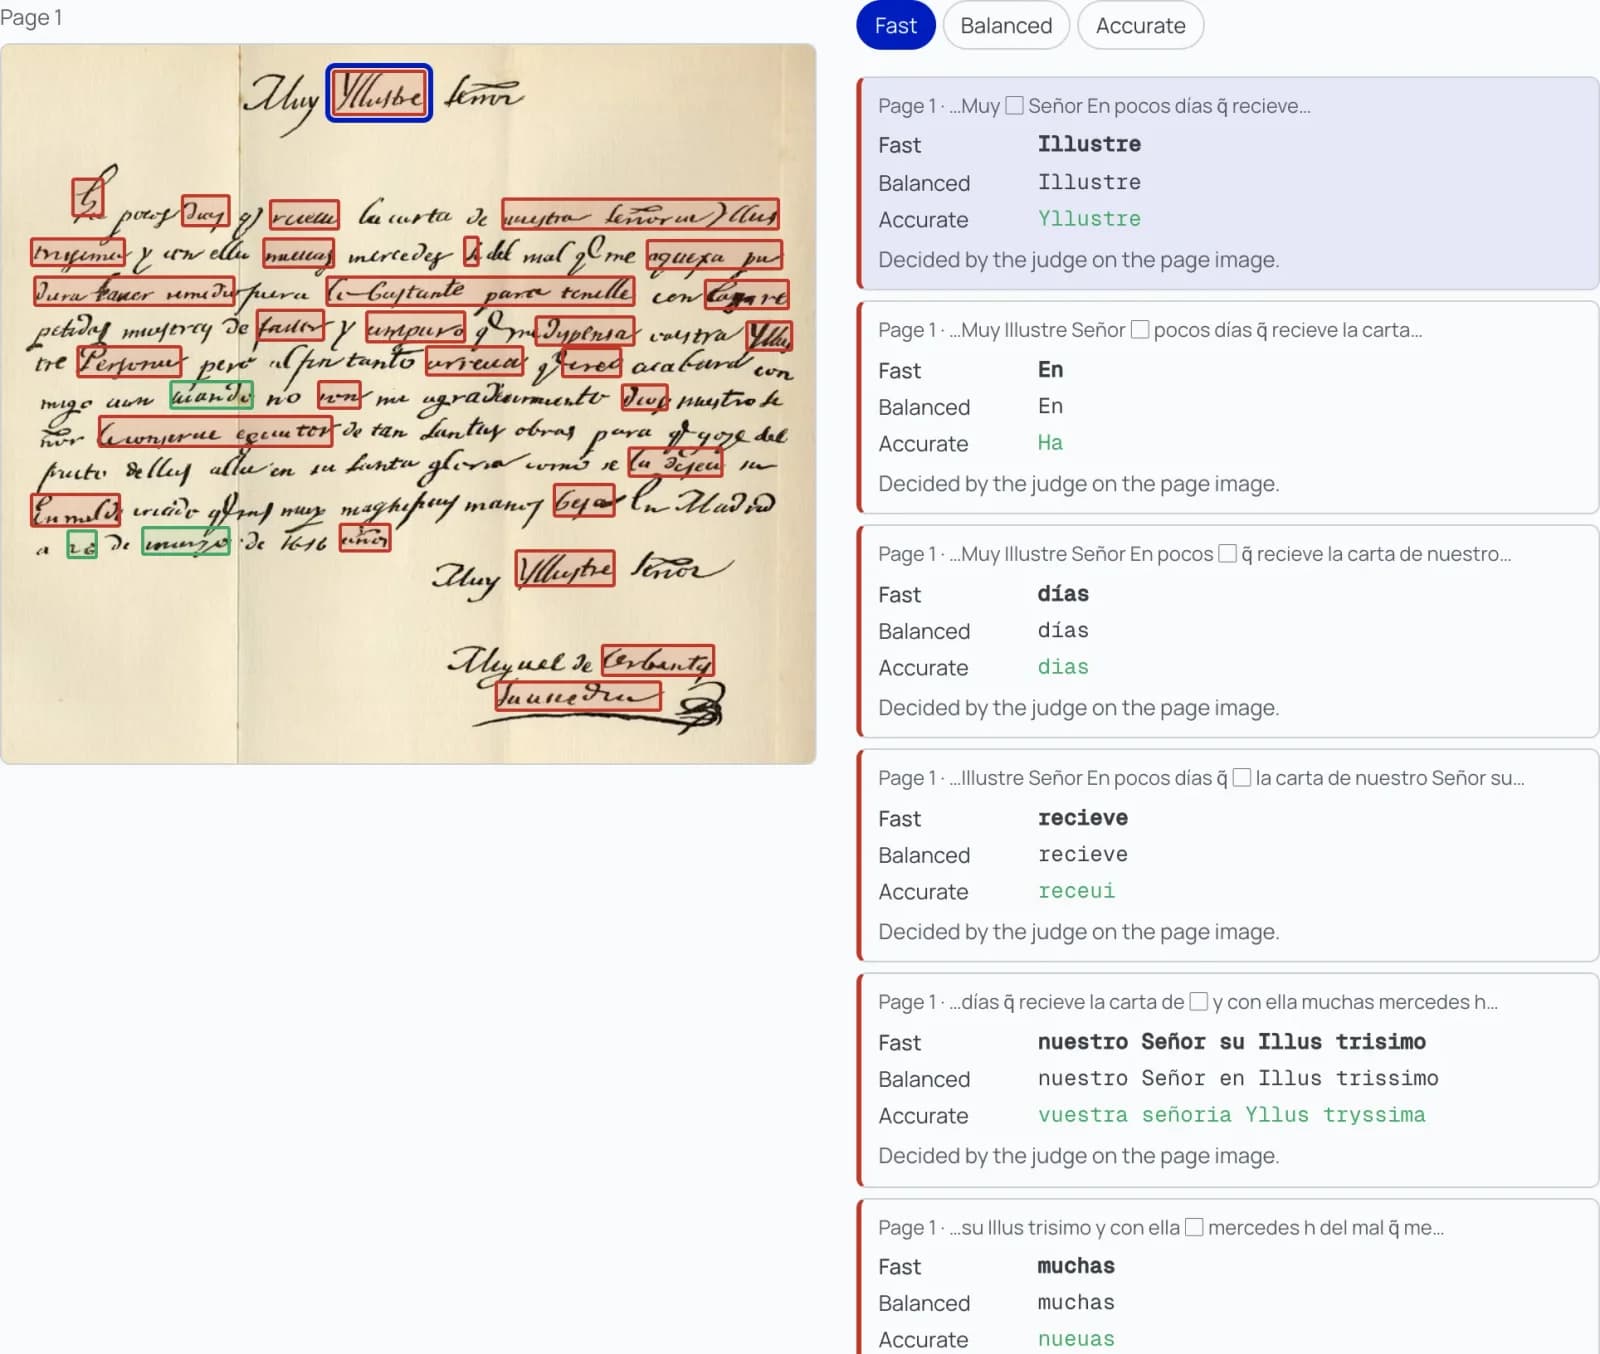
- Протестированные ими парсеры с открытым исходным кодом недостаточно хорошо справлялись с таблицами и разделяли ссылки между страницами или сносками.
- Пользовательский код закрывал эти пробелы. Даниэль написал логику для обработки пограничных случаев, таких как таблица или ссылка, обрезанные посреди страницы, но этот код требовал постоянного обслуживания.
Знакомство с Datalab
Даниэль узнал о Datalab через LinkedIn. После обращения команда Datalab напрямую проработала эту проблему вместе с ним.
«В этом и заключается энтузиазм стартапа», — говорит Даниэль.
«В этом и заключается энтузиазм стартапа», — говорит Даниэль.
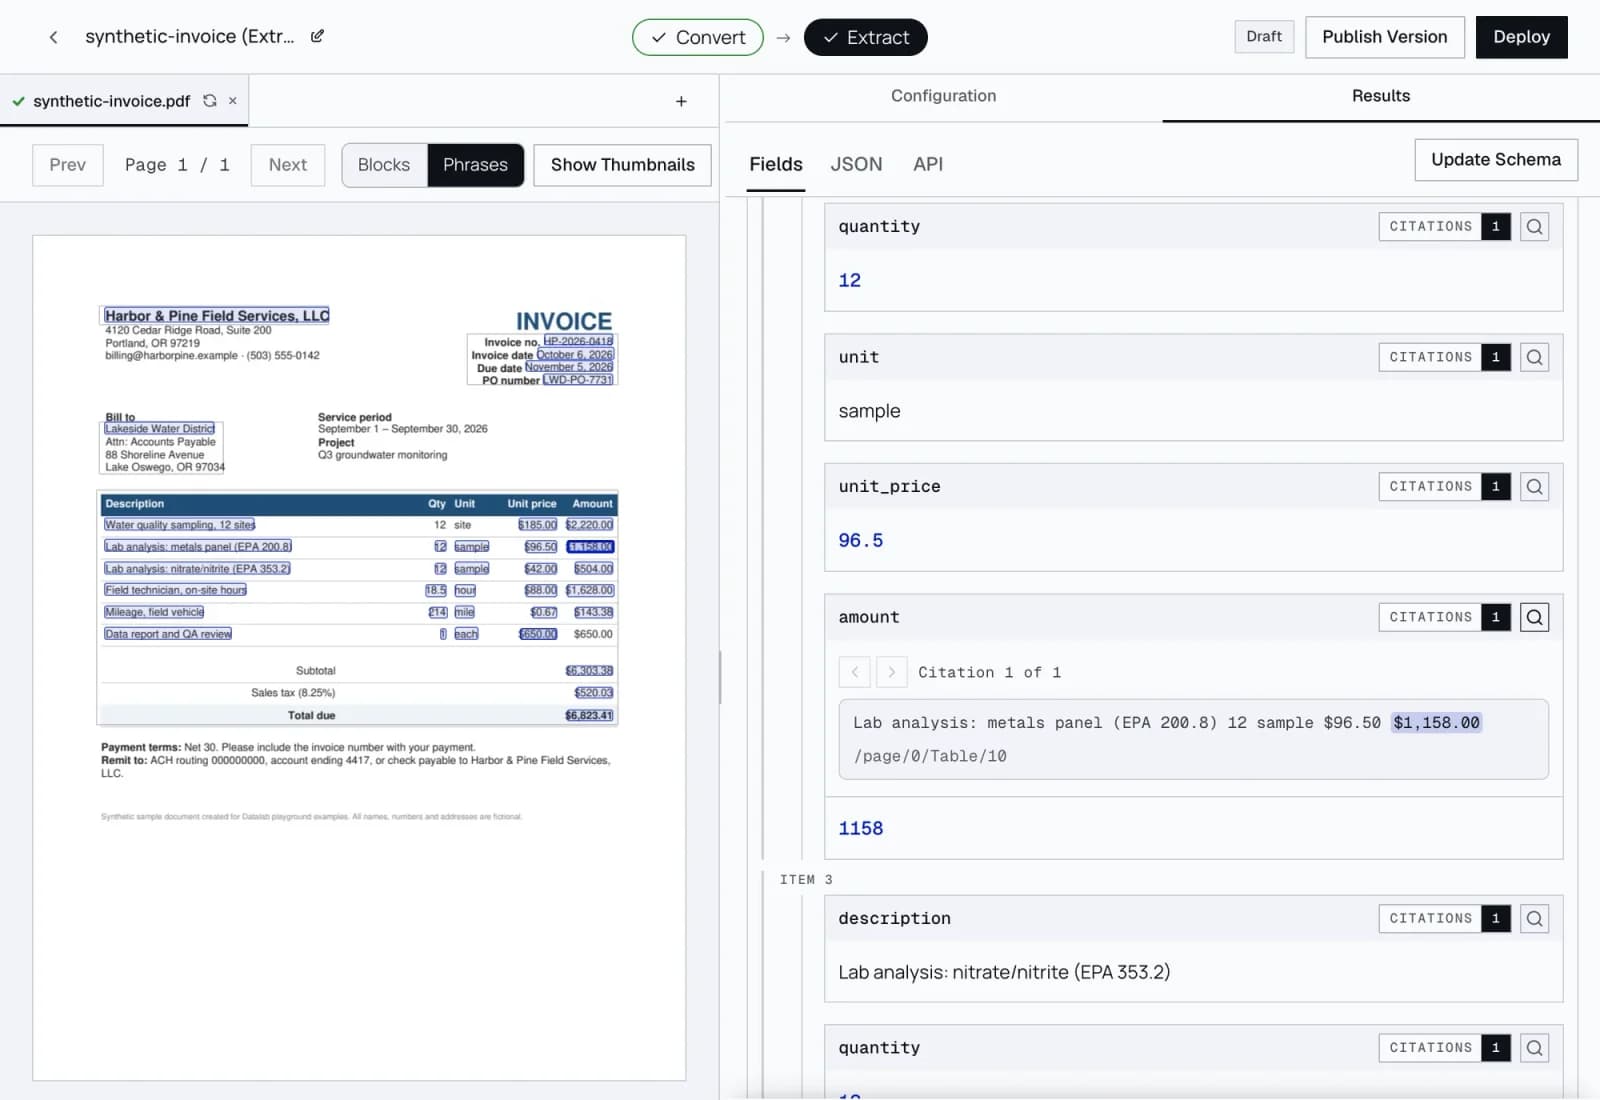
Что изначально убедило Даниэля, так это ограничивающие рамки (bounding boxes), указывающие на позиционные данные. Datalab возвращает местоположение каждого элемента на странице, поэтому ReviewerZero может точно показать редакторам, где находится проблема.
Выделялись и некоторые другие характеристики:
- Самостоятельная настройка. «Это было легко интегрировать. С другими инструментами приходилось с кем-то связываться, но я смог сделать это в тот же день». Регистрация на платформе самообслуживания Datalab и получение ключа API заняли считанные минуты.
- Выдающаяся поддержка. «У некоторых сотрудников Datalab есть реальный глубокий опыт работы с научными документами, и они всегда готовы помочь». Оперативная поддержка по электронной почте или в Slack была огромным плюсом.
- Модели с открытыми весами. «Я в науке, поэтому люди любят открытые продукты». Корни Datalab с открытым исходным кодом завоевали доверие исследовательской аудитории еще до первого вызова API.
- Точный режим. Он справлялся с контентом, обрезанным посреди страницы, что было особенно важно для многостраничных таблиц и списков литературы.
Как это работает: от PDF к доказательствам
Datalab находится в начале конвейера ReviewerZero. Каждая последующая проверка зависит от его вывода.
- Парсинг. Стартап пропускает документ через API Datalab в точном режиме. На выходе получаются структурированные блоки — абзацы, таблицы, ссылки, панели рисунков, — каждый с ограничивающей рамкой.
- Проверка. Проверки достоверности ReviewerZero выполняются на чистом тексте: поиск ссылок, статистические тесты, согласованность таблиц.
- Сопоставление. Проход LLM сопоставляет каждую выявленную проблему с блоком Datalab, в котором она появляется.
- Отображение. В отчете выделяется конкретный абзац, таблица или панель рисунка, чтобы рецензенты видели доказательства в контексте.
Структура на уровне блоков особенно важна. Сначала Даниэль пытался сопоставлять проблемы на уровне слов, но тысячи крошечных блоков запутали LLM. Блоки на уровне абзацев и таблиц дают четкую цель, а рисунки возвращаются с рамкой для каждой панели, а не с одной рамкой для всего рисунка.
Результаты: более быстрые и надежные флаги
От ~30 минут до 3–5 минут: для самых сложных документов, объем которых мог достигать ста страниц, Textract мог потратить полчаса и все равно выдать ошибку. Datalab обрабатывает тот же документ за 3–5 минут.
Таблицы и ссылки, переживающие разрывы страниц. Многостраничные таблицы и разделенные списки литературы теперь передаются без потерь. Достигнутая точность позволила внедрить новейшие проверки ReviewerZero в отношении статистики внутри таблиц.
Меньше затрат на поддержку кода. Предыдущая логика для пограничных случаев в основном упразднена. Каждое исправление раньше занимало около часа и постоянно повторялось; теперь команда экономит примерно 30 минут инженерного времени каждую неделю.
Меньше ручных перепроверок. Раньше команда вручную проверяла конвертацию, прежде чем доверять флагу галлюцинации. Благодаря точному парсингу вероятность того, что флаг окажется настоящим, стала намного выше.
Что дальше: продвижение раньше по конвейеру
Раньше ReviewerZero вмешивался уже после публикации статьи. Теперь сервис приближается к авторам, выявляя проблемы до подачи. Это расширяет круг документов, которые ему необходимо читать:
- Конференц-презентации. Некоторые конференции запрещают докладчикам рекламировать продукты или встраивать видео. ReviewerZero надеется расширить свой сценарий использования, включив в него файлы PPTX для выявления потенциальных нарушений на слайдах, во вложениях и в заметках докладчика.
- Документы Word, комментарии и правки для клиентов, работающих на более ранних этапах процесса подготовки текста.
- Доступность. В связи с вступлением в силу Европейского акта о доступности (European Accessibility Act) ReviewerZero изучает такие проверки, как выявление рисунков с низким контрастом по стандартам WCAG.