БЛОГ · ОБНОВЛЕНИЯ ПРОДУКТОВ
11 ноября 2026 г., автор: Вик Паручури (Vik Paruchuri), 4 мин.
Быстрый режим теперь работает на базе Surya 2.6, нашей новой модели OCR. Стоимость снизилась с 3 до 1 доллара за 1000 страниц при условии обмена данными, оценка на OmniParseBench составляет 91.6, а скорость работы увеличилась.
Быстрый режим теперь работает на базе Surya 2.6, нашей новой модели OCR. Для каждого запроса в быстром режиме:
- Стоимость составляет 1 доллар за 1000 страниц при обмене данными для обучения (1,33 доллара без обмена), по сравнению с прежними 3 долларами (4 доллара без обмена).
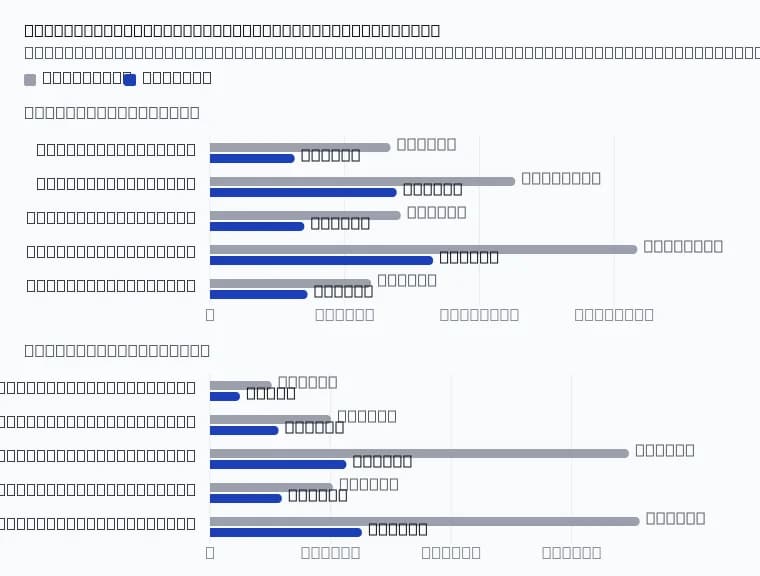
- Результат на OmniParseBench составляет 91.6 по сравнению с 90.3 ранее. Наибольший прирост заметен в таблицах: с 88.0 до 91.2.
- Он работает быстрее. Медианное время возврата страницы моделью сократилось с 3.9 до 2.6 секунд, а один графический процессор обрабатывает в 1.7 раза больше страниц.
В вашем коде ничего не меняется. Начиная с сегодняшнего дня, каждый запрос с параметром mode="fast" использует Surya 2.6.
В чем быстрый режим стал лучше
Таблицы прибавили 3.2 пункта. Наибольший прирост наблюдается на страницах, которые раньше вызывали трудности в быстром режиме:
- Длинные страницы с мелким текстом выросли с 84.8 до 95.8.
- Повернутые и искривленные страницы выросли с 85.4 до 92.0.
- Страницы с формулами из arXiv выросли с 92.5 до 95.0.
Кроме того, быстрый режим стал гораздо реже зависать. Раньше 35 страниц из 2937 обрабатывались до достижения лимита длины вывода. Теперь таких страниц всего 2.
В каких случаях вместо него использовать сбалансированный или точный режим
В некоторых документах быстрый режим стал работать хуже, чем раньше:
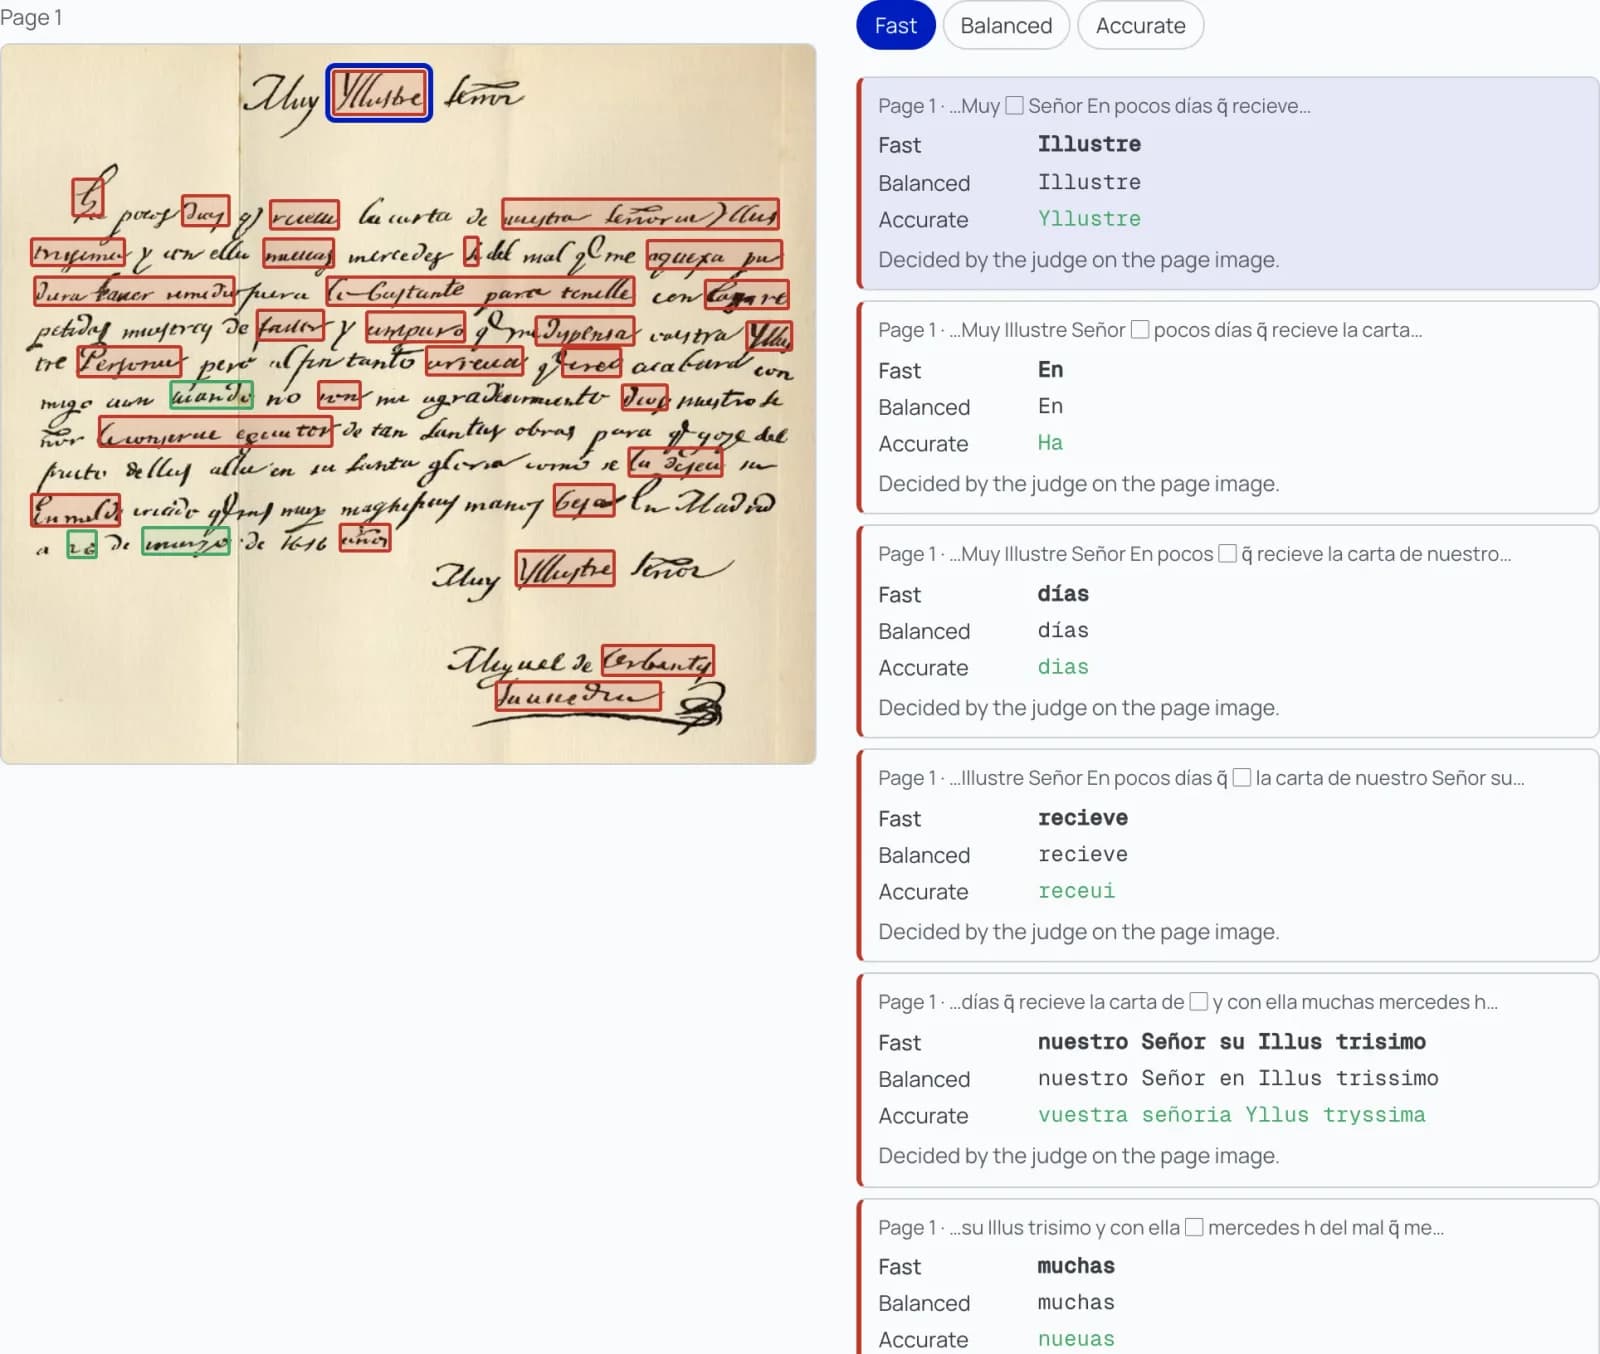
- Распознавание рукописного текста ухудшилось на двух тестовых наборах: с 69.1 до 54.3, а для французского рукописного текста — с 46.4 до 45.2.
- Распознавание старого сканированного текста снизилось с 72.2 до 63.0, а старые сканы в целом ухудшились на 3.9 пункта.
- Очень большие страницы ухудшились с 86.0 до 80.7.
- Заполненные формы ухудшились с 88.8 до 86.0, а набор реальных PDF-файлов — с 95.3 до 93.4.
Если ваши документы содержат рукописный текст, старые сканы или страницы большого формата, используйте сбалансированный или точный режим.
Не уверены, какой режим подходит вашим документам? Запустите быстрый, сбалансированный и точный режимы параллельно на собственных страницах с помощью функции Evals. Она показывает все места, где режимы по-разному распознают страницу.
Быстрее
На том же графическом процессоре при 16 одновременных запросах на 1187 страницах медианное время обработки страницы моделью сократилось с 3.87 до 2.58 секунд (на 33%). Медленные страницы тоже стали обрабатываться быстрее: 90-й перцентиль снизился с 9.15 до 5.20 секунд. Теперь один графический процессор обрабатывает в 1.66 раза больше страниц в секунду.
Это время работы самой модели. Время обработки через API также включает загрузку, рендеринг и остальные этапы конвейера.
1 доллар за 1000 страниц
Предоставление ваших документов для обучения модели снижает стоимость любого режима на 25%. Теперь быстрый режим предоставляет полную разметку макета, таблиц, формул и порядка чтения за треть от прежней цены.
Попробуйте быстрый режим в песочнице.
Как мы проводили измерения
Оба прогона выполнялись с использованием OmniParseBench на всех 2937 страницах с продакшн-промптом. Под «до» понимается быстрый режим в том виде, в котором он работал до сегодняшнего дня, с тем же разрешением страниц, которое использовалось в продакшене. Скорость: один графический процессор, 1187 страниц, 16 параллельных запросов, каждая модель с настройками для продакшна. Пропускная способность рассчитана по одному запуску на модель, поэтому погрешность составляет плюс-минус 5%.