Менеджеру и аналитику нужны разные вещи из одного и того же финансового отчета NVIDIA. Менеджеру нужен агент, который прочитает отчет и ответит на вопросы. Аналитику нужны четыре значения в базе данных для отслеживания выручки и прибыли с течением времени.
Парсинг документов преобразует документ в машиночитаемое представление. Извлечение данных извлекает поля, необходимые приложению. И то, и другое может возвращать JSON (JavaScript Object Notation), поэтому один лишь формат файла не подсказывает, что именно следует использовать.
Мы будем использовать NVIDIA’s second-quarter fiscal 2027 financial results для работы с тем и другим. Репозиторий туториалов tutorials repository содержит исходный документ, схемы извлечения и эталонные значения.
Когда использовать парсинг, извлечение или то и другое вместе
Парсинг преобразует файл Portable Document Format (PDF), документ Word, электронную таблицу или изображение в Markdown, HTML (Hypertext Markup Language), JSON или фрагменты (Chunks). Выходные данные представляют содержимое и структуру документа. В Datalab эта операция называется Convert (Преобразование).
Извлечение возвращает значения для полей, указанных в схеме извлечения (Extraction Schema). Вы определяете имена полей, типы и описания в формате JSON Schema. В Datalab эта операция называется Extract (Извлечение).
Менеджеру нужны текст и таблицы из отчета, чтобы агент мог отвечать на вопросы, которые могут меняться. Аналитику нужны выбранные значения с постоянными именами и единицами измерения. Приложение может проверить эти значения перед сохранением их в базу данных.
Приложение для обработки счетов может извлечь номер счета, дату и сумму, а затем направить расхождения на проверку. Панели мониторинга с функцией вопросно-ответной системы по документам требуется и то, и другое: извлечение предоставляет метрики, а парсинг — окружающий контент.
Преобразование PDF в Markdown
API Datalab Convert может вернуть отчет в формате Markdown. Сохраните отчет как NVIDIA-financial-results.pdf рядом со своим скриптом. Установив Python SDK (Software Development Kit) и задав DATALAB_API_KEY в своем окружении:
Markdown включает в себя заголовок отчета, финансовые таблицы и комментарии. Агент может читать этот контент, чтобы отвечать на вопросы об отчете. Руководство по быстрому старту охватывает настройку SDK.
Определение полей для извлечения
Аналитику нужны четыре поля за текущий отчетный квартал:
- Дата окончания квартала.
- Выручка в миллионах долларов США (USD).
- Разводненная прибыль на акцию в соответствии с Общепринятыми принципами бухгалтерского учета (GAAP).
- Скорректированная разводненная прибыль на акцию (Non-GAAP).
Сводные таблицы на странице 1 используют одни и те же метки строк для результатов по GAAP и Non-GAAP. Ни одна из сводных таблиц не указывает дату окончания квартала. Источник: .
Отчет содержит несколько правдоподобных ответов на расплывчатый запрос «прибыль на акцию». Схема извлечения должна отличать GAAP от Non-GAAP, разводненную от базовой, а текущий квартал — от других периодов. Выручка также требует указания единицы измерения: в заголовке суммы округлены до миллиардов, в то время как в таблице приводится точная сумма в миллионах.
Сохраните эту схему извлечения как schema.json:
Имена полей включают период, базис учета и единицы измерения. Описания подсказывают модели, какие соседние значения следует исключить. required перечисляет поля, которые объект должен содержать, а additionalProperties: false запрещает необъявленные свойства в этом объекте. Ни одно из ограничений не доказывает, что извлеченное значение верно.
Здесь поля прибыли на акцию (EPS) используют числа, чтобы приложение могло выполнять с ними вычисления. Дата использует строку с форматом даты. Сохраняйте схему извлечения как можно более простой, насколько это позволяют данные; эти четыре скалярных поля не нуждаются в вложенных объектах.
Документация по извлечению содержит больше примеров и опцию генерации схем. Проверьте сгенерированные описания полей на соответствие требованиям приложения перед их использованием.
Извлечение значений и проверка цитат
Прочитайте schema.json и отправьте его вместе с отчетом. Установите extraction_mode="balanced", чтобы запросить метаданные полей и верификацию. Отдельная опция режима управляет преобразованием; здесь мы устанавливаем ее в значение "accurate".
В тестовом запуске запрошенными значениями были:
Сохраненный вывод также содержит ключи цитирования и метаданных. Эти ключи представляют собой аннотации API, добавляемые рядом с запрошенными значениями; выбирайте свои объявленные поля при проверке бизнес-объекта по схеме извлечения или при записи его в базу данных.
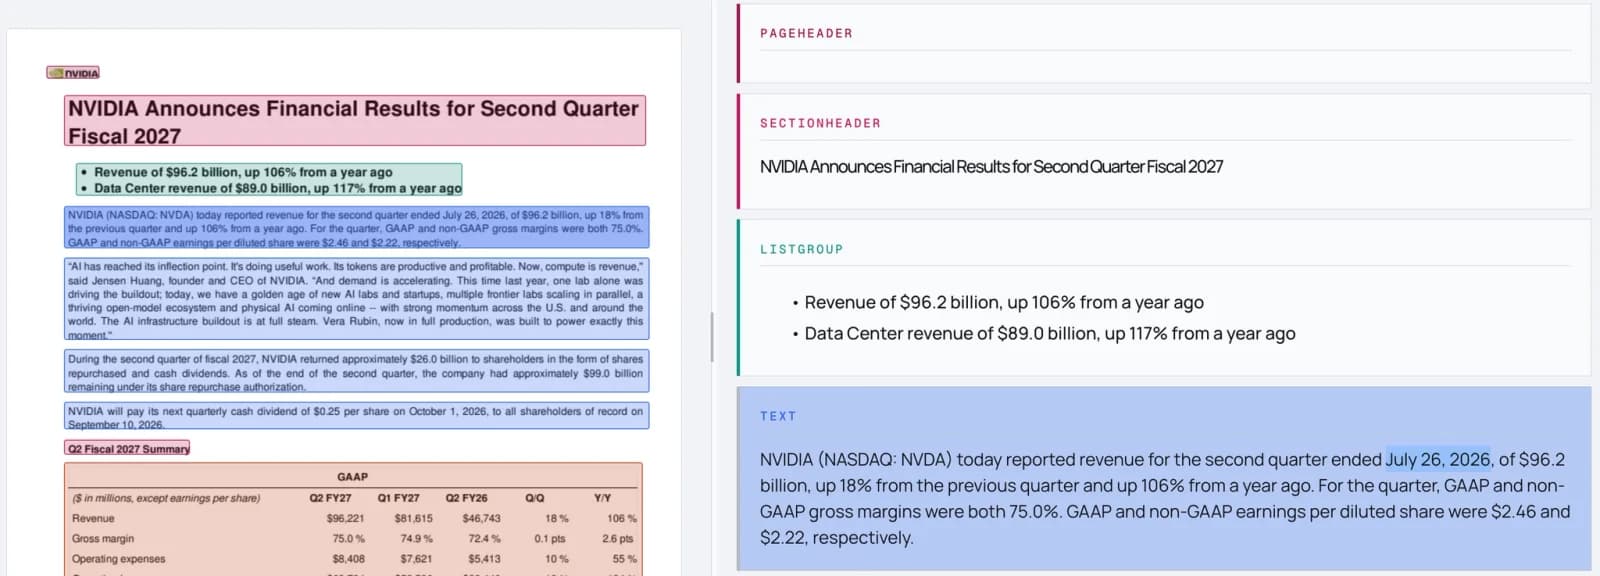
Дата окончания квартала отсутствует ни в одной из сводных таблиц. Модель нашла ее в первом абзаце отчета. Эта выдержка из сохраненного ответа показывает поддерживающий блок и результат проверки:
Цитирование /page/0/Text/3 идентифицирует текстовый блок на первой странице. Идентификаторы блоков используют индексы страниц и блоков, начиная с нуля. Снимок экрана показывает этот блок с выделенной датой:
Исходная страница и преобразованные блоки в средстве просмотра документов Datalab. Расположение блоков и выделение даты созданы Datalab.
В сбалансированном и точном режимах извлечения EXTRACTED означает, что значение было найдено в документе или получено из него. NOT_RESOLVABLE означает, что документ не содержит или не подразумевает запрошенное значение, и значение возвращается как null.
Цитата указывает на подтверждающий контент. Верификация сверяет извлеченное значение с документом и описанием поля. Отсутствие результата проверки или статус, отличный от PASS, требуют рассмотрения в рабочем процессе, требующем проверки. Успешный результат все равно должен соответствовать предполагаемому смыслу приложения.
Двусмысленное описание может пройти верификацию
Предположим, аналитику нужна скорректированная разводненная прибыль на акцию (Non-GAAP), и мы передаем модели следующую схему извлечения:
Описание указывает на второй квартал 2027 финансового года, но не определяет базис учета. В тестовом запуске извлечение вернуло значение по GAAP в размере 2,46 долл. США, и проверка прошла успешно. Обратная связь явно идентифицировала это как GAAP:
Значение подтверждается документом и соответствует предоставленному нами описанию. Оно не удовлетворяет требованию аналитика, потому что мы опустили «Non-GAAP» в описании.
Изменение описания на «Не по GAAP (Non-GAAP) разводненная прибыль на акцию за Q2 2027 фин. года из финансовых сводных таблиц, в долл. США на акцию» вернуло 2,22 долл. США в тестовом запуске. Обратная связь по верификации ссылалась на таблицу Non-GAAP по адресу /page/0/Table/9 и на первый абзац.
Также используйте описательное имя поля quarter_non_gaap_diluted_eps_usd. Рецензент сможет определить его базис учета и единицы измерения, не пытаясь догадаться, что означает eps.
Оценка извлечения по сравнению с эталонными данными
Чтобы оценить, соответствует ли извлечение требованиям аналитика, сравните значения с независимо проверенными ответами. Omni Extract Bench имеет детерминированный оценщик и инструмент для тестирования предсказаний.
Пример сравнивает две схемы извлечения на одном и том же документе. Обе запрашивают четыре указанных выше поля. Расплывчатая версия называет поле Non-GAAP diluted_eps_usd и опускает «Non-GAAP» в своем описании. Точная версия использует quarter_non_gaap_diluted_eps_usd и описание из schema.json.
Используйте следующую структуру папок для следующих скриптов:
Сохраните schema.json как schemas/nvidia_q2_fy27.json. Для расплывчатой версии замените имя поля Non-GAAP на diluted_eps_usd как в свойствах (properties), так и в обязательных полях (required), и используйте неоднозначное описание выше. Оставьте остальные три поля без изменений.
Сохраните эти ожидаемые значения как gold/nvidia_q2_fy27.json:
Для gold/nvidia_q2_fy27_vague.json используйте те же значения и переименуйте quarter_non_gaap_diluted_eps_usd в diluted_eps_usd. Его ожидаемое значение остается равным 2.22, так как этого требует аналитик. Оценщик сопоставляет поля объекта по ключу, поэтому каждый эталонный файл должен использовать имена полей своей схемы извлечения (Extraction Schema).
Установив пакет omni-extract-bench[harness], сохраните это как predict.py. Он отправляет обе схемы извлечения и сохраняет предсказания:
Параметр mode инструментальной среды (harness) выбирает режим извлечения для своего адаптера Datalab. Он отличается от раздельных параметров mode и extraction_mode в SDK.
Сохраните это как score.py для оценки сохраненных предсказаний без повторного вызова API:
Запустите python eval/predict.py, а затем python eval/score.py.
В тестовом запуске нечеткая схема извлечения вернула значение GAAP для поля, которое должно было содержать показатель прибыли non-GAAP. Три поля совпали, и оценщик пометил это поле как неверно прочитанное:
Точная схема извлечения вернула все четыре ожидаемых значения:
Это результаты для четырех полей в одном документе, а не оценка точности по финансовым отчетам. Вывод модели может различаться между запусками. Пример показывает, как сравнение с эталоном позволяет обнаружить несоответствие, прошедшее верификацию.
В спецификации оценки определены правила сопоставления. В нашей публикации об Omni Extract Bench описывается более широкий бенчмарк, а датасет доступен на Hugging Face.
Часто задаваемые вопросы
В чем разница между парсингом и извлечением данных?
Парсинг представляет содержимое документа в другом формате. Извлечение возвращает выбранные значения под именами полей, определенными в схеме извлечения. И то, и другое может возвращать JSON; JSON парсинга описывает структуру документа, в то время как JSON извлечения содержит запрошенные поля и любые аннотации API.
Нужны ли мне оба подхода?
Используйте оба, когда вашему приложению нужны как выбранные значения, так и содержимое окружающего документа. Например, информационная панель может использовать извлеченные поля выручки для графиков и преобразованный текст для вопросов по отчету.
Считается ли распознавание текста парсингом?
Распознавание текста (OCR) считывает текст с изображений. Парсинг документов также восстанавливает контент, такой как порядок чтения и структура таблиц. Datalab использует OCR как часть процесса конвертации.
Означает ли успешное прохождение верификации правильность извлечения?
Значение может пройти верификацию и при этом не соответствовать требованиям приложения, если описание поля амбивалентно. Проверяйте цитаты и метаданные верификации, а также оценивайте запрошенные поля по независимо проверенным ожидаемым значениям.
Что измеряют оценки извлечения?
Они сравнивают предсказанные значения с эталонными. Результаты могут выявить неверные значения, пропущенные поля и описания, которые не отражают требования приложения.
Чтобы запустить пример с NVIDIA, начните с документа, схем извлечения и эталонных файлов в репозитории руководств.
Кейси Бейтс — основатель и технический директор ThinkFox AI, где он создает агентские ИИ-инструменты и обучает команды их использованию.