В Qdrant 1.20 мы выпустили две главные функции, которые могут сделать ваш поиск дешевле и быстрее: два новых нативных типа данных для квантования (turbo8 и turbo16) и продвинутое индексирование метаданных для вложенных полей. Мы измерили улучшения производительности и стоимости, чтобы вам не пришлось делать это самостоятельно, и в этом посте мы делимся нашими выводами.
Сокращайте объем памяти на диске, а не полноту поиска
Хранение векторов всегда является главной статьей расходов в семантическом поиске: они занимают место на диске в холодном состоянии и в оперативной памяти в горячем.
Нативные типы данных для квантования помогают решить эту проблему, уменьшая количество бит, необходимых для хранения каждого измерения вектора: turbo8 использует 8 бит, а turbo16 — 16, поэтому та же коллекция занимает четверть (turbo8) или половину (turbo16) пространства по сравнению с float32. Для команд, у которых заканчивается ОЗУ или дисковое пространство, это означает меньшее количество узлов или возможность разместить больше данных на уже имеющихся узлах.
Возможно, вы сейчас думаете: «Почему я должен предпочесть это существующим float16 и uint8?» Ответ прост: преобразование float32 во float16 или uint8 приводит к потере не только точности (меньше бит), но и информации, так как сжатие основано на простых трансформациях.
Нативные типы данных для квантования, напротив, используют TurboQuant — алгоритм сжатия на основе вращения, который хорошо работает на большинстве наборов данных (частично благодаря паре трюков, добавленных нами в Qdrant). Он сохраняет релевантную информацию, одновременно снижая точность и, следовательно, объем памяти, необходимый для каждого вектора. Это делает его отличным выбором для ресурсоемких рабочих нагрузок, которым все же требуется высокое качество поиска.
Векторное хранилищеменьше — лучшехранилище (МБ)0100200300400500600585 МБ293 МБ147 МБfloat32turbo16turbo832-бит16-бит8-битПолнота@100больше — лучшеполнота@100 (%)010203040506070809010094.8 %95.0 %95.4 %float32turbo16turbo832-бит16-бит8-бит
turbo4, 4-битный тип данных из версии 1.19, позволяет сэкономить еще больше (в 8 раз меньше памяти), но на некоторых наборах данных он теряет несколько процентных пунктов полноты поиска. Выбирайте его, когда ограничения по ресурсам волнуют вас больше, чем высокое качество поиска.
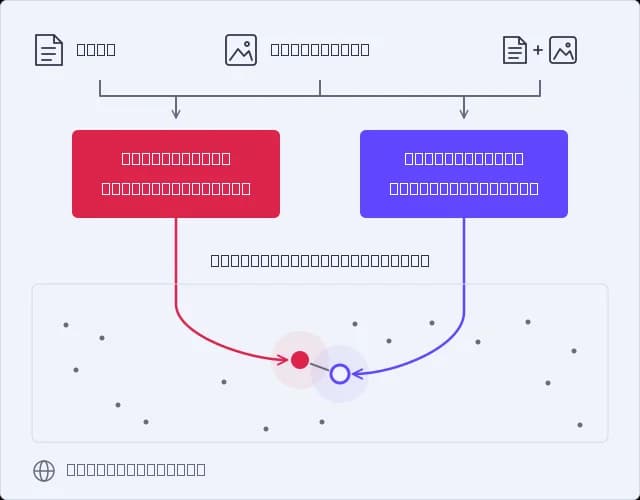
Чтобы использовать новые типы данных, выберите один из них при создании коллекции. После этого вы можете загружать обычные векторы float32 в обычном режиме, а Qdrant поворачивает их с помощью TurboQuant и сохраняет в 8-битную или 16-битную целочисленную сетку:
«Но разве квантование не увеличивает задержку?»
Да, квантование может увеличить задержку, но, как показывает следующий график, turbo8 и turbo16 остаются в пределах 10% от задержки на стороне сервера для векторов float32. Сохраненные векторы уже квантованы, а поступающий запрос — нет. Умный подход Qdrant заключается в том, что он не применяет весь пайплайн TurboQuant к самому запросу: он лишь поворачивает его и сохраняет точность float32 (асимметричная оценка), поэтому накладные расходы минимальны, а поиск остается быстрым.
В случае скалярного и бинарного квантования, которые уменьшают размер векторов, по которым ищет Qdrant, но также сохраняют копии в полной точности, ситуация выглядит немного иначе. Чтобы восстановить полноту, они могут повторно оценивать лучшие кандидаты по сравнению с оригиналами float32. Когда эти оригиналы находятся на диске (что часто бывает при нехватке памяти), каждый запрос ожидает чтения с диска. Вы можете пропустить повторную оценку, чтобы избежать ожидания, но тогда полнота поиска упадет.
Типы данных TurboQuant не имеют этапа повторной оценки, поскольку компактные векторы и есть сами векторы, а оригиналы float32 отбрасываются. Ничто не ждет диск, а полнота остается близкой к float32.
Мы протестировали каждый тип данных на 14 наборах данных вложений с размерностью от 512 до 3072. HNSW используется в качестве индекса, а точный поиск служит эталоном. На графиках используются три набора данных с размерностью 1536, с ограничением в 100 результатов и двукратным передискретированием (oversampling) для скалярного и бинарного квантования. Код доступен в репозитории modern-quantization-bench.
Мы протестировали каждый тип данных на 14 наборах данных вложений с размерностью от 512 до 3072. HNSW используется в качестве индекса, а точный поиск служит эталоном. На графиках используются три набора данных с размерностью 1536, с ограничением в 100 результатов и двукратным передискретированием (oversampling) для скалярного и бинарного квантования. Код доступен в репозитории .
Фильтрация на основе точек
В 2017 paper Томаш Петричек (Tomas Petricek) описал разработку на основе точек (dot-driven development) как способ исследования данных с помощью вложенных цепных вызовов методов (например, string.strip().toUpper()). Такая вложенность очень часто встречается в полезных нагрузках (payloads) метаданных, связанных с векторами в Qdrant, которые часто содержат массивы объектов, таких как авторы научной статьи.
Вложенный фильтр запрашивает один элемент, удовлетворяющий всем условиям, например автора, у которого имя «Ада», а фамилия «Хоппер». До сих пор Qdrant отвечал на этот запрос в два этапа (здесь мы называем их обычными вложенными фильтрами). Сначала поиск по индексу находит точки-кандидаты, которые соответствуют каждому условию, хотя не обязательно в рамках одного и того же элемента. Затем Qdrant считывает полезные нагрузки этих кандидатов ( с диска или из памяти, в зависимости от размещения) и сужает их до точек, которые действительно удовлетворяют всем условиям в пределах одного элемента.
В Qdrant 1.20 мы внедрили индексацию для каждого элемента (per-element indexing) для вложенных полей, что позволяет Qdrant пропустить второй шаг и проверять весь фильтр исключительно с помощью поисков по индексу.
Вложенные фильтры: плоские, обычные индексы и индекс по элементам1 млн точек, меньше — лучшезадержка p95 (мс)ревизия через 90 днейимя автораавтор + ревизияревизия + категория050100150200250300плоскийвложенный, обычные индексывложенный, индекс по элементам
На 1 миллионе статей arXiv индекс по элементам обрабатывал до четырех раз больше запросов в секунду, чем обычные индексы, с теми же корректными результатами. Плоский фильтр (см. следующий раздел) близок по скорости, но он пропускает от трети до половины правильных статей.
Код для этого бенчмарка находится в репозитории nested-filters-bench.
Код для этого бенчмарка находится в репозитории .
Работайте умнее, а не дольше
Плоский фильтр проверяет каждое условие независимо. Он использует только поиски по индексу, поэтому работает как обычный вложенный фильтр, но без второго этапа чтения полезных нагрузок. Индекс по элементам, с другой стороны, сохраняет каждого автора как отдельную запись, поэтому он возвращает те же корректные точки, что и обычный вложенный фильтр, не считывая ни одной полезной нагрузки.
Плоские фильтры обычно самые быстрые, так как условия могут соответствовать разным элементам массива, но их не следует использовать для массивов объектов, так как они возвращают много ложноположительных результатов.
На следующем графике показано, как фильтр для автора по имени Ада Хоппер проходит через каждый режим. Выберите режим или воспроизведите его заново и проследите за шагами.
Вы создаете индекс по элементам, задавая параметр nested для ключа массива при создании индекса полезной нагрузки для поля внутри его элементов:
Создайте такой же индекс для каждого поля во вложенном фильтре, и ваши существующие вложенные фильтры станут быстрее без каких-либо изменений в поисковом запросе.
Попробуйте
Обе функции доступны в Qdrant 1.20. Установите для параметра datatype значение turbo8 или turbo16 при создании коллекции и добавьте nested в индексы полезной нагрузки для ваших вложенных фильтров. Расскажите нам о результатах на Discord.