БЛОГ · ТЕСТЫ ПРОИЗВОДИТЕЛЬНОСТИ
23 октября 2026 г., автор: Вик Паручури (Vik Paruchuri), 14 мин чтения
Мы протестировали 17 OCR-моделей с открытыми весами на 16 288 тестах OmniParseBench, используя собственную среду развертывания каждого поставщика. Вот где каждая из них преуспевает, а где терпит неудачу.
Две недели назад мы выпустили OmniParseBench: 16 288 тестов на прохождение/непрохождение на 2 937 страницах с таблицей лидеров API для разбора документов. Естественный следующий вопрос касается открытых моделей: если вы хотите запустить модель на собственных GPU, какую из них следует выбрать и насколько она отстает от API?
Чтобы ответить на него, мы запустили 17 OCR-моделей с открытыми весами на тех же тестах. Каждая модель работала с задокументированными поставщиком настройками обслуживания, промптами и синтаксическим анализом вывода; редкие исключения перечислены ниже. Мы публикуем все цифры, включая те, на которых наши собственные модели, chandra-ocr-2, Surya OCR 2 и Indra OCR, проигрывают. Те же цифры представлены на странице набора данных вместе со всеми вынесенными вердиктами; отличаются только заголовок Datalab accurate (93.5, более свежий запуск) и строка Indra OCR (версия 1.1 из ее репозитория).
Рейтинги
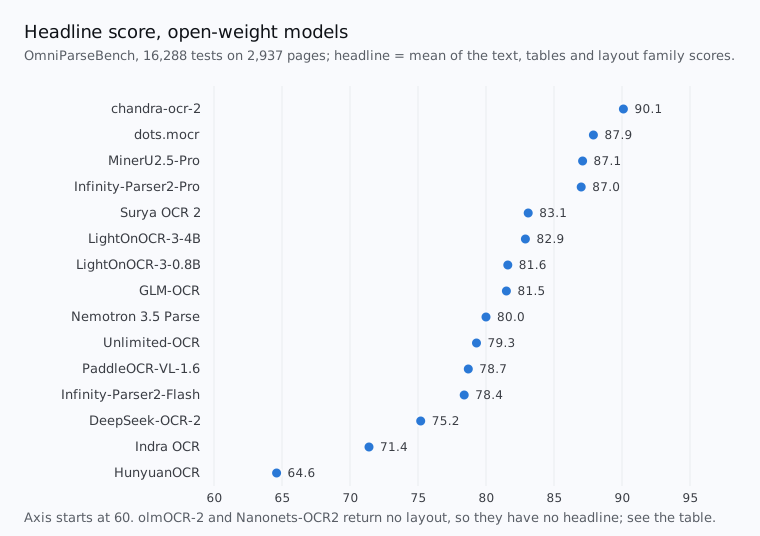
Общий показатель представляет собой среднее значение трех категорий оценок: текст, таблицы и разметка (как устроен бенчмарк). У модели, которая не возвращает прямоугольники разметки, нет оценки разметки, а значит, нет и общего показателя; мы показываем ее оценки для текста и таблиц. Параметры соответствуют тем, которые используются при выводе, и подсчитаны по файлам весов каждой модели: выходной слой, связанный с эмбеддингами, учитывается один раз, а головы многотокенового прогнозирования, которые лишь ускоряют декодирование, исключаются.
Лучшие открытые модели близки к таблице лидеров API. chandra-ocr-2 (90.1) опережает Mistral OCR (89.5), Claude Sonnet 5.5 (88.7) и GPT-5.6 Sol (87.8) и уступает 3.4 балла Datalab accurate (93.5). dots.mocr, MinerU2.5-Pro и Infinity-Parser2-Pro отстают в пределах 3.1 балла. За ними следует разрыв в 3.9 балла: следующие 11 моделей набирают от 64.6 до 83.1 балла. Модель Nemotron 3.5 Parse от NVIDIA, выпущенная 17 октября, набирает 80.0 баллов при 0.63 млрд параметров.
Оценки по категориям показывают, что модели ошибаются в разных областях:
- Текст разделяет модели сильнее всего: от 87.4 (chandra-ocr-2) до 50.5 (HunyuanOCR). Теги ниже показывают, где теряется текст.
- Таблицы варьируются от 92.1 (MinerU2.5-Pro) до 56.6 (olmOCR-2). Причина в основном в структуре таблиц, а не в чтении (см. ниже).
- Разметка высока у каждой модели, которая рисует рамки: от 81 до 95.
Размер и оценка связаны лишь косвенно. Surya OCR 2 лидирует среди моделей с числом параметров менее 1 млрд, а chandra-ocr-2 занимает первое место в общем зачете с 4.5 млрд. Infinity-Parser2-Pro, самая большая модель с 35.1 млрд параметров, набирает меньше, чем chandra-ocr-2 и dots.mocr. С другой стороны, Indra OCR более чем в 50 раз меньше любой другой модели в этом списке: 12.3 млн параметров с математическими моделями, из которых 1.25 млн приходятся на ее основной распознаватель, и она работает на CPU. Она набирает 71.4 балла, отставая менее чем на 4 балла от DeepSeek-OCR-2, в своем режиме по умолчанию с включенными математическими моделями. В этом режиме она считывает собственный текстовый слой цифрового PDF-файла там, где он проходит проверки, а остальное распознает с помощью OCR. Без математических моделей она набирает 66.7, а при чтении каждой страницы как изображения — 61.2.
Что проверяет OmniParseBench
OmniParseBench — это набор из 16 288 модульных тестов на 2 937 страницах из 2 343 документов. Каждый тест представляет собой вопрос да/нет по одной странице, поэтому сбой указывает на одну конкретную ошибку, которую можно изучить:
Тесты охватывают документы, которые сложно даются парсерам: таблицы (6 767 тестов), включая многоуровневые заголовки и группы строк, сверяемые с XML издателя; математические формулы (3 316); многоколоночные страницы (3 517); пустые, заполненные и сканированные формы (1 028); рукописный текст (923); мелкий текст (832); повернутые страницы (824); ухудшенные сканы (655) и 92 языка. Большинство ответов поступает из первоисточников, таких как JATS XML издателя, самостоятельно заполненные формы и текстовые слои PDF, и каждый тест фиксирует, откуда был получен ответ.
Каждый результат проходит через один и тот же конвертер и нормализацию, поэтому HTML или markdown, $…$ или <math> получают одинаковую оценку. Мы также удалили тесты, которые прошли все системы, которые также прошел простой инструмент без модели, и которые модель-судья оценила как тривиальные, так что есть запас: лучшая система набирает 93.5 балла и гораздо меньше на сложных срезах.
Где открытые модели теряют текст
Поскольку каждый тест помечен тегами, можно оценить любой срез. Вот самые сложные срезы, оцененные так же, как и общий показатель (среднее арифметическое оценок по категориям для тестов с тегами), для справки приведены четыре системы API из вступительной публикации:
Каждая ячейка закрашена в соответствии с ее расстоянием от медианы всех 27 систем на странице набора данных для этого среза: синим выше медианы, красным ниже, темнее с шагом до 15 баллов. Медианы: рукописный текст — 58.9, математика — 92.4, таблица — 86.4, форма — 73.0, многоколоночный — 84.2, мелкий текст — 81.1, повернутый — 77.7, ухудшенный — 77.1, не английский — 65.8.
Срезы Datalab accurate взяты из запуска от 15 октября, когда модель набрала 92.9 балла; ее текущий общий показатель составляет 93.5.
Тестов на тег: рукописный текст — 923, математика — 3316, таблица — 6767, форма — 1028, многоколоночный — 3517, мелкий текст — 832, повернутый — 824, ухудшенный — 655, не английский — 1950. «Не английский» означает тест с тегом языка, отличным от английского.
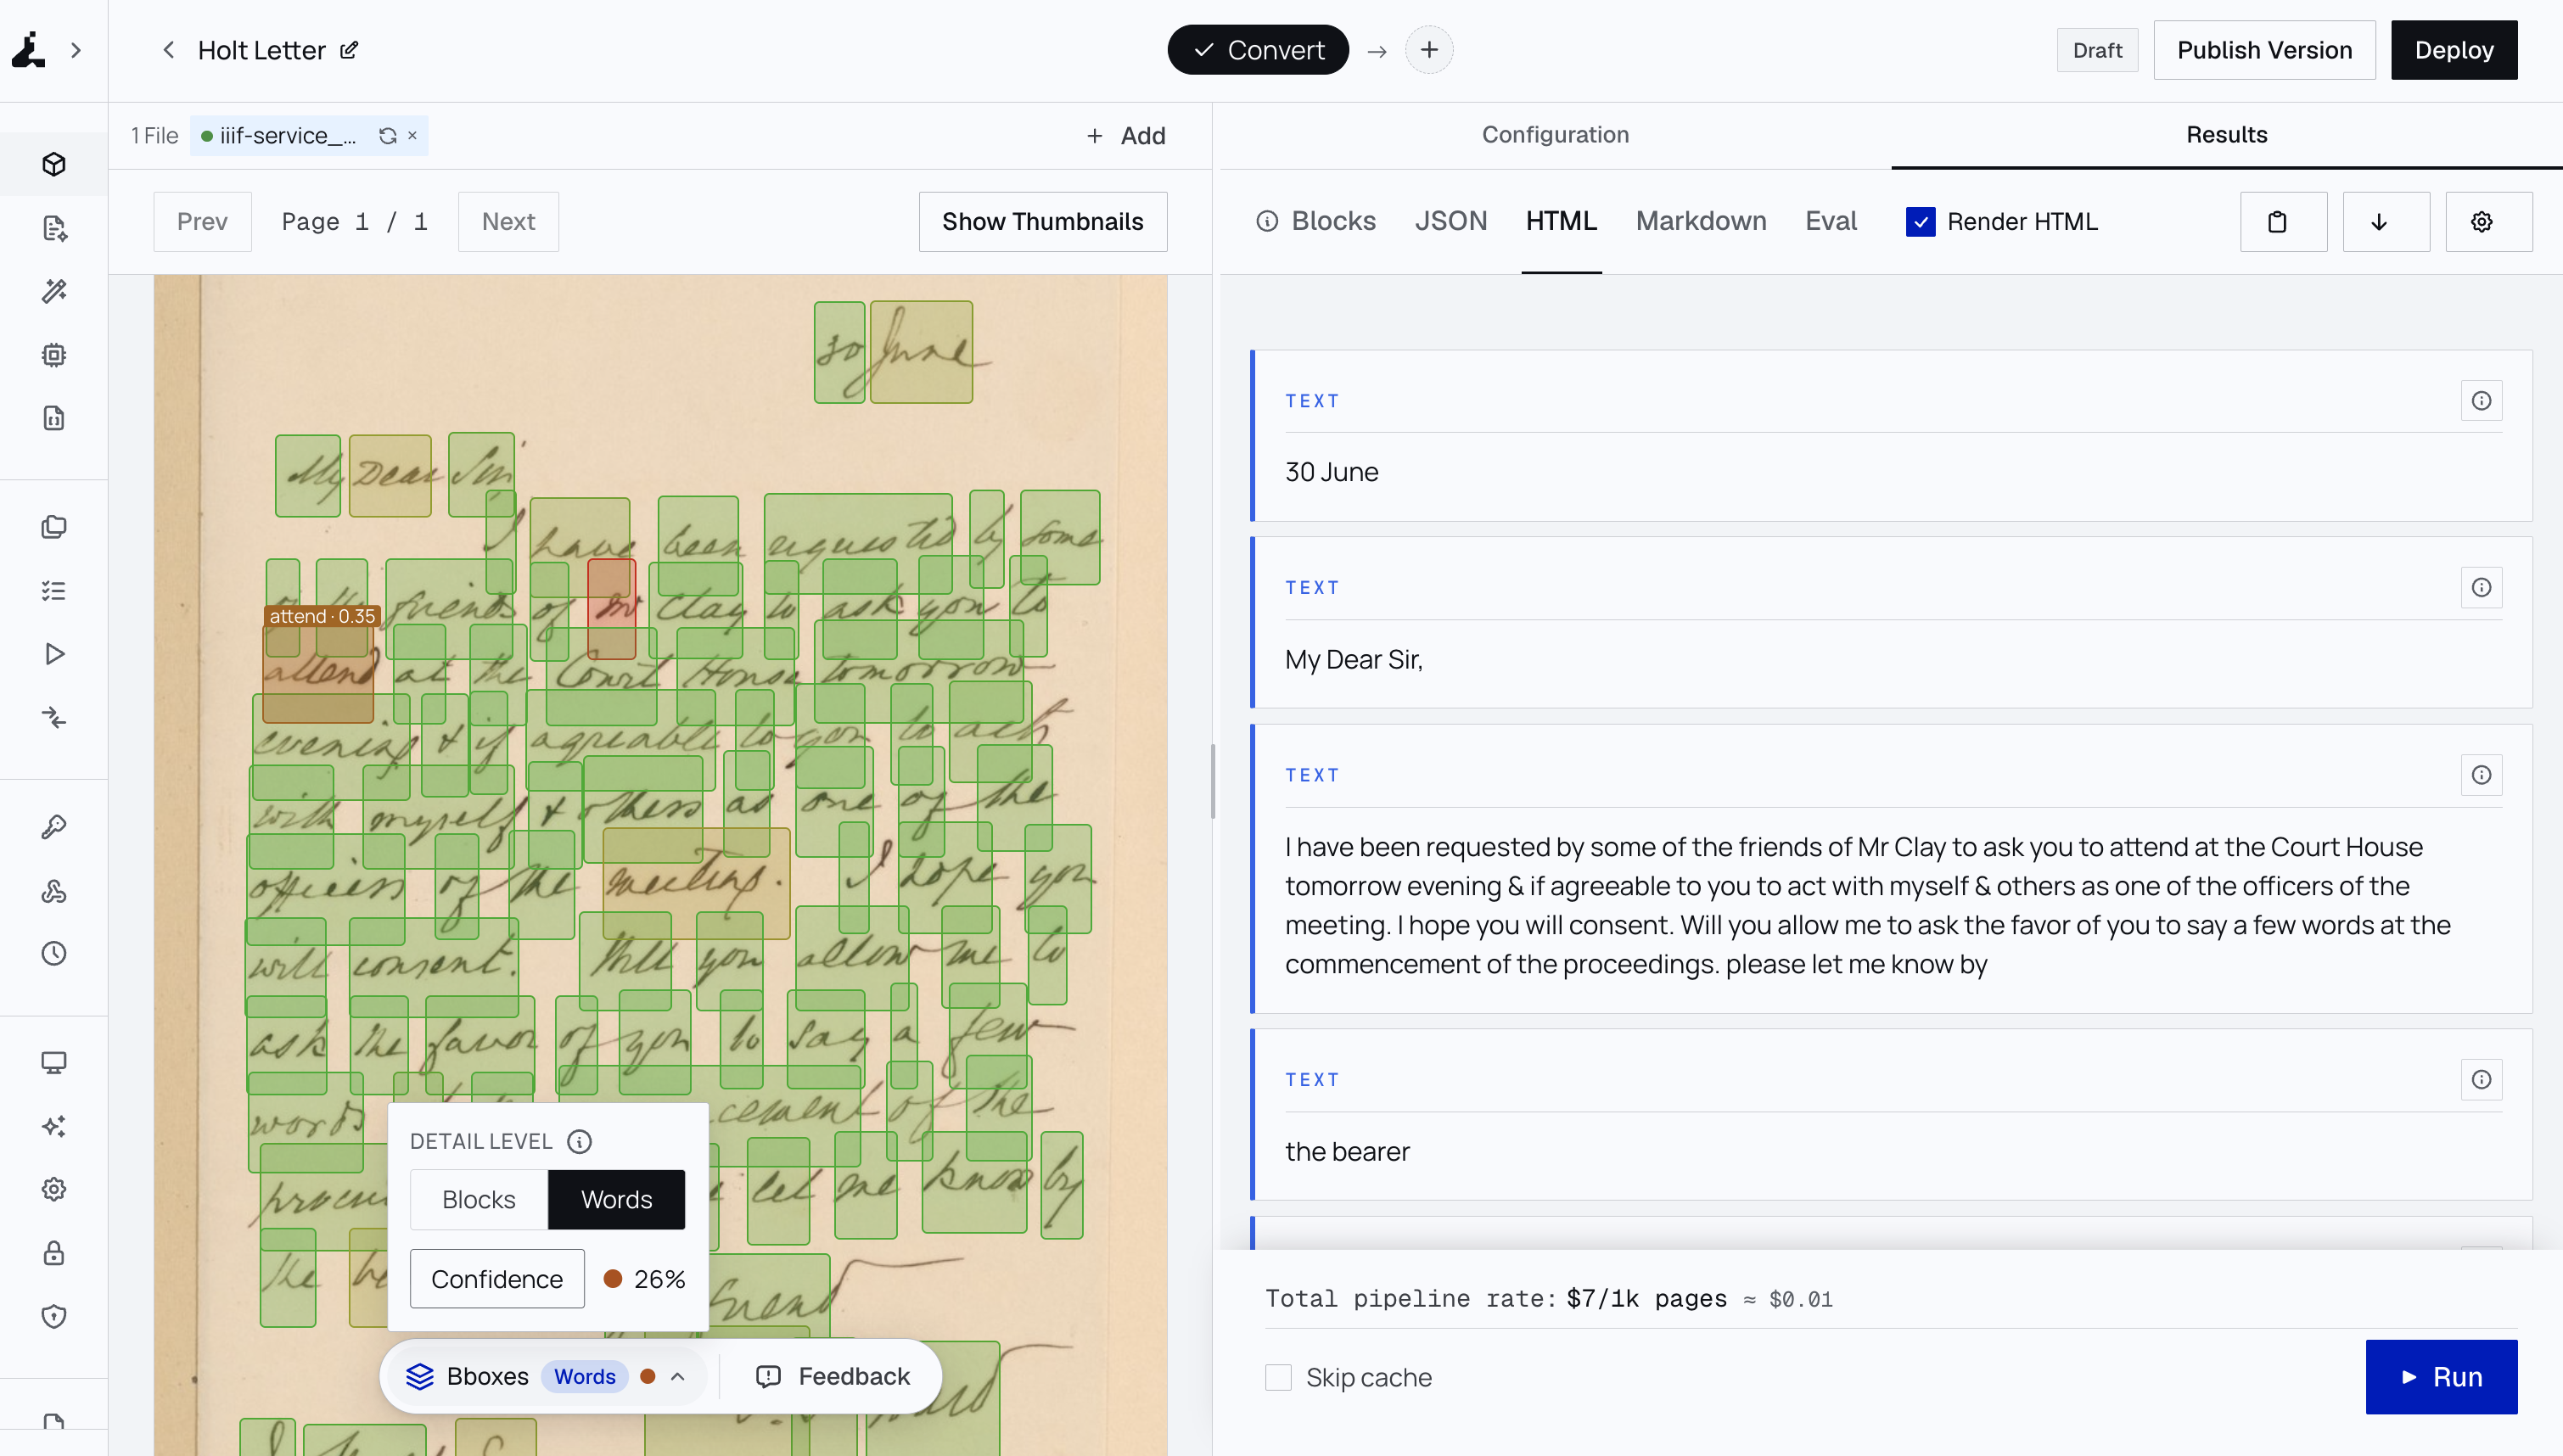
Рукописный текст и неанглоязычные страницы — самые сложные срезы для большинства открытых моделей. В рукописном вводе лучшая открытая модель набирает 66.8 балла, а Gemini 3.8 Flash — 79.4. Повернутые страницы разделяют модели: большинство открытых моделей набирают от 49 до 84 баллов, а Unlimited-OCR (36.6) и DeepSeek-OCR-2 (36.5) набирают менее 40 баллов. Математика для некоторых из них решена почти полностью: 5 из 14 моделей в таблице выше набирают по ней более 95 баллов (chandra-ocr-2, dots.mocr, LightOnOCR-3-4B, Unlimited-OCR, Infinity-Parser2-Flash).
Почему OmniParseBench, а не olmOCR-bench или ParseBench
Открытые модели обычно сравнивают на olmOCR-bench и все чаще на ParseBench. У обоих есть проблемы, которые имеют значение для данного сравнения. В материале «Почему мы создали OmniParseBench» приведена вся подробная информация.
olmOCR-bench исчерпан
Около 3–4% тестов в olmOCR-bench содержат неверные эталонные данные или очень категоричные правила, поэтому реальный предел составляет около 96–97%, и лучшие модели близки к нему. Последние проценты теперь достигаются за счет постобработки, написанной специально для бенчмарка. В собственной таблице LightOn модель Infinity-Parser2-Pro набирает 85.9 без обработки и 87.6 с постобработкой для оценки, а LightOnOCR-3-4B набирает 85.0 без обработки и 86.3 с нормализацией. Каждая из таких программ постобработки насчитывает около 700 строк. Один балл больше, чем большинство разрывов в таблице лидеров.
Без обработки три модели из этой публикации набирают почти одинаковое количество баллов на olmOCR-bench в пределах одного пункта. На OmniParseBench это не так:
olmOCR-bench: chandra-ocr-2 — наш запуск; остальные две указаны по данным LightOn.
olmOCR-bench также не отражает большую часть того, что присылают клиенты. В основном это англоязычные статьи с arXiv и сканы из Internet Archive, в нем нет форм, тесты таблиц проверяют только ближайших соседей ячейки, и в нем практически нет нелатинской письменности.
ParseBench измеряет форматирование
ParseBench от LlamaIndex в основном измеряет, насколько точно вывод парсера соответствует ожидаемому форматированию:
- Один промпт стоит 22 балла. Pulse изменила свои промпты, чтобы подробно описать форматирование, проверяемое в бенчмарке, и ее показатель семантического форматирования вырос с 51.39 до 73.97. Включение задокументированных параметров вывода в нашем API переместило наш показатель с 46.27 до 77.35 при идентичном тексте.
- Модель с 650 млн параметров выходит в лидеры только за счет форматирования. Мы провели 70 шагов обучения с подкреплением (RL) для Surya, нашей модели с 650 млн параметров, без использования документов ParseBench. С помощью нескольких исправлений вывода в процессе инференса она поднялась с 23-го на 3-е место из 148 (5-е без этих исправлений), опередив все передовые модели. На OmniParseBench модель Surya OCR 2 без такого RL набирает 83,1 балла: пятое место среди открытых моделей в этом посте и ниже, чем GPT-5.6 Sol, Claude Sonnet 5.5 и Gemini 3.8 Flash.
- Диаграммы измеряют точность оценки. 73% правил для диаграмм представляют собой значения, которые не указаны на самой диаграмме, и они оцениваются так, будто заданы точно.
- Визуальное сопоставление (grounding) следует подходу LlamaParse. Открытая модель разметки распознала лишь 68% текстовых блоков при IoU 0.8. Самый дешевый тариф LlamaParse уступает лучшей из остальных систем по всем остальным параметрам в 2–12 раз (пунктов), но лидирует в этом.
Мы тоже соревнуемся в этом
Мы создали OmniParseBench, и наши модели участвуют в нем, поэтому мы предъявляем к нему более высокие требования: ни для одной системы не пишется специальный промпт под тесты, адаптеры служат только для конвертации форматов, все системы получают одинаковые тайм-ауты и попытки повтора, а каждая страница, тест и адаптер находятся в открытом доступе. Именно поэтому в разделе «Как мы запускали модели» ниже перечислены все настройки, которые мы использовали для каждой модели.
Таблицы: структура, а не чтение
При детальном разборе сбоев в таблицах выяснилось, что в большинстве случаев текст не отсутствовал. Тест находит текст ячейки, но сама ячейка оказывается под неверным заголовком, рядом с неверным соседом или не в той группе строк. Частой причиной являются объединенные ячейки. В таблице с двухуровневым заголовком модель, которая не записывает теги colspan или rowspan, сглаживает заголовок, и все значения под ним смещаются в не ту колонку.
LightOnOCR-3 наглядно демонстрирует разрыв между чтением текста и пониманием структуры. Оценка модели с 4 млрд параметров по тексту (83,9) выше, чем у dots.mocr (82.5), но ее оценка по таблицам на 18 пунктов ниже (70,8 против 88,6).
Зацикливание ответов
Маленькие OCR-модели иногда повторяют фразу до тех пор, пока не исчерпают лимит токенов. Поставщики решают эту проблему по-разному. Клиент chandra-ocr-2 повторяет зацикленный ответ при более высокой температуре, а пайплайн olmOCR-2 делает до 8 попыток перезапуска. MinerU2.5-Pro, Unlimited-OCR и DeepSeek-OCR-2 используют n-граммный процессор логитов на сервере. Клиент HunyuanOCR останавливает зацикленный ответ и сохраняет текст, предшествующий ему. Большинство клиентов сохраняют ответ, обрезанный по лимиту токенов, поэтому зацикливание отображается как неудачные тесты на этой странице. Клиент Nemotron 3.5 Parse действует строже: он не возвращает документ для ответа, обрезанного по лимиту, что произошло на 31 странице из 2937. Мы сохранили исходное поведение каждого поставщика и не добавляли никаких изменений.
Как мы запускали модели
Целью было запустить каждую модель так, как это описано в документации ее поставщика, и никак иначе:
- Обслуживание (Serving): версия vLLM и флаги, документированные поставщиком, на серверах H100 (по одному на сервер; два для Infinity-Parser2-Pro).
- Промпт и семплирование: документированные поставщиком промпт, температура и лимит токенов. Если поставщик публикует клиент или пайплайн (chandra-ocr, dots.mocr, LightOnOCR, mineru-vl-utils от MinerU, SDK от GLM-OCR, PaddleOCR-VL, код vLLM для DeepSeek-OCR-2, клиент HunyuanOCR, nemotron-parse от NVIDIA), адаптер вызывает собственный код поставщика для формирования промптов и разбора вывода.
- Разметка (Layout): если документированный режим модели возвращает типизированные блоки, адаптер сопоставляет их метки с метками бенчмарка с помощью фиксированной таблицы. Модели без блоков оцениваются только по тексту и таблицам.
- Ввод страниц: модель, код поставщика которой читает PDF, получает файл страницы и рендерит его так, как это делает поставщик, с разрешением поставщика (указано ниже). Модель, чей код принимает только изображения (HunyuanOCR, Nanonets-OCR2, Nemotron 3.5 Parse), получает страницу в формате PNG с длинной стороной не более 2048 пикселей.
- Без постобработки: адаптеры выполняют только конвертацию форматов (markdown в HTML, теги поставщика в простой HTML). Ни один ответ не редактируется.
- Лимит времени: 900 секунд на страницу, как и для любого API в таблице лидеров.
- Оценки: цифры взяты из карточки набора данных (dataset card) для ревизии данных 961c0f89, страницы и ответы которой идентичны релизной ревизии. Каждый вердикт содержится в файле results.parquet набора данных.
Несколько выбранных нами решений отклоняются от документации поставщиков, и мы приводим их список, чтобы вы могли их оценить:
- chandra-ocr-2: пакет рендерит PDF с разрешением 300 DPI, поля формы сглаживаются. Используется промпт ocr_layout пакета chandra-ocr при температуре 0 и top_p 0.1, максимум 12 384 токена, с повторной попыткой пакета при зацикленном ответе (до 6 раз, с увеличением температуры на 0.2 каждый раз). Адаптер также повторяет попытку при ответе, обрезанном по лимиту токенов, что пакет не может обнаружить; ответ, обрезанный при каждой попытке, сохраняется в исходном виде.
- dots.mocr: парсер рендерит PDF с разрешением 200 DPI. Используется промпт prompt_layout_all_en из репозитория парсера, температура 0.1, максимум 32 768 токенов. Ответ, чей JSON не удается разобрать, заменяется очищенным текстом парсера без разметки, как это делает сам парсер.
- LightOnOCR-3: рендеринг с помощью poppler при 400 DPI с уменьшением разрешения так, чтобы страница укладывалась в 5 миллионов пикселей, как в собственном бенчмарке LightOn. Промпт разметки (grounding) при температуре 0.1. Клиент не передает лимит токенов, поэтому мы использовали 12 288 — лимит собственного пайплайна бенчмарка LightOn.
- Unlimited-OCR: пайплайн рендерит PDF с разрешением 300 DPI. Промпт, n-граммный процессор и настройки из рецепта vLLM. Пример из рецепта ограничивает вывод 8192 токенами; мы разрешили 28 000 — это контекст модели в 32 768 токенов за вычетом места под промпт.
- MinerU2.5-Pro: MinerU рендерит PDF с разрешением 200 DPI. Двухэтапное извлечение клиента mineru-vl-utils (разметка, затем извлечение содержимого для каждого блока) с использованием стандартных промптов. Собственные попытки повтора клиента отключены, поскольку бенчмарк одинаково повторяет временные сбои для каждой системы.
- olmOCR-2: пайплайн рендерит PDF со значением по умолчанию 1288 пикселей. Промпт и расписание повторных попыток из набора инструментов (toolkit) (до 8 попыток при возрастающей температуре, одна за другой). Мы исключили резервный вариант последней надежды из набора инструментов, который возвращает встроенный текстовый слой PDF, если ни одна попытка не увенчалась успехом, поэтому страница без успешных попыток засчитывается как неудавшаяся.
- GLM-OCR: SDK рендерит PDF с разрешением 200 DPI. Документированный пайплайн SDK (PP-DocLayoutV3, затем модель для каждого региона). Его сервер давал сбой при обработке большого количества страниц одновременно, поэтому мы запустили 12 процессов сервера по одной странице на каждый, что соответствует пути обработки одиночных запросов SDK. По умолчанию SDK удаляет перед чтением те регионы, которые он классифицирует как верхний колонтитул, нижний колонтитул, номер страницы, сноску, врезку или справочный текст; мы изменили только файл config.yaml, чтобы эти регионы читались как текст, поскольку бенчмарк оценивает всю страницу целиком с сохранением колонтитулов, как и для любой другой системы. Страница с регионом, который SDK не смог прочитать, отправляется повторно (в то время как SDK в таком случае удалил бы регион без предупреждения).
- Nanonets-OCR2-3B: документный промпт из карточки модели при температуре 0, максимум 15 000 токенов, с пенальти за повторения (repetition penalty), равным 1.0. Мы не использовали необязательный промпт карточки для финансовых документов.
- PaddleOCR-VL-1.6: PaddleX рендерит PDF в разрешении 144 DPI. Документированный пайплайн (PaddleOCRVL, версия 1.6, разметка PP-DocLayoutV3, модель запущена через vLLM), с моделью разметки на CPU. По умолчанию пайплайн исключает из разметки markdown колонтитулы, сноски и боковой текст; мы сохранили каждый блок, поскольку бенчмарк оценивает всю страницу с сохраненными колонтитулами, как это делается для любой системы.
- DeepSeek-OCR-2: отрендерено с помощью PyMuPDF в разрешении 144 DPI, как это делает скрипт PDF из репозитория. Собственный путь vLLM репозитория: vLLM 0.8.5 с кодом модели DeepSeek, процессором изображений (режим обрезки) и процессором n-gram без повторов, промптом <|grounding|>Convert the document to markdown. при температуре 0, максимум 8192 токена (длина его контекста) и постобработкой скрипта оценки. Репозиторий запускает это как пакетный скрипт; мы обернули ту же настройку движка в небольшой HTTP-сервер, чтобы бенчмарк мог отправлять ему страницы.
- HunyuanOCR (1.5): проверенная поставщиком настройка vLLM 0.18.1 с флагами serve.sh и запросом клиента и остановкой потоковой передачи при повторе; текст до остановки сохраняется, так как его сохраняет клиент. Мы использовали задачу layout_parse, которая возвращает всю страницу с типизированными блоками; задача doc_parse по умолчанию пропускает колонтитулы и не имеет разметки. В августе файл config.json репозитория модели перешел на новый формат, который код позиционного кодирования vLLM не читает, поэтому мы обслуживали текущие веса с предыдущим файлом config.json репозитория; файлы весов, токенизатора и процессора идентичны в обоих коммитах.
- Surya OCR 2: пакет рендерит PDF в разрешении 192 DPI. Пакет surya-ocr (0.22.1) с распознаванием всей страницы командой surya_ocr и промптом пакета по умолчанию, семплированием и лимитом токенов, развернутый на vLLM 0.20.1 с флагами, которые пакет собирает для H100, включая прогнозирование нескольких токенов (MTP) по умолчанию. Мы включили опцию пакета запрашивать повторно при повышенной температуре, когда ответ для всей страницы не парсится или повторяется (до 6 раз); после этого пакет возвращается к разметке плюс OCR для каждого блока, как это принято по умолчанию.
- Infinity-Parser2 (Pro и Flash): SDK рендерит PDF в разрешении 300 DPI. Промпт document-to-JSON SDK infinity_parser2 и его парсинг JSON, при температуре 0 с максимум 32 768 токенами и отключенным мышлением, как отправляет карточка модели, развернутые на vLLM 0.17.1 с флагами карточки модели; Pro на двух H100 с тензорным параллелизмом. Ответ, обрезанный по лимиту токенов, сохраняет свои полные элементы, как это делает SDK. По умолчанию в markdown SDK отсутствуют колонтитулы и сноски страниц; мы сохранили их, как и для любой системы.
- Indra OCR: версия 1.1 на CPU (x86, 4 виртуальных CPU, по одной странице за раз), в режиме авто по умолчанию с включенным --math: она считывает текстовый слой цифрового PDF, где слой проходит проверки пакета, и выполняет OCR для каждой второй страницы и области. При выключенной математике она набирает 66.7, а в режиме --mode ocr, который читает каждую страницу как изображение, — 61.2. Оценки взяты из репозитория Indra OCR для той же ревизии набора данных и оценщика.
- Nemotron 3.5 Parse: nvidia/Nemotron-3.5-Parse в коммите 62cb1e4, с клиентом NVIDIA nemotron-parse (3.5.0.post7) в режиме однократного прохода по умолчанию, развернутый на vLLM 0.26.0 с флагами из docs/serving.md (однотокенный MTP, FlashAttention 3), на одной H100 с 64 обрабатываемыми страницами. Клиент принимает изображения, поэтому он получает изображение страницы размером 2048 пикселей, а процессор модели изменяет его размер максимум до 1664 x 2048. Мы использовали семплирование клиента по умолчанию (температура 0.2, top_k 50, штраф за повторение 1.05, максимум 8744 токена), которое также использует собственный пайплайн ParseBench от NVIDIA. В быстром старте в карточке модели вместо этого используется жадное семплирование; с ним модель набрала 78.8. Главный результат ParseBench от NVIDIA использует тройной проход, который сохраняет дополнительные копии каждой таблицы на выбор оценщика; с ним модель набрала 82.0. Мы сообщаем результат для стандартного однократного прохода.
Мы обучаем chandra-ocr-2 и Surya OCR 2, поэтому мы заинтересованы в этом сравнении. Именно поэтому здесь перечислена каждая настройка и почему адаптеры опубликованы в репозитории omni_parse_bench, а адаптеры Nemotron 3.5 Parse добавлены в PR #26, чтобы каждый мог повторно их запустить. Каждая оценка для каждой системы также приведена в таблице результатов репозитория. Если вы считаете, что мы запустили модель в условиях ниже ее лучшей документированной настройки, откройте issue, и мы запустим ее повторно.
Какую модель выбрать
- Для лучшего общего балла: chandra-ocr-2, dots.mocr, MinerU2.5-Pro и Infinity-Parser2-Pro. Они находятся в пределах 3.1 балла друг от друга.
- Для таблиц: MinerU2.5-Pro (92.1) и dots.mocr (88.6).
- Для текста, рукописного ввода и неанглоязычных страниц: chandra-ocr-2 лидирует во всех трех категориях. Далее идут LightOnOCR-3-4B по тексту (83.9) и рукописному вводу (65.4), а также dots.mocr (74.4) и Surya OCR 2 (71.4) по неанглоязычным страницам. Отставание от лучших API здесь все еще велико: по рукописному вводу chandra-ocr-2 набирает 66.8, а Gemini 3.8 Flash — 79.4.
- Если вам нужны блоки разметки, проверьте столбец разметки: каждая модель с блоками набирает там 81 балл или выше (самая низкая — HunyuanOCR), но olmOCR-2 и Nanonets-OCR2 не возвращают блоки.
- Если у вас только CPU: Indra OCR. На 4 ядрах ее медианная страница обрабатывается за 357 мс с включенными математическими моделями и за 212 мс с выключенными.
Чтобы самостоятельно изучить любой срез, в руководстве по бенчмарку показано, как оценивать прогоны по тегу, набору или типу теста.
Если вы предпочитаете не запускать модель самостоятельно, API Datalab выполняет запуск Chandra с дополнительными шагами исправления, которые скрыты за строкой «Datalab accurate».