Мы переработали сегментацию в виде агента. Вместо однократного прохода по страницам модель изучает пакет, проверяет места, где один документ, судя по всему, заканчивается и начинается другой, и только после этого формирует окончательный ответ. Это работает как со сканами, так и с цифровыми PDF-файлами, а также с пакетами любого объема — от нескольких страниц до значительно более чем тысячи.
Результаты бенчмарка
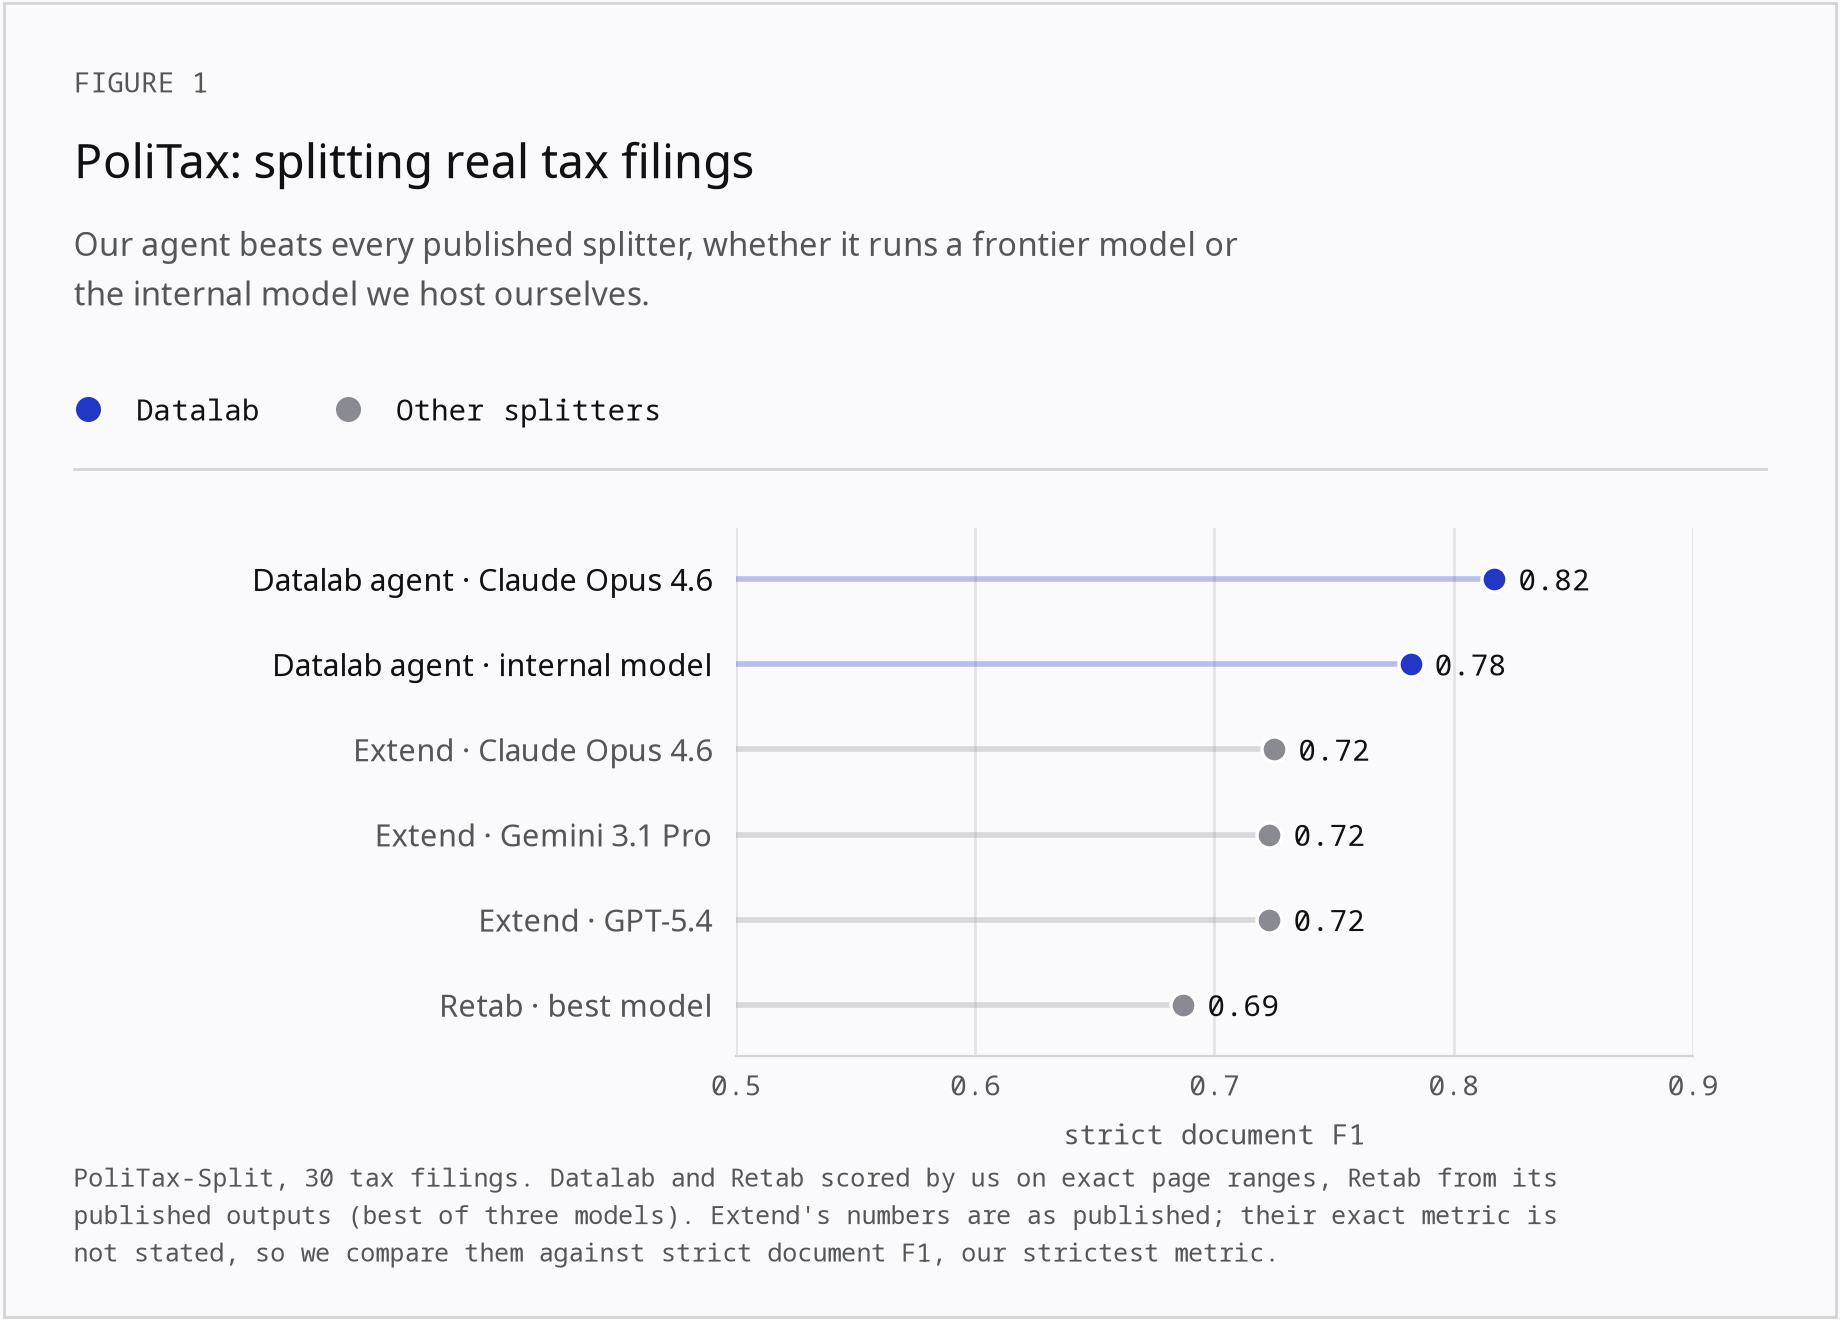
PoliTax-Split — это общедоступный бенчмарк длинных налоговых деклараций, разделенных по определенному правилу, поэтому он одновременно проверяет навыки чтения и следования инструкциям. Мы передали нашему агенту это правило в качестве промпта и оценили его работу по строгой метрике F1 для документов.
Бенчмарк был полностью отложенным: мы никогда не обучали и не настраивали модели на нем или на аналогичных документах.
Наш агент лидирует независимо от используемой базовой модели. С Claude Opus 4.6 он достигает 0,82, а с нашей внутренней моделью — 0,78. Лучшие из опубликованных результатов — это Extend’s с показателем 0,72 и Retab’s с показателем 0,69. Лидерство сохраняется и по мягкой метрике (0,79 и 0,77 против 0,68 у Retab).
Примечание к сравнению: мы самостоятельно рассчитали показатель Retab по их опубликованным результатам, используя ту же метрику, что и для наших запусков. Показатели Extend взяты из их опубликованных результатов. Они не уточняют, какую именно метрику используют, поэтому мы сравниваем их с нашей самой строгой метрикой — строгим F1 для документов.
На нашем внутреннем бенчмарке из 160 пакетов, включающем как цифровые, так и сканированные документы, рабочий агент показывает строгий F1 для документов на уровне 0,95–0,97, и этот показатель держится на отметке около 0,96 для пакетов объемом более 1000 страниц.
Как мы проводим измерения: строгий F1 для документов
Самый простой способ оценки разделения — точность на уровне страниц, однако он создает усеченное впечатление об эффективности разделителей, заставляя их выглядеть лучше, чем они есть на самом деле. Большинство страниц являются продолжением предыдущих, поэтому разделитель может получить высокий балл, ошибаясь при этом в определении границ, что является единственной сложной задачей.
Вместо этого мы оцениваем документы целиком. Предсказанный документ засчитывается только в том случае, если диапазон его страниц в точности совпадает с реальным, а метрика F1 для документов балансирует точность и полноту по этим документам. Именно это имеет значение на последующих этапах: если документ смещен хотя бы на одну страницу, извлечение данных будет запущено на неправильных страницах.
Перетащите границу в вашем разделении, чтобы переместить ее. Кликните внутри документа, чтобы разделить его на этой странице, или на его первой странице, чтобы объединить его обратно.
Истинное
1–34–89–1112–15
Ваше разделение
1–3 4–9 10–11 12–15
Мы также отслеживаем мягкую версию метрики, при которой документ засчитывается, если он пересекает свой истинный диапазон страниц по меньшей мере на 80% (общее количество страниц относительно всех страниц в любом из диапазонов). Это полезно для того, чтобы отличать близкие промахи от реальных ошибок, однако основным нашим показателем остается строгий F1 для документов.
Что считать документом, определяете вы
Не существует единственно верного способа разделить пакет. Налоговому специалисту может потребоваться каждая форма и приложение IRS в виде отдельного документа, в то время как архиву может понадобиться один документ на всю декларацию.
Поэтому вы задаете определение самостоятельно. Передайте текстовый промпт вместе с файлом:
Без промпта агент выполняет разделение по стандартным признакам: новым заголовкам, бланкам организаций, возобновлению нумерации страниц, смене отправителя или темы.
Обучение небольших моделей разделению
Рабочий агент функционирует на базе нашей внутренней модели. Чтобы сделать сегментацию быстрее и дешевле, мы также обучили две модели меньшего размера (маленькую и среднюю) по тому же рецепту, который описывался в нашей публикации про циклы: с помощью on-policy дистилляции из внутренней модели и/или обучения с подкреплением в рамках того же цикла агента.
На пакетах, аналогичных тем, на которых они обучались, обе модели приближаются к внутренней модели. На реальных пакетах FDA, находящихся за пределами этого распределения, средняя модель сохраняет большую часть своего прироста, а маленькая — значительно меньше половины.
Пользовательские правила — это область, где маленькие модели все еще отстают. На PoliTax средняя модель улучшает свой показатель с 0,53 до 0,61 благодаря обучению, но все еще существенно не дотягивает до результата внутренней модели, равного 0,78.
Использование в API
Отправьте пакет по адресу /segment со схемой границ документов на уровне страниц. Добавьте промпт, чтобы задать собственное определение документа:
Каждый сегмент возвращается с названием, номерами страниц (с нумерацией от 0) и коэффициентом уверенности. Оставьте поле prompt пустым, чтобы выполнить разделение по правилам по умолчанию. Полное описание структуры запросов и ответов см. в справочнике по API сегментации.
Цены
Сегментация на уровне страниц по-прежнему стоит 0,50 долл. США за 1000 страниц и тарифицируется отдельно, без обязательного выполнения парсинга. Для вас ничего не меняется.
Разделяете кредитные досье, налоговые декларации, медицинские карты или материалы судебного процесса? Попробуйте это в песочнице. А если ваши документы подчиняются правилу, которое трудно описать словами, мы будем рады услышать о нем: [email protected].