Как создавать системы преобразования документов, которые справляются с неопределенностью в моделях ИИ?
Если вы используете модель OCR для преобразования документа, вам придется столкнуться с галлюцинациями. Но если вы создаете систему преобразования документов с учетом неопределенности модели, вы сможете уверенно выявлять, проверять и устранять потенциальные галлюцинации. Модели OCR совершенствуются и выдают меньше галлюцинаций, но для их минимизации недостаточно просто выбрать мощную модель. Ведущие модели OCR теперь предоставляют оценки достоверности и местоположение каждого слова в документе, что позволяет разработчикам эффективно направлять сомнительные слова на проверку человеку.
Знать, какие слова требуют проверки — это одно, но знать, где именно в документе они находятся — совсем другое. Системы Document AI должны показывать рецензентам, где в исходном документе появляется сомнительное слово, чтобы они могли принять решение. В этой статье мы рассмотрим, как использовать модели Datalab для создания систем Document AI, которые обрабатывают неопределенность модели с помощью оценки достоверности на уровне слов и верификации.
Как найти сомнительные слова в рукописном документе?
Представьте ситуацию, когда вам нужно использовать модель OCR для преобразования документа. Возможно, в компании, где вы работаете, есть исторические бумажные записи, которые необходимо оцифровать. Или, может быть, вы участвуете в исследовательском проекте, где результаты записываются в бланки сбора данных, заполненные в полевых условиях. Или представьте, что вам поручили проанализировать медицинские записи из рукописных форм. Как узнать, точно ли модель ИИ, которую вы используете, расшифровывает данные?
Давайте взглянем на пример рукописного документа из Библиотеки Конгресса. Можете ли вы прочитать письмо ниже? Как вы думаете, сможет ли модель OCR точно расшифровать его?
Библиотека Конгресса, Отдел рукописей, Документы Джозефа Холта. Письмо от Р. И. Уорда к Джозефу Холту, 30 июня.
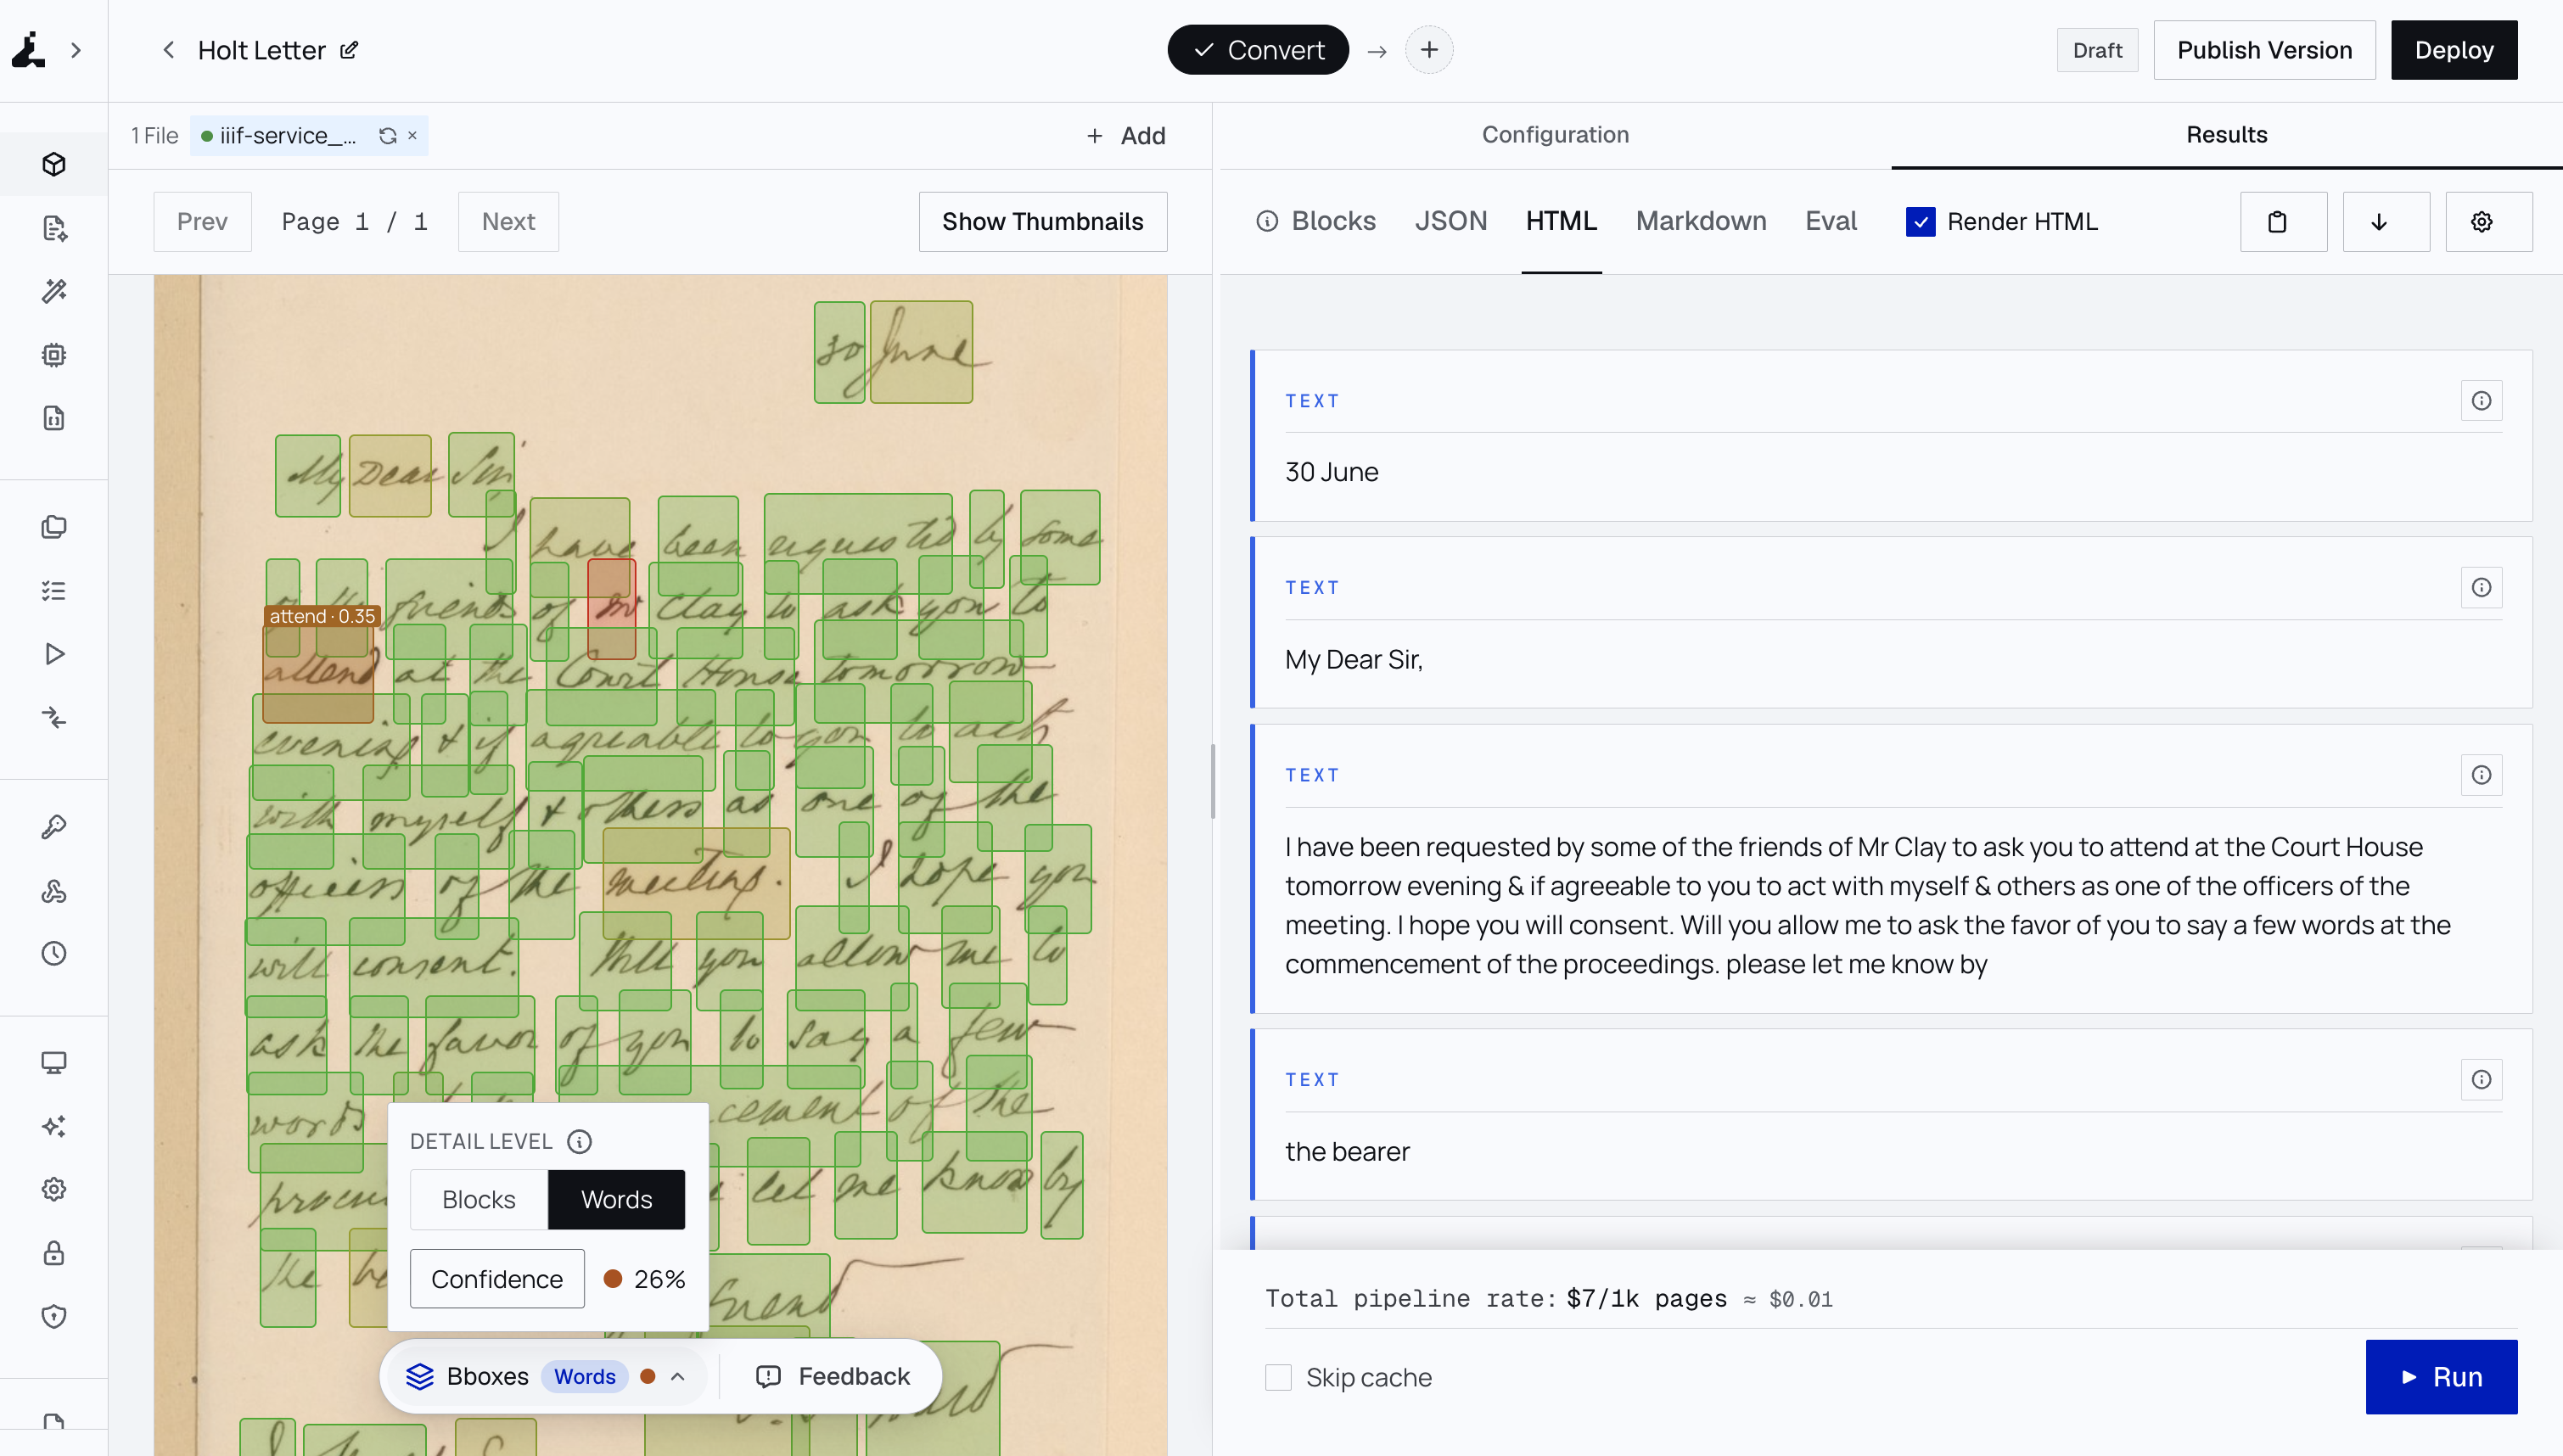
Посмотрим, как модель Datalab расшифровывает письмо выше. Вместе с расшифрованным выводом я выбрал опцию ограничивающей рамки слова (word bounding box), которая возвращает местоположение и оценку достоверности для каждого слова. Ограничивающая рамка предоставляет координаты каждого слова в документе, что полезно для отображения местоположения слова во время проверки. Оценка достоверности показывает, насколько модель уверена в своем прогнозе для конкретного слова. Давайте посмотрим, как это выглядит в Datalab Playground.
Письмо Холта в Datalab Playground на уровне детализации «Слова». Большинство слов обведены зеленым; слово «attend» помечено как 0.35, а «Mr» обведено красным. Рендеринг HTML справа считывает отрывок как «ask you to attend at the Court House tomorrow evening.» Письмо: Библиотека Конгресса, Отдел рукописей, Документы Джозефа Холта. Рамки, оценки и HTML являются результатом работы Datalab.
Обратите внимание на изображении, что слово «attend» имеет оценку достоверности 0.35. Это означает, что модель не особенно уверена в своем прогнозе для этого слова. Но просматривая слово в контексте более широкого отрывка, как видно на правой стороне изображения, мы можем чувствовать себя более уверенно в том, что модель делает хороший прогноз для этого слова. Если вы хотите узнать больше об ограничивающих рамках слов и оценках достоверности Datalab, ознакомьтесь с этой записью в блоге, а также с последующей записью.
Далее давайте посмотрим, как возвращать ограничивающие рамки слов и оценки достоверности для документа с помощью Datalab Convert API.
Как использовать Datalab Convert API для возврата ограничивающих рамок слов и оценок достоверности?
Datalab Playground — отличный способ поэкспериментировать с Datalab Convert API. Но чтобы создать собственную систему ИИ для документов, нам нужно использовать API напрямую. Мы будем использовать REST API, чтобы указать, что хотим получить ограничивающие рамки слов и оценки достоверности. Ограничивающие рамки слов включаются путем установки параметра word_bboxes в значение "true".
См. документацию по преобразованию документов для общего обзора Datalab Convert API. Ознакомьтесь с разделом «Дополнения ограничивающих рамок» (Bounding Box Add-ons) в документации для включения ограничивающих рамок слов и оценок достоверности.
Я не буду вдаваться в детали синтаксиса, но вот код, который я использовал для преобразования изображения рукописного примера в HTML с ограничивающими рамками слов и оценками достоверности:
Обратите внимание ниже, что каждое слово имеет атрибуты data-bbox и data-confidence, которые используются для отображения ограничивающих рамок слов и оценок достоверности в выводе HTML. В данном случае преобразование через REST API вместо Playground вернуло оценку достоверности около 0.33 для слова «attend», что немного ниже, чем оценка 0.35, возвращенная Playground. Ожидайте некоторого разброса в оценках достоверности между запусками модели.
Вот отрывок из полного вывода HTML, показывающий ограничивающую рамку и оценки достоверности для некоторых слов в документе:
Используя вывод HTML, мы можем помечать и направлять на проверку слова, требующие внимания человека. Координаты ограничивающей рамки позволяют нам отображать слова, требующие внимания, в приложении.
Какие слова следует отправлять на проверку?
Выбор слов для отправки на проверку определяется порогом, который устанавливаете вы или ваша команда. В этом примере мы установили порог 0.9, и 18 из 89 слов оказались ниже 0.9. В конечном итоге вам нужно будет определить и уточнить порог, который лучше всего подходит для вашего случая использования, путем итераций и проверок. Взгляните на результаты ниже и сравните их с исходным изображением. Согласны ли вы со словами, требующими проверки? Можете ли вы подтвердить их точность?
До сих пор мы рассматривали, как интерпретировать ограничивающие рамки слов и оценки достоверности для стандартных текстовых макетов. Далее давайте посмотрим, как мы можем находить слова и возвращать оценки достоверности для данных, находящихся в таблицах.
Как рассчитывать оценки достоверности для ячеек таблицы?
Реалистично говоря, нам нужно будет создавать системы ИИ для документов, которые также справляются с табличными макетами. И для проверки результатов, когда для ячейки таблицы возвращается низкая оценка достоверности, нам будет полезно иметь доступные координаты ограничивающей рамки. Давайте взглянем на пример документа, который включает сочетание рукописных слов и данных, расположенных в таблице. В таблице данных записываются ежемесячные осадки за 1941–1950 годы для местоположения в Великобритании.
Министерство авиации, форма Метеорологического управления 1603: ежемесячные осадки в Эбби-Кумхир (The Hall), Раднор, за 1941–1950 годы, написанные черными и синими чернилами на печатной сетке. Национальная метеорологическая библиотека и архив, Метеорологическое управление, Великобритания: исходный том, страница просмотра 137; acknowledgement, OGL v3.0. Справочные значения: Расшифровка Rainfall Rescue.
Мы снова будем использовать REST API для преобразования PDF и возврата ограничивающих рамок и оценок достоверности. Но на этот раз мы укажем "extras": "table_cell_bboxes,list_item_bboxes", чтобы получить ограничивающие рамки для ячеек таблицы и элементов списка. Ознакомьтесь с документацией, чтобы узнать больше. Я не ожидаю увидеть какие-либо результаты по элементам списка в данном случае. Вот код, который я использовал:
В данном случае полный HTML-вывод был записан в файл под названием rain.html. Я не буду приводить здесь весь вывод, так как он очень объемный. Но я выделю один интересный момент из результатов. Модель OCR вернула показатель достоверности 0,965 для ячейки «July 1950», указав, что значение для этого месяца составляет 0,05”. Сравните это с исходным изображением. Кажется ли вам это значение верным?
Национальная метеорологическая библиотека и архив, Метеорологическая служба, Великобритания: исходный том, страница 137; , . Обрезано; добавлена красная рамка. HTML — это результат работы Datalab.
Оказывается, фактическое количество осадков, зафиксированное в июле 1950 года в этом месте, составляло 5,05 дюйма. В данном случае мне удалось проверить результат по эталонной транскрипции.
Этот пример поднимает важный вопрос. Показатели достоверности добавляют уровень защиты от «галлюцинаций» OCR, но высокий показатель достоверности не означает, что результат является абсолютно точным. В конце концов, показатель достоверности не был равен 1,0. Вывод заключается в том, что для критически важных данных лучше всего сочетать показатели достоверности с определенным уровнем проверки человеком, чтобы гарантировать точность результатов.
Если не считать этого одного значения, модель OCR Datalab транскрибировала данные об осадках правильно. Вот как выглядит необработанный HTML-вывод, отображенный локально в браузере.
Скриншот локального браузера с отрендеренным HTML из модели OCR Datalab. Это не скриншот Datalab Playground.
Далее в статье мы увидим удивительный результат: изменение типа входного файла для этих данных об осадках позволяет модели OCR Datalab достичь 100% точности. А пока давайте переключим внимание на элементы списков.
Как ограничивающие рамки применяются к элементам списков?
Мы убедились, что добавление ограничивающих рамок и показателей достоверности к стандартному тексту и табличным данным полезно для выявления значений, требующих дополнительной проверки. И по этой причине Datalab также поддерживает ограничивающие рамки для элементов списков.
Те же концепции, которые мы рассмотрели, применимы к ограничивающим рамкам и показателям достоверности для элементов списков. Для каждого элемента списка модель возвращает результаты в формате HTML. Нам не нужно тратить на это много времени, но стоит показать ценность этой функциональности на примере.
Обратите внимание, как на этой странице представлены три набора списков в двух разделах, или подстраницах.
Три списка на одной странице: маркированные списки содержимого ежемесячных и ежегодных изданий слева и список аудитории со звездочками справа, вокруг повернутого изображения обложки и карты осадков. NOAA, Национальный центр климатических данных (1988), Cooperative observers climatological observations: sample WS form E-15, страница 4. Общественное достояние.
Вот код, который мы используем для преобразования страницы PDF в HTML.
А вот как выглядит необработанный HTML для элемента списка, изображенного ниже.
NOAA, Национальный центр климатических данных (1988), , страница 4. Общественное достояние. Обрезано; добавлено красное наложение. HTML — это результат работы Datalab.
Вот полный результат, отрендеренный как HTML. Обратите внимание, что исходные изображения в PDF захватываются API Datalab и сохраняются программой вместе с HTML.
Повернутый заголовок обложки возвращается в виде прямых заголовков, три списка — как три HTML-списка (23 элемента), а здание, печати и карта — как извлеченные изображения. Скриншот локального браузера с отрендеренным HTML из модели OCR Datalab. Это не скриншот Datalab Playground.
Как LLM общего назначения соотносятся с Datalab Convert API?
На протяжении всей этой статьи мы видели, что ограничивающие рамки и показатели достоверности полезны для выявления сомнительных значений в преобразованных документах. Но насколько хорошо LLM общего назначения справляются с преобразованием OCR? LLM общего назначения по умолчанию не возвращают ограничивающие рамки слов и показатели достоверности, поэтому мы не сможем помечать и проверять сомнительные значения так, как мы это делаем с помощью Datalab Convert API.
Я хотел сравнить, как Datalab Convert API соотносится с моделями Claude, Gemini и GPT. Claude Code CLI и Codex CLI — это два инструмента, которые я ежедневно использую для программирования, поэтому я настроил эксперимент, чтобы сравнить пару моделей от каждого провайдера. Что касается Gemini, я использовал инструмент Antigravity CLI, который не является моим основным инструментом, но я часто использую модели Gemini Flash для задач компьютерного зрения.
Для Anthropic и OpenAI я выбрал по одной «рабочей» модели и одной передовой модели для сравнения с Datalab Convert API в «сбалансированном» и «точном» режимах (точный режим используется для самых сложных случаев преобразования OCR). Для Gemini я выбрал только Gemini 3.6 Flash, последнюю версию модели, к которой у меня есть доступ.
Вот модели, которые я сравнил с Datalab:
- Claude Sonnet 5
- Claude Opus 5.5
- GPT-6 Luna
- GPT-6 Astra
- Gemini 3.6 Flash
Это не формальная оценка. Это скорее «проверка на ощущения» или предварительное исследование того, насколько хорошо LLM общего назначения справляются с преобразованием OCR. Результаты здесь могут быть полезны для принятия решения о том, для каких провайдеров и моделей стоит писать API-скрипт для прямых вызовов API модели, вместо того чтобы запускать преобразование OCR через инструмент программирования. Сначала мы рассмотрим результаты для каждой модели без вызовов инструментов, таких как масштабирование и обрезка. Думайте об этом примерно как о том, насколько хорошо модель может транскрибировать значения только с помощью OCR.
Без вызовов инструментов
* Расходы на LLM являются оценочными и основаны на использовании токенов. Расходы на Datalab — это опубликованные тарифы Convert. Ограничивающие рамки слов, ячеек таблиц и списков с показателями достоверности добавляют $3–$9 на 1000 страниц.
Интересно, что значение осадков за июль 1950 года в 5,05 дюйма вызвало проблемы и у других моделей. Claude Opus стабильно считывал значение как 6,05, в то время как GPT-6 Astra считывал его как 0,05 в двух случаях из трех. Заметьте, что ответы Astra и Gemini варьировались между запусками, несмотря на использование одного и того же изображения и промпта, в то время как Datalab каждый раз возвращал одни и те же значения.
Вот где возник сюрприз. Как в сбалансированном, так и в точном режимах модель Datalab каждый раз считывала значение правильно, несмотря на то, что ранее ошибочно считывала его как 0,05. Я объясню, почему, позже в статье. А пока взгляните на качество, задержку и стоимость для каждой протестированной нами модели.
Datalab Convert API показал самую высокую точность как в сбалансированном, так и в точном режиме, при затратах ниже, чем у всех других моделей, за исключением GPT-6 Luna. Но у Luna была самая низкая общая точность среди всех моделей, и она стабильно возвращала больше всего неверно считанных значений.
Увидев эти результаты, мне стало любопытно, улучшает ли использование инструментов, таких как обрезка и масштабирование, производительность преобразования OCR для LLM общего назначения, поэтому мы рассмотрим это далее.
Улучшает ли вызов инструментов преобразование OCR и уменьшает ли количество галлюцинаций для LLM общего назначения?
При разрешении вызовов инструментов, таких как обрезка и масштабирование, LLM общего назначения, как правило, предпочитают использовать их, а не полагаться только на встроенный OCR. Именно здесь поведение моделей различается от модели к модели.
Больше всего меня поразило то, что, несмотря на более высокую стоимость за токен, Opus 5.5 в итоге оказался дешевле и быстрее, чем Sonnet 5, потому что Sonnet активно использовал инструменты. Очень активно. Opus иногда разрезал изображение на несколько полос, но затем быстро возвращал свой анализ. Sonnet, с другой стороны, активно использовал инструменты обработки изображений, такие как обрезка, масштабирование и поиск линий сетки таблицы, часто делая десятки вызовов инструментов за один прогон.
Astra и Gemini Flash при анализе постоянно использовали методы кадрирования и масштабирования, в то время как Luna в целом делала очень мало вызовов инструментов.
С вызовами инструментов
* Расходы на LLM являются оценочными и основаны на использовании токенов.
Реалистично говоря, разработчики вряд ли будут использовать такую мощную модель, как Astra, для транскрибирования документов в больших масштабах из-за стоимости и задержек. А системы ИИ для работы с документами будут выполнять прямые вызовы API вместо использования программных обвязок, как в этом эксперименте. Но этот эксперимент стал полезной демонстрацией того, насколько хорошо несколько моделей общего назначения справляются с задачами по сравнению с моделью Datalab.
Хорошо, а что насчет скачка точности до 100% у модели Datalab? Давайте разберем это далее.
Меняет ли формат входных данных результат?
При проведении сравнений между моделями и провайдерами я был удивлен, увидев, что модель Datalab стабильно возвращает эталонное значение 5.05 для отсканированного значения за июль 1950 года, несмотря на то, что ранее она постоянно возвращала 0.05. Разбираясь в этом, я обнаружил, что вероятной причиной является использование изображения в формате PNG в качестве входных данных для прямого сравнения, вместо PDF, использовавшегося в исходном анализе табличных данных.
В таблице ниже сравниваются результаты для входных данных в форматах PDF и PNG.
Это не означает, что при конвертации документов всегда следует использовать файлы изображений вместо PDF. Вывод здесь заключается в том, что стоит оценивать производительность OCR для различных входных форматов, когда у вас есть такой выбор.
Заключение
LLM общего назначения, такие как модели Claude, GPT и Gemini, способны выполнять OCR, но не возвращают показатели достоверности, которые мы могли бы использовать для пометки сомнительных значений. API Datalab Convert способен возвращать показатели достоверности и ограничивающие рамки, указывающие на местоположение каждого значения. Эта функциональность доступна для текста, табличных данных и списков. Эти инструменты добавляют уровень защиты от «галлюцинаций» OCR, позволяя быстрее обнаруживать сомнительные значения и направлять выбранные данные, требующие ручной проверки, специалистам.
Часто задаваемые вопросы
Что такое «галлюцинации» OCR и почему они возникают?
Галлюцинации OCR — это вымышленные значения, которых нет в обрабатываемом документе. Галлюцинации характерны для трансформерных моделей, поскольку они обучены предсказывать следующий токен в последовательности. Например, такое поведение модели может привести к исправлению исходных данных при наличии опечатки, так как модель возвращает написание, которое считает правильным. В других случаях галлюцинации OCR могут привести к пропуску информации при низком качестве входных данных, например, из-за размытого изображения или выцветших чернил.
Как можно уменьшить количество галлюцинаций при конвертации рукописных или отсканированных документов?
Используйте максимально возможное качество входных данных, если у вас есть выбор. Если входной файл не подходит для OCR, запросите повторное сканирование или новое изображение, если это возможно. Выбирайте модель OCR с дополнительными средствами защиты от галлюцинаций, такими как показатели достоверности и ограничивающие рамки для каждого слова или значения. Пишите и поддерживайте оценочные тесты для проверки производительности модели и обнаружения неточностей. Направляйте документ на проверку человеку, если модель не уверена в результате или входные данные имеют низкое качество.
Почему ИИ гадает, вместо того чтобы признать, что не может прочитать документ?
Трансформерная модель обучена создавать наиболее правдоподобное продолжение последовательности. Поэтому поведение по умолчанию некоторых моделей может приводить к угадыванию, а не к признанию того, что они не могут прочитать входные данные. Трансформерные модели могут быть способны воздерживаться от прогнозирования, если они специально обучены или получили соответствующую инструкцию, либо когда провайдеры моделей встраивают внутренние процессы верификации, которые «исправляют» входные данные, как описывает Datalab в этой статье о повышении точности OCR.
Кейси Бейтс — основатель и технический директор ThinkFox AI, где он создает агентные ИИ-инструменты и обучает команды их использованию.