Кейси Бейтс — основатель и технический директор ThinkFox AI, где он создает инструменты на базе агентского ИИ и обучает команды их использованию.
Какие модели OCR лучше всего подходят для моих документов?
Разобраться в бенчмарках поставщиков OCR бывает непросто, а понять, как конкретная модель OCR будет работать с вашими собственными документами, кажется еще более сложной задачей. Бенчмарки часто бывают несовершенными и нередко подыгрывают разработчику. Хуже того, бенчмарки поставщиков сложно применить к вашим собственным документам. Как можно доверять бенчмарку, если вы не можете протестировать его на таких же документах, как ваши?
В этой статье я подробно разберу, как интерпретировать бенчмарки и какие нюансы следует учитывать при выборе ведущих моделей OCR для вашего сценария использования. Я буду использовать открытый бенчмарк от Datalab, OmniParseBench, чтобы понять, как различные модели OCR (и не только от Datalab) показывают себя по сравнению друг с другом.
Но подождите, разве OmniParseBench — это не бенчмарк от Datalab? Да, и Datalab первыми призывают скептически относиться к бенчмаркам поставщиков:
Мы создали этот бенчмарк и мы продаем парсер — вам стоит помнить об этом, как и в случае с ParseBench. Разница, к которой мы стремимся, заключается в том, что вам не нужно верить нам на слово. У каждого теста есть записанный источник, а программа для подсчета баллов представляет собой около 2000 строк понятного кода на Python, который вы можете прочитать. И как всегда: лучший бенчмарк — это ваши собственные документы. Запускайте собственные тесты. — Вик Паручури, основатель и генеральный директор Datalab, в статье «Почему мы создали OmniParseBench»
Мы создали этот бенчмарк и мы продаем парсер — вам стоит помнить об этом, как и в случае с ParseBench. Разница, к которой мы стремимся, заключается в том, что вам не нужно верить нам на слово. У каждого теста есть записанный источник, а программа для подсчета баллов представляет собой около 2000 строк понятного кода на Python, который вы можете прочитать.
И как всегда: лучший бенчмарк — это ваши собственные документы. Запускайте собственные тесты.
— Вик Паручури, основатель и генеральный директор Datalab, в статье «Почему мы создания OmniParseBench»
Так как же ему доверять? Компания Datalab создала OmniParseBench честным, проверяемым и комплексным. Код и данные доступны для изучения. Давайте посмотрим, как это работает.
Что такое бенчмарк OCR и что такое оценка OCR?
Итак, что же такое бенчмарк OCR? И что такое оценка OCR? Бенчмарк парсинга сравнивает модели OCR, выставляя оценку тому, насколько их результат совпадает с эталонными данными, включая проверки и эталонные выводы, по общему набору документов. Иногда бенчмарки также берут на себя предварительную обработку (настройку) и постобработку (очистку), чтобы модели оценивались справедливо по тому, как они читают документы, а не по формату их вывода.
То, из чего складывается оценка, различается в разных бенчмарках, но может включать наличие текста, порядок текста, содержимое таблиц, структуру таблиц и верстку. В следующем разделе мы рассмотрим, из чего состоит оценка в OmniParseBench. Бенчмарки могут быть полезны для сужения выбора, но относитесь скептически к бенчмаркам от разработчиков, так как они часто отдают предпочтение компании, которая их создала.
Когда я обсуждал бенчмарки OCR для этой статьи с Полем Семамой, инженером-исследователем в Datalab, он поделился тем, как в Datalab подходят к бенчмаркам. Я представил это в таблице ниже.
Четыре составляющие бенчмарка: задача, набор данных, предиктивные модели и подсчет баллов
Как в Datalab определяют бенчмарк: задача, набор данных с эталонным сигналом, модели, решающие задачу, и программа подсчета баллов, которая оценивает их предсказания. Каждое определение процитировано по электронной почте от Поля Семамы, инженера-исследователя в Datalab.
Обратите внимание, что эта статья посвящена пониманию бенчмарков синтаксического анализа документов, а не бенчмарков извлечения данных. Если вам интереснее более подробное объяснение извлечения данных, ознакомьтесь с моей недавней статьей Извлечение данных против парсинга: что выбрать?, а также загляните в открытый бенчмарк извлечения данных от Datalab, OmniExtractBench.
Оценка парсинга OCR проверяет точность синтаксического анализа модели на выборке ваших документов с использованием написанных вами тестов. Оценки полезны для выбора правильной модели OCR для ваших типов документов и для определения того, какие типы ошибок могут допускать модели.
На диаграмме ниже более подробно сравниваются бенчмарки и оценки.
Источники: Datalab Benchmarks + Evals (2025-12-09); We lead an external extraction benchmark (but run your own evals) (2026-07-14).
Используйте бенчмарки, чтобы сузить круг вариантов, и собственные оценки, чтобы принять окончательное решение. С помощью OmniParseBench вы можете создавать собственные тесты на выбранных вами документах.
Как оценивается бенчмарк OCR?
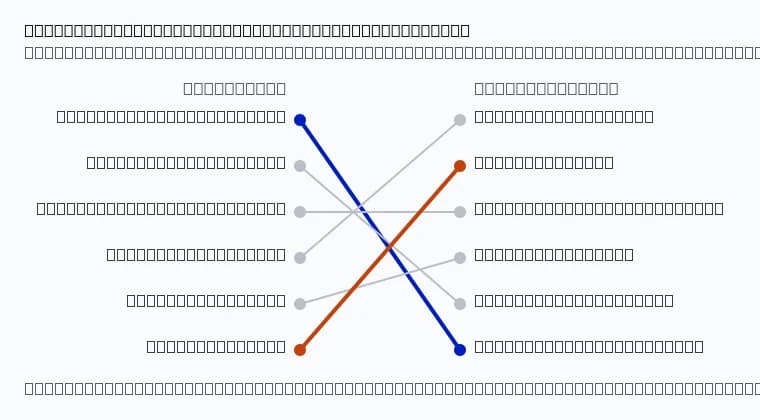
Теперь давайте посмотрим, что может влиять на оценку в бенчмарке или определять ее. Мне кажется удобным разделить это на две части, как показано на рисунке ниже: что запрашивается и как это подсчитывается. В этих двух частях выделяются семь категорий, или факторов, которые определяют числовое значение в бенчмарке.
Под «запрашиваемым» понимаются решения, которые формируют корпус, например, какие документы выбраны, сколько их и какого они типа. Задача относится к тому, что система OCR должна выдать во время работы. А эталонный сигнал — это правильный ответ для каждого теста или оценки. В совокупности это факторы, которые следует учитывать, когда вы задаетесь вопросом: «Отражают ли задача и набор данных бенчмарка мой операционный сценарий использования?»
Вторая часть охватывает то, как подсчитываются результаты, или «что означает итоговая цифра?» Другими словами, это то, как бенчмарк фактически оценивает прогнозы по сравнению с эталоном, и насколько легко выполнять фильтрацию и переранжирование на основе параметров данных, ошибок и т. д.
Но, на мой взгляд, существует один фактор, который влияет как на то, что запрашивается, так и на то, как это подсчитывается: обвязка (harness). Обвязка, то есть код и конфигурации, используемые во время оценки, может влиять на то, что запрашивается у модели, путем включения или отключения функций OCR или задания таких параметров, как температура. Обвязка также может определять числовой показатель бенчмарка при обработке результатов. Таким образом, обвязка — это предварительная обработка (настройка) и постобработка (очистка), которые могут повлиять на оценку в бенчмарке.
Идем дальше: метрика, используемая для теста, может влиять на то, как оценивается ответ. Например, некоторые разработчики могут создавать метрики, адаптированные под то, как их модели OCR форматируют результаты. Сводка или агрегация результатов по категориям (например, рукописный текст или математические формулы) может повлиять на оценку бенчмарка. А когда есть группы или семейства результатов, то, как каждый из них взвешивается, может определить итоговый балл.
Наконец, существует знаменатель. Следует ли учитывать неудачные страницы? Например, если модель отказывается обрабатывать изображение из-за фильтра содержимого, считаете ли вы это сбоем или игнорируете результат?
Рисунок ниже не претендует на исчерпывающую полноту и создан не в Datalab. Это моя собственная ментальная модель того, что влияет на показатели бенчмарка. Читая эту статью, подумайте, представляете ли вы себе это иначе.
Что запрашивается — слева, как это подсчитывается — справа, а обвязка находится на линии между ними. Эта структура — моя собственная разработка.
Теперь, когда у нас есть ментальная модель факторов, определяющих показатель бенчмарка, давайте посмотрим, как рассчитывается оценка бенчмарка. Методы оценки бенчмарков различаются, поэтому мы проиллюстрируем подход к оценке OmniParseBench от Datalab.
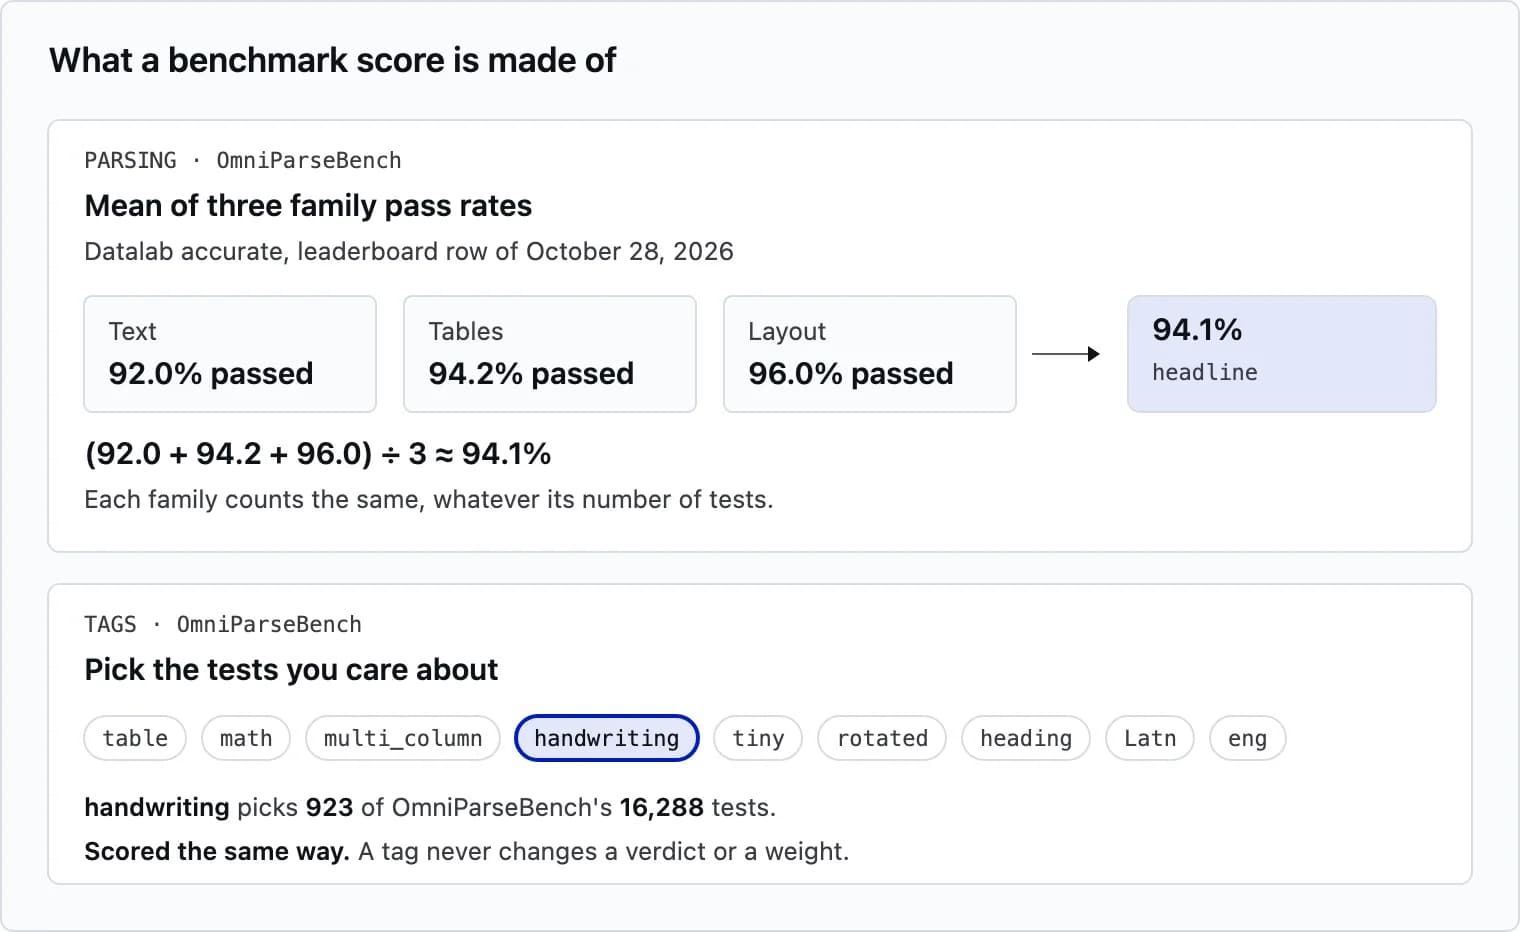
OmniParseBench усредняет результаты или вычисляет среднее значение для трех основных групп, называемых семействами. Это текст, таблицы и верстка. Семейства представляют собой логическую группировку типов тестов. Например, семейство текста включает тесты на проверку наличия значения, порядка значений (например, «сегодня» перед «средой») или повторений, которые подсчитывают, сколько раз появляется конкретная строка. Все три семейства имеют одинаковый вес, а их среднее значение называется «основным показателем» (headline).
Равный вес семейств бенчмарка означает, что добавление новых тестов в наиболее актуальное для вас семейство (например, таблицы) делает оценку таблиц более точной, но не увеличивает ее значимость в общем итоге.
Одна из моих любимых функций OmniParseBench — тегирование, которое полезно для выбора и фильтрации тестов, наиболее релевантных вашему сценарию использования. Например, что делать, если набор документов, который вы хотите оценить, не содержит рукописного текста? В OmniParseBench у вас есть возможность исключить из набора для оценки только тесты на рукописный текст.
Важно знать, что теги в OmniParseBench никогда не решают, пройден ли конкретный тест или нет, и они не определяют основной показатель.
Основной показатель парсинга — это среднее значение показателей успешности трех семейств. Теги выбирают тесты и никогда не меняют вердикт. Источники: OmniParseBench: четкий, проверяемый и доступный для изучения бенчмарк для распознавания текста (OCR) (08.10.2026); таблица лидеров OmniParseBench по состоянию на 28.10.2026.
Еще одна функция OmniParseBench, которую я ценю, — это использование модульных тестов, где каждый тест дает ответ «да» или «нет» на вопрос о странице. Существуют и другие способы оценки, например подсчет расстояния редактирования между выводом модели и эталонными данными. Но я создаю собственные оценки с помощью модульных тестов (например, присутствует ли это слово или присутствует ли это значение под этим заголовком, пример которого мы увидим позже в этой статье), потому что результаты тестов интерпретируемы, а написание модульных тестов масштабируемо.
Что делает OCR-бенчмарк полезным?
Знать, как оценивается бенчмарк — это одно, но понимать, почему бенчмарк полезен именно вам — совсем другое. Бенчмарк полезен, если он отражает то, как OCR-модели справляются с вашими конкретными данными и задачами. Следовательно, чтобы бенчмарк был полезным, он должен быть проверяемым и честно рассказывать о том, как и на каких данных он измеряет производительность OCR. Это означает следующее:
- Набор данных должен быть разнообразным и должным образом промаркирован.
- Предварительная обработка (настройка) и последующая обработка (очистка) каждым инструментом должны быть последовательными и честными для каждой оцениваемой OCR-модели.
- Оценка должна давать четкий сигнал об успешности выполнения задачи.
Заметное противоречие в OCR-бенчмарках заключается в том, что конкретные данные и задачи, определяющие полезность бенчмарка, различаются у разных пользователей, а общий балл представляет собой непрозрачное агрегированное число, усредняющее все детали.
Для обработки документов существует множество способов разделения данных. Один OCR-бенчмарк может оценивать любые из следующих параметров или все сразу:
- Наличие текста
- Порядок текста
- Распознавание таблиц
- Заголовки таблиц
- Верхние колонтитулы и названия
- Математические уравнения
- Язык
- Верстка
И этот список можно продолжать. Datalab пытается разрешить это противоречие с помощью упомянутого ранее тегирования в OmniParseBench благодаря тому контролю, который теги дают пользователям при формировании оцениваемых данных и задач. Благодаря этому пользователи могут получать более точный сигнал по результатам бенчмарка. Кроме того, модульность OmniParseBench и открытый исходный код позволяют пользователям создавать собственные оценки и даже редактировать код.
Как читать OCR-бенчмарк вендора?
Теперь, когда мы имеем представление о том, как формируется оценка бенчмарка и что делает его полезным, давайте используем эти знания, чтобы лучше понять четыре основных способа, с помощью которых поставщики OCR-моделей могут создавать выгодные для себя бенчмарки.
Четыре способа, которыми самостоятельно опубликованный бенчмарк может подыгрывать своему создателю, адаптировано из собственного списка Datalab. Источник: Мы проводим внешний бенчмарк извлечения данных (но запускайте свои собственные оценки) (14.07.2026).
Вендоры могут выбирать документы или адаптировать основной показатель под свои сильные стороны, ограничивать запуск тестов конкурентов во время оценки или настраивать свои системы ИИ на тестах бенчмарка. Обычно для каждой оцениваемой системы ИИ предоставляется только одна метрика. Но что, если бы бенчмарк опирался на другой набор документов?
Оценка в таблице лидеров — это измерение, и каждое измерение имеет погрешность. Datalab опубликовала реальные результаты каждого запуска в таблице лидеров с фиксацией вердикта о прохождении или непрохождении. Поэтому я использовал эту информацию для запуска симуляции и добавления планки погрешности.
Оценка бенчмарка может быть получена из набора тестов, который запускается всего один раз, но вы можете использовать статистический метод, называемый бутстрэппингом, чтобы оценить, как изменятся оценки бенчмарка, если для него будет использоваться другая выборка документов из того же пула. Поэтому я выполнил бутстрэп для 2343 индексов документов OmniParseBench, случайно выбрав 2,000 списков с возвращением (некоторые документы появляются в выборке дважды, а другие не появляются вовсе). С каждой выборкой я заново пересчитывал итоговый балл. Выполнение 2,000 выборок дает 2,000 симуляций для каждой OCR-модели без необходимости совершать реальные вызовы API. На графике ниже показаны средние 95% для каждой системы ИИ.
Подумайте об этом так. Если перед вами поставлена задача снизить задержку функции в приложении, вы, вероятно, не будете выпускать релиз на основе медианных результатов задержки по одному набору запросов. Вы, скорее всего, запишете медианную задержку по нескольким разным наборам запросов, каждый из которых имеет собственную медиану. Основной балл — это всего лишь одна выборка на тему «насколько эта система ИИ хороша в разборе подобных документов». Никто не выпускает релизы по единственной выборке задержки, поэтому не выбирайте OCR-модель по единственной оценке из таблицы лидеров.
,Каждый итоговый балл с центральными 95% от повторной выборки из 2343 документов бенчмарка 2000 раз. Три системы без оценки верстки исключены. Источник: мой анализ опубликованных вердиктов, набор данных OmniParseBench по состоянию на 29.10.2026.
,Каждый основной показатель колеблется примерно на 0,7–1,7 пункта в ту или иную сторону. Это шум. Теперь взгляните на разрывы. Из 30 мест, где одна система располагается непосредственно над другой, только 7 таких разрывов превышают уровень шума. Остальные 23 пары систем могли бы поменяться местами при другой выборке. Сравнение любых двух систем (а не только тех, что стоят рядом) показывает, что большинство разрывов реальны, поскольку 415 из 465 возможных комбинаций пар больше уровня шума. Таким образом, таблицу лидеров можно воспринимать как уровни (тиры), а не как строгий порядок.
,Имейте в виду, что приведенные выше погрешности охватывают только шум выборки документов, а не вариативность от запуска к запуску.
,Будьте скептичны, если бенчмарк какого-либо вендора ставит его собственные OCR-модели на первое место. Datalab занимает здесь верхнюю строчку, и именно поэтому так важно, чтобы данные и система оценки были публичными. И будьте осторожны, если в таблице лидеров показатели превышают 99%, так как это может означать, что бенчмарк благоволит вендору, оценки слишком просты, бенчмарк исчерпал себя (сатурирован) или имеет место комбинация всех трех факторов.
Подводя итог, при чтении результатов OCR-бенчмарка подумайте, содержит ли датасет то, что вас интересует. Если да, то оцените, предоставляют ли оценщики (один или несколько) честный и содержательный сигнал для измерения успеха задачи. Возможно, вам придется заглянуть в код, чтобы проверить, справедливо ли бенчмарк и его инструментарий обрабатывают предварительную и последующую обработку. Наконец, подумайте, позволяет ли бенчмарк выполнять фильтрацию по интересующим вас тегам с последующим переранжированием.
А теперь давайте подробнее рассмотрим сбои тестов, чтобы понять, как оценщик может не пройти тест.
Как выглядит сбой теста?
Давайте посмотрим на пример сбоя теста. На рисунке ниже показано двенадцать тестов для одной страницы данных, взятых из OmniParseBench. В тесте в первой строке тест ищет значение 4.0 a под заголовками Ranger Russet (Trial 5) > RF. В данном случае это тест table_cell, который ищет конкретное значение под определенными значениями заголовков Ranger Russet (Trial 5) > RF.
Правильное значение для этих заголовков возвращают как Datalab balanced, так и Datalab accurate (высокая точность, более высокая стоимость), поэтому тест успешно пройден для обоих режимов Datalab. То же самое справедливо и для одиннадцати из двенадцати тестов значений на этой странице. Но тест 9 не проходит. Почему? Причина сбоя показалась мне неожиданной, поэтому я решил поделиться этим примером.
Оказывается, Datalab balanced и Datalab accurate не проходят тест 9 не потому, что они не смогли вернуть значение 0.23 (они его вернули), а потому, что они не смогли вернуть это значение вместе с указанными заголовками Désireé (Trial 2) > Eggs/cyst. Если присмотреться, причиной сбоя теста является то, что вместо «Désireé», которое встречается в исходном документе, был возвращен заголовок «Désirée» — более распространенное написание с ударением на предпоследнюю «e».
Таким образом, причина сбоя теста со стороны оценщика (ячейки, соответствующие 0.23, были найдены, но не под заголовками Désireé ...) верна, поскольку вместо этого был возвращен заголовок Désirée .... Эти двенадцать тестов OmniParseBench не допускают никаких изменений, и данный оценщик проверяет текст символ за символом. Этот тест был получен из publisher_markup, поэтому требуемым ответом является исходный контент. Девять из 34 систем не проходят только этот тест, но успешно проходят другие похожие тесты на этой странице. 21 система, прошедшая все двенадцать тестов, скорее всего, сохранили оригинальное написание со страницы. Остальные четыре системы провалили несколько тестов на этой странице.
Как вы думаете, является ли замена Désireé на более распространенное написание Désirée фичей или багом? Если вы пишете собственные тесты, вы можете решить это сами!
Двенадцать тестов ячеек таблиц на одной странице бенчмарка с опубликованным вердиктом Datalab для каждого из них. 34 системы, подсчитанные в тексте, включают три системы, у которых нет оценки макета и, следовательно, нет общего заголовка. Единственный сбой: на странице напечатано «Désireé», а Datalab написала «Désirée». Источники: датасет OmniParseBench по состоянию на 2026-10-29; мой запуск от 2026-10-30 для заголовка, написанного Datalab.
В открытом и проверяемом бенчмарке, таком как OmniParseBench, каждый сбой теста имеет причину, которую можно изучить и оспорить. Я не буду рассказывать здесь о том, как запустить собственный бенчмарк, но стоит упомянуть, что Datalab создала OmniParseBench модульным и расширяемым. С помощью OmniParseBench вы можете использовать свои собственные документы, писать для них собственные тесты, добавлять собственную модель или даже добавлять собственный оценщик.
У OmniParseBench есть некоторые ограничения, о которых стоит знать. Например, придуманный текст не пенализируется, 2,3% проверенных фактов неверны, а 225 тестов зависят от правила верхнего/нижнего колонтитула, которое не задокументировано.
Заключение
Оценка OCR-бенчмарка от OmniParseBench представляет собой совокупность суждений об успешности или неуспешности, объединенных правилами. Если вы можете прочитать правила и результаты, вы можете оценить, оценивает ли бенчмарк факторы, имеющие отношение к вашим документам. Суммирует ли итоговая оценка бенчмарка семейства тестов, которые отражают то, что находится в вашем корпусе документов? И оценивает ли бенчмарк документы, подобные вашим?
Оценка в таблице лидеров — это одна точка данных, которая обычно не отражает вариативность от запуска к запуску. Хотя бутстрэппинг не поможет вам понять эту вариативность между запусками, он показывает, что производительность OCR-моделей группируется по уровням, а не по простым рангам. Не доверяйте только рангам. Создайте свой набор документов и напишите для них оценки.
Часто задаваемые вопросы
Какие лучшие OCR-бенчмарки для сравнения моделей парсинга документов?
Бенчмарк olmOCR benchmark оценивает способность OCR-моделей конвертировать PDF-документы в Markdown с сохранением контекста и структуры. Этот бенчмарк проверяет возможности OCR-моделей в отношении наличия и отсутствия текста, порядка чтения, точности таблиц и точности математических формул. Датасет olmOCR-bench содержит 7010 тестовых случаев в 1403 PDF-файлах. Datalab использовала некоторые документы и тесты из olmOCR-bench для создания OmniParseBench.
Каковы лучшие открытые OCR-модели в 2026 году и каковы их результаты?
В ходе сравнения OCR-моделей с открытыми весами Datalab определила лучшие модели в целом: chandra-ocr-2, dots.mocr, MinerU2.5-Pro и Infinity-Parser2-Pro. Для таблиц наибольшее количество баллов набрала MinerU2.5-Pro, за ней следует dots.mocr. Как по тексту, так и по рукописному вводу лидирует chandra-ocr-2, за ней следует LightOnOCR-3-4B. На неанглоязычных страницах лидирует chandra-ocr-2, за ней следуют dots.mocr и Surya OCR 2. Из 15 моделей, вернувших блоки макета, 14 набрали 89 баллов и выше.
Какой OCR-бенчмарк следует использовать для тестирования распознавания рукописного ввода?
Бенчмарк OmniParseBench от Datalab оценивает ведущие универсальные модели ИИ и OCR-модели в области распознавания рукописного ввода. С помощью OmniParseBench вы можете добавлять свои собственные примеры рукописного ввода и модульные тесты для оценки производительности OCR-модели на ваших документах. Если вы не видите OCR-модель, которую хотите протестировать в таблице лидеров OmniParseBench, инструкции в репозитории содержат рекомендации о том, как запустить оценку для выбранной вами модели.
Почему одни и те же OCR-модели занимают разные места в разных бенчмарках?
Набор документов (или корпус), используемый при оценке, различается для каждого бенчмарка. Такие бенчмарки, как olmOCR-bench и OmniParseBench, используют модульные тесты с ответами «да/нет», чтобы определить, пройден тест или нет. Модульные тесты в основном проверяют содержимое, но каждый бенчмарк имеет свои собственные соглашения. Бенчмарки, использующие метод оценки, известный как расстояние редактирования, могут оценивать производительность форматирования OCR, а вендоры могут адаптировать оценку под сильные стороны форматирования своих OCR-моделей.