Каждый пайплайн Datalab начинается с одного и того же вопроса: какой режим выбрать? Стоимость наших режимов составляет от $0,50 до $10 за 1 000 страниц, причем те из них, которые лучше всего справляются со сложными страницами, работают медленнее всего. Честный ответ всегда звучал так: «все зависит от ваших документов», что одновременно верно и не слишком полезно.
Бенчмарки тоже не дают окончательного ответа. OmniParseBench показывает, какой парсер лучше всего справляется с 2 937 страницами, которые мы выбрали. Он не может подсказать, достаточно ли режима Balanced для ваших страховых форм или принесут ли дополнительные $6 за 1 000 страниц хоть какую-то пользу при обработке ваших сканированных контрактов.
Evals отвечает на этот вопрос на основе ваших документов. Выберите несколько документов и режимы для тестирования, а затем нажмите кнопку «Сравнить» (Compare). Инструмент запускает каждый режим, находит все места, где они прочитали страницу по-разному, проверяет каждое такое место по странице и называет режим, который стоит использовать:
Увидьте каждое место, где режим ошибается
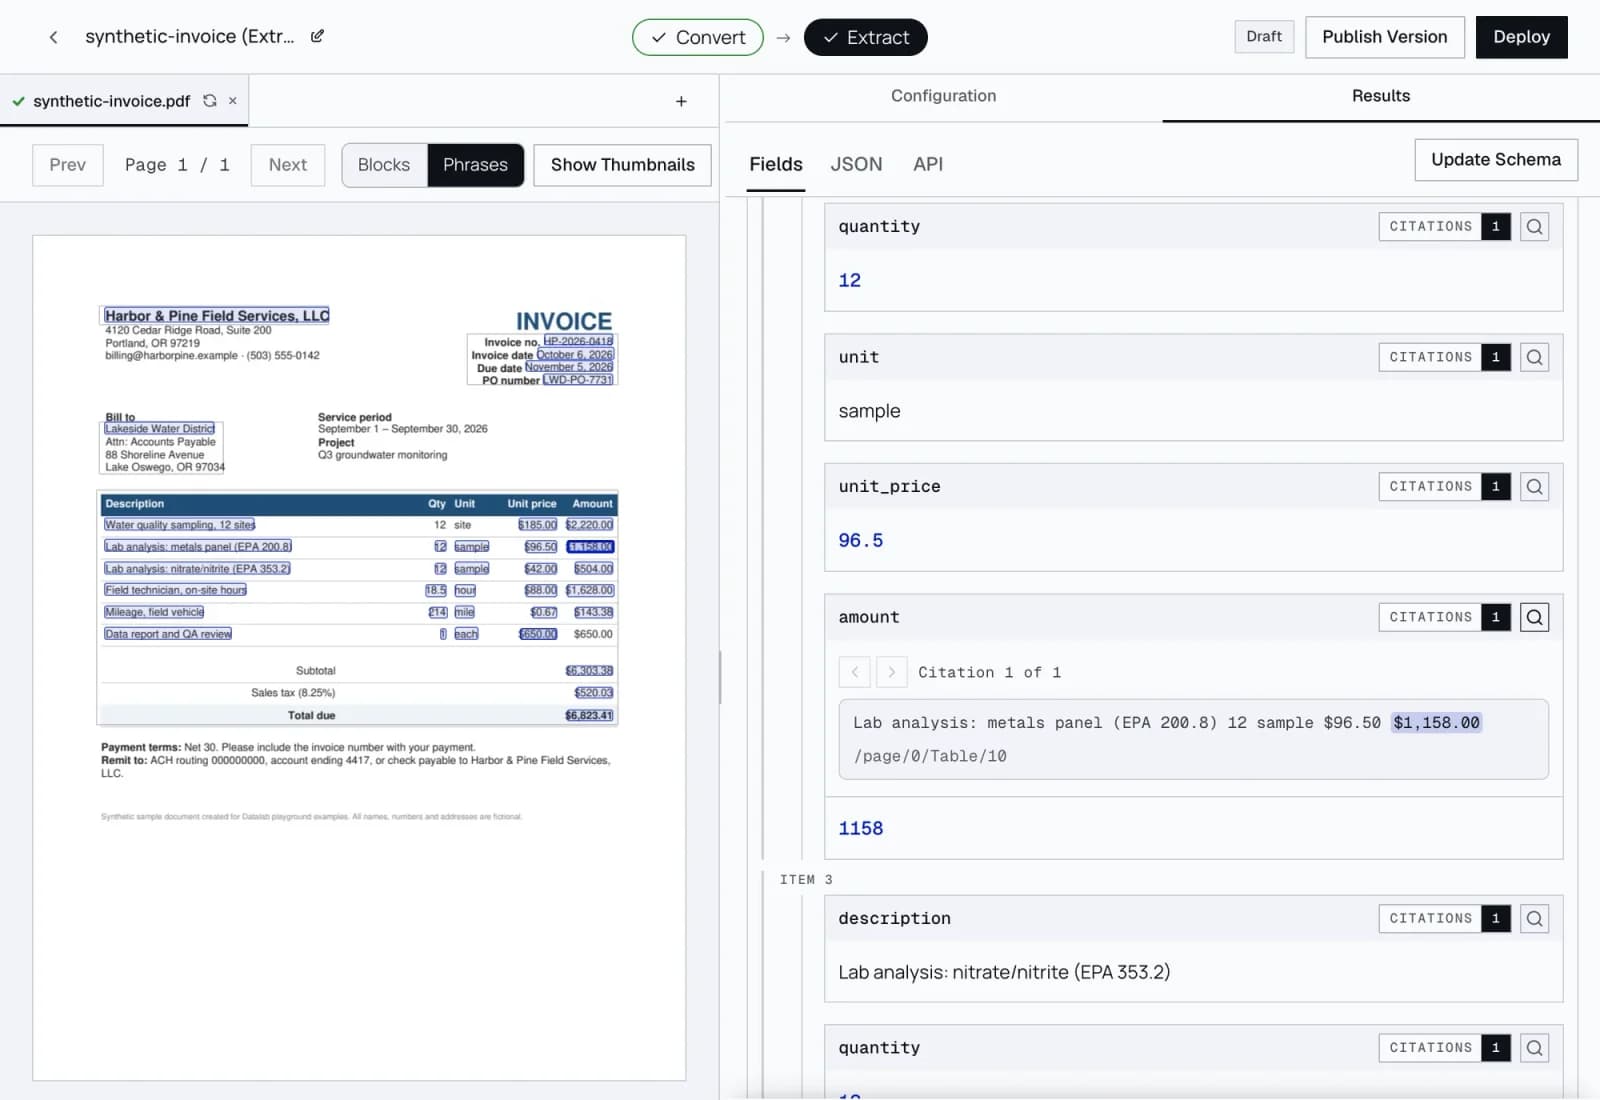
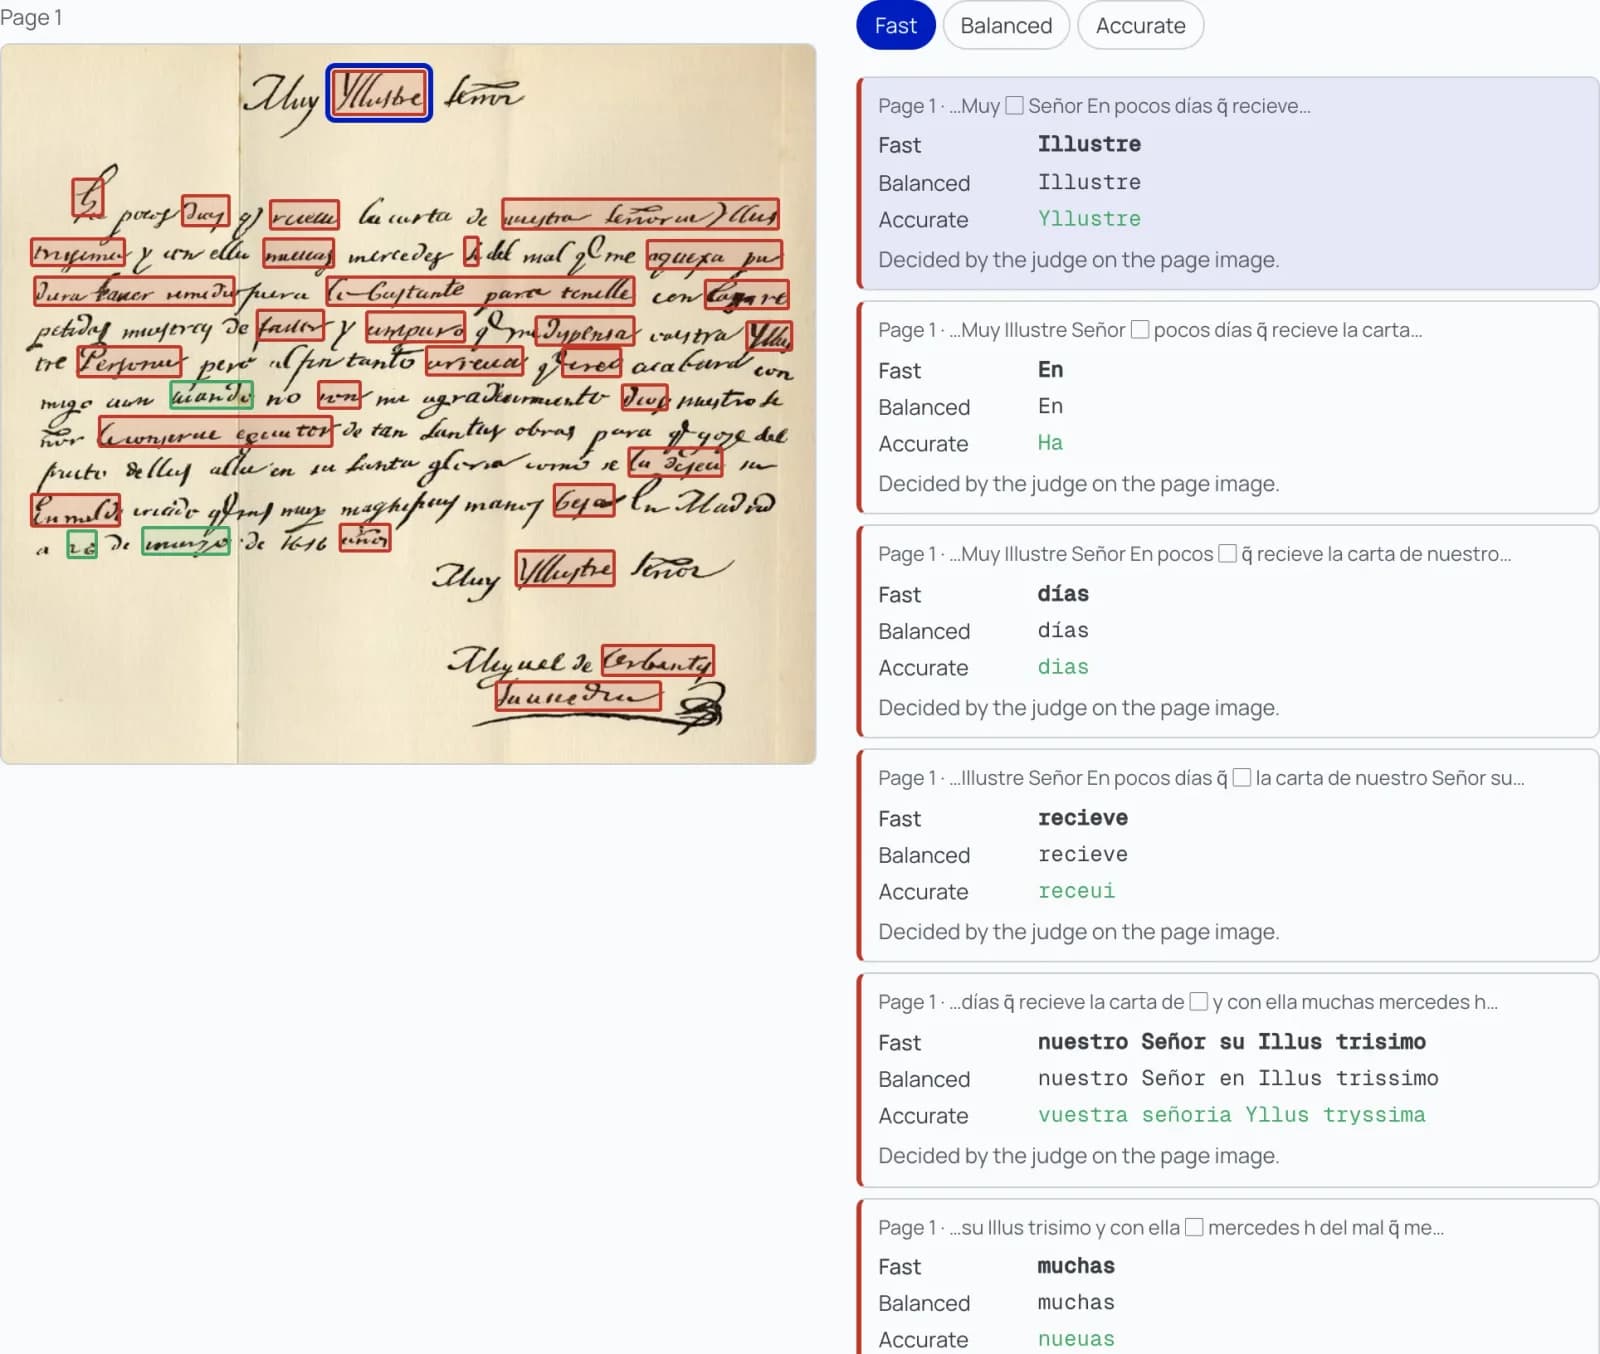
Рекомендация полезна только тогда, когда вы можете ее проверить. Нажмите на любую ячейку, и вы получите страницу с рамкой вокруг каждого места, где мнения режимов расходятся. Рамки ставятся на уровне слов, поэтому каждая из них указывает точно на конкретные слова. Текст, перенесенный на следующую строку, получает по рамке на каждой строке.
Каждое место в списке отображает результат распознавания для каждого режима, победивший вариант и то, что стало решающим фактором: текстовый слой PDF или визуальная модель (vision model), читающая страницу. Вкладка для каждого режима позволяет переключать вид, чтобы вы могли увидеть, в чем именно ошибается Balanced по сравнению с Accurate, и наоборот.
В письме 1616 режим Fast читает «En pocos días», тогда как Accurate читает «Ha pocos dias». Это два расхождения, и страница показывает, какое чтение является правильным.
Цифровые PDF-файлы работают точно так же. В повернутой таблице результатов из статьи PubMed Central режим Fast пропускает доверительные интервалы, такие как (0.93–2.93), которые сохраняют Balanced и Accurate. Если режимы по-разному читают заголовок столбца, текстовый слой PDF разрешает это противоречие.
Что именно проверяется
Ошибки режима не ограничиваются только словами, поэтому Evals запускает те же группы проверок, которые используются в OmniParseBench:
Для некоторых из этих проверок требуется осторожность во избежание ложных срабатываний. Два режима могут записать одно и то же уравнение в разной LaTeX-нотации (\le или \leq, \dfrac или \frac), поэтому перед сравнением уравнения приводятся к единому формату. Два режима также могут читать блоки страницы в разном порядке, например, в две колонки или в виде двух статей. Пословное сравнение превратило бы один перемещенный абзац в десятки несвязанных «различий». Поэтому текст каждого режима сначала восстанавливается в едином порядке блоков с использованием блоков из его вывода в формате JSON. Слова внутри каждого блока не перемещаются, поэтому некорректно прочитанное слово все равно будет учтено.
Элементы, относящиеся к стилю, не учитываются: регистр символов, пробелы, синтаксис разметки markdown, знаки препинания вокруг слова, номер страницы.
Вы можете сравнить от двух до четырех настроек одновременно. Выберите режим (Fast, Balanced или Accurate) и параметр объединения страниц («Merge across pages»), который определяет, будет ли таблица, разрывающаяся на стыке страниц, представлена как единая таблица.
Как этим пользоваться
- Откройте инструмент сравнения (Compare) из пайплайна. В Forge добавьте несколько своих документов в пайплайн конвертации (Convert) и нажмите «Сравнить» (Compare) рядом с кнопкой «Запустить» (Run).
- Выберите то, что нужно сравнить. Режимы Fast, Balanced и Accurate уже заполнены. Удалите ненужный режим и выберите параметр объединения страниц («Merge across pages») для каждого варианта. В нижней части страницы отображается стоимость до запуска.
- Прочитайте ответ. В первой строке указан режим, который следует использовать, и соотношение характеристик («Balanced стоит на 60% дешевле и дает на 20 худших результатов»). Для каждого режима отображается колонка с тем, как он справился по сравнению с лучшим режимом, его цена за 1 000 страниц и измеренное время работы в секундах на страницу.
- Проверьте доказательства. Нажмите на ячейку, чтобы просмотреть страницы с рамкой на каждом месте расхождения режимов.
- Используйте режим. Нажмите «Использовать этот» (Use this), и пайплайн переключится на выбранный режим.
Каждый режим работает по своей обычной цене. Само сравнение стоит $10 за 1 000 страниц.
Чтобы провести сравнение на более крупной выборке, поместите свои документы в коллекцию (Collection) и запустите для нее сравнение (Compare): каждый документ из коллекции пройдет через все режимы. Каждое сравнение сохраняется в разделе Evals на боковой панели, так что вы сможете вернуться к нему позже.
Выберите несколько документов, похожих на ваш реальный поток данных, включая сложные: факсимильную форму, фотографию с телефона, таблицу, занимающую две страницы. Именно на них режимы различаются сильнее всего.
Как принимается решение
Evals не оценивает каждый результат сам по себе. Если спросить модель «является ли это хорошей расшифровкой страницы?», вы получите оценку, которая плавает от запуска к запуску, а небольшие различия между режимами затеряются в этом шуме. Мы также пробовали заставлять модель заранее писать тесты для каждой страницы. На новых сканированных и рукописных страницах такие тесты обнаруживали от 0 до 6 из примерно 20 реальных ошибок каждого типа, которые выявляют тесты OmniParseBench. Модель, способная написать тест для сложного участка страницы, могла бы и прочитать этот участок правильно, поэтому тесты охватывали лишь то, что все режимы и так делали правильно.
Поэтому Evals задает более узкий вопрос: где режимы расходятся в мнениях и какое чтение соответствует странице?
- Программа сопоставляет слова из вывода каждого режима страница за страницей и выводит список всех мест, где по крайней мере один режим прочитал что-то иначе.
- Каждое такое место получает вердикт. Если на странице есть текстовый слой, побеждает вариант чтения, который ему соответствует. Это точный и бесплатный метод, при этом шрифты текстового слоя определяют полужирное и начертание курсивом тем же способом. У сканов и фотографий текстового слоя нет, поэтому визуальная модель (судья) изучает изображение страницы и выбирает подходящий вариант чтения, либо отвечает «ни один» или «неясно». Она видит все спорные места на странице за один вызов с перемешанными вариантами. Она отвечает на такие вопросы, как «Написано ли на странице Illustre или Yllustre?», что гораздо проще правильно определить, чем оценивать всю расшифровку целиком.
- Каждый режим получает список мест, где он ошибся, в то время как другой режим прочитал страницу правильно. Лучший режим отмечен как «Лучший» (Best), а для всех остальных указано, на скольких местах они читают хуже. Места с вердиктом «Неясно» («Unclear») не учитываются.
Цифры намеренно приводятся в относительном выражении. Если каждый режим неправильно читает одно и то же слово, Evals не видит этого и не пытается делать вид, что видит. Вы выбираете между режимами, а общая для них ошибка не меняет этот выбор.
Почему этому можно доверять
Инструмент, рекомендующий определенный режим, должен быть безупречно точным, поэтому мы проверили каждый его компонент на данных с известными результатами.
Самый прямой тест — запустить Evals там, где ответ нам уже известен. В OmniParseBench опубликованы результаты и вердикты пройден/не пройден для режимов Datalab Accurate и Balanced. На 214 из 2 937 страниц эти два режима дают хотя бы один различающийся вердикт теста. Мы запустили продакшн-версию Evals на 137 из этих страниц (фиксированная выборка цифровых PDF, сканов и нескольких рукописных страниц) и задали два вопроса.
Во-первых, сопоставление по каждому месту: когда один из тестов бенчмарка для текста или таблиц разделяет два режима, и это приходится на место, оцененное Evals, выбирает ли Evals тот же самый режим? Это подтверждается в 151 случае из 174 (87%).
Во-вторых, сопоставление по каждой странице: совпадает ли режим с меньшим количеством худших мест на странице с режимом, который успешно проходит больше тестов бенчмарка на ней? Это подтверждается на 91 странице из 121 (75%), как для сканированных страниц, оцениваемых по изображению (25 из 32), так и для страниц с текстовым слоем (66 из 89). Совпадение растет по мере увеличения разрыва. Когда один режим побеждает в тестах бенчмарка на странице всего с преимуществом в один тест, Evals согласен с ним в 64% случаев (37 из 58). При разнице в три теста и более совпадение составляет 91% (30 из 33).
Там, где они расходятся во мнениях, они обычно измеряют разные вещи. На одной странице PubMed Central в эталонном тесте есть два теста ячеек таблицы, и Balanced проходит оба. Evals обнаружила на странице еще 48 чисел, которые Balanced пропускает, каждое из которых определяется текстовым слоем PDF. Эталонный тест проверяет несколько фактов на страницу, выбранных и проверенных заранее. Evals проверяет каждое слово, в котором режимы различаются.
Мы выбрали судью на сложных страницах, а не на простых. В письме Сервантеса 1616 года мы визуально проверили 25 мест и четыре раза запустили каждую модель зрения-кандидата с производственным промптом. Модель, которую мы используем, была права в 21–23 из 25 мест. Остальные кандидаты варьировались от 5 до 23, и самые слабые из них ошибались одинаково: они «исправляли» страницу. Судья, который выбирает «días», потому что это современное написание, когда на странице написано «dias», поощряет режим, который модернизирует, а не тот, который читает. Мы выбрали модель, которая была наиболее верна странице в том виде, в котором она написана.
Мы попробовали давать судье фрагмент каждого места вместо всей страницы. В отдельной серии запусков на тех же 25 местах фрагменты показали себя хуже: от 19 до 21 правильного ответа против 23–24 для всей страницы при 12-кратном увеличении входных токенов. Судье нужен контекст строки и почерка.
Мы также отдельно проверили тесты таблиц и форматирования. Мы запустили проверку таблиц на 310 страницах OmniParseBench, сравнив Accurate и Balanced, и сопоставили это с собственными тестами table_cell эталона. Проверка отметила 17 из 27 страниц, где тесты эталона расходятся между двумя режимами. На этих страницах судья выбрал того же победителя, что и эталон, в 12–13 из 17 случаев при трех запусках. Каждая страница, на которой они не согласились, содержала диапазон, который сама страница показывает по-разному, например, заголовок, центрированный по трем столбцам, который в исходных данных охватывает два. Две разные модели зрения согласны в 92% различий в таблицах.
На 785 страницах с тестами формата OmniParseBench проверка обнаружила 41 из 57 тестов, где Accurate и Balanced расходятся. Там, где решение зависело от шрифтов PDF, они каждый раз соглашались с эталоном (14 из 14).
У Evals есть ограничения, и мы хотим, чтобы вы о них знали:
- Ошибка, которую совершают все режимы, не учитывается. Evals говорит вам, какой режим лучше, а не насколько хорош лучший из них.
- Судья — это модель. Ее типичная ошибка — «исправлять» опечатку, которая напечатана на странице.
- Сканированная страница, у которой уже есть текстовый слой OCR, обрабатывается как цифровая страница, поэтому ошибки этого слоя определяют результаты в соответствующих местах.
Попробуйте Evals в Forge.