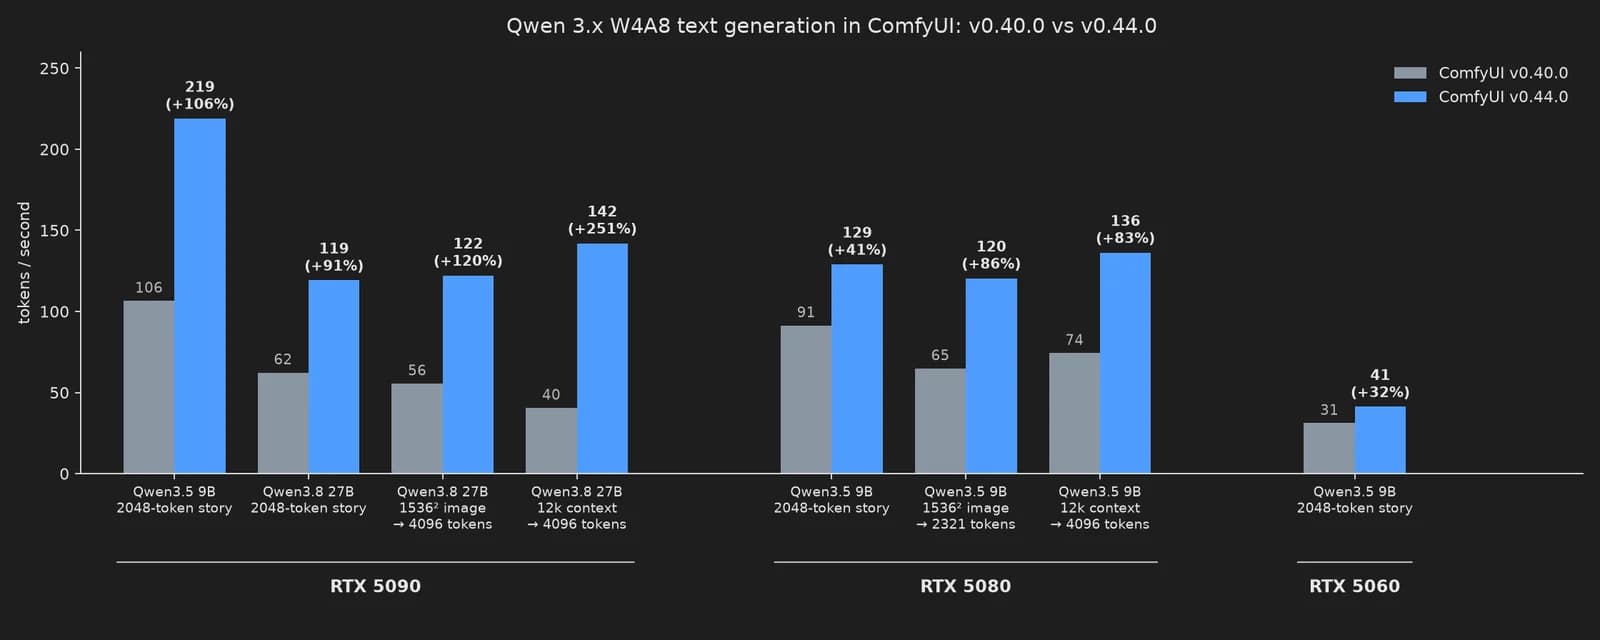
ComfyUI локально запускает множество больших языковых моделей (LLM) для улучшения промптов, написания текстов, описания изображений и даже базового общения. Недавно мы переписали критически важный путь генерации текста, уделив особое внимание семейству LLM Qwen3.x. В результате одни и те же чекпоинты на том же GPU теперь могут генерировать токены почти в два раза быстрее, без каких-либо изменений в самой модели или качестве её ответов. Это также ускоряет работу многих инструментов улучшения промптов, включенных в современные модели генерации изображений.
На RTX 5090 скорость Qwen3.5 9B выросла со 106 до 219 токенов в секунду, а на RTX 5080 — с 91 до 129 токенов в секунду. При описании изображения 1536×1536 модель Qwen3.8 27B показала рост с 55 до 122 токенов в секунду на RTX 5090.
Qwen3.8 27B W4A8 на RTX 5090 при описании изображения 1500×1500 и написании текста: 137 токенов в секунду с включенной опцией mtp в режиме auto.
В этом блоге обсуждаются некоторые архитектурные детали и особенности реализации вывода LLM, а также недавние улучшения производительности. Все описанное здесь доступно в ComfyUI v0.45.0. Просто загрузите чекпоинт Qwen3.x, оставьте опцию mtp в узле Text Generate в режиме auto и приступайте к работе.
Генерация текста — это последовательный процесс: каждый новый токен зависит от предыдущего и требует полного считывания весов модели для каждого токена. Масштабируемый вывод LLM обычно позволяет экономизировать затраты на чтение весов путем объединения нескольких запросов в пакеты (батчи), например, при обработке независимых чатов от разных пользователей. Однако рабочий процесс ComfyUI обычно генерирует только одну последовательность, поэтому каждый шаг представляет собой пакет из одного элемента. Для модели с 27 миллиардами параметров, квантованной до четырех бит, такой как Qwen3.8 W4A8, один шаг требует считывания примерно 14 ГБ весов для создания одного токена, при этом для каждого веса может выполняться всего одна математическая операция. Узким местом генерации токенов является скорость, с которой ваш GPU может считывать модель из видеопамяти (VRAM).
В отличие от них, диффузионные модели, используемые в ComfyUI для генерации изображений или видео, обрабатывают весь латентный вывод на каждом шаге, где каждый вес применяется ко всей длине последовательности. В отличие от LLM, узким местом диффузионных моделей является вычислительная мощность, определяемая скоростью вычислений GPU. Это создает совершенно иную задачу оптимизации по сравнению с миром генерации изображений и видео.
Большинство весов в моделях LLM представляют собой линейные матричные умножения. Они обрабатываются линейными ядрами, известными как ядра GEMM/GEMV — это оптимизированные программы для GPU, предназначенные для умножения матриц. В нашем случае с LLM плотная, часто квадратная матрица умножается либо на вектор (M=1 для состояния одного токена), либо на очень тонкую матрицу (например, M=3 для состояния проверки Multi-Token Prediction (MTP) с небольшим количеством токенов). Это и есть «тонкая» линейная задача.
В недавних изменениях были добавлены значительные оптимизации использования шины VRAM и эффективности, чтобы перенастроить работу исключительно на скорость чтения из VRAM и время работы шины памяти VRAM.
Чекпоинты Qwen3.x поставляются с «головой» для предсказания нескольких токенов (MTP): это небольшой дополнительный слой по сравнению с основной моделью, который использует скрытое состояние модели для угадывания следующего токена. ComfyUI использует эту функцию MTP для спекулятивного декодирования. Голова MTP создает несколько вариантов токенов, а затем при следующем проходе прямого распространения все предложенные токены проверяются спекулятивно. Этот процесс стоит примерно столько же, сколько генерация одного токена, поскольку проход все еще ограничен скоростью VRAM. Каждый вариант MTP, который совпадает с тем, что выбрала бы основная модель, принимается, что позволяет избежать полного прохода прямого распространения и, в свою очередь, экономит полное чтение модели для каждого правильно угаданного токена MTP. Именно так MTP может более чем удвоить скорость вывода токенов, значительно повышая производительность.
В этих недавних изменениях мы оптимизировали вычислительное ядро для MTP, а также улучшили сам алгоритм MTP с помощью нового адаптивного древовидного алгоритма MTP.
Чекпоинты Qwen3.x в ComfyUI обычно имеют формат W4A8 (4-битные веса, 8-битные активации) или W6A8 (6-битные веса, 8-битные активации). В ComfyUI v0.40.0 они обрабатывались через путь общего назначения INT8: квантование активации, запуск линейного ядра матрица-вектор, написанного только для соответствия макету VRAM W4A8, хранящемуся в файлах safetensors. Мы заменили это оптимизированным ядром матрица-вектор (GEMV), где веса и их групповые масштабы чередуются в памяти в том порядке, в котором ядро их потребляет. Таким образом, каждый блок потоков считывает непрерывный поток данных вместо того, чтобы переключаться между тензором весов и тензором масштабов, что сокращает обращения к VRAM и повышает эффективность конвейеров массового чтения VRAM. Эта специфичная для ядра перекомпоновка VRAM выполняется на месте в VRAM и управляется динамическим движком загрузки весов, требуя выполнения только один раз при загрузке модели. Этот процесс не требует дополнительной оперативной памяти или VRAM. Такая перекомпоновка нужна только для наших «тонких» линейных слоев, так как более «толстые» линейные слои диффузионных моделей ограничены вычислительной мощностью и скрывают задержки, связанные с вышеупомянутыми обращениями к VRAM.
Большинство современных GPU оснащены тензорными ядрами, которые вычисляют фрагмент операций умножения матриц за одну инструкцию GPU. GPU NVIDIA, начиная с 30-й серии, оптимизированы для минимального размера фрагмента (тайла) 8, при этом другие прямоугольные размеры могут быть больше. Новое ядро использует эту инструкцию умножения-накопления матриц (MMA) с весами и входными данными, расположенными так, что тонкий размер M, показанный на изображении выше, соответствует минимальному аппаратно поддерживаемому размеру фрагмента 8. Это позволяет использовать одну инструкцию, минимизируя при этом неиспользуемые вычислительные строки (когда M < 8). Для случая генерации одного токена, где M=1, это дает примерно ту же производительность, что и использование инструкций, не относящихся к тензорным ядрам (CUDA) (dp4a). Однако этот подход с использованием фрагментов мгновенно становится быстрее при рассмотрении MTP, где M > 1. В конечном итоге, до восьми строк предположений MTP становятся практически бесплатными, так как наш тайлер может вычислять до M=8 с той же скоростью, что и M=1.
В линейное ядро были добавлены новые слияния пролога: квантование активации теперь поглощает RMSNorm или SwiGLU, которые предшествуют ему, поэтому эти промежуточные тензоры никогда не записываются в память между ними, что минимизирует трафик кэш-памяти и накладные расходы на запуск ядра. Это, в свою очередь, минимизирует небольшие чистые вычислительные разрывы между активностью шины VRAM, обеспечивая небольшое дополнительное ускорение.
Qwen3.5 и 3.8 — это модели с гибридным вниманием: тип модели, который использует две разные схемы внимания, применяемые к отдельным блокам трансформера. Три из каждых четырех слоев — это линейное внимание DeltaNet с небольшим рекуррентным состоянием, а четвертый — обычное внимание с групповыми запросами (grouped-query attention) с KV-кэшем.
Для слоев внимания мы добавили ядро декодирования, которое обрабатывает короткий запрос либо для одного токена, либо для нескольких предложенных токенов из MTP и его строк причинной проверки напрямую, без материализации маски внимания. Оно разделяет кэшированный префикс между множеством блоков потоков, поэтому GPU заполняется лишь крошечным запросом, а последний завершивший работу блок объединяет частичные результаты в рамках того же запуска.
Для слоев DeltaNet наиболее затратной частью была спекуляция. Проверка черновика из нескольких токенов требует наличия рекуррентного состояния после каждого из них, и в случае отклонения черновика состояние должно быть восстановлено. Раньше это означало создание снимка полного состояния объемом 64 КиБ на голову для каждого слоя после каждого спекулятивного токена. Теперь ядро записывает небольшие промежуточные данные для каждого токена и откладывает обновление состояния, чтобы следующий вызов только воспроизводил принятые токены и записывал зафиксированное состояние один раз. Ядро, в свою очередь, жертвует небольшим объемом дополнительных вычислений ради значительного сокращения нагрузки на память, что решает нашу основную проблему «узкого места» — ограничение по видеопамяти при наличии избыточных вычислительных мощностей.
Ранее авторегрессионное ядро внимания KV-кэша было отдельным от недавно добавленной оптимизированной схемы внимания Comfy-Kitchen. Внимание Comfy-Kitchen вместе с поддержкой KV-кэша было добавлено в ComfyUI v0.45, что позволило использовать INT8-внимание для специфической схемы внимания LLM, описанной ранее в блоге. Это уменьшает объем занимаемой KV-кэшем видеопамяти, а также значительно увеличивает скорость предварительного заполнения (pre-fill) для длинных промптов, системных промптов или уже существующих контекстов.
Вы можете запустить ComfyUI с параметром --use-ck-attention, чтобы включить внимание Comfy-Kitchen.
В ComfyUI v0.40.0 создание черновиков MTP изначально ограничивалось одной цепочкой предположений о токенах, соответствующей одному варианту того, какими будут следующие 2–5 токенов. Цепочка создавала один токен, возвращала его в модель, а затем создавала следующий токен до установленного значения глубины для MTP. По умолчанию установка MTP в значение auto давала от 2 до 5 токенов, адаптирующихся в зависимости от режима сэмплирования или промежуточного измерения успешности. Слабость такого цепочечного подхода заключается в том, что он делает ставку на единственное предположение, и каждое последующее предположение в цепочке может быть потеряно, если оно неверно. Если лучший выбор головы MTP на глубине 1 неверен, весь шаг дает только один токен, даже если второй лучший вариант на глубине 1 был правильным.
Цепочечный MTP создает только один путь. Древовидный MTP сохраняет альтернативные токены на каждом уровне как дочерние элементы, проверяет все дерево за один проход и перепланирует структуру дерева на основе того, что было успешно принято.
Альтернативный подход, позволяющий избежать этого потенциального изъяна в цепочке, заключается в использовании адаптивного древовидного алгоритма. На каждом уровне лучший выбор головы MTP продолжает основную цепочку, как и раньше, со своим лучшим предположением для каждого черновика, но небольшое количество альтернативных предположений сохраняется в качестве кандидатов для последующей проверки MTP. Это формирует небольшую структуру дерева черновиков с дополнительными листьями-кандидатами, которые проверяются, но не используются для дальнейшего создания черновиков. Теоретически можно создать любое количество предположений с убывающей отдачей для каждого дополнительного предположения в любой структуре дерева глубины, однако наше линейное ядро вычисляет до M=8 «бесплатно». Это устанавливает предел количества предположений на уровне семи (M=8-1), чтобы соответствовать нашему вычислительному ядру и аппаратному обеспечению. Проход проверки теперь несет до восьми строк: зафиксированный токен плюс семь токенов черновика, при этом каждый из них должен рассматриваться как несколько альтернативных вариантов будущего.
Тип текста как для промпта, так и для вывода определяет, какую форму должно принять дерево. Предсказуемый вывод, такой как код, списки или описание, повторяющее промпт, поощряет глубину, что означает, что длинные цепочки принимаются целиком. Творческое письмо поощряет широту: лучший выбор часто бывает неверным, но правильный токен обычно находится в первой тройке. Адаптивный MTP постоянно измеряет показатели, поэтому MTP в режиме auto продолжает измерять и перепланировать процесс «на лету». Он ведет экспоненциально затухающий подсчет того, какой ранг имел принятый токен — был ли он первым выбором, вторым, третьим… или ни одним из них — на каждом уровне черновика, а также замеряет фазы создания черновика и проверки с помощью событий CUDA. Каждые 32 шага он оценивает все 64 способа компоновки семи строк черновика как цепочки ширины, оценивая ожидаемое количество принятых токенов на шаг на основе условных вероятностей попадания и деля на измеренную стоимость, verify_ms + depth × draft_ms. Он переключается только в том случае, если победитель лучше как минимум на 3%, чтобы гарантировать, что форма не будет постоянно меняться, и поскольку каждая форма использует одни и те же восемь строк, графы CUDA, захваченные для этого шага, продолжают работать при переключении.
Адаптивный древовидный MTP можно использовать, если для значения MTP установлено значение auto в узле Generate Text.
В период между ComfyUI v0.40.0 и v0.45.0 генерация текста Qwen3.x в ComfyUI стала значительно быстрее на том же оборудовании. Более длинные контексты, которые раньше приводили к нехватке памяти, теперь легко помещаются, а спекулятивный декодер теперь подстраивается под текст, который он пишет. Эти улучшения работают на NVIDIA и AMD, Windows и Linux и не требуют от вас дополнительных действий, кроме обновления ComfyUI.