Живое видео стало главной темой в AI-сообществе Twitter в последнее время. От модели H3 Max, обученной постом Fal, которая в прошлом месяце конкурировала по качеству и возглавила чарты, до модели FastH3, оптимизированной по стоимости. Видеомодели прошли долгий путь с тех пор, как люди шутили, что ИИ-модели не могут анимировать Уилла Смита, поедающего спагетти!
Как бы ни впечатляли эти недавние модели, существует проблема. И эта проблема — стоимость. Запуск этих моделей в непрерывном режиме может стоить более 6 тысяч долларов в день! Это делает данные модели совершенно непригодными для обычного пользователя.
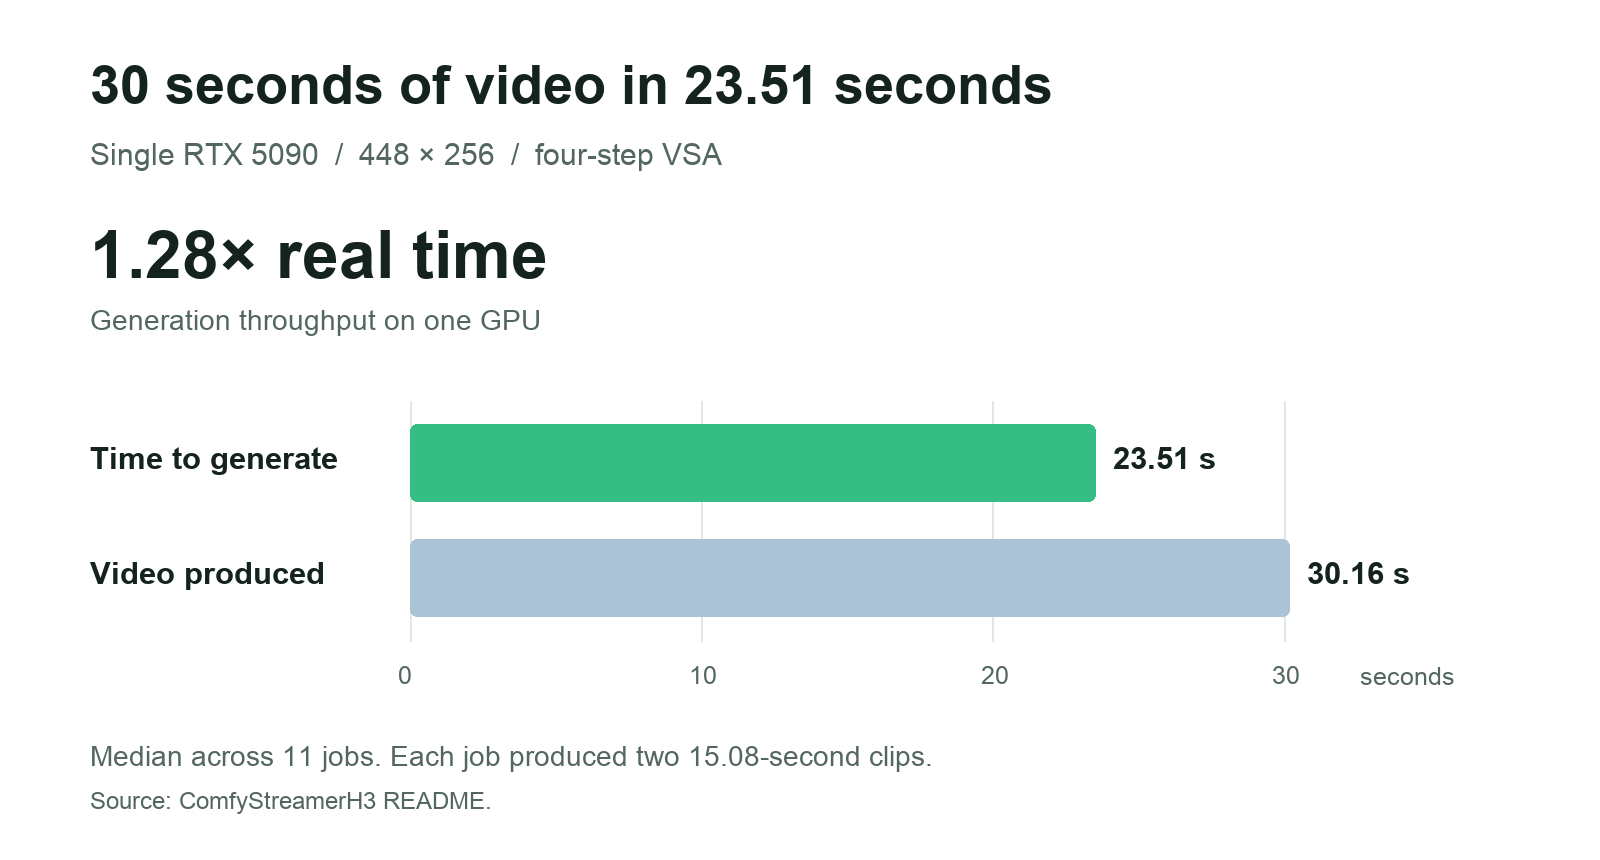
Поэтому я задался вопросом: насколько далеко можно продвинуть эти модели? Что, если заставить агента искать в интернете каждую оптимизацию, каждое ускорение, каждую экономию средств и, безусловно, каждый «грязный хак», который жертвовал качеством ради скорости? А что, если собрать всё это в один кастомный узел Comfy, работающий на одном потребительском GPU? Мои требования были следующими:
- Оборудование: одна RTX 5090 с 32 ГБ видеопамяти
Оборудование: одна RTX 5090 с 32 ГБ видеопамяти
- Скорость: генерация 15 секунд видео за 15 секунд или быстрее
Скорость: генерация 15 секунд видео за 15 секунд или быстрее
- Разрешение: 448×256
Разрешение: 448×256
- Качество: сохранить смотрибельность, даже если у клипов есть шероховатости
Качество: сохранить смотрибельность, даже если у клипов есть шероховатости
RTX 5090 была полезной целью: некоторые высококлассные игровые ПК оснащены ею, а аренду можно найти примерно за 70 центов в час на самом дешевом сегменте рынка.
Аниме
Стилизованное 3D
Акварель
У клипов явно есть некоторые шероховатости и артефакты. Но это совсем не ужасный результат для одного GPU, который можно арендовать менее чем за 70 центов в час!
Но хватит разговоров, давайте перейдем к деталям. Обычных зрителей предупреждаю: я даже сам не всё понимаю, так как это просто то, что мой агент смог извлечь из других проектов. Слава Astra Codex!
Я использовал в четырехэтапной настройке. Для сравнения, FastVideo Preview V1 сгенерировал 15-секундный клип в разрешении 1344×768 за 47,2 секунды на одном B200 (подсказка: это гораздо более дорогой GPU).
Вот что мы оптимизировали для запуска рабочего процесса на одной RTX 5090:
- Четыре шага сэмплирования. Каждый шаг — это еще один раунд работы модели по уточнению видео. Использование четырех шагов означает меньше работы для каждого клипа.
Четыре шага сэмплирования. Каждый шаг — это еще один раунд работы модели по уточнению видео. Использование четырех шагов означает меньше работы для каждого клипа.
- Разреженное внимание (Sparse attention). Внимание позволяет частям видео обмениваться информацией по мере генерации. VSA фокусирует полное внимание на выбранных 20% блоков видео — пропуская около 80% — при этом сохраняя промпт.
Разреженное внимание (Sparse attention). Внимание позволяет частям видео обмениваться информацией по мере генерации. VSA фокусирует полное внимание на выбранных 20% блоков видео — пропуская около 80% — при этом сохраняя промпт.
- Текстовый энкодер меньшего размера. Энкодер превращает ваш промпт в информацию, которую может использовать H3. NicoLab28’s ClipProj адаптирует Qwen3-VL-4B для замены 32B-энкодера H3: он использует около 4,5 ГБ вместо 15,7 ГБ.
Текстовый энкодер меньшего размера. Энкодер превращает ваш промпт в информацию, которую может использовать H3. адаптирует Qwen3-VL-4B для замены 32B-энкодера H3: он использует около 4,5 ГБ вместо 15,7 ГБ.
- Чекпоинт меньшего размера. FastVideo’s pruned INT8 checkpoint сочетает прунинг (удаление выбранных весов) с хранением INT8 (8-битные числа), уменьшая объем видеопамяти, необходимый модели.
Чекпоинт меньшего размера. сочетает прунинг (удаление выбранных весов) с хранением INT8 (8-битные числа), уменьшая объем видеопамяти, необходимый модели.
- Объединенный FP4 MLP. MLP обрабатывает множество повторяющихся вычислений модели. Использование 4-битной математики для этой части и объединение операций означает меньше памяти для весов и меньше промежуточных результатов для перемещения; это основано на ByronLeeeee’s H3 optimizations.
Объединенный FP4 MLP. MLP обрабатывает множество повторяющихся вычислений модели. Использование 4-битной математики для этой части и объединение операций означает меньше памяти для весов и меньше промежуточных результатов для перемещения; это основано на .
- Декодирование и кодирование вместе. Kijai’s INT8 H3 video decoder перестраивает видео по тайлам. NVENC начинает записывать каждый готовый тайл, пока декодер готовит следующий, поэтому шаги перекрываются. Рабочий процесс сохраняет только последний кадр для следующей задачи, вместо кэширования каждого декодированного кадра.
Декодирование и кодирование вместе. перестраивает видео по тайлам. NVENC начинает записывать каждый готовый тайл, пока декодер готовит следующий, поэтому шаги перекрываются. Рабочий процесс сохраняет только последний кадр для следующей задачи, вместо кэширования каждого декодированного кадра.
Эти оптимизации улучшили как скорость, так и использование памяти, снизив требования к VRAM с 80 ГБ до менее чем 30 ГБ, что безопасно укладывается в 32 ГБ видеопамяти RTX 5090.
Если вы хотите протестировать результаты самостоятельно, кастомный узел Comfy выпущен с открытым исходным кодом здесь: https://github.com/Comfy-Org/comfystreamerh3
Кроме того, вы можете арендовать GPU на платформе Comfy Developer Platform.
Comfy API управляет хостингом GPU, моделями и зависимостями, поэтому ваше приложение может запрашивать видео, не имея собственного GPU. Вы можете следовать инструкциям в файле readme here, чтобы зарегистрироваться и развернуть эту демо-версию в Comfy API.
Очевидно, что есть значительный потенциал для улучшения детализации изображения, согласованности и разрешения этих видео. Но то, что H3 генерирует хотя бы частично разборчивое видео в реальном времени на одной RTX 5090, показывает, как далеко можно продвинуть эти модели на переднем крае живого видео на одном GPU. Следующим шагом было бы пропустить каждый клип через оптимизированную по стоимости модель апскейлинга видео, такую как недавно выпущенная SolRefinery: то есть генерировать быстрые начальные видео в разрешении 448 × 256, а затем дешево масштабировать их до более высокого разрешения. Мое предварительное тестирование с этой моделью показывает увеличение плотности пикселей в 7 раз при использовании всего в 3 раза большего количества GPU. Так что, учитывая возможность будущих оптимизаций, мы можем получить экономически эффективное, полупригодное живое видео раньше, чем вы думаете!
Нет публикаций