Последний год мы активно полагались на бенчмарк olmOCR. Это хороший и качественно разработанный бенчмарк. Но сейчас он уже исчерпал себя — большинство приростов достигается за счет более сложной постобработки, а не за счет улучшения качества самих моделей.
Тем временем бенчмарк ParseBench от LlamaIndex стал использоваться шире. Мы потратили много времени на его оценку. Он в основном измеряет то, форматируете ли вы вывод так, как он ожидает (то есть совпадаете ли вы с тем, как LlamaIndex форматирует вывод) — мы подняли модель с 650 млн параметров почти на вершину таблицы лидеров всего за несколько шагов RL, без какого-либо улучшения качества базовой модели.
Pulse, другая компания по обработке документов, также получила прирост в 22 балла в одной из категорий бенчмарка просто за счет обновления своего промпта и конфигурации в соответствии с соглашениями LlamaIndex.
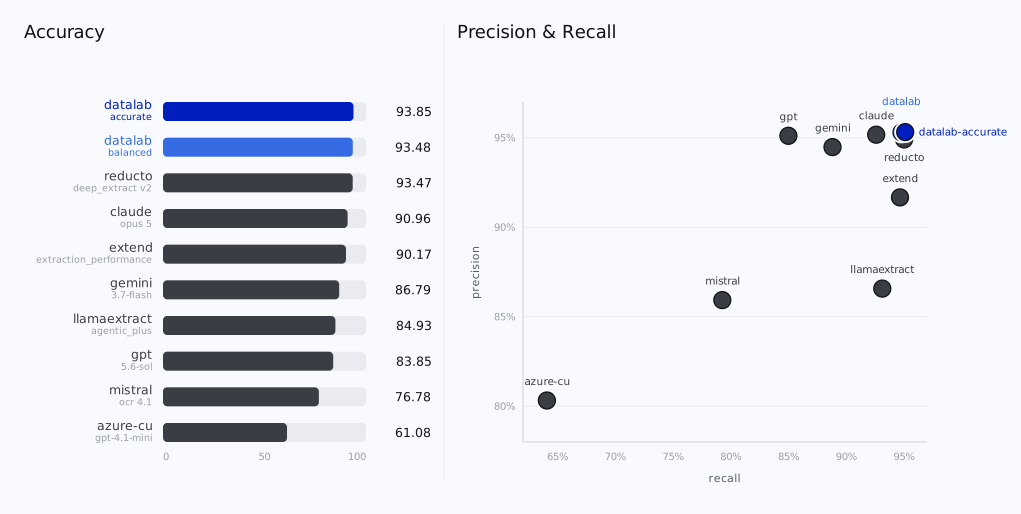
Мы создали новый бенчмарк, OmniParseBench, и выпустили его на прошлой неделе. Отныне мы будем использовать именно его для отчетов о наших релизах. В этом посте объясняется, почему он нам понадобился и почему мы считаем его справедливым.
Год на olmOCR
Мы использовали olmOCR-bench от AllenAI с момента запуска Chandra и для каждого последующего релиза (Chandra 1.5 и 2, а также Surya 2).
Он нам нравился по трем причинам:
- Юнит-тесты, а не расстояние редактирования. Каждый тест представляет собой вопрос «да/нет» по одной странице: присутствует ли данное предложение, идет ли этот абзац перед тем, находится ли эта ячейка под тем заголовком. Непрошедший тест указывает на конкретную ошибку, которую можно посмотреть.
- Его сложно обмануть. Бенчмарки, построенные на расстоянии редактирования по отношению к одной эталонной транскрипции, вознаграждают за соответствие форматированию эталона. Юнит-тестам в основном все равно, как вы форматируете, им важно лишь то, правильно ли вы передали контент.
- Четкий сигнал. Долгое время оценки olmOCR совпадали с нашими субъективными ощущениями. Когда модель казалась лучше, она получала больше баллов.
olmOCR исчерпал себя
В ноябре прошлого года мы писали об исчерпании возможностей бенчмарка olmOCR. Мы попросили Gemini перепроверить каждый не прошедший тест и обнаружили, что большинство сбоев были придирками к форматированию, а не ошибками модели. С учетом этой корректировки показатель Chandra вырос с 85,5% до 93,9%. Около 3-4% тестов имеют неверную разметку ground truth или очень категоричные правила, поэтому реальный предел составляет около 96-97%.
Это означает, что запаса для роста почти не осталось. Большинство оставшихся приростов достигается за счет более точного соответствия форматированию бенчмарка, а не за счет лучшего чтения.
Насыщение также меняет то, что вознаграждает бенчмарк. Когда модели находятся так близко к пределу, оставшиеся баллы приносит нормализация вывода в ту самую форму, которую ожидают тесты. Поэтому в релизах моделей, таких как недавние Infinity Parser и LightOnOCR, теперь приводятся оценки olmOCR после постобработки, написанной специально для бенчмарка. Это разумная реакция на отсутствие других путей для улучшения. Но это означает, что оценка больше не коррелирует с качеством модели.
Эффект составляет 1-2 балла на модель. В собственной таблице постобработки LightOn модель Infinity-Parser2-Pro набирает 85,9 без обработки и 87,6 с оценочной постобработкой, а LightOnOCR-3-4B набирает 85,0 без обработки и 86,3 с нормализацией (86,0 в нашей репликации). Один балл больше, чем большинство разрывов между моделями в таблице лидеров.
И размер постобработчиков продолжает расти. Постобработчик Chandra OCR 2 занимает менее 100 строк и преобразует наши собственные соглашения вывода, такие как теги <sup>, в формат бенчмарка. Постобработчик LightOn занимает около 700 строк: он преобразует таблицы с формулами в текст, удаляет отточие, сокращает пробелы в формах и восстанавливает формулы внутри строк. Постобработчик Infinity-Parser2 также занимает около 700 строк и применяет различные перезаписи, нацеленные конкретно на каждую категорию olmOCR.
Стимул становится очевидным, когда мы применяем ту же нормализацию к нашей собственной модели. Без обработки Chandra OCR 2 и LightOnOCR-3-4B набирают одинаково в пределах погрешности: 85,1 и 85,0. С нормализацией LightOn поверх нашей собственной обработки результат Chandra OCR 2 вырастает до 86,2. Мы могли бы продолжать подниматься в рейтинге olmOCR, написав еще более крупный постобработчик. Однако мы предпочитаем улучшать саму модель, а не тратить время на манипуляции с бенчмарком.
Другая проблема — покрытие. olmOCR в основном англоязычный, состоит главным образом из статей с arXiv и сканов Internet Archive. В нем нет форм. Тесты таблиц проверяют только ближайших соседей ячейки, с чем простые таблицы легко справляются. Практически нет нелатинских письменностей. Это именно те документы, с которыми борются наши клиенты, и бенчмарк их «не видит».
ParseBench
ParseBench стал бенчмарком, который люди используют вместо предыдущего — он стартовал с поста в блоге, публичного датасета и статьи на arXiv, и теперь другие вендоры ссылаются на него в своих релизах. LlamaIndex создала этот бенчмарк, и ее собственный продукт, LlamaParse, занимает первое и второе места.
Проблема ParseBench заключается в том, что он измеряет не качество OCR, а то, насколько ваш вывод соответствует формату, ожидаемому ParseBench (что обычно означает, насколько хорошо вы согласованы с тем, как выдает результаты LlamaParse). Это бесполезно, если вы пытаетесь оценить качество модели.
Вот несколько причин почему:
Промпт дает 22 балла
Pulse занимала 7-е место в бенчмарке до сентябрьского обновления своей конфигурации и 3-е после него. Обновление включило этап доработки и добавило промпты, адаптированные под бенчмарк. В сентябре Pulse изменила эти промпты, чтобы детально прописать форматирование, которое проверяет бенчмарк:
«Сохраняйте подписи к графикам, иерархию заголовков, структуру таблиц и семантическое форматирование. Переносите встроенные стили в разметку markdown: **жирный**, *курсив*, <u>подчеркнутый</u>, ~~зачеркнутый~~, <sup>надстрочный</sup>, <sub>подстрочный</sub>, <mark>выделенный</mark> маркером, а также уровни заголовков (#, ##, ###), соответствующие визуальной иерархии».
«Сохраняйте подписи к графикам, иерархию заголовков, структуру таблиц и семантическое форматирование. Переносите встроенные стили в разметку markdown: **жирный**, *курсив*, <u>подчеркнутый</u>, ~~зачеркнутый~~, <sup>надстрочный</sup>, <sub>подстрочный</sub>, <mark>выделенный</mark> маркером, а также уровни заголовков (#, ##, ###), соответствующие визуальной иерархии».
Другой ее промпт заканчивается фразой «никогда не добавляйте акценты, которых там нет» — что точно соответствует штрафу за ложные срабатывания в коде оценки. В сообщении о коммите говорится прямо: это изменение заставляет «конфигурацию запрашивать то, что измеряет измерение семантического форматирования», и при повторном запуске от Pulse категория бенчмарка «Семантическое форматирование» подскочила с 51,39 до 73,97. Это 22,6 балла от изменения промпта и конфигурации.
Мы увидели тот же эффект вообще без изменения промпта. Включение задокументированных опций вывода в нашем API подняло нашу оценку семантического форматирования с 46,27 до 77,35 в нашем запуске их тестового инструмента (40,79 в опубликованном варианте). Текст был идентичным, и форматирование не стало лучше как таковое — оно просто совпало с соглашениями, которые ожидает ParseBench.
Модель с 650M параметров почти на вершине, с 70 шагами RL
Если ParseBench в основном измеряет формат, небольшая модель должна иметь возможность подняться на вершину. Поэтому мы попробовали это сделать.
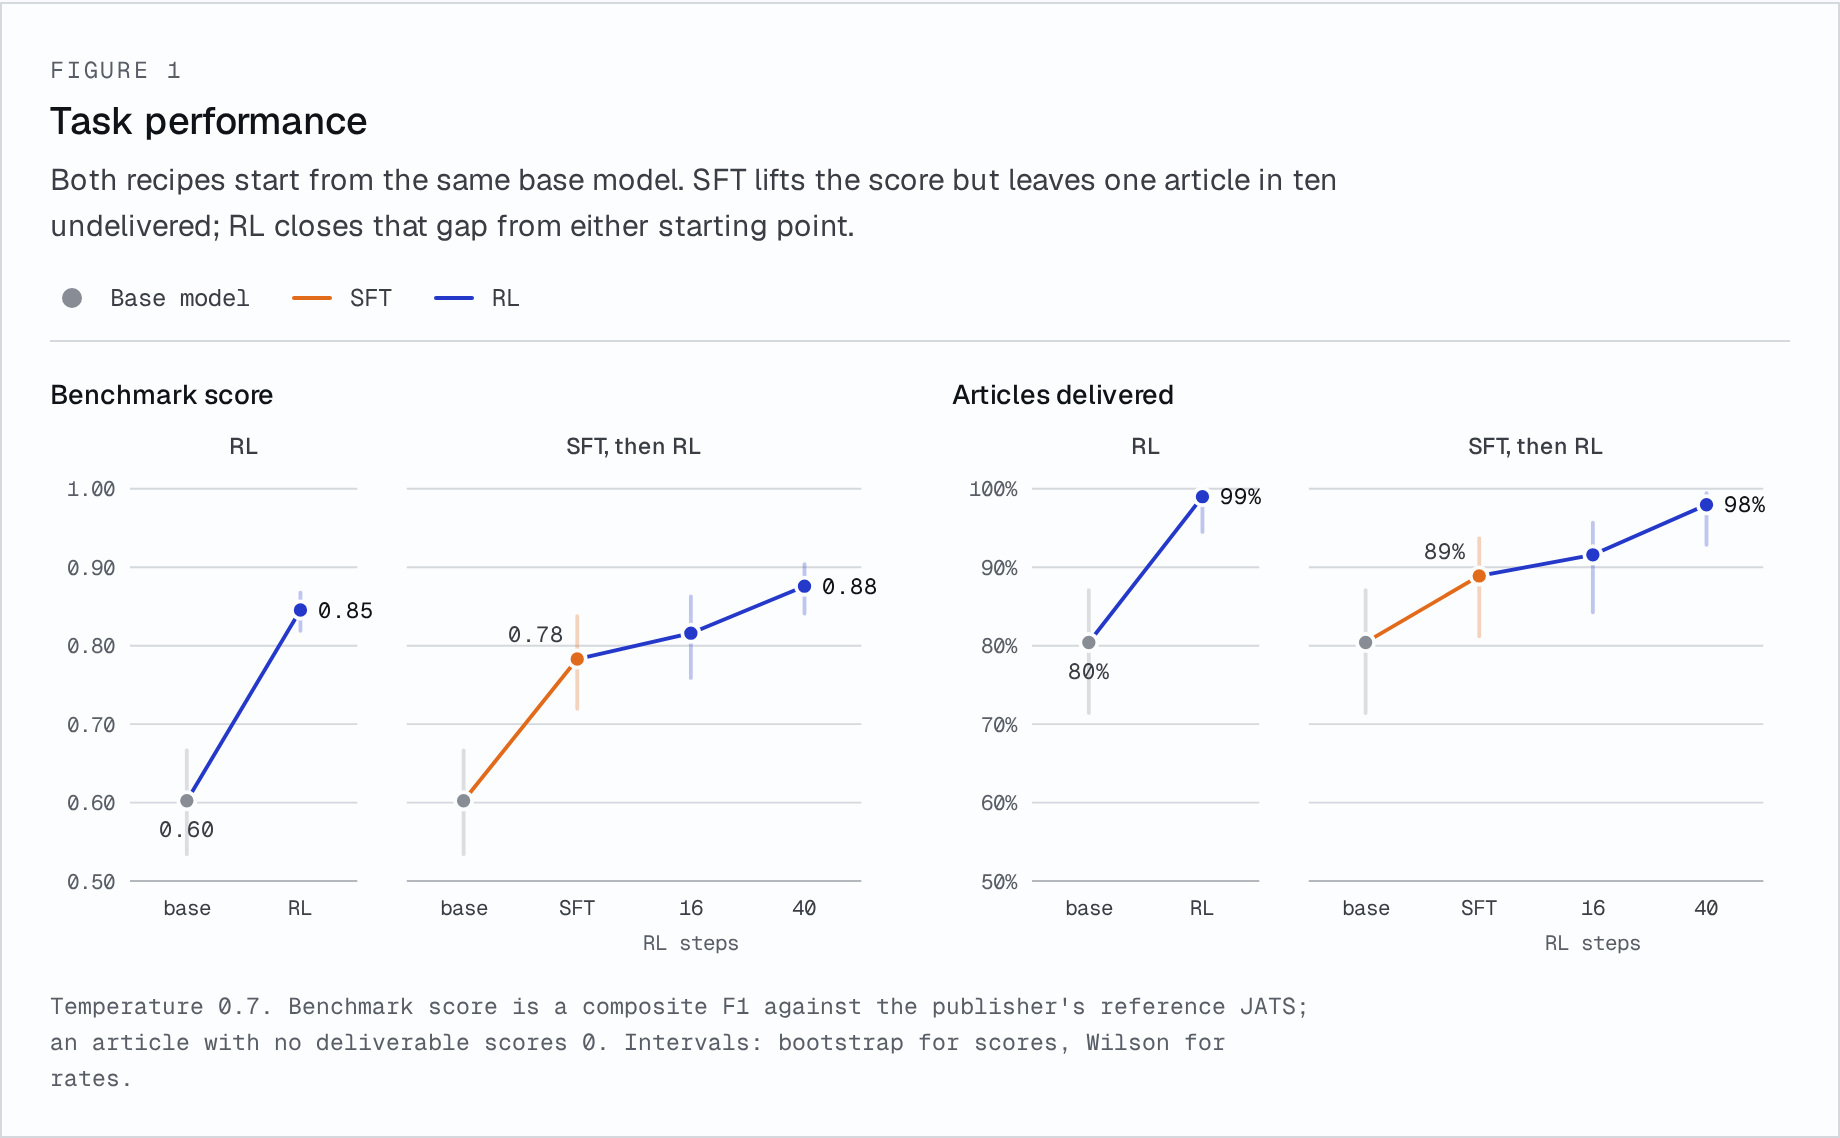
Мы взяли Surya, нашу открытую OCR-модель с 650 млн параметров, и выполнили 70 шагов обучения с подкреплением (RL). Мы не обучали модель ни на каких документах ParseBench.
После 70 шагов и нескольких исправлений вывода Surya поднялась с 23-го на 3-е место из 148 (5-е без исправлений) по четырем измерениям, не связанным с графиками, опередив каждую пограничную модель и каждую открытую модель в таблице.
Surya — очень мощная модель OCR, но другие бенчмарки и субъективные оценки показывают, что в задачах OCR она на самом деле не лучше, чем Gemini 3.8 flash и Opus 5.5.
Это означает, что бенчмарк вознаграждает форматирование, а не реальное улучшение качества модели.
Мы выпускаем контрольную точку (checkpoint) вместе с конвертером и точными настройками, чтобы вы могли проверить это самостоятельно: datalab-to/surya-parsebench-rl.
Графики измеряют оценку, а не парсинг
Категория «Графики» требует от парсера превратить каждый график в таблицу, а затем проверяет отдельные числа в ней.
- 73% правил для графиков (3569 из 4864) являются оценками. Значение не указано на графике прямо, поэтому парсеру приходится считывать его с полосы или линии. Эталонными данными для них служат оценки самой VLM.
- Оценки оцениваются так, будто они точны. Для большинства допускается относительная погрешность в 5-10%, а для 182 применяется стандартное значение по умолчанию в 1%.
- Метки должны совпадать с наименованиями в эталоне. Парсер, который называет серию по-другому или ориентирует таблицу иначе, терпит неудачу, даже если в ней содержится правильное число.
- Парсер, который сохраняет график в виде изображения или расшифровывает текст на нем, получает ноль баллов.
Таблица лидеров отражает результат. Медианная система набирает 37 баллов в категории «Графики», а лучшая передовая модель — 70,89. Самые высокие баллы достаются продуктам с конвейером преобразования графиков в таблицы: LlamaParse Agentic Plus (94,18), Pulse Ultra 2 (89,70) и LlamaParse Agentic (88,68).
Графики сортируют парсеры по наличию у них этого конвейера, а не по тому, насколько хорошо они читают страницу. И снова мы оцениваем не качество модели, а соответствие бенчмарку.
Визуальное позиционирование (Visual Grounding) следует за LlamaParse
Код, генерирующий эталонную разметку, указывает, что он работает «на основе нормализованного вывода парсера» и сопоставляет метки с помощью map_llamaparse_raw_label_to_canonical.
Мы попытались воспроизвести рамки с помощью модели открытой разметки. В нашем тесте модель открытой разметки PP-DocLayoutV2 совпала лишь с 68% текстовых блоков и 39% заголовков разделов при IoU 0,8. Ни один опробованный нами публичный инструмент не воспроизводит их.
Таблица лидеров показывает этот эффект. Все три уровня LlamaParse набирают баллы с разницей менее чем в полбалла друг от друга в категории Visual Grounding (от 83,77 до 84,25) при 15-кратном диапазоне цен. Лучшая из остальных 144 систем набирает 80,61 балла, а лучшая передовая модель — 72,91.
Сравните это с другими категориями. В каждой из них самый дешевый тарифный план LlamaParse отстает от лучшей из остальных систем в 2–12 раз. Visual Grounding — единственная категория, в которой он превосходит всех:
Мы точно не знаем, какая именно система нарисовала рамки, но похоже, что это тесно связано с тем, как рисует рамки LlamaIndex. Дешевый тариф, который проигрывает везде и выигрывает только здесь, — это как раз то, чего следовало ожидать, если эталонные данные соответствуют его условностям.
Есть и другие проблемы — ошибки подсчета очков, которые аннулируют целые категории для красиво оформленного HTML, правила, которым не может соответствовать ни один парсер, и документы, которые никогда не оцениваются. Но четыре вышеупомянутые проблемы являются основными: оценка в ParseBench в основном показывает, насколько точно парсер соответствует условностям ParseBench.
Что делает OmniParseBench по-другому
Мы хотели сохранить то, что делало olmOCR хорошим, и исправить то, из-за чего он исчерпал свой потенциал.
Сохраняется структура модульных тестов (unit tests). Каждый тест по-прежнему представляет собой вопрос «да/нет» по одной странице: этот текст присутствует, этот идет перед тем, эта ячейка находится под этими заголовками, эта строка находится внутри блока таблицы. OmniParseBench содержит 16 288 тестов на 2 937 страницах из 2 343 исходных документов.
Ему все равно на ваше форматирование. HTML или markdown, с красивым оформлением или без, $…$ или <math>: каждый вывод проходит через один и тот же конвертер и ту же нормализацию, применяемую к обеим сторонам каждого сравнения. Уравнения сравниваются по тому, во что их рендерит KaTeX, а не по тому, как написан LaTeX.
Каждый тест указывает, откуда взят ответ. Большинство тестов получено из источников, которым известен ответ: JATS XML издателя для таблиц, формы, которые мы заполнили сами, текстовые слои PDF, проверенные тесты самого olmOCR. Остальные поступают от группы независимых моделей, причем разногласия разрешаются человеком. В каждом тесте фиксируется источник, поэтому вы можете фильтровать их по степени доверия к нему.
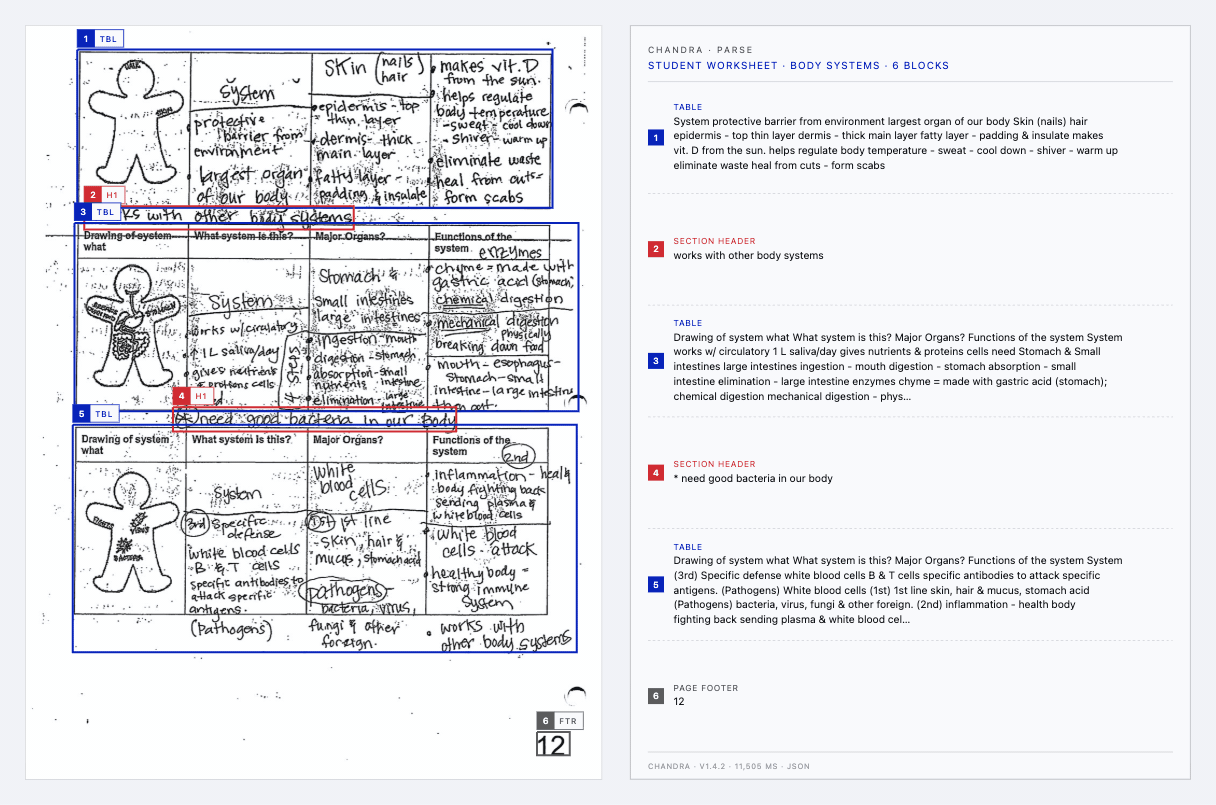
Он охватывает сложные случаи. Формы (пустые, заполненные и сканированные), рукописный текст, ухудшенные сканы, мелкий текст на инженерных чертежах, повернутые страницы, 92 языка и таблицы с реальной структурой — многоуровневые заголовки, строки разделов и группы строк, сверенные с XML издателя.
У него есть запас прочности (headroom). Мы удалили 18 264 теста, которые прошли все системы и которые также прошел простой инструмент без модели (pdftotext, PyMuPDF, Tesseract), — они не могут различать парсеры. Лучшая система набирает в целом 92,9 балла, а в сложных срезах показатели намного ниже. Для нелатинских письменностей лучшая система успешно проходит 88,6% тестов, а медианная — 81,5%. На ухудшенных сканах лучший результат составляет 85,6%, а медианный — 78,6%. В случае рукописного текста лучший результат — 81,4%, а медианный — 72,2%. Мы продолжим добавлять новые сложные пограничные случаи, чтобы бенчмарк не исчерпал свой потенциал полностью.
В нашем посте о запуске подробно описано, как тесты получают теги и как разделять результаты.
Обеспечение справедливости
Мы создали бенчмарк, в котором участвуем сами, поэтому планка честности должна быть выше, а не ниже. Вот что мы сделали:
- Ни один провайдер не получает пользовательский промпт. Каждое API парсинга работает с собственными оптимальными настройками, используя только документированные параметры. Универсальные модели (GPT, Gemini, Claude) получают одни и те же короткие промпты, опубликованные в репозитории. Никто не получает инструкций, написанных под критерии оценки, включая нас самих.
- Адаптеры меняют только формат. Конвертация markdown провайдера в HTML или возврат заголовков, которые провайдер возвращает отдельно. Каждое изменение проверяется на предмет отсутствия потерь.
- Одинаковое отношение к ошибкам. Каждый провайдер получает одинаковое время ожидания (таймаут) и одинаковое количество повторных попыток.
- «Не поддерживается» не означает «ошибка». Если провайдер не может создавать блоки макета, эти тесты исключаются из его оценки, а не засчитываются как неверные.
- Эталонные модели помечены. Gemini 3.8 Flash и Claude Sonnet 5.5 помогли создать или проверить некоторые тесты. Мы по-прежнему оцениваем их, но делаем пометку, поскольку они могут иметь преимущество в этих тестах.
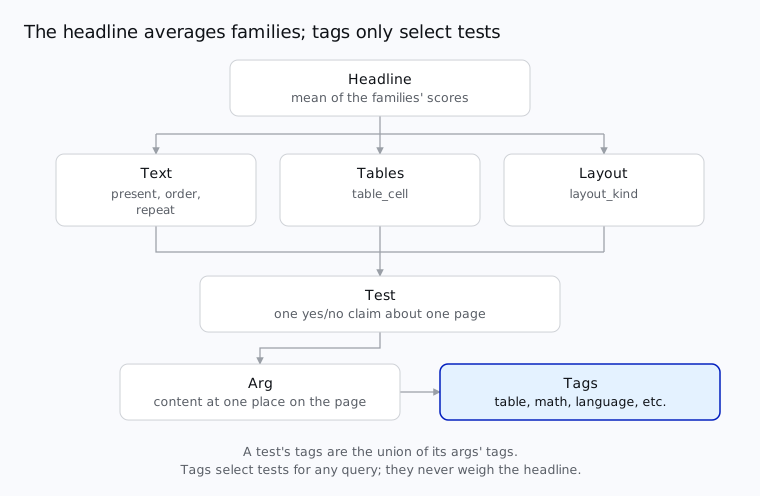
- Заголовок нельзя исказить количеством тестов. Это среднее значение для текста, таблиц и макета, поэтому добавление новых тестов какого-то одного типа делает эту оценку более точной, но не увеличивает ее вес.
- Все находится в открытом доступе. Код распространяется под лицензией Apache 2.0, а каждая страница и каждый тест опубликованы.
- Мы не обучаемся на нем. Страницы бенчмарка исключаются из наших обучающих данных.
Он будет продолжать развиваться
Статический бенчмарк со временем исчерпывает свой потенциал — именно это произошло с olmOCR. Поэтому OmniParseBench — это живой бенчмарк. Когда мы (или клиент) обнаруживаем сбой, который он не может зафиксировать, мы добавляем для него тесты. Несколько наборов уже находятся в разработке: больше рукописного текста, федеральные формы, газеты, где модели пропускают целые колонки, и символы из чужих систем письменностей, проникающие в текст.
Каждый релиз имеет версию, поэтому результаты всегда сравниваются для одной и той же версии.
Как мы будем сообщать о релизах
Отныне о каждом выпуске модели и API мы будем сообщать с указанием баллов OmniParseBench. Вот как обстоят дела на сегодняшний день:
* Используется при создании и проверке некоторых тестов. Полные результаты, данные о стоимости и задержках приведены в посте о запуске.
Мы создали этот бенчмарк и продаем парсер — вам стоит иметь это в виду, как и в случае с ParseBench. Разница, к которой мы стремимся, заключается в том, что вам не нужно верить нам на слово. У каждого теста есть записанный источник, а программа оценки представляет собой около 2000 строк простого кода на Python, который вы можете прочитать.
И как всегда: лучший бенчмарк — это ваши собственные документы. Запускайте собственные оценки.