Iraqi Knowledge Portal (KIQP) — это иракская инициатива в области цифровых знаний, запущенная Центром каталогизации и информационных систем при Департаменте интеллектуальных и культурных дел святыни Аль-Аббаса в сотрудничестве с университетом Аль-Кафил. Ее миссия — сохранение, систематизация и расширение доступа к историческим, академическим, культурным и архивным знаниям Ирака посредством единой цифровой среды с возможностью поиска.
Это крупнейшая платформа цифровых знаний в Ираке. В настоящее время платформа работает с такими материалами, как газеты, журналы и книги, с планами по дальнейшему расширению, включая рукописи, диссертации, научные работы и другие архивные коллекции. Техническая команда KIQP сотрудничала с Datalab, чтобы проверить, можно ли упростить процесс оцифровки их материалов.
Задача: фрагментированный рабочий процесс обработки документов
KIQP полагается на обработку документов, чтобы сделать свою базу исторических знаний доступной для поиска. До появления Datalab они разделяли рабочий процесс обработки документов между несколькими инструментами OCR и обработки изображений. Это делалось по нескольким причинам:
- Структура страницы и форматирование часто терялись, особенно в старых сканах.
- Исторические документы требовали значительной ручной подготовки, включая корректировку качества изображения, освещения, контрастности и читаемости.
- Точность распознавания нескольких языков была еще одной проблемой, особенно для арабского и других менее представленных языков, которые важны для их коллекций.
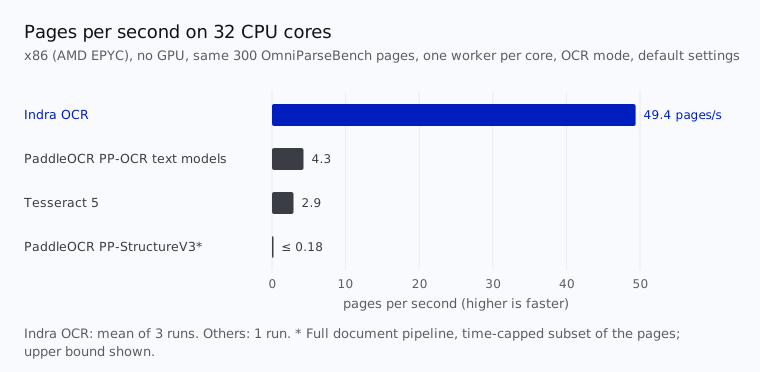
Сложность фрагментированного рабочего процесса побудила Махди, разработчика программного обеспечения и программиста в KIQP, изучить другие решения OCR. Его команда протестировала и объединила несколько подходов к OCR и предварительной обработке, включая Tesseract OCR и PaddleOCR, вместе с ручной корректировкой изображений и проверкой человеком.
Эти инструменты хорошо работали с такими языками, как английский, немецкий и французский, но результаты были менее стабильными для арабского, яванского и суахили. Для получения приемлемого результата часто требовалось переключаться между инструментами, готовить изображения вручную, объединять выходные данные и исправлять ошибки, прежде чем контент мог попасть в рабочий процесс портала KIQP.
Решение: API Datalab
Его команда узнала о Datalab во время исследования высокопроизводительных моделей OCR и решений для обработки документов. Впервые они столкнулись с проектом через GitHub, что привело их к дальнейшей оценке на официальной платформе Datalab.
Аргументы в пользу более глубокой оценки стали очевидны во время их ранних тестов на старых арабских документах. Команда обнаружила, что Datalab может объединить понимание документов, OCR и большую часть предварительной обработки в более унифицированный рабочий процесс, сохраняя при этом структуру страницы более эффективно, чем их предыдущий процесс.
«Сочетание более сильных результатов на исторических арабских материалах и существенное сокращение ручных операций сделали Datalab очень многообещающим вариантом для нашего рабочего процесса». — Махди, KIQP
«Сочетание более сильных результатов на исторических арабских материалах и существенное сокращение ручных операций сделали Datalab очень многообещающим вариантом для нашего рабочего процесса». — Махди, KIQP
Конвейер, который тестировала команда, прост: PDF-файл или старое отсканированное изображение отправляется через API Datalab, Datalab обрабатывает документ и возвращает структурированный Markdown, а затем результат проходит проверку и валидацию человеком, прежде чем попасть в процессы индексации, поиска и последующей обработки знаний в KIQP. В этой настройке Datalab находится в центре этапа преобразования документов, заменяя несколько отдельных шагов предварительной обработки и OCR, которыми ранее управляли независимо.
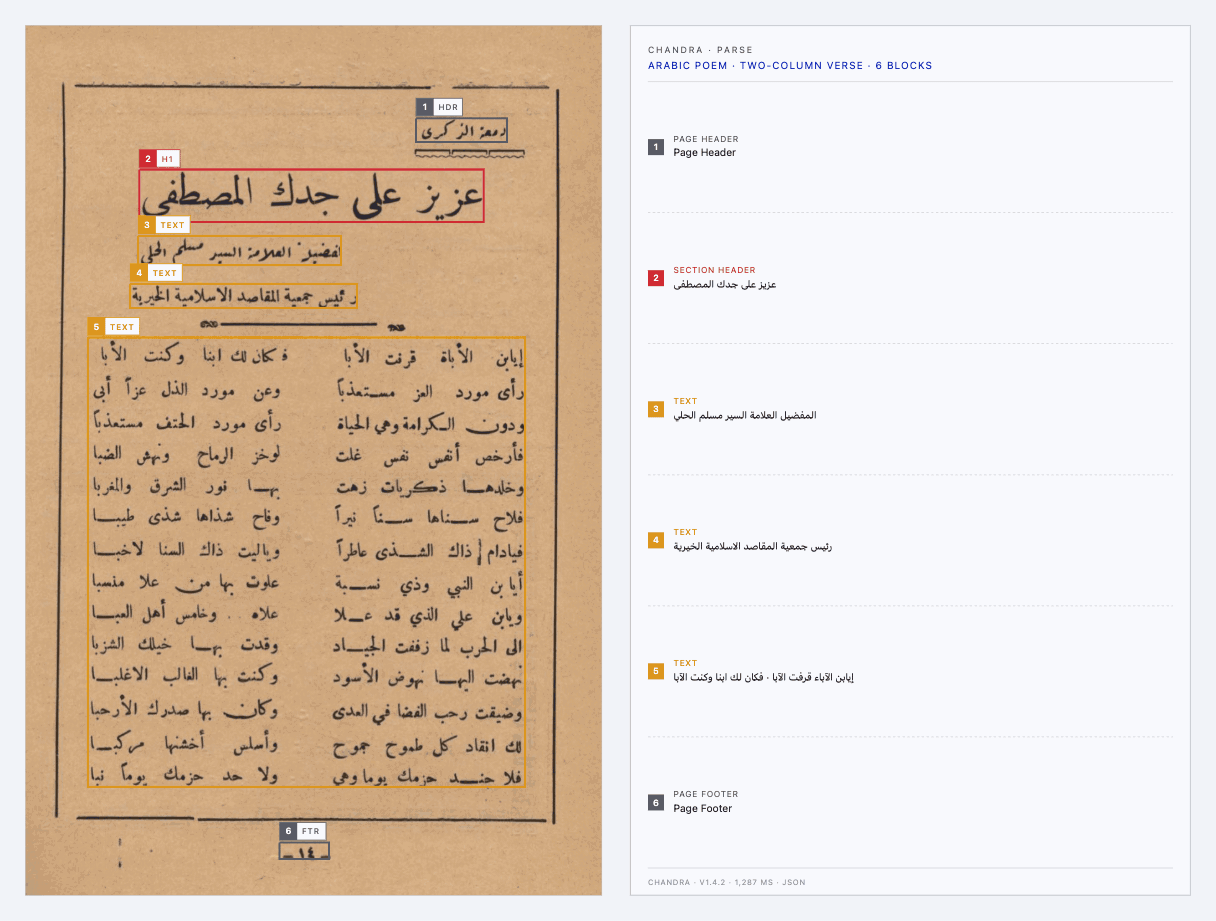
Распечатанное арабское стихотворение в две колонки, проанализированное Datalab, рядом с оригинальным сканом
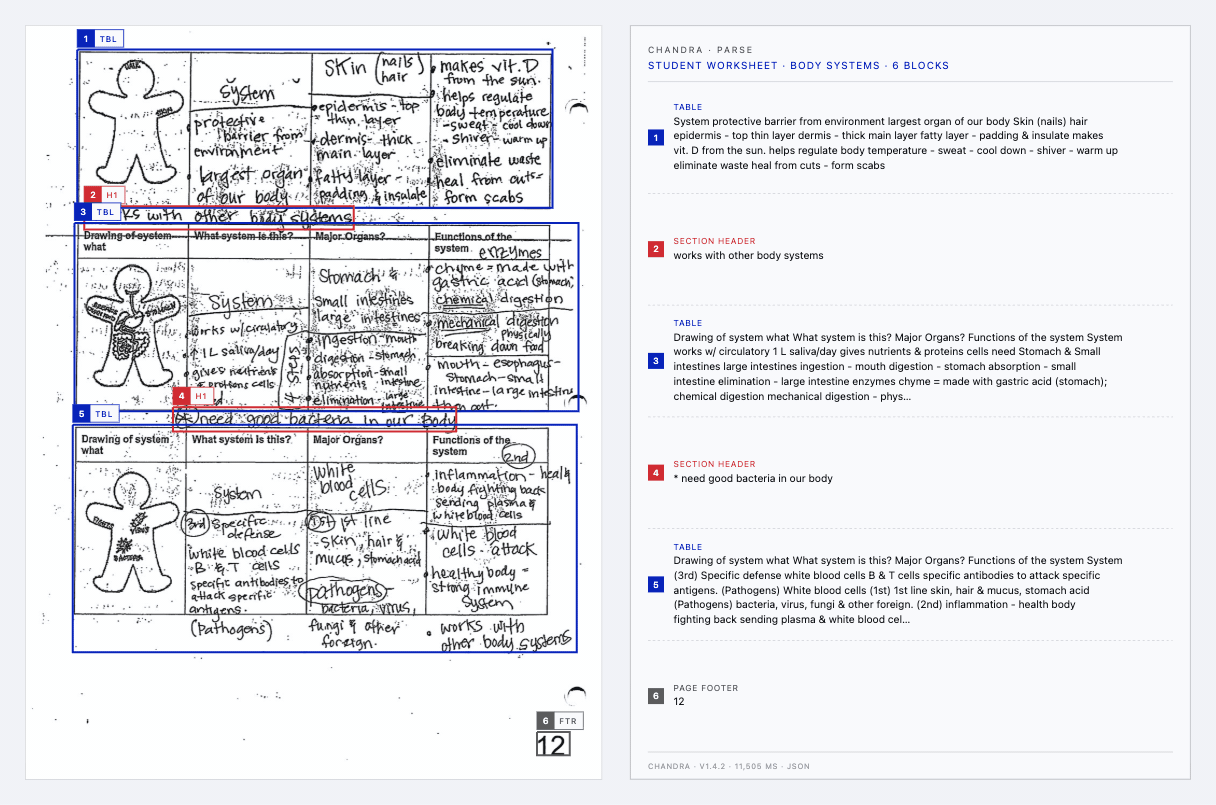
Некоторые из наиболее сложных материалов KIQP — это старые арабские газеты, журналы, книги и архивные страницы с ухудшенным качеством изображения, исторической типографикой, плотной версткой или рукописным контентом и маргинальными заметками. В ходе тестирования Datalab показал очень хорошие результаты на старых печатных арабских материалах и сократил объем необходимой ручной предварительной обработки. Рукописный арабский текст остается более сложным, чем печатный, поэтому проверка человеком остается частью рабочего процесса для сложных архивных материалов.
Рукописный лист арабской рукописи с маргинальными заметками, проанализированный Datalab
Результаты оценки
В ходе оценки Махди и техническая команда обработали около 30 000 страниц через Datalab. Согласно внутренним оценкам команды, общее время обработки документов в период тестирования сократилось примерно на 65% по сравнению с их предыдущим рабочим процессом. Они также отметили существенное сокращение ручного вмешательства и нагрузки по проверке в ходе тестирования.
«Без Datalab мы бы продолжали полагаться на фрагментированную комбинацию OCR-движков, инструментов предварительной обработки изображений, ручных исправлений и повторяющейся проверки человеком». — Махди, KIQP
«Без Datalab мы бы продолжали полагаться на фрагментированную комбинацию OCR-движков, инструментов предварительной обработки изображений, ручных исправлений и повторяющейся проверки человеком». — Махди, KIQP
Пересмотренный конвейер сократил ручную обработку, улучшил пропускную способность, снизил вероятность человеческих ошибок и упростил технологический стек. Эти результаты указывают на многообещающий путь для более широкой работы KIQP по оцифровке, поскольку платформа имеет оценочный объем накопленных материалов от 1 до 3 миллионов страниц книг, PDF-файлов, отсканированных материалов и архивов, которые потребуют обработки по мере роста их коллекций.