Lila Sciences и Anyscale обучили открытую модель GLM-5.3-Flash на 1 миллионе токенов на последовательность, используя 64 графических процессора B200. Это в 64 раза больше, чем мог выдержать стек обучения, когда мы начинали, и все изменения доступны с открытым исходным кодом в SkyRL. Наша команда SkyRL в Anyscale тесно сотрудничала с исследователями из Lila Science над их инфраструктурой на базе стека с открытым исходным кодом, чтобы изучить возможности увеличения длины контекста для этой конкретной модели.
Научные данные по своей природе длинные. Геном, семейство родственных белковых или РНК-последовательностей или запись эксперимента, проводимого в течение нескольких дней, теряют важную структуру, если их разбить на несколько тысяч токенов. ИИ, управляющий научными исследованиями в замкнутом цикле с автономной лабораторией, имеет ту же потребность: на протяжении циклов гипотез, протоколов и показаний приборов его контекст вырастает до сотен тысяч токенов.
Многие открытые модели сейчас поддерживают контекст в 1 млн токенов, но они могут не обладать «из коробки» необходимой производительностью для целевой задачи при больших значениях контекста. Устранение этого разрыва означает обучение на собственных данных задачи при их полной длине, без сокращения или сильного сжатия контекста. Эта работа была направлена на достижение цели с помощью открытой модели и открытого стека обучения.
Результат вкратце:
- 1 млн токенов на последовательность помещается в 144,5 ГБ на GPU, что меньше 178 ГБ у B200.
1 млн токенов на последовательность помещается в 144,5 ГБ на GPU, что меньше 178 ГБ у B200.
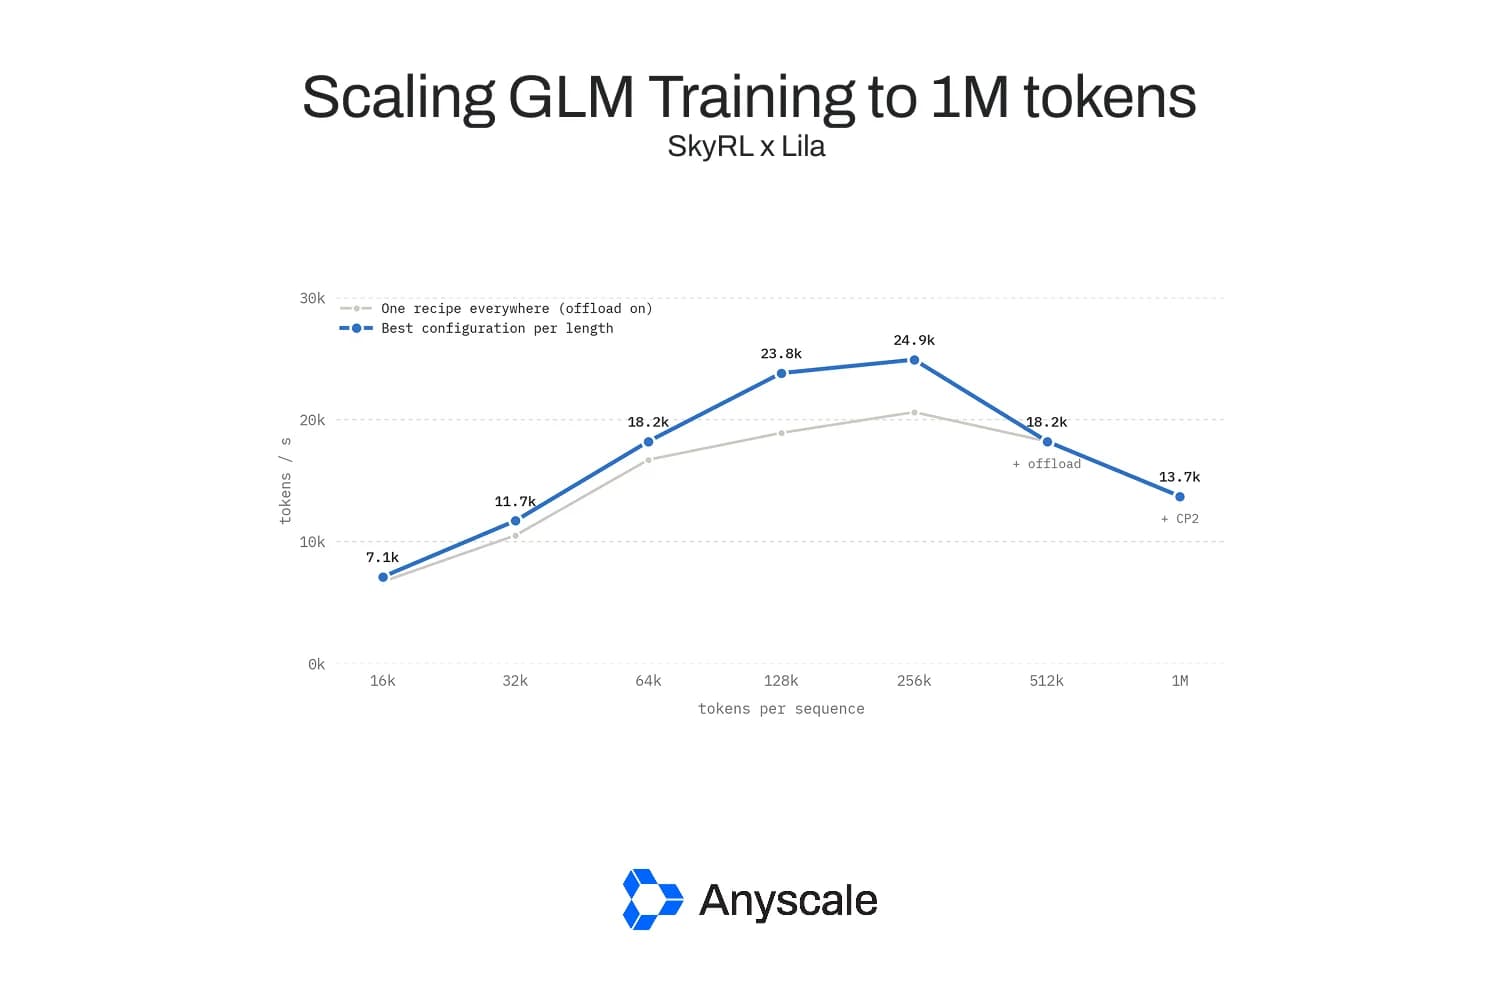
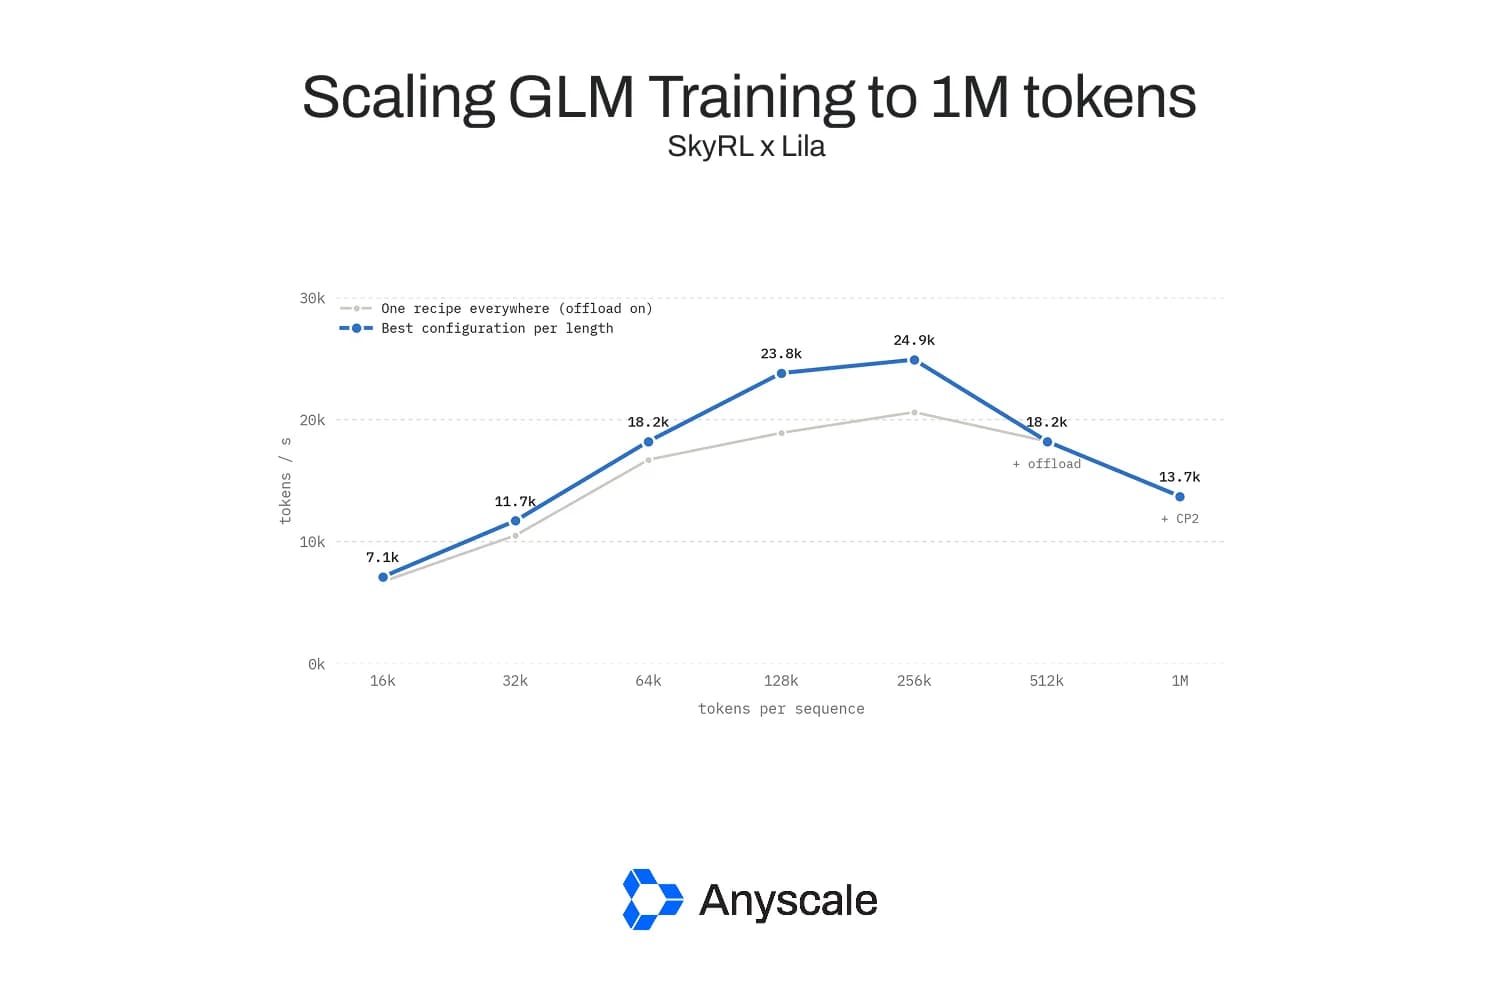
- 13,7 тыс. токенов/с при 1 млн и пик в 24,9 тыс. токенов/с при 256 тыс. на 64 GPU B200.
13,7 тыс. токенов/с при 1 млн и пик в 24,9 тыс. токенов/с при 256 тыс. на 64 GPU B200.
- Модель использует контекст: при дообучении на геноме человека функция потерь улучшается больше всего на токенах, перед которыми находятся сотни тысяч токенов контекста.
Модель использует контекст: при дообучении на геноме человека функция потерь улучшается больше всего на токенах, перед которыми находятся сотни тысяч токенов контекста.
- Открытый исходный код: рецепт находится в SkyRL, и несколько исправлений направляются в основной репозиторий Megatron-LM.
Открытый исходный код: рецепт находится в , и несколько исправлений направляются в основной репозиторий Megatron-LM.
Как мы достигаем контекста в 1 млн токенов в GLM 5.3 Flash?
GLM-5.3-Flash — это гибридная модель: 34 из 45 ее слоев используют линейное внимание (Kimi Delta Attention), а 11 — разреженное внимание DeepSeek (DSA). Она также использует остаточный поток, который в 4 раза шире обычного, и слои смеси экспертов (MoE). Каждый из этих компонентов требовал отдельной работы. Память растет вместе с длиной последовательности в каждом слое, а во внимании она растет пропорционально квадрату длины, поэтому каждая оптимизация лишь отодвигает предел до тех пор, пока не будет достигнут следующий. Мы выполнили несколько оптимизаций, каждая из которых подробно описана вместе с экспериментами и PR в оригинале .
Большинство проблем, с которыми мы столкнулись, не являются специфичными для GLM и могут быть применены к моделям, использующим аналогичные компоненты:
- Проверяйте, что каждый слой запускает именно то ядро, которое вы ожидаете: слои разреженного внимания GLM молча переключались на плотное внимание, потому что скомпилированные ядра принимали только точные формы тензоров DeepSeek. Ошибок не возникало; запуск просто потреблял 114 ГБ на GPU при 16 тыс. и заканчивался нехваткой памяти при 32 тыс. Дополнение тензоров для соответствия разреженному ядру сократило потребление памяти вдвое.
Проверяйте, что каждый слой запускает именно то ядро, которое вы ожидаете: слои разреженного внимания GLM молча переключались на плотное внимание, потому что скомпилированные ядра принимали только точные формы тензоров DeepSeek. Ошибок не возникало; запуск просто потреблял 114 ГБ на GPU при 16 тыс. и заканчивался нехваткой памяти при 32 тыс. Дополнение тензоров для соответствия разреженному ядру сократило потребление памяти вдвое.
- Разреженное внимание перемещает квадратичные затраты, но не устраняет их. DSA учитывает только 2048 токенов на запрос, но выбор этих токенов означает оценку каждого запроса относительно всей последовательности. Вычисление этой матрицы оценок по несколько сотен запросов за раз удерживает потребление памяти ниже 2 ГБ, а разделение вычислений между GPU вместо повторения на каждом из них сделало полный шаг обучения в 2,1 раза быстрее при 256 тыс.
Разреженное внимание перемещает квадратичные затраты, но не устраняет их. DSA учитывает только 2048 токенов на запрос, но выбор этих токенов означает оценку каждого запроса относительно всей последовательности. Вычисление этой матрицы оценок по несколько сотен запросов за раз удерживает потребление памяти ниже 2 ГБ, а разделение вычислений между GPU вместо повторения на каждом из них сделало полный шаг обучения в 2,1 раза быстрее при 256 тыс.
- Каждое исправление памяти стоит пропускной способности, поэтому используйте только то, что необходимо для данной длины. Полное перевычисление, выгрузка на CPU и контекстный параллелизм дают больше контекста ценой скорости. Выгрузка, например, снижает пиковое потребление памяти при 256 тыс. со 142 до 98 ГБ, но добавляет 21% к времени шага. Мы включаем каждый метод только на той длине, где обучение не помещается без него.
Каждое исправление памяти стоит пропускной способности, поэтому используйте только то, что необходимо для данной длины. Полное перевычисление, выгрузка на CPU и контекстный параллелизм дают больше контекста ценой скорости. Выгрузка, например, снижает пиковое потребление памяти при 256 тыс. со 142 до 98 ГБ, но добавляет 21% к времени шага. Мы включаем каждый метод только на той длине, где обучение не помещается без него.
- Бенчмарки на случайных токенах недооценивают память для моделей MoE. Реальное распределение текста распределяется неравномерно между экспертами: на реальном наборе данных с длинным контекстом самый загруженный GPU получал примерно в 4 раза больше среднего количества токенов, и на 512 тыс. заканчивалась память там, где запуски на случайных токенах проходили легко. Обработка слоя MoE по последовательности частями решила проблему. Тестируйте память на реальных данных перед определением размера кластера.
Бенчмарки на случайных токенах недооценивают память для моделей MoE. Реальное распределение текста распределяется неравномерно между экспертами: на реальном наборе данных с длинным контекстом самый загруженный GPU получал примерно в 4 раза больше среднего количества токенов, и на 512 тыс. заканчивалась память там, где запуски на случайных токенах проходили легко. Обработка слоя MoE по последовательности частями решила проблему. Тестируйте память на реальных данных перед определением размера кластера.
- Планируйте хост-память, а не только память GPU. При 1 млн токенов входные данные слоев, выгруженные на CPU, составляют около 180 ГБ на GPU до контекстного параллелизма, более 1 ТБ на узел из 8 GPU, и они делят оперативную память хоста с состоянием оптимизатора. Используйте закрепленную (pinned) память для копий (они были на 22% быстрее, чем выгружаемая память) и освобождайте ее на каждом шаге.
Планируйте хост-память, а не только память GPU. При 1 млн токенов входные данные слоев, выгруженные на CPU, составляют около 180 ГБ на GPU до контекстного параллелизма, более 1 ТБ на узел из 8 GPU, и они делят оперативную память хоста с состоянием оптимизатора. Используйте закрепленную (pinned) память для копий (они были на 22% быстрее, чем выгружаемая память) и освобождайте ее на каждом шаге.
- Проверяйте корректность отдельно от скорости. Показатели скорости и памяти могут быть получены на случайных весах, но корректность — нет. В запусках RL с реальными весами логарифмические вероятности тренера совпадали с vLLM с точностью до 0,04–0,07 (средняя абсолютная разница) от 128 тыс. до 1 млн токенов, а тест на переобучение снизил потери с 1,65 до 0,17 за 20 шагов.
Проверяйте правильность отдельно от скорости. Показатели скорости и памяти можно получить на случайных весах, а правильность — нет. В запусках RL с реальными весами логарифмические вероятности трейнера совпадали с vLLM с точностью до 0,04 — 0,07 (средняя абсолютная разница) в диапазоне от 128 тыс. до 1 млн токенов, а тест на переобучение снизил потери с 1,65 до 0,17 за 20 шагов.
Благодаря сочетанию этих идей нам удалось поддерживать хорошую пропускную способность для различных длин контекста
LinkTraining Results
Мы провели пост-тренировку на геноме человека с длиной последовательности 512 тыс. токенов, потери модели на отложенной выборке снизились на 4,8% за 80 шагов, причем наибольший прирост наблюдался на токенах с наибольшим предшествующим контекстом. Последнее является доказательством того, что модель научилась использовать длинный контекст, а не только локальные паттерны.
Мы провели обучение на хромосомах 1 и 2 эталонного генома человека (hg38) и выполнили оценку на хромосоме 22, которую модель никогда не видела. ДНК — отличный тест, поскольку она имеет структуру на любом масштабе: от коротких мотивов до паттернов, охватывающих очень большие участки.
Чтобы отделить обучение на больших расстояниях от локального обучения, мы разделили потери на отложенной выборке по позициям токенов (на бакеты по 32 тыс. токенов) и сравнили их до и после дообучения:
- Ранние токены имеют небольшой предшествующий контекст, поэтому любое улучшение там обусловлено локальными паттернами, такими как короткие мотивы и нуклеотидный состав.
Ранние токены имеют небольшой предшествующий контекст, поэтому любое улучшение там обусловлено локальными паттернами, такими как короткие мотивы и нуклеотидный состав.
- Поздние токены имеют до 500 тыс. токенов предшествующего контекста.
Поздние токены имеют до 500 тыс. токенов предшествующего контекста.
- Локальное обучение помогает каждой позиции в равной степени, поэтому более значительное улучшение на поздних позициях должно быть следствием длинного контекста, доступного только им.
Локальное обучение помогает каждой позиции в равной степени, поэтому более значительное улучшение на поздних позициях должно быть следствием длинного контекста, доступного только им.
LinkRunning on Anyscale
Каждый эксперимент в этой статье выполнялся на Ray под управлением платформы Anyscale в кластере из 64 графических процессоров B200 в облаке Lila. SkyRL использует Ray для размещения и координации воркеров обучения и инференса, поэтому в рамках одной и той же настройки проводились тесты памяти на случайных токенах, дообучение на реальных данных и запуски RL для проверки трейнера в сравнении с vLLM.
Более подробную информацию о конкретных методах, используемых для поддержки длинного контекста, см. в этом подробном посте в блоге.