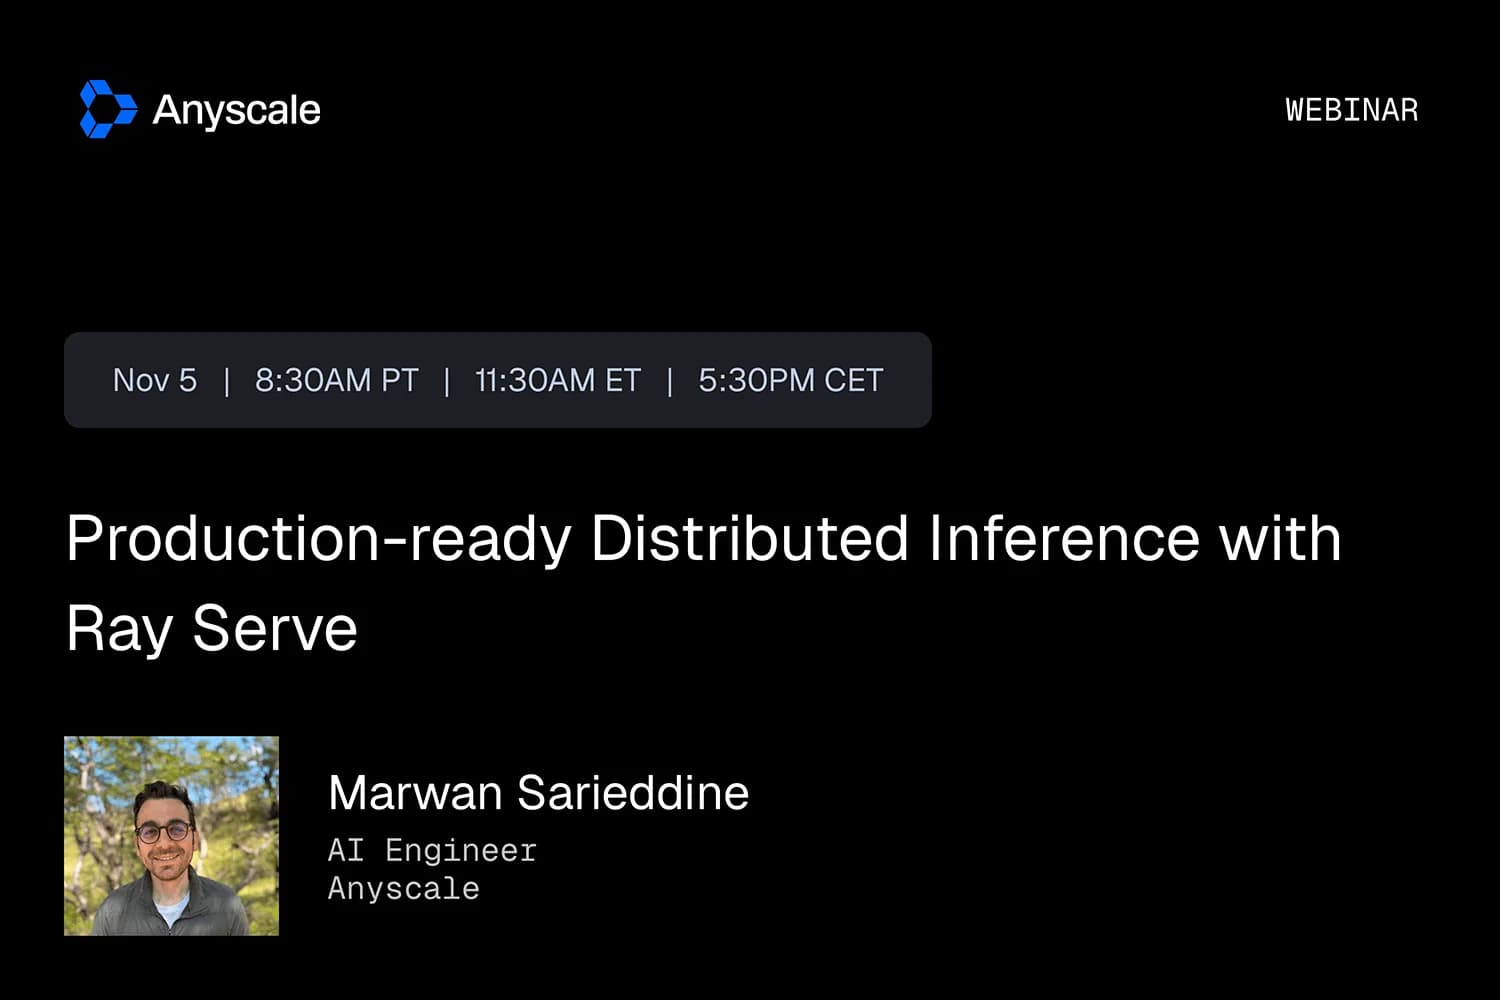
Проектируйте масштабируемые распределенные системы инференса для промышленных ИИ-приложений, от классических моделей машинного обучения до больших языковых моделей. Узнайте, как Ray Serve обеспечивает высокую пропускную способность и низкую задержку, а также как оценивать компромиссы производительности при автомасштабировании, пакетной обработке, маршрутизации и оптимизации движка инференса.
Темы включают:
- Создание приложений Ray Serve с использованием развертываний, композиции и маршрутизации запросов с учетом нагрузки
Создание приложений Ray Serve с использованием развертываний, композиции и маршрутизации запросов с учетом нагрузки
- Развертывание и масштабирование LLM-эндпоинтов с помощью Ray Serve LLM на таких движках, как vLLM и SGLang
Развертывание и масштабирование LLM-эндпоинтов с помощью Ray Serve LLM на таких движках, как vLLM и SGLang
- Оптимизация движка инференса с помощью KV-кэша, paged attention, кэширования префиксов и непрерывной пакетной обработки
Оптимизация движка инференса с помощью KV-кэша, paged attention, кэширования префиксов и непрерывной пакетной обработки
- Масштабирование передовых моделей с помощью маршрутизации с учетом KV-кэша, дезагрегации префилла/декодирования и широкого параллелизма экспертов для моделей Mixture-of-Experts (MoE)
Масштабирование передовых моделей с помощью маршрутизации с учетом KV-кэша, дезагрегации префилла/декодирования и широкого параллелизма экспертов для моделей Mixture-of-Experts (MoE)
- Развертывание пользовательских LLM на Anyscale и их интеграция с агентскими платформами (Claude Code, Cursor, Codex)
Развертывание пользовательских LLM на Anyscale и их интеграция с агентскими платформами (Claude Code, Cursor, Codex)
- Сравнение затрат между собственными GPU, подписками и тарификацией на основе токенов API.
Сравнение затрат между собственными GPU, подписками и тарификацией на основе токенов API.