
За последние 2 года мы проанализировали невероятное разнообразие документов с помощью наших ведущих моделей Surya, Marker, а теперь и Chandra. Общаясь с клиентами за это время, мы пришли к нескольким выводам:
- Разнообразие документов бесконечно (попробуйте проанализировать отсканированный документ, на котором просвечивают чернила с обратной стороны).
- Парсинг — это только начало обычно сложного процесса преобразования или рабочего процесса с документами.
- Предпочтения клиентов добавляют дополнительный уровень комбинаторной сложности к правильному парсингу.
Что значит правильно проанализировать документ? Иногда это просто: точно ли вы представили информацию относительно того, как она была на странице? В других случаях у пользователя есть свое мнение: «ну… да… но не могли бы вы сделать это вот так?»
Действительно, существуют объективные и субъективные представления о правильности, когда вы основываете преобразование на точке зрения клиента. Размышляя над этой проблемой в течение последнего года, мы поняли, что нам нужно общее решение для того, что кажется бесконечно сложной задачей.
Document Agent, который сейчас находится в закрытой бета-версии, — это наш ответ.
Диапазон преобразования
Парсинг — это только начало. Когда вы конвертируете PDF, DOCX, электронную таблицу и т. д., вам нужно что-то с этим сделать или что-то извлечь. Эти варианты использования могут варьироваться от:
- Предоставления схемы с ключевыми полями для извлечения информации — классический случай структурированного извлечения.
- Исправления PDF-файла для соответствия стандартам доступности (соответствие WCAG).
- Преобразования PDF в формат JATS-XML, если вы научный издатель.
- Выполнения преобразования с получением правок (redlines) из документа.
- Выполнения преобразования с форматированием списков очень специфическим образом.
- Выполнения преобразования, когда это сложный документ клинического исследования с очень плотными таблицами, где люди могут визуально определить, где находятся столбцы, но никто не нарисовал линии, и это довольно неоднозначно.
И многое другое.
В прошлом это могло потребовать создания высокоспециализированных рабочих процессов и инженерных усилий со стороны клиента, но когда у нас есть:
- агентные возможности и передовой интеллект в качестве ресурса;
- современные модели преобразования и извлечения, а также внутренние конвейеры в Datalab,
мы задались вопросом, сможем ли мы создать агентную систему, которая использует наши основные примитивы преобразования для оптимизации того, как мы решаем эти проблемы для клиентов.
Внутреннее использование нашего агента
Недавно мы писали о нашем новом процессоре для приведения PDF-файлов в соответствие со стандартом WCAG, а также о другом процессоре для преобразования PDF-файлов в JATS-XML для научных издателей.
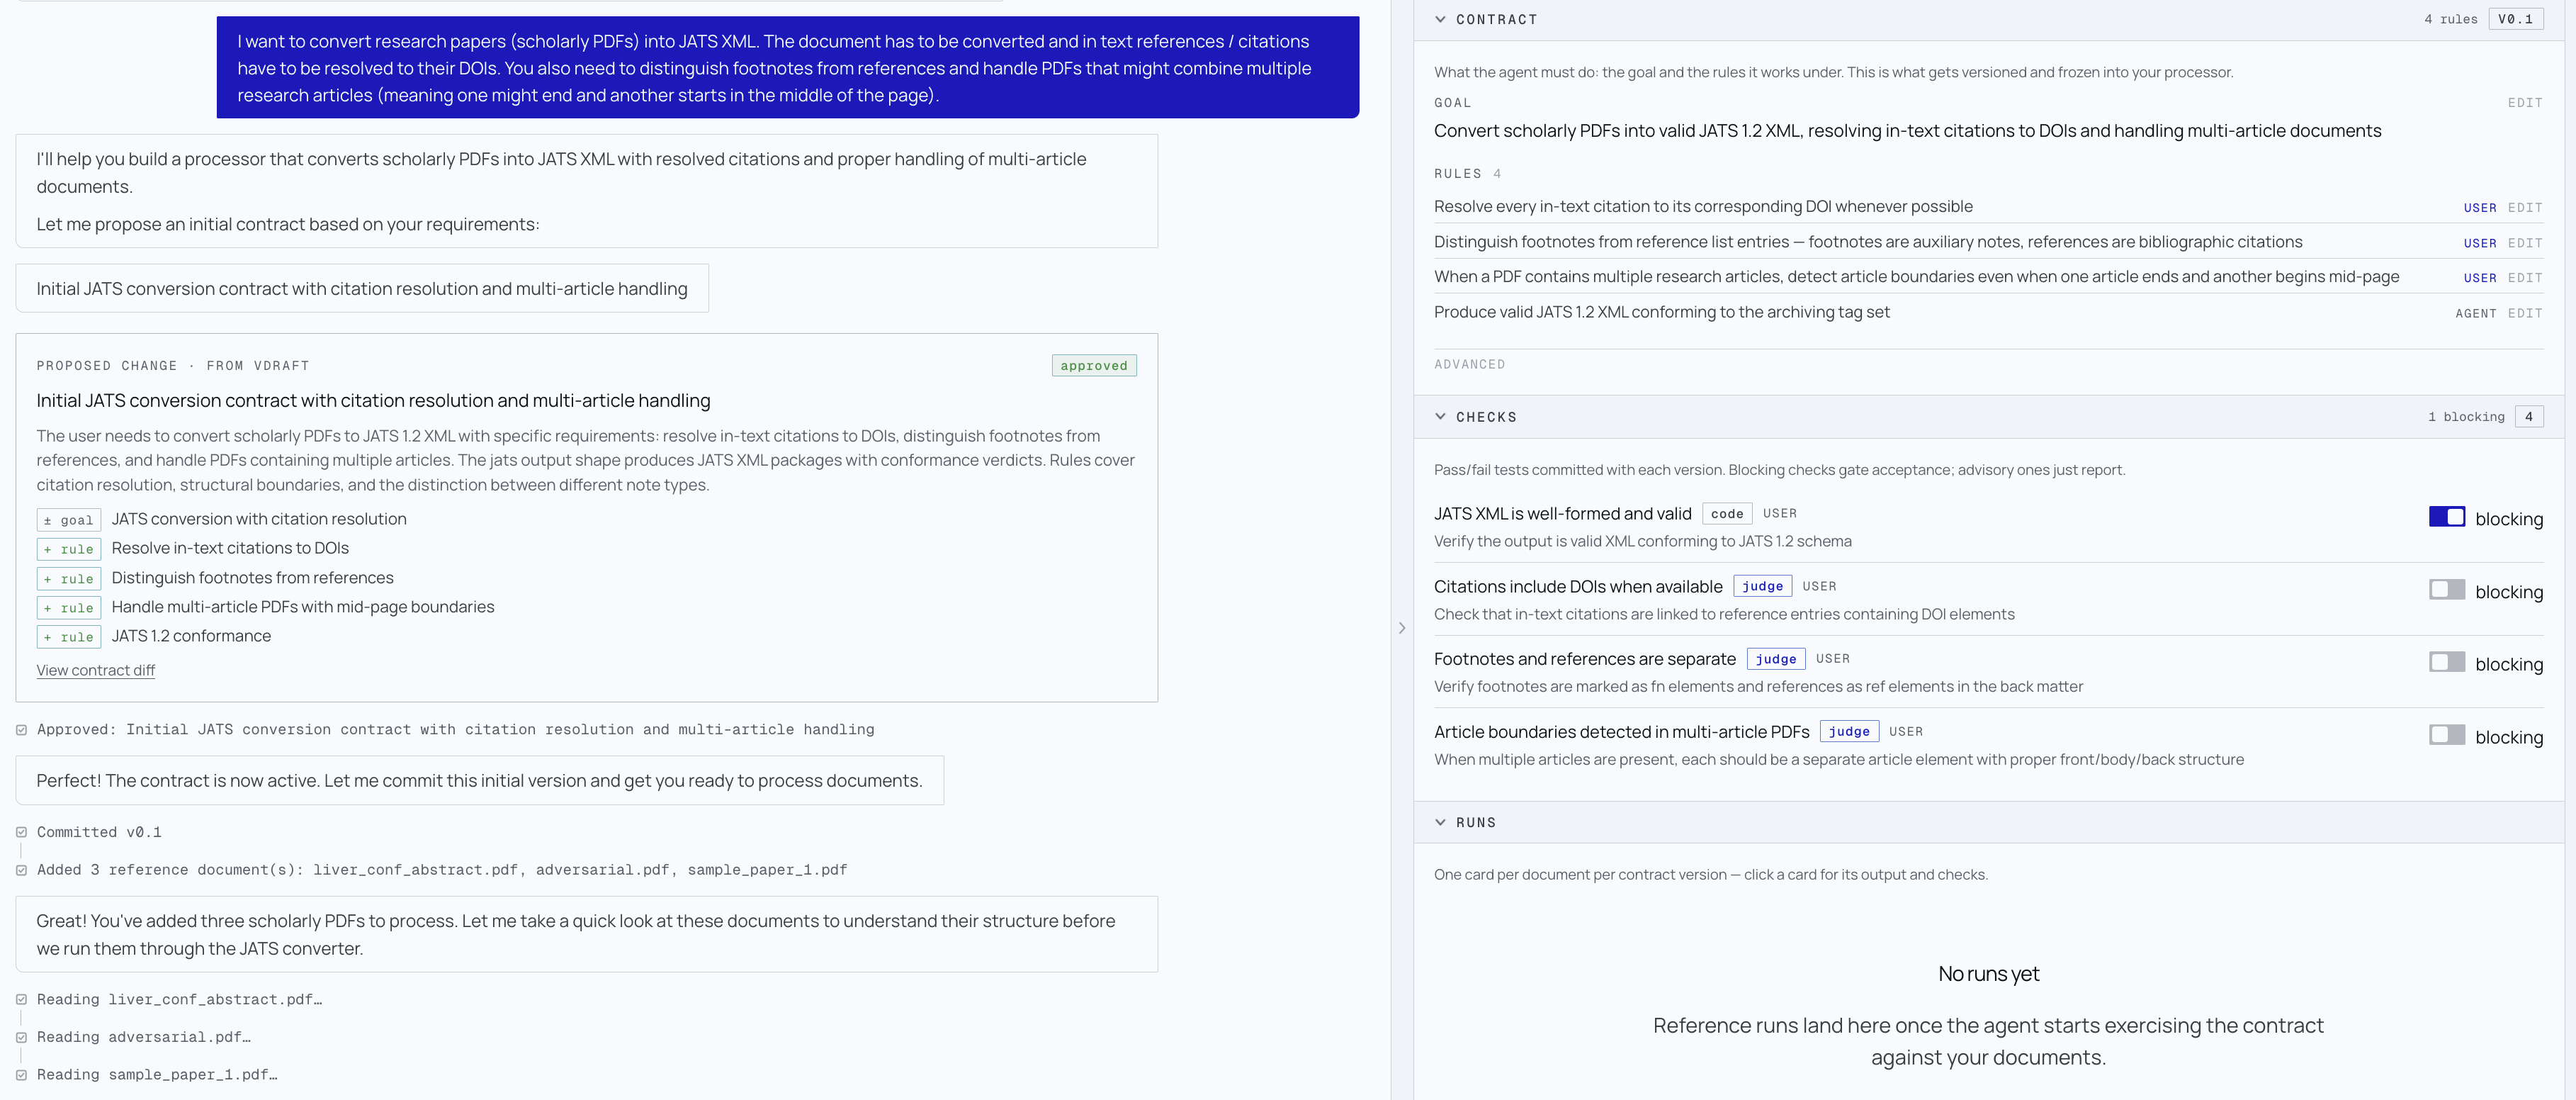
Внутри компании мы использовали нашего собственного агента по работе с документами и начали новую сессию проектирования, итерируя его работу путем уточнения наших намерений, предоставления образцов документов и создания критериев проверки того, как выглядит правильное преобразование.
Сессия проектирования при создании нашего JATS-процессора: намерения слева; версионируемый контракт — цели, правила и проверки — справа.
Наш агент использовал внутренние модели и другие конвейеры, обученные нашей исследовательской группой, в качестве инструментов, которые он мог применять, и прорабатывал проблему, разрабатывая различные стратегии и проверяя результаты по конкретному набору верификаторов, разработанных вместе с нами, до тех пор, пока не находил надежное решение.
Это очень похоже на то, как к проблеме подошел бы мотивированный человек: он знает, что хочет получить, и вооружен примерами и определениями успеха, но ему приходится координировать работу внутри команды, которая связывает различные сервисы, поддерживает инфраструктуру и т. д.
Наш агент кардинально сокращает этот цикл, давая каждому возможность получить то, что ему нужно от своих документов.
По мере работы и улучшения качества наших бенчмарков эти внутренние исследования агента были сохранены и превращены в шаблоны для наших стандартных процессоров JATS и WCAG, готовых к использованию напрямую с помощью простого вызова API!
Закрытая бета-версия
Мы очень воодушевлены потенциалом этого подхода — работа над некоторыми из этих проблем может казаться пугающей и обременительной, но, по нашему опыту, она становится волшебной.
Мы будем регулярно выпускать шаблоны, но доступ к полноценному пользовательскому агенту все еще находится в закрытой бета-версии. Если вы имеете дело со сложными рабочими процессами с документами, свяжитесь с нами по адресу [email protected], чтобы получить доступ — нам не терпится увидеть, что вы с ним создадите!