В прошлом месяце мы выпустили Document Agent — универсального агента, способного выполнять многоэтапные задачи, связанные с документами. В основе системы LLM работает в нашей среде пошагово: анализирует страницы, пишет скрипты и запускает проверки, пока результат не будет принят.
В качестве эксперимента мы дообучили небольшую открытую модель для управления агентом. Мы попробовали два подхода: обучение на результатах работы более мощной модели и обучение с подкреплением (RL). Оба метода помогли, но только RL позволило стабильно предотвращать застревание модели в бесконечных повторах одних и тех же вызовов инструментов.
Настройка
Для этого эксперимента мы использовали одну из наших агентских задач: преобразование научных PDF-файлов в формат JATS XML.
«Из коробки» небольшая модель не очень хорошо справляется с этой задачей, в основном из-за недостаточной компетенции в работе с предоставленными инструментами. Она застревает, перезапускает одни и те же инструменты и, что самое неприятное, попадает в цикл, вызывая один и тот же инструмент снова и снова. Зацикливание — довольно распространенная проблема в LLM; см. статью Liquid AI о «петлях гибели».
Существует два основных способа улучшить модель, управляющую агентом:
- Обучение на примере более мощной модели (обучение с учителем, SFT). Мы записываем работу более мощной модели и дообучаем маленькую модель копировать её действия шаг за шагом.
- Обучение на собственных ошибках (обучение с подкреплением, RL). Маленькая модель выполняет задачу много раз, каждая попытка оценивается, и модель поощряется за действия, которые привели к хорошим результатам.
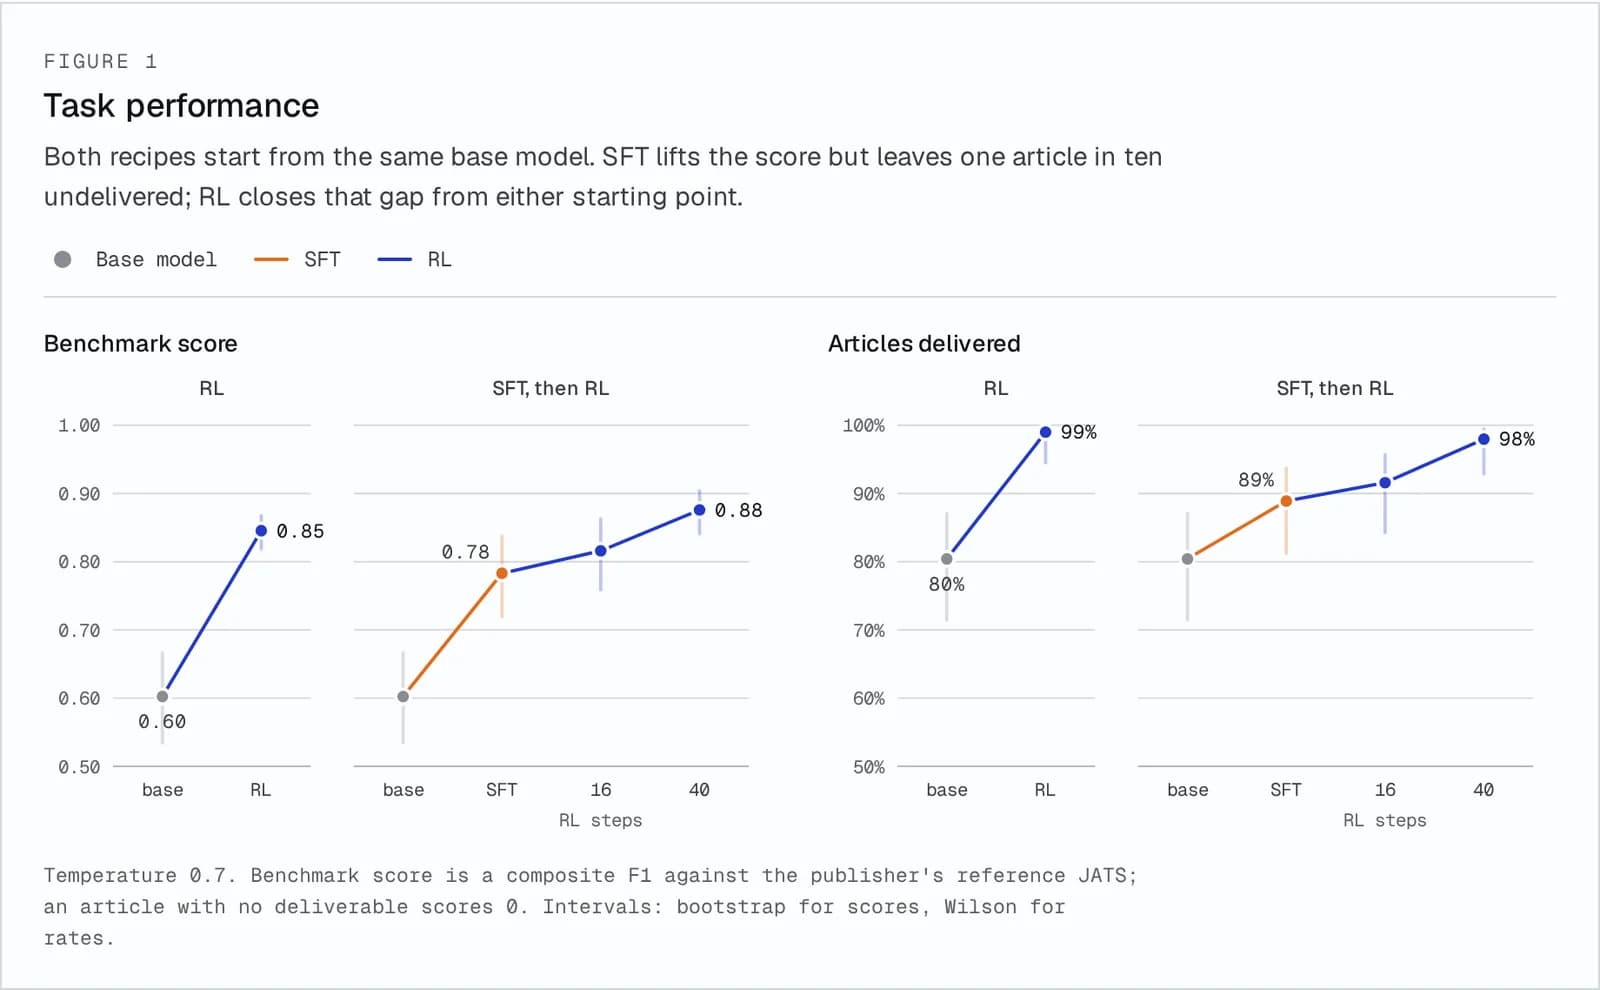
Мы протестировали SFT, RL на базе исходной модели и SFT с последующим RL, а затем провели оценку на 100 статьях с общедоступными эталонными XML-файлами, которые ни одна из моделей не видела во время обучения.
Результаты тестирования
Мы видим, что и RL, и SFT позволяют улучшить показатели, причем использование RL после SFT ведет к дальнейшему прогрессу.
Частично рост баллов связан с лучшим пониманием инструментов и требований профиля агента JATS. Однако при анализе логов стала ясна еще одна причина: как базовая модель, так и SFT-модель застревают в циклах вызова инструментов, что мешает им завершить задачу.
Борьба с зацикливанием
Типичный цикл SFT: модель исправляет скрипт, получает ошибку и отправляет ту же самую команду снова, до 41 раза подряд. Часто ее собственные рассуждения указывают на проблему («Мне стоит попробовать использовать sed») прямо перед тем, как она повторяет вызов. RL избавляет от этого почти полностью, независимо от того, с какой модели начинается обучение.
Жадная декодировка
Вывод при температуре 0 — распространенный способ сделать поведение агента более предсказуемым, поэтому мы повторно запустили тест в этом режиме. Для моделей без RL результаты оказались значительно хуже.
Жадная декодировка ухудшает показатели всех моделей, кроме тех, что обучались только через RL. SFT завершает лишь 9% статей, повторяя один и тот же некорректный вызов инструмента на каждом шаге. Частично такое поведение проявляется и при температуре 0.7, но выборка (sampling) обычно позволяет выйти из цикла после одной неудачной попытки. SFT с последующим RL показывает лучшие результаты, но все равно склонна сваливаться в циклы идентичных вызовов.
Первопричины
SFT-модель не научилась зацикливаться у своего «учителя»: ни в одном из логов учителя вызов не повторяется более трех раз подряд.
Наша главная гипотеза заключается в том, что основной причиной является внеполитическая (off-policy) природа SFT: модель учится только на траекториях учителя, а не на своих собственных. Учитель редко ломает свои скрипты, поэтому, когда это делает ученик, он оказывается в состоянии, которого не было в обучающих данных. Не имея примера «ошибка при редактировании, затем другой подход», модель с наибольшей вероятностью продолжает то, что уже есть в контексте: предыдущую команду. Это классический пример накопления ошибок или предвзятости воздействия (exposure bias) при обучении с подражанием.
RL исправляет это, так как является внутриполитическим (on-policy) методом: модель обучается на своих собственных прогонах, поэтому может адаптироваться к своим ошибкам. Прогон, который зацикливается до достижения лимита шагов, не дает результата и получает 0 баллов, в то время как прогон, который сталкивается с той же ошибкой и пробует что-то другое, все еще может получить положительное преимущество. Именно на этом контрасте строится обучение. За 40 шагов прогоны с 4 или более идентичными вызовами получают отрицательное преимущество в 88% случаев и их доля падает с 12% до 4%.
Чтобы изолировать внутриполитическую составляющую, мы также попробовали on-policy дистилляцию (OPD). Как и SFT, она учится у учителя, но тренируется на собственных прогонах ученика: ученик генерирует траекторию, а учитель оценивает каждый созданный токен.
OPD достигает результатов RL при температуре 0.7 и зацикливается реже, чем SFT. При температуре 0 она сохраняет работоспособность там, где SFT терпит крах. Она все еще иногда зацикливается при температуре 0, поэтому OPD не так эффективна, как RL, в полном устранении циклов. Тем не менее, доказательства ясно указывают на один вывод: ученик, который учится на своих собственных траекториях, работает лучше и зацикливается реже.
Что дальше
Это был небольшой эксперимент, но он сформировал наш взгляд на обучение моделей для наших агентов и важность использования внутриполитических данных. Мы рады продолжать обучение моделей для других задач с документами и будем делиться тем, что узнаем.
Если вы обучаете агентов и столкнулись с похожими (или другими!) проблемами, мы будем рады обменяться опытом.