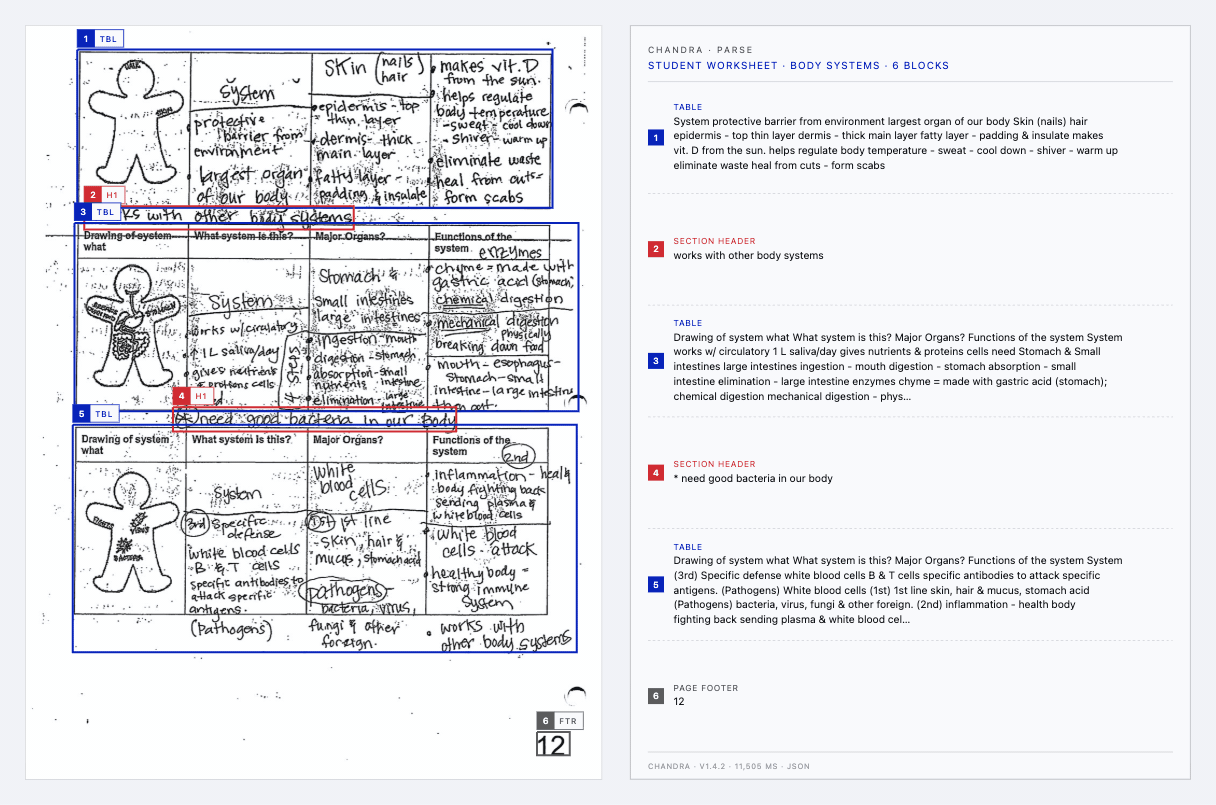
В Datalab мы посвятили себя сложной, неприглядной задаче: заставить ИИ правильно читать документы, без галлюцинаций и ошибок. Извлечение информации из таблиц на тысячу страниц и из запутанных форм — одна из самых сложных задач в обработке документов. Модель, которая галлюцинирует одну неправильную цифру в контракте или в отчёте, может оказать реальное влияние на бизнес.
Наш взгляд таков: бенчмарк извлечения должен выполнять две функции:
- Помогать клиентам выбирать подходящего поставщика; и
- Давать инженерам возможность диагностировать, что именно идёт не так в данной модели.
Мы следим за всеми недавними запусками бенчмарков, и такие бенчмарки, как ExtractBench и LongExtractBench, являются полезной отправной точкой, но у них есть общие недостатки:
- Документы и система оценки могут быть смещены в пользу конкретного поставщика, создавшего бенчмарк;
- Предсказательный harness сложно аудитировать, поэтому нельзя определить, означает ли низкий балл провал модели или провал harness;
- Оценка запутана или трудно интерпретируема, поэтому вопрос «почему этот документ получил низкий балл?» не имеет реального ответа; и
- Документы охватывают лишь небольшую часть вселенной возможных случаев извлечения. Некоторые бенчмарки (например, LongExtractBench) содержат только плотные таблицы. Другие включают только чистые документы без сканов. Это не отражает реальный мир и реальные вызовы.
Мы хотели иметь честный способ оценить варианты извлечения. Поэтому мы решили взять четыре существующих бенчмарка от разных поставщиков (LlamaIndex, Extend, micro1 и Datalab), очистить их, стандартизировать оценку и сделать их максимально честными.
Наш бенчмарк OmniExtractBench включает:
- 620 документов из четырёх существующих бенчмарков нескольких поставщиков. Это устраняет смещение;
- Оценщик, полностью детерминированный и объясняющий каждое решение через Вердикт — атомарную, аудитируемую единицу, которая точно указывает, было ли значение совпадено, неправильно прочитано, пропущено, выдумано или сфабриковано, вместо того чтобы сводить всё к одной непрозрачной оценке. Это делает его аудитируемым;
- Чистые, последовательные и честные правила для сложных внутренних деталей, например, как оценивать null‑значения против пустых. Это делает оценку прозрачной и проще для понимания; и
- Документы, которые обычно ломают извлечение: огромные таблицы с повторяющимися значениями, плотные скалярные схемы, научные статьи, кредитные соглашения, резюме и отчёты. Это охватывает широкий спектр реальных сложных сценариев использования в нескольких вертикалях.
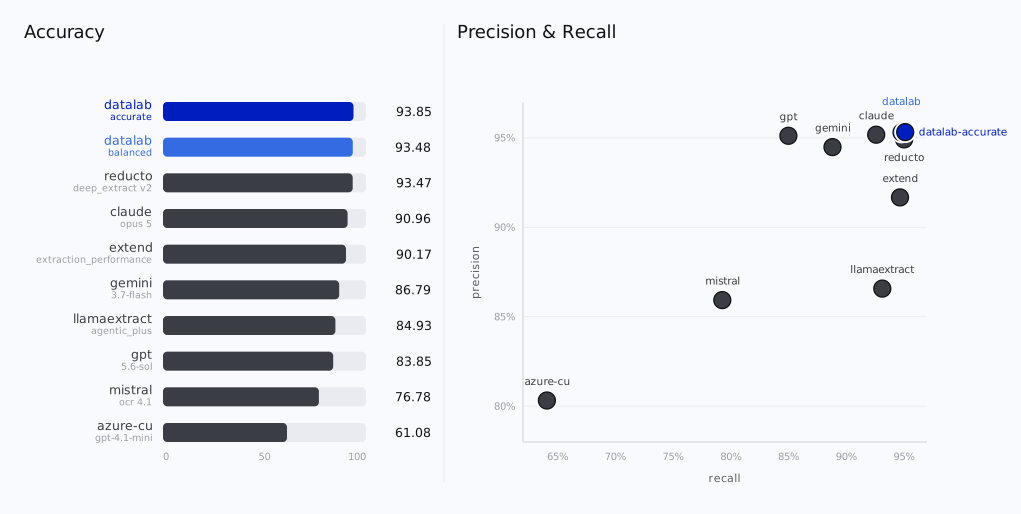
Вот как несколько основных вариантов извлечения на самом деле показали себя, оцениваясь одинаково, на одном корпусе документов:
Каждое среднее значение рассчитывается по количеству документов, которые поставщик действительно смог обработать — колонка покрытия. Небольшое покрытие является ограничением поставщика: документ либо исчерпал лимит вывода, либо его схема была отвергнута как слишком большая.
Мы будем продолжать улучшать инструментарий, аудитируемость и честность этого бенчмарка. Мы будем рады услышать ваши мысли (особенно если вы не согласны). Код оценки находится на GitHub, а данные — на Hugging Face.
Данные
620 документов из 4 источников:
Вот разбивка документов:
Оценщик
Проблемы оценки
Проблема с оценкой извлечения заключается в неоднозначных адресах значений. Адрес — это путь к скалярному значению, который вы проходите по словарю, чтобы добраться до этого значения. Например, единственный адрес следующего словаря {"a": {"b": "c"}} — это ("a", "b").
Во многих задачах извлечения нам нужно извлечь переменное количество JSON‑объектов. Пользователь указывает это с помощью типа «array» в JSON‑схеме. Это часто используется для больших таблиц — мы хотим извлечь множество строк из таблицы, которые должны соответствовать определённой схеме.
Проблема здесь в том, что одна небольшая ошибка может стоить почти всей таблицы в баллах при наивной оценке. Например, в таблице из 100 строк, если модель пропустит первую строку, каждая предсказанная строка будет смещена на одну позицию, что приведёт к ужасному баллу, хотя модель фактически правильно обработала 99 из 100.
Наш оценщик
Наш оценщик детерминирован и имеет простую конструкцию. Он состоит из трёх компонентов:
- Нормализация документа;
- Нормализация скалярных значений; и
- Сопоставление листовых адресов: если адрес unambiguous, сопоставляем точно; и если ambiguous, применяем венгерское сопоставление на основе содержимого (рекурсивно для вложенных массивов объектов).
- Если unambiguous, сопоставляем точно; и
- Если ambiguous, применяем венгерское сопоставление на основе содержимого (рекурсивно для вложенных массивов объектов).
Он работает в следующих этапах:
- Нормализовать документ;
- Преобразовать предсказанный и золотой JSON‑словарь в адреса, сопоставленные со скалярными значениями;
- Нормализовать скалярные значения преобразованных адресов; и
- Для каждого массива, который появляется, выполнить венгерское сопоставление (рекурсивно для вложенных массивов) на основе содержимого элементов массива, чтобы выровнять неоднозначные предсказанные и золотые адреса. Может остаться несопоставленных предсказанных адресов — ложные положительные — и несопоставленных золотых адресов — ложные отрицательные.
Для каждого документа этот процесс создаёт один Вердикт на каждый уникальный скалярный адрес, выровненный с помощью венгерского сопоставления при необходимости. Варианты:
- matched: был сопоставлен и значения совпадают;
- misread: был сопоставлен, но значения не совпадают;
- unfound: в ground truth есть адрес, а в предсказании его нет;
- fabricated: схема предлагает адрес, а в ground truth его нет, но предсказание существует;
- invented_item: скалярное предсказание элемента массива, которое не сопоставилось ни с чем; или
- invented_field: адрес, который схема никогда не объявляла.
Эти варианты взаимно исключаются в нашем коде и также семантически. Один интересный суждение, который мы приняли здесь: адрес относится к invented_item, если он находится внутри непарного элемента (например, строки), даже если этот адрес был изобретённым полем внутри схемы этого элемента массива. Мы считаем, что это правильный выбор: это указывает, что модель была наказана за изобретение элемента. Адреса вне массивов, которые схема никогда не объявляла, относятся к invented_field.
Как мы обрабатываем null
Одна несоответственность между harness‑ами оценки заключается в том, как они обрабатывают null. Проблема состоит в том, чтобы понять, когда модель опускает что‑то, а когда утверждает что‑то. Это разница между утверждением, что ячейка в таблице не содержит значения, и утверждением, что ячейка содержит текст «n/a».
Мы обрабатываем null следующим образом (как для ground truth, так и для предсказания):
- Мы flatten‑им оба JSON, получая отображение от адресов к их значениям; и
- Мы проверяем значение и спрашиваем, указывает ли оно на отсутствие (опускание) или на утверждение: пустая строка, None, "\t\n» преобразуются в None; а «NA», "-", "--» остаются без изменений.
- Пустая строка, None, "\t\n» преобразуются в None; и
- "NA", "-", "--» остаются без изменений.
Для каждого адреса, который после этих шагов имеет значение None, мы удаляем весь адрес. Это означает, что опускание адреса эквивалентно указанию на него значения None. Мы считаем это правильным подходом, иначе метрика может быть использована в свою пользу через ширину схемы.
Игра могла бы выглядеть так: добавить сотни необязательных полей в ground‑truth схему, которых фактически нет в документах бенчмарка. Тогда модели получали бы награду за нахождение ничего, получая (по сути) бесплатные совпадения между None и None, произвольно завышая баллы.
Метрики
Все формулы метрик основаны на количестве вердиктов, которое само по себе является количеством адресов после выравнивания. Общее количество всех вердиктов — это total.
Основные метрики:
- точность → |matched| / total;
- полнота → |matched| / |gold|; и
- точность (precision) → |matched| / |pred|.
Мощность вердиктов
То, что позволяют нам делать вердикты, — это обеспечение аудируемости через результаты, а не только код, который привёл к этим результатам. Метрики разлагаются на подсчёты вердиктов, поэтому то, что вы видите вверху, можно исследовать через лестницу абстракций, что помогает интерпретируемости.
Одна из вещей, которую мы разрабатываем, — это небольшое пользовательское интерфейс, который разбивает результаты по вердиктам и позволяет вам перекрёстно ссылаться на это вместе с PDF и схемой. Вот предварительный просмотр:
Что дальше
Мы с нетерпением ждём отзывов сообщества и продолжения уточнения бенчмарка, добавления более инструментов и дальнейшего развития OmniExtractBench. В ближайшие недели мы подробнее обсудим некоторые проблемы, которые видим в других бенчмарках. Мы также запустим инструменты, которые помогут вам оценивать результаты извлечения и строить уверенность.
Как всегда, самый важный бенчмарк — тот, который вы запускаете на своих собственных документах — направьте нашу площадку на ваши самые ужасные файлы и сравните наши цифры с вашими собственными. Если у вас есть отзывы о бенчмарке, напишите нам на [email protected].