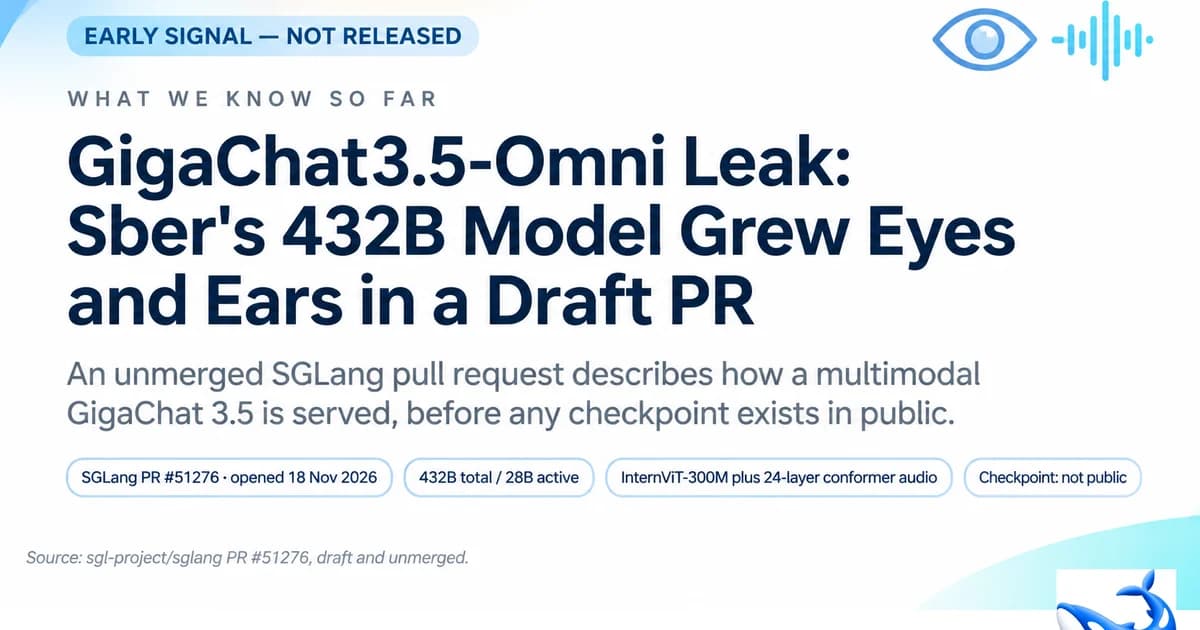
Черновик pull request, открытый в репозитории SGLang 18 ноября 2026 года, описывает модель, которой официально не существует: GigaChat3.5-Omni-432B-A28B. Это GigaChat 3.5 Ultra — 432-миллиардная языковая модель Сбера на основе смеси экспертов (MoE) — дополненная визуальным энкодером InternViT-300M и 24-слойным аудио-конформером. Система способна обрабатывать изображения, видео (со звуковой дорожкой или без), аудиофайлы и их комбинации. Ни один из этих фактов нельзя проверить по карточке модели, так как публичной карточки просто нет. Репозиторий на Hugging Face, на который ссылается PR, при запросе выдает ошибку HTTP 401, поиск по названию на Hugging Face ничего не дает, а в документации для разработчиков Сбера по-прежнему указан GigaChat 3 Ultra как модель последнего поколения, без упоминания мультимодальных версий. В наличии имеются лишь 3290 добавленных строк кода для обслуживания модели, конфигурационный файл, около 2000 строк тестов и таблица бенчмарков, в которой столбец с эталонными значениями кто-то оставил пустым.
И это немало. Pull request такого уровня может написать только тот, у кого был доступ к чекпоинту: процессор делегирует декодирование изображений, раскладку пикселей и извлечение log-mel спектрограмм удаленному коду самого чекпоинта через --trust-remote-code. Это означает, что автор должен был запустить модель, чтобы увидеть, как выглядят эти тензоры. Поэтому важный вопрос не в том, «анонсировал ли это Сбер» (нет, не анонсировал), а в том, что этот код говорит о модели, которая, скорее всего, сейчас находится в приватном репозитории, и что это будет означать для тех, кто платит за токен при обработке аудио и видео.
Что на самом деле описывает pull request
PR #51276 в SGLang озаглавлен «[Feat] gigachat35-omni: Add GigaChat3.5-Omni image, video and audio support». Это черновик, он не объединен с основной веткой, а CI для него был пропущен именно из-за статуса черновика. Реализация представляет собой тонкую обертку — GigaChat35OmniForConditionalGeneration вокруг существующей GigaChat35ForCausalLM — с тремя дополнениями: визуальный путь через InternVisionModel и проектор MLP с перемешиванием пикселей, встроенный аудио-конформер и процессор, который расставляет плейсхолдеры. Все, что приведено ниже, является описанием модели от автора PR, и ни один из этих пунктов не был подтвержден Сбером.
• Языковой стек — без изменений по сравнению с GigaChat 3.5: 432 млрд параметров всего, 28 млрд активных, 256 маршрутизируемых экспертов (8 на токен), 40 слоев, гибридное внимание, сочетающее MLA с линейными слоями внимания Gated DeltaNet, две головы MTP. Эти цифры взяты из публичной карточки модели GigaChat 3.5 Ultra, поэтому эта часть верифицируема.
• Зрение — InternViT-300M, изображения разбиваются на фрагменты 448×448, по 256 токенов на фрагмент.
• Аудио — 24-слойный конформер, ширина 1024, 16 голов, полносвязный слой шириной 4096, 64 мел-бина, коэффициент субдискретизации 4, внимание ограничено чанками по 200 кадров с «ореолом» (halo) в один блок на слой. Аудио токенизируется со скоростью 6,25 токена в секунду, один токен на 160 мс.
• Видео — первый кадр сохраняет все 256 токенов; последующие кадры сохраняют в среднем 77 токенов. Какие именно 77 токенов оставить, решается после кодирования путем ранжирования среднего абсолютного отклонения каждого токена от той же позиции в предыдущем кадре. Стабильная сортировка по всему клипу выбирает их, поэтому в кадре может оказаться больше или меньше 77 токенов.
• Видео со звуком — параметр use_audio_in_video вставляет долю токенов звуковой дорожки каждого кадра после самого кадра, с метками времени ЧЧ:ММ:СС между кадрами.
• Длинное аудио — клипы длиннее 32 минут кодируются окнами с «ореолом», что, согласно PR, побитово идентично однопроходному кодированию. Заявленная возможность: пять часов аудио на одном узле.
• Обработка ошибок — некорректные медиаданные возвращают код 400 вместо аварийного завершения планировщика, а SGLANG_VLM_CACHE_SIZE_MB по умолчанию установлен на 2048 для этой архитектуры, так как стандартных 100 МБ не хватало для хранения эмбеддингов длинного видео, из-за чего каждый чанк префилла приводил к повторному запуску энкодеров.
Черновик остается черновиком
Стоит уточнить, какая часть этой информации верифицируема сегодня, поскольку черновик PR с пропущенным CI — это предложение, а не факт выпуска готового продукта. Файла gigachat35_omni.py не существует в основной ветке SGLang — при попытке доступа выдается ошибка 404, а на странице поддерживаемых моделей в основной ветке нет упоминания GigaChat. У PR один коммит от аккаунта, единственным взаимодействием которого в SGLang является этот PR, а единственный комментарий к нему — это примечание бота документации с просьбой одобрить предварительный просмотр из форка.
Происхождение кода — самое сильное косвенное доказательство во всей истории. Весь медиа-путь процессора делегирован «удаленному процессору чекпоинта», а автор сообщает о паритете идентификаторов промптов с «сервирующим стеком, на котором модель обучалась и оценивалась» — внутренним эталонным стеком, который не назван и не является публичным. Невозможно написать ни то, ни другое для модели, которую вы не запускали. Кому-то за пределами Сбера потребовался бы чекпоинт; у кого-то внутри был бы доступ к внутреннему стеку. В PR нет ни слова о том, кто именно это сделал, и данная статья не будет строить догадки.
Единственное, что становится ясно из кода, — это не переименование и не флаг конфигурации. Модель регистрирует новый тип model_type (gigachat3_5_omni) со своими собственными идентификаторами токенов — 128004 для изображений, 128005 для видеокадров, 128006 для аудио, 128007 для звуковой дорожки — новый процессор, новый тип результата эмбеддинга, который mm_schedule.py должен обрабатывать наряду с существующим путем EVS, и новую обработку для чанкового префилла, поскольку количество токенов, которое сохраняет кадр, становится известно только после его кодирования. Это почерк модели, обученной с учетом этих решений по предобработке, а не результат любительского дообучения, гипотетически «прикрученного» к текстовому чекпоинту.
Математика токенов — это то, что стоит изучить
Отложим таблицу бенчмарков в сторону. Арифметика в PR — это суть, потому что именно она показывает, является ли 432B-модель, потребляющая длинное аудио и видео, чем-то, что вы могли бы позволить себе запустить — и это та часть, которая не изменится, даже если Сбер никогда не скажет ни слова об этой модели.
Возьмем час аудио. При 6,25 токена в секунду это 22 500 входных токенов плюс метка времени каждые 60 секунд и финальная метка длительности — сущие пустяки по сравнению с самим аудио. Возьмем 512-кадровое видео. При 256 токенах для первого кадра и 77 для каждого последующего, клип составит около 39 600 токенов без учета звуковой дорожки, что примерно треть от контекста 128K для полуминуты видео. Добавьте звуковую дорожку, и каждый кадр получит дополнительные токены. Это и есть главный аргумент в пользу схемы сокращения изменений: без нее 512 кадров по 256 токенов каждый составили бы 131 072 токена — целое окно 128K для одного клипа.
Что это означает в деньгах, легко проверить на моделях, доступных сегодня. В каталоге OrcaRouter цены на смешанные медиа-входы для часа аудио выглядят так:
• Gemini 3.8 Flash — $0,75 за миллион входных токенов, поэтому час аудио стоит около 1,7 цента, а 512-кадровый клип — около 3 центов.
• Qwen3-VL 235B A22B Instruct — $0,40 за миллион входных токенов, то есть примерно 0,9 цента за час и 1,6 цента за клип.
• DeepSeek V4 Flash Vision Exp — $0,22 за миллион входных токенов, но только для изображений; аудио он не принимает вовсе.
Обеспечьте реальную рабочую нагрузку. Сорок часов записанных звонков — это 900 000 токенов: около 68 центов по прайс-листу Google и 36 центов по прайс-листу Qwen, согласно публичным ценам провайдеров. OrcaRouter передает тарифы провайдеров без наценок, поэтому любое снижение цен поставщиком вступает в силу на нашей стороне в тот же день — что также является честным пределом того, что мы можем здесь сказать: GigaChat3.5-Omni-432B-A28B отсутствует в нашем каталоге, и мы не предоставляем способ его вызова. Его невозможно вызвать нигде. Суть арифметики в том, что когда нечто подобное действительно появится, аудио не будет самой дорогой частью; ею будут токены, которые вы не можете сжать.
Именно здесь кроются 32-минутное окно и пятичасовое ограничение, упомянутые в PR. Эти цифры важны для тех, кто самостоятельно размещает модель на восьми H100, поскольку они определяют, какая часть длинной записи должна быть перекодирована при разделении запроса на фрагменты префилла (prefill chunks). Они не имеют значения для тех, кто платит за токен, где час аудио — это час аудио, независимо от того, какой кодировщик его создал.
Четыре показателя бенчмарка, один пустой столбец
В PR представлены четыре оценки, полученные на восьми H100 в формате FP8 при тензорном параллелизме 8 и жадном декодировании: MMLU-Pro 73.07, MMAU test-mini 78.50, MMMU validation 64.11 и Video-MME 80.74 для 512-кадрового клипа с саундтреком. Читайте их с тремя оговорками, все из которых видны на самой странице PR.
Первая заключается в том, что столбец для сравнения пуст. В таблице есть столбец для исходного стека обслуживания модели и столбец для этого PR, и заполнен только второй, поэтому рядом с этими цифрами нет базовых показателей, и по таблице невозможно сказать, соответствует ли порт стеку, на котором обучалась модель, или проигрывает ему. Текст действительно содержит утверждение о паритете — идентичные идентификаторы промптов для каждого запроса, который мог обслужить эталон, совпадение первых токенов в 19 из 19 случаев — что неявно говорит о том, что эталон не смог обслужить один из двадцати фиксированных запросов.
Вторая — это контрольный список. Пункт «Предоставить результаты бенчмарков точности и скорости в соответствии с разделом Test the accuracy» не отмечен, а таблица скорости, содержащая строки для батча 1 и батча 16 со столбцами для базового декодирования, MTP-декодирования, ускорения и длины принятия, полностью пуста. Таким образом, для этой модели вообще нет показателя пропускной способности, несмотря на две MTP-головки в языковом стеке, которые, согласно публичной карточке GigaChat 3.5, обеспечивают до 2,2-кратного ускорения генерации.
Третья — это контекст, и здесь цифры становятся интересными, а не просто скудными. MMLU-Pro на уровне 73.07 находится примерно на 2,6 пункта ниже, чем 75.68, которые указаны в собственной карточке модели GigaChat 3.5 Ultra для текстовой модели в том же бенчмарке — что может означать, что мультимодальный вариант пожертвовал некоторым качеством текста, или что в двух запусках использовались разные инструменты тестирования, и нет ничего опубликованного, что позволило бы выбрать между этими объяснениями. MMAU на уровне 78.50 выше, чем 74.7, указанные в собственной карточке аудиомодели GigaChat для Qwen3-Omni, и значительно выше 62.2, которые та же карточка указывает для собственной модели Sber GigaChat3.1-Audio-10B-A1.8B — карточка, измеренная на полном наборе MMAU, а не на подмножестве test-mini, поэтому воспринимайте это сравнение как предположительное, а не как прямое сопоставление. MMMU на уровне 64.11 — это средний показатель понимания изображений. Video-MME на уровне 80.74 для 512-кадрового клипа с аудио — это тот показатель, который вызвал бы удивление, если бы кто-то независимый его воспроизвел.
Что требуется для обслуживания и что сказал Sber
Сначала о реальности развертывания. Текстовый чекпоинт FP8, лежащий в основе GigaChat 3.5 Ultra, занимает 437,9 ГБ в 39 файлах, поэтому тензорный параллелизм 8 на H100 оставляет примерно 55 ГБ весов на карту до учета KV-кэша — вот почему тестовый стенд PR состоит из восьми H100 и почему это не сильно изменится для варианта Omni. Две башни — это статистическая погрешность по сравнению с 432B: InternViT-300M плюс 24-слойный конформер шириной 1024 — это значительно меньше миллиарда параметров, поэтому требования к оборудованию по сути определяются языковой моделью. Метаданные, флаги запуска и парсер вызовов инструментов gigachat35 уже находятся в основной ветке SGLang после слияния работы по GigaChat 3.5 в сентябре, и в кулинарной книге проекта с тех пор есть страница GigaChat 3.5; чего нет в основной ветке, так это какого-либо мультимодального пути.
Сам Sber не опубликовал ничего, что удалось бы найти в рамках этого материала. В его документации для разработчиков GigaChat 3 Ultra указана как модель последнего поколения, наряду с GigaChat 2 Max, Pro и Lite, а также моделями эмбеддингов — нет ни 3.5, ни Omni, ни мультимодальной записи. У Artificial Analysis нет страницы для GigaChat 3.5 Ultra или варианта Omni ни по одному из запросов, которые мы пробовали сегодня, поэтому нет и независимой оценки базовой модели, от которой можно было бы отталкиваться. Публичная карточка GigaChat 3.5 Ultra реальна, лицензирована по MIT, ориентирована на русский и английский языки и содержит набор бенчмарков поставщика, включая TAU2-bench 68.71, SWE-bench Verified 42.6, Terminal-Bench 2 на уровне 13.48 и LiveCodeBench v6 на уровне 56.2 — все это собственные цифры Sber, не воспроизведенные независимо, и все они относятся только к текстовой модели.
Аудио-линейка — это та часть, которая выглядит как план, а не как случайность. Sber выпустил GigaChat3.1-Audio-10B-A1.8B в июле 2026 года: конформерный речевой энкодер и адаптер модальности, подающий данные в 10B декодер смеси экспертов (mixture-of-experts), обученный для временного позиционирования на специально созданном наборе данных длинного аудио, с описаниями с временными метками и суммаризацией длинного аудио в качестве ключевых навыков. Это именно та возможность, которую призвана сохранить схема штамповки PR Omni — временная метка перед каждым кадром, штамп каждые шестьдесят секунд аудио, закрывающая длительность — и размеры конформера в конфигурации PR согласуются со сворачиванием этого стека в модель 432B, а не с его размещением рядом.
Что могло бы прояснить ситуацию
Четыре вещи, в порядке возрастания того, насколько много они бы рассказали. Публичный чекпоинт по этому идентификатору репозитория подтвердил бы существование модели и позволил бы любому прочитать конфигурацию, которая в настоящее время является единственным фактическим основанием для размеров башен. Объединенный, не черновой PR с зеленым статусом CI показал бы, что порт работает не только на двадцати фиксированных запросах автора. Таблица скорости с цифрами показала бы, выживают ли две MTP-головки в мультимодальной обертке, что является разницей между моделью, которую можно обслуживать интерактивно, и той, которую нельзя. Независимый бенчмарк — чей угодно, на полных наборах, а не на test-mini — показал бы, значат ли что-то 78.50 и 80.74.
До тех пор решение для читателя простое, и оно не зависит от того, разрешится ли эта утечка. Если вашему продукту сегодня нужно понимание аудио или видео, GigaChat3.5-Omni-432B-A28B не рассматривается, и ни одно объявление его не добавило; модели, которые могут выполнять эту работу, уже оцениваются за токен, и приведенная выше арифметика говорит о том, что счет меньше, чем предполагает большинство команд. Если вы планируете самостоятельно разместить русскоязычный мультимодальный стек на своих собственных H100, этот PR — самое раннее публичное доказательство того, что такой чекпоинт создается, и его учет токенов стоит прочитать сейчас — схема сжатия, а не таблица бенчмарков, является той частью, которая определяет ваш бюджет памяти.
Что мы будем отслеживать дальше: станет ли репозиторий публичным, перестанет ли PR быть черновиком и появится ли в документации для разработчиков Sber мультимодальная запись раньше, чем произойдет что-либо из вышеперечисленного. Любое из этих трех событий превратит этот материал из обзора того, что нам известно на данный момент, в полноценный анонс, и статью придется не обновлять, а переписывать заново.