Что означает деградация контекста для AI-агентов
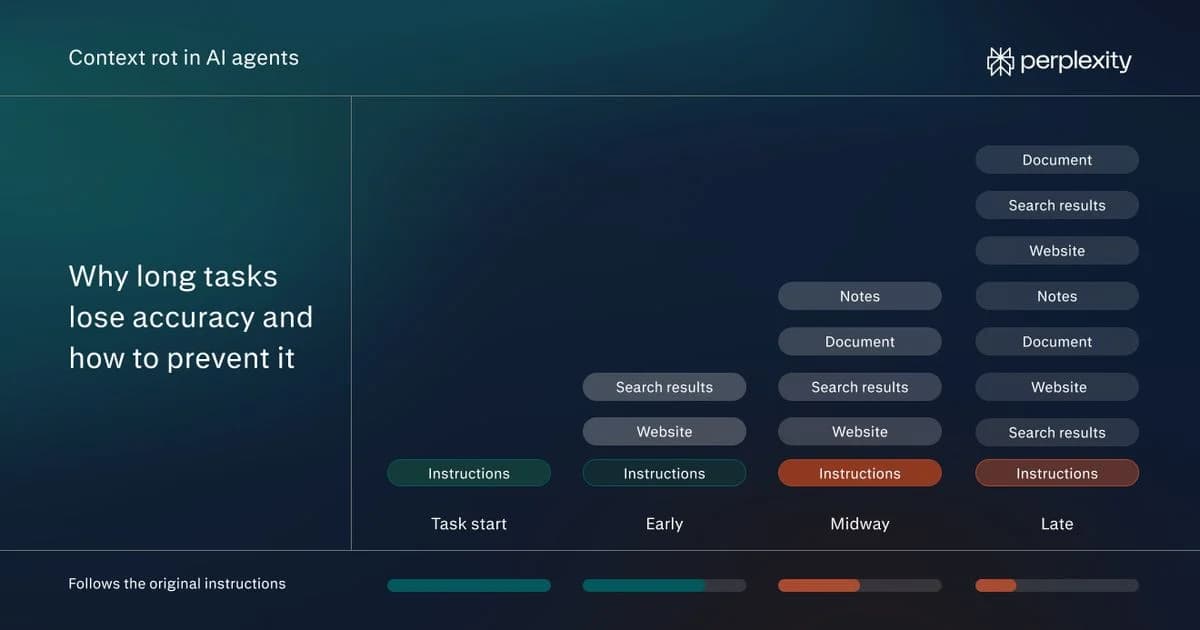
Деградация контекста в AI-агентах — это постепенная потеря точности, которая возникает по мере заполнения контекста агента во время выполнения длительной задачи.
Контекст агента — это информация, доступная модели для выполнения следующего шага. Он может включать инструкции, предыдущие сообщения, результаты поиска, а также текст с веб-сайтов или из файлов. По мере работы агент может добавлять в него новые данные.
Например, допустим, задача агента — найти поставщиков, которые осуществляют доставку в течение двух недель. В начале работы в его контексте содержится только этот запрос. В середине выполнения задачи контекст будет включать текст десятков сайтов поставщиков, несколько страниц результатов поиска и заметки о том, каких поставщиков агент уже проверил.
Существует предел того, какой объем контекста может удерживать модель (так называемое контекстное окно). Окно измеряется в токенах — небольших фрагментах текста, обычно представляющих собой слово или его часть. Деградация контекста усиливается по мере его роста, поэтому она наиболее вероятна в длительных задачах, состоящих из множества шагов.
По мере усиления деградации контекста агент становится менее точным. Он может хуже следовать исходным инструкциям, упускать детали или принимать похожую информацию за ту, которая ему нужна.
Например, агент может начать включать поставщиков, у которых доставка занимает шесть недель, хотя ему было поручено найти вариант с двухнедельной доставкой. Инструкция все еще находится в контексте, но она перестает влиять на выбор агента.
Деградация контекста — это не то же самое, что просто нехватка места в контекстном окне. Когда контекст задачи превышает размер окна, данные обрезаются или задача завершается с ошибкой. Деградация контекста начинается задолго до этого момента, пока все данные еще помещаются.
Это также не то же самое, что отравление контекста (когда в контекст агента попадает вводящая в заблуждение или вредоносная информация). Агент с точной и полной информацией все равно может столкнуться с деградацией контекста.
Почему происходит деградация контекста
Деградация контекста происходит из-за того, что внимание модели ограничено, даже если в контекстном окне есть свободное место. В AI-моделях «внимание» — это технический термин, обозначающий, как модель решает, на какие части входных данных опираться при написании каждого слова ответа. Каждая часть контекста конкурирует за это внимание. Чем больше текста, тем меньше внимания достается каждой отдельной части.
Например, Chroma опубликовала исследование о том, как длина входных данных влияет на AI-модели. В нем тестировались 18 моделей от Anthropic, OpenAI, Google и Alibaba. В одном из тестов исследователи спрятали предложение с советом по написанию текста внутри длинной подборки эссе. Затем они спросили модель, в чем заключался совет.
Они проводили тест многократно, каждый раз добавляя больше текста эссе. Предложение и вопрос никогда не менялись. Менялся только объем окружающего текста.
Чем больше текста приходилось читать моделям, тем хуже они справлялись. Этот результат подтвердился во всех тестах в отчете. Исследователи прогнозируют, что падение точности будет еще более значительным в реальной работе, требующей множества шагов, как в большинстве задач для агентов.
Как деградация контекста может повлиять на AI-агентов
Деградация контекста обычно проявляется одним из четырех способов:
Потеря исходных инструкций
В простейшем тесте Chroma моделям предлагалось точно скопировать длинную строку повторяющихся слов, вставив где-то одно другое слово. Это была тривиальная задача с четкой инструкцией. Тем не менее, производительность всех моделей снижалась по мере увеличения длины текста. Некоторые модели начали генерировать слова, которых вообще не было во входных данных.
В задаче для агента пользователь обычно задает конкретные ограничения в начале, например бюджет или требуемый формат. По мере роста контекста агент может применять их менее последовательно. Причина кроется в общем объеме контекста, а не в том, где именно расположена инструкция.
Упущенные детали из середины задачи
Согласно исследованию, AI-модели наиболее надежно используют информацию, когда она находится в самом начале или в самом конце входных данных. В одном из тестов исследователи дали моделям набор из 20 документов и задали вопрос, ответ на который содержался только в одном из них. Когда этот документ был первым или последним, модели обычно находили ответ. Когда он находился в середине набора, они пропускали его гораздо чаще. Исследователи называют это позиционным эффектом.
Та же закономерность применима и к агентам. Информация, полученная в начале задачи, может оказаться в середине длинного диалога, где некоторым моделям сложнее ее использовать. В примере с поставщиками итоговый список может не содержать хорошего поставщика, которого агент проверил в середине выполнения задачи.
Смешивание похожей информации
По мере роста контекста агенты могут хуже распознавать, какая информация соответствует их инструкциям. Например, допустим, пользователь поручил агенту найти поставщиков, которые доставляют товары «в течение двух недель». На сайте поставщика написано: «прибытие в течение 14 календарных дней с момента заказа». В короткой задаче агент, скорее всего, поймет, что это одно и то же. Но если эта информация скрыта среди десятков других страниц поставщиков, вероятность того, что он не заметит соответствия, выше.
Альтернативно, агент может начать включать результаты, которые не имеют отношения к делу. Допустим, агент ищет поставщиков офисных стульев. На сайте одного поставщика обещают двухнедельную доставку, но только для столов. Стулья же доставляются шесть недель. На сайте используются те же слова, что и в инструкции, поэтому агент может все равно добавить этого поставщика в список. Исследователи называют такую информацию «дистрактором» (отвлекающим фактором). Она выглядит релевантной, но таковой не является, поэтому конкурирует с важной информацией.
Исследование Chroma показало, что обе проблемы усугубляются по мере увеличения объема окружающего текста.
Ошибки, которые трудно заметить
Деградация контекста не вызывает сообщения об ошибке. Агент продолжает работать и выдает результат, который выглядит завершенным. Из-за этого его ошибки легко пропустить.
В тестах Chroma эти ошибки принимали две формы. Иногда модель давала уверенный, но неверный ответ. В примере с поиском поставщиков агент мог предоставить аккуратный, хорошо оформленный список, в который попал поставщик, чьи условия доставки были неверно истолкованы.
В других случаях модель заявляла, что не смогла найти информацию, которая на самом деле присутствовала. Например, агент мог выдать отчет о том, что ни один поставщик не соответствует двухнедельному лимиту, хотя на самом деле такие были.
Как настроить задачи для агентов, чтобы уменьшить деградацию контекста
Правильная постановка задач позволит минимизировать влияние деградации контекста и поддерживать максимальную точность работы агента на протяжении всей задачи. Следующие рекомендации помогут в этом.
Формулируйте задачу как конкретное задание
Четкое задание позволяет ограничить объем контекста. Агент знает, когда задача выполнена, поэтому перестает собирать материалы, как только их становится достаточно. Конкретные требования также дают ему четкий критерий для проверки каждой страницы. Это облегчает агенту поиск нужной информации.
Перед отправкой задачи убедитесь, что она охватывает три аспекта:
- Задача: что агент должен сделать и какой результат получить, например «найти поставщиков и составить краткий список».
- Требования: факты, которые агент не может угадать, например бюджет, крайний срок, адрес доставки и для кого предназначен результат.
- Результат: формат, объем и структура, например «таблица с названием, ценой за стул и временем доставки».
В совокупности запрос для задачи с поставщиками может выглядеть так:
«Найдите 10 поставщиков, которые могут доставить 40 офисных стульев в наш офис в Чикаго в течение двух недель по цене менее 250 долларов за стул. Верните таблицу с названием поставщика, ценой за стул, сроком доставки и ссылкой на страницу продукта. Список предназначен для нашего офис-менеджера, который будет оформлять заказ».
Сосредоточьтесь на каждой задаче
Одна задача с одной четкой целью позволяет поддерживать небольшой объем контекста. Длинные задачи также стоят дороже. Каждый шаг обрабатывает все, что было собрано до этого момента, поэтому перегруженный контекст потребляет больше кредитов на каждом этапе.
Для проекта, состоящего из нескольких частей, разделите его:
- Перечислите отдельные результаты, например, поиск поставщиков, сравнение цен и электронное письмо выбранному поставщику.
- Выполняйте каждый результат как отдельную задачу.
- Передавайте только готовый результат из одной задачи в следующую. Например, загрузите таблицу поставщиков как файл, чтобы начать задачу по сравнению, вместо того чтобы продолжать в той же ветке, где она была создана.
Задача по сравнению начнется с одной таблицы, а не со всех страниц.
Укажите агенту правильные источники
Каждая страница, которую читает агент, добавляется в его контекст, включая меню, рекламу и шаблонный текст вокруг полезной части. Предоставление агенту источников напрямую снижает этот шум.
Загружайте файлы, от которых зависит задача, например, список утвержденных поставщиков, прикрепляя их к запросу. Указывайте веб-сайты, которые стоит искать, когда агенту приходится искать в сети, например, два надежных каталога поставщиков.
Подключайте инструменты, где находится информация. Например, в Perplexity Computer откройте «Коннекторы» (Connectors) на боковой панели и включите приложения, необходимые для задачи, такие как Google Drive или Slack. Затем упомяните их в запросе: «Используй спецификации стульев в нашем Google Drive». Подключайте только релевантные приложения, так как каждый коннектор занимает часть контекста агента.
Если информация находится в приложении, которого нет в списке коннекторов, его все равно можно подключить. Многие приложения предлагают коннектор MCP (Model Context Protocol) — стандартный способ подключения инструментов ИИ к другому программному обеспечению. Computer может использовать их наряду со встроенными коннекторами. В корпоративной учетной записи администратору, возможно, потребуется сначала их включить.
Запрашивайте финальную проверку на соответствие инструкциям
Завершайте запрос этапом проверки, в котором указаны наиболее важные ограничения:
«Перед завершением проверьте каждого поставщика на соответствие этим требованиям: доставка в течение двух недель, цена менее 250 долларов за стул. Отметьте тех, кто не соответствует этим требованиям, вместо того чтобы просто исключать их».
Ограничения по-прежнему остаются в начале контекста. Этап проверки дает агенту повод сравнить итоговый результат с ограничениями, вместо того чтобы полагаться на инструкции, которые должны сохранять свое влияние на каждом шаге.
В то же время просьба отмечать проблемы, а не просто отбрасывать такие результаты, облегчает обнаружение ошибок (например, отклонение поставщика, который обещает доставку в течение 14 календарных дней, только потому, что он не использует слова «две недели»).
Проверяйте работу на контрольных точках
Для более длительных задач создайте контрольную точку в запросе:
«Начни с поиска 20 потенциальных поставщиков, затем остановись. Я подтвержу список, прежде чем ты начнешь собирать цены».
Сверьте шорт-лист с исходными инструкциями. Исправьте все, что не так, в последующем запросе, а затем позвольте агенту продолжить. Ошибки, обнаруженные на этом этапе, не будут переноситься на каждый последующий шаг.
Начинайте новую задачу, если текущая сбилась с курса
Если агент повторяет одну и ту же ошибку после исправлений, начните новую задачу. Каждое исправление добавляет больше текста в и без того длинный контекст. Вместо этого создайте новую задачу. Повторите инструкции, загрузите все хорошие результаты из первой попытки и начните заново.
Некоторые агенты делают версию этого автоматически — процесс, называемый компактизацией. По мере того как задача становится длинной, агент заменяет старый материал, например, полный текст страниц, прочитанных ранее, кратким резюме того, что он нашел. Portable Computer от Perplexity сжимает контекст таким образом, чтобы модель оставалась в рамках того объема, с которым она может хорошо работать.
Также важно начинать новую задачу, если цель меняется. Ветка, которая началась как поиск поставщиков, не должна превращаться в проверку контрактов.
Превращайте повторяющиеся инструкции в навык (Skill)
Некоторые инструкции возникают в каждой задаче определенного типа, например, предпочтительный формат таблицы, список поставщиков, которых следует избегать, или стандартный этап проверки. В Computer их можно сохранить как навык (Skill) — набор инструкций для повторного использования, которым агент следует каждый раз. Навык встраивает другие лучшие практики в каждую задачу, которая его использует.
Чтобы настроить его:
- Выберите задачу, которая часто возникает, например, исследование поставщиков.
- Запишите инструкции, которые даются каждый раз: формат, проверки, источники, которые нужно использовать или избегать.
- Сохраните их как навык. Инструкции, уже написанные в Markdown, можно импортировать напрямую.
- Указывайте навык в будущих запросах: «Используй навык исследования поставщиков, чтобы найти поставщиков стульев для офиса в Денвере».
Как Perplexity подходит к контексту в работе агентов
Perplexity Computer обрабатывает длинные задачи способами, которые позволяют поддерживать контекст каждой модели небольшим и релевантным. Три части его дизайна ограничивают объем того, что модель должна прочитать за один раз.
Разделение работы между субагентами
Computer разбивает запрос на задачи и подзадачи, а затем создает субагентов для их выполнения. Каждый субагент работает над одной частью задания в своем собственном контексте. В задаче с поставщиками один субагент может исследовать цены, а другой — проверять условия доставки. Ни одному из них не нужно читать все, что прочитал другой.
Хранение работы в файлах
Каждая задача Computer получает свое рабочее пространство со своими файлами, веб-браузером и инструментами. Агент может сохранять свою работу в файл, например, в текущую таблицу проверенных поставщиков. Затем он открывает этот файл снова только тогда, когда это необходимо.
Выбор релевантных фрагментов из результатов поиска
Веб-страницы полны материала, который модели не нужен, например, меню, реклама, метаданные и текст на другие темы. Сжатие контекста с учетом запроса (Query-aware context compression) удаляет это. Прежде чем страница попадет в модель, Perplexity оставляет только те предложения, которые относятся к запросу.
Изучите советы, руководства и примеры задач для Perplexity Computer, чтобы применить эти шаги на практике.
Часто задаваемые вопросы
Является ли «деградация контекста» (context rot) тем же самым, что и галлюцинация?
Нет, но они связаны. Галлюцинация — это любой ответ, который утверждает что-то ложное или не подтвержденное. Деградация контекста — это одно из условий, которые делают галлюцинации более вероятными, наряду с другими ошибками, такими как игнорирование инструкций и пропущенные детали.
Может ли лучший запрос исправить деградацию контекста?
Четкий запрос уменьшает деградацию контекста, сохраняя фокус задачи. Однако он не может остановить рост контекста. В достаточно длинной задаче агент все равно собирает больше, чем может эффективно использовать, поэтому разделение работы и проверка по ходу дела так же важны, как и сам запрос.
Влияет ли деградация контекста на обычные чаты с ИИ, а не только на агентов?
Да. В чате контекстом является весь разговор на данный момент, включая каждое сообщение и любые документы, вставленные или загруженные в него. Ветка, которая длилась часами по нескольким темам, может привести к тем же ошибкам, что и длинная задача агента. Начало новой ветки для новой темы позволяет сохранить фокус каждого разговора.
Насколько длинной может стать задача, прежде чем начнется деградация контекста?
Фиксированной точки не существует. Все зависит от модели и задачи. Например, локальные модели с контекстным окном в 260 000 токенов начинают испытывать трудности уже после 100 000 токенов, что значительно меньше их предельных возможностей. Кроме того, снижение производительности происходит постепенно, а не внезапно.