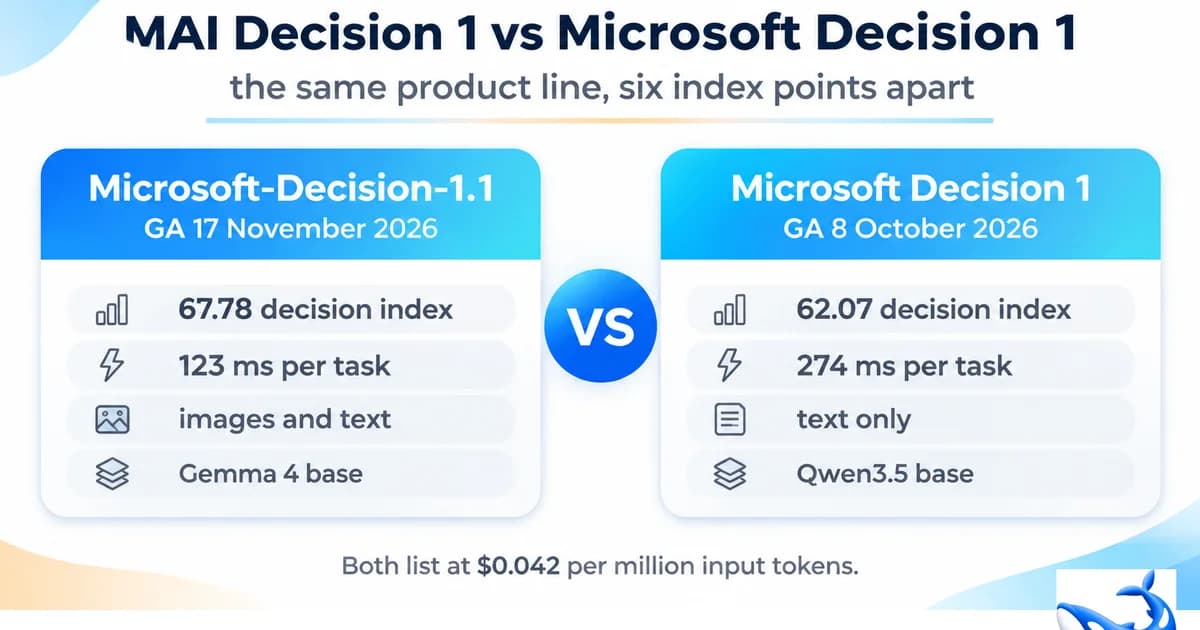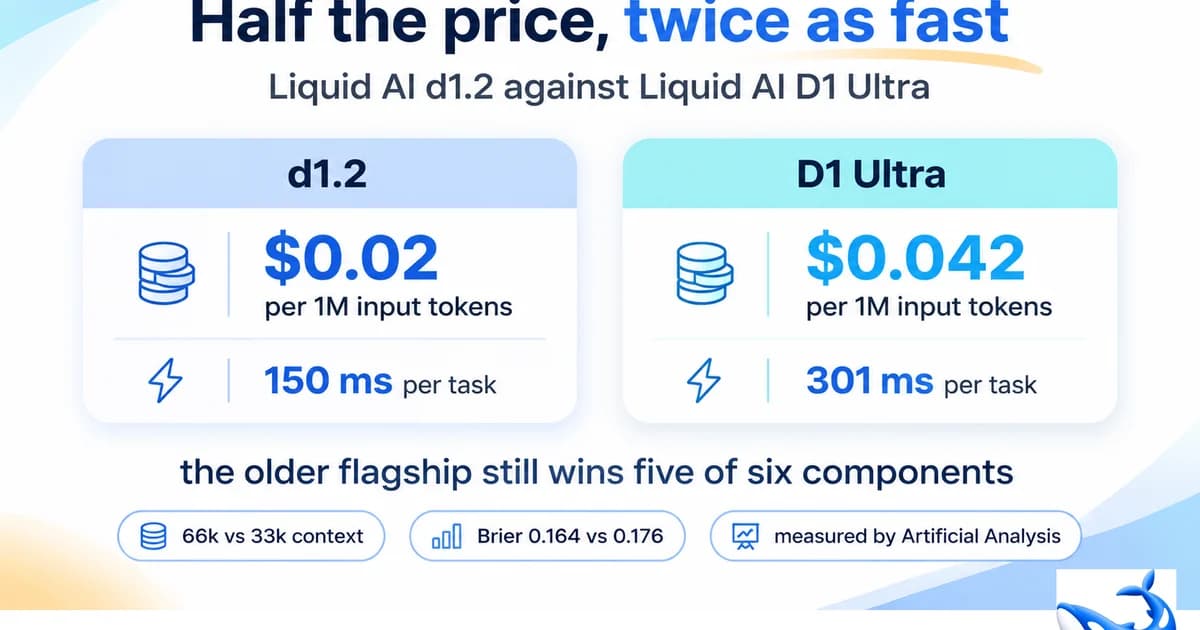
Модель Liquid AI d1.2 стоит 0,02 доллара за миллион входных токенов. Liquid AI D1 Ultra, флагманская модель семейства до 16 ноября 2026 года, стоит 0,042 доллара. Согласно Artificial Analysis Decision Index v2.1, более старая и дорогая модель по-прежнему впереди — 70,58 против 68,69 — и она лидирует в пяти из шести оценок, на которых строится индекс. Таким образом, согласно заголовку сравнения, флагман остается лучшей моделью, но заголовок сравнения — это наименее полезная вещь, которую можно извлечь из этих двух строк.
На самом деле их разделяет не рейтинг, а форма. D1 Ultra — это модель для сложных, однократных суждений: дефект на печатной плате, проверка страхового случая по фотографии. d1.2 — это модель для ответов на несколько вопросов об одном и том же состоянии, работающая в два раза быстрее, с контекстным окном, которое, согласно таблице, составляет 66 тыс. токенов против 33 тыс. у D1 Ultra, и с пятью типами ответов, которых нет у D1 Ultra. Разница в 0,022 доллара реальна; является ли она решающей для вашего перехода — это вопрос о характере ваших запросов, и на него можно ответить, исходя из опубликованных данных.
Ценовой разрыв в значимых единицах
В пересчете на токен удвоение звучит тривиально. В пересчете на задачу это не то же самое соотношение, поскольку две модели потребляют разное количество токенов для ответа на один и тот же вопрос. Artificial Analysis рассчитывает стоимость моделей на миллион задач по текущим прейскурантным ценам, и показатель самой таблицы составляет 63 доллара для d1.2 против 133 долларов для D1 Ultra — разрыв в 2,1 раза, который сохраняется даже после учета токенов.
• Цена за миллион входных токенов — 0,02 доллара для d1.2 против 0,042 доллара для D1 Ultra.
• Моделируемая стоимость миллиона задач — 63 доллара против 133 долларов, обе по текущим прейскурантным ценам, обе взяты из таблицы, а не от Liquid.
• Decision Index v2.1 — 68,69 (№9 из 25) против 70,58 (№6 из 25).
• Время на задачу — 150 мс против 301 мс. Новая дешевая модель в два раза быстрее.
• Контекстное окно — 66 тыс. токенов против 33 тыс., согласно данным Artificial Analysis; в собственных публикациях Liquid о запуске размер окна для обеих моделей не указан.
• Модальность ввода — текст и изображение для обеих, согласно таблице. d1.2 добавляет аудио, по словам поставщика, что еще не отражено в спецификации таблицы.
• Оценка Брайера (Brier score), где меньшее значение лучше — 0,164 против 0,176. Более дешевая модель лучше откалибрована.
Прочитайте последнюю строку дважды. Калибровка — это свойство, которое делает порог вероятности пригодным для использования, и модель, стоящая вдвое дешевле, выигрывает в этом. Баллы, которые все еще удерживает флагман, касаются знаний, а не уверенности в них.
В чем D1 Ultra по-прежнему оправдывает свою цену
Пять из шести компонентов отдают предпочтение более старой модели, и закономерность в них достаточно последовательна, чтобы учитывать ее при планировании.
• AA-Paperclip, решения по документам — 64,69 для D1 Ultra против 62,60 для d1.2, при этом 51,3% документов полностью верны против 44,3%. Полное прохождение документа — более строгая мера: счет-фактура из пятнадцати полей с четырнадцатью правильными считается ошибкой.
• EvalSafe-O*NET-AA, суждения на рабочем месте — 88,15 против 86,55, и точность 82,9% против 79,7%. Разница в 1,6 балла по компоненту близка к уровню шума при повторном запуске.
• AA-Omniscience-Decision v1.1, знания — 64,39 против 60,94, при точности 28,0% против 30,0% и уровне отсутствия галлюцинаций 88,6% против 66,6%. Строка точности и строка отказа от ответа противоречат друг другу, и именно строка отказа доминирует в оценке: D1 Ultra отказывается гораздо чаще и получает за это вознаграждение.
• HLE-MultiChoice v1.1, сложные вопросы — 47,39 против 44,69. По «сырой» точности разрыв увеличивается в другую сторону: 6,09% против 5,30%, и это шум в тесте, где весь диапазон составляет менее десяти процентов.
• AA-Symmetry, инвариантность при перефразировании — 78,66 против 76,52 по оценке компонента, хотя d1.2 проходит больше полных наборов: 50,0% против 45,8%. Флагман выигрывает по частичному зачету и проигрывает по более строгой мере, так что эта строка также не является однозначной победой.
Если ваш рабочий процесс — это «один документ, один сложный вопрос, ответ передается человеку, который будет действовать на его основе», то эти строки описывают именно тот случай, когда старый флагман по-прежнему является правильным выбором, а разница в цене при таком объеме — это погрешность округления.
В чем d1.2 не имеет равных
Один компонент меняет картину, и весьма существенно.
• When2Call, решения по инструментам и функциям — 96,09 для d1.2 против 93,83 для D1 Ultra, при точности 95,5% против 93,0%. Это компонент, который определяет, вызывает ли агент нужную функцию с нужными аргументами, и это самый сильный аргумент в пользу новой модели в агентском стеке.
Затем есть все то, что индекс не измеряет. Пять новых типов ответов — значение с символами, из которых оно было прочитано, диапазоны с позициями, поля, подсчеты с диапазонами, множественный выбор с вероятностями для каждого варианта — существуют только в d1.2, и индекс не оценивает ни один из них. Их показатели точности — собственные данные Liquid, полученные на внутренних тестовых наборах, созданных из отложенных частей общедоступных наборов данных, и они помечены таким образом везде, где появляются ниже.
Согласно цифрам поставщика, две новые модели близки друг к другу, а строки для D1 Ultra вообще нет, потому что этих типов задач не существовало, когда она вышла: 98% и 96% при чтении значения из чека для d1.2-ultra и d1.2, 94%/93% против 92%/88% по диапазонам персональных данных, 94% для обеих по определению местоположения объекта и 87% против 90% по выбору каждого присутствующего объекта. Важный факт для этого сравнения — не проценты, а то, что старая модель не может выразить эти ответы, поэтому конвейер, которому они нужны, выбирает не между двумя моделями. Он выбирает между одной моделью и обходным решением.
Правило биллинга, которое стоит больше, чем два балла индекса
D1 Ultra тарифицирует каждый вопрос как отдельный промпт, включая каждое прикрепленное изображение. Задайте десять вопросов об одной фотографии, и фотография будет оплачена десять раз: при заявленных Liquid 1,5 токена на патч 32×32 пикселя, изображение 1024×1024 составляет 1536 токенов, поэтому десять вопросов несут 15 360 токенов изображения до того, как будет произнесено слово текста. d1.2 тарифицирует текст и изображения запроса один раз, а каждый дополнительный вопрос добавляет только свой текст.
Рассчитаем на конкретном запросе: документ на 2000 токенов, одно изображение 1024×1024, десять вопросов примерно по 30 токенов. По старому правилу запрос несет примерно 35 700 токенов; по новому — примерно 3840. При цене каждой модели это около 0,0015 доллара для D1 Ultra против около 0,00008 доллара для d1.2 — ценовой разрыв и разрыв в биллинге суммируются, а не нивелируются. При 250 000 запросов в месяц разница составляет примерно 375 долларов против 20 долларов.
Это арифметика на основе собственного описания биллинга Liquid, а не измеренный счет, и соотношение сводится к 1×, если вы задаете один вопрос на состояние. Этот единственный вопрос и есть все решение: чем больше вопросов вы задаете об одном и том же документе, тем меньше сравнение зависит от баллов индекса.
Что меняется в клиенте
Эндпоинт тот же — api.liquid.ai/decisions/v1/systemone — и миграция заключается в строке модели. Три исходных типа вопросов сохраняют свою форму; ответы по-прежнему представляют собой структурированный JSON с вероятностью для каждого варианта и без выходных токенов, поэтому в вашем парсинге ничего не меняется. То, что вы получаете, является дополнением и не ломает ничего из того, что уже работает.
Основная сложность здесь скорее операционная, чем техническая: D1 Ultra не является устаревшей, обе модели тарифицируются только по входным токенам, и Liquid продает обе через одну и ту же консоль. Нет никаких принудительных факторов для перехода, а это значит, что миграция не произойдет сама по себе и ее следует планировать исходя из измеримой рабочей нагрузки, а не даты запуска.
Запуск обеих моделей без обязательного выбора одной из них
Пара слов о доступе перед операционной частью: d1.2 и D1 Ultra предоставляются через собственный API Liquid, и ни одна из них не представлена в нашем каталоге — это сравнение, а не заявление о доступности. Наш каталог имеет значение только из-за Jev 1.14, который удерживает EvalSafe-O*NET-AA на уровне 91,14, в то время как d1.2 достигает 86,55, принимает тот же формат запроса systemone и стоит 0,042 доллара за миллион входных токенов. Если решение о миграции упирается в один компонент, который вы не можете позволить себе потерять, именно с этой моделью его и стоит тестировать.
Разделение, которое имеет смысл, следует за уточненной картиной компонентов, а не за заголовками. Отправляйте состояния с несколькими вопросами, любые запросы с изображениями и все, что агент перенаправляет, на d1.2 — именно там его контекстное окно, скорость и When2Call указывают в одном направлении. Оставляйте одиночные сложные суждения по документам и вопросы на знание с однозначным ответом для D1 Ultra, пока ваша собственная выборка не покажет обратное. Два маршрута, по одному условию на каждый, написанные в зависимости от типа вопроса, а не жестко закодированные в трех сервисах: именно для этого и нужен DSL маршрутизации. А поскольку цены поставщика передаются без наценки в 0%, изменение любой из цен Liquid становится заметным для маршрутизации в тот же день, а не при следующем продлении. Автоматическое переключение при сбоях затем покрывает случай, если у одной из двух моделей возникнут проблемы в середине миграции.
Теневой запуск в таком масштабе почти ничего не стоит: прогоните несколько тысяч ваших реальных состояний через обе модели, сравните вероятности, а не метки, и подсчитайте случаи, когда D1 Ultra выдает 0,85 и ошибается, в сравнении с теми же случаями на d1.2. Согласно общим данным, новая модель лучше откалибрована; ваша выборка — это единственное, что скажет, лучше ли она откалибрована на ваших данных, и именно от этого числа должна зависеть миграция.