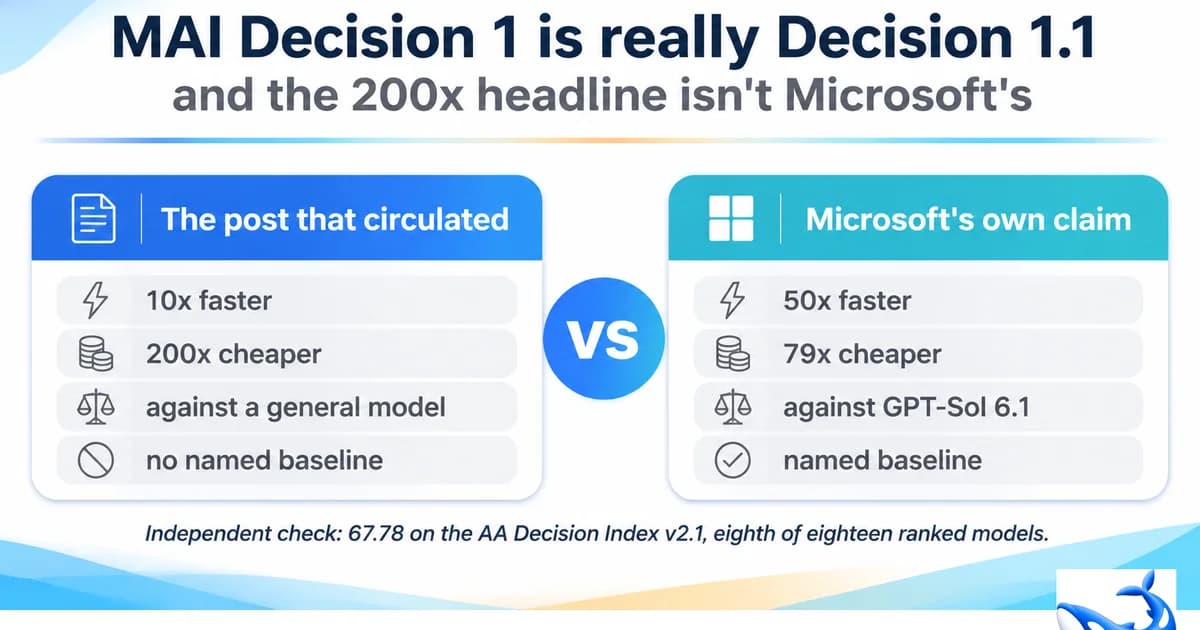
17 ноября 2026 года распространились две цифры относительно MAI Decision 1: якобы она в 10 раз быстрее и в 200 раз дешевле «обычной модели». Ни одна из этих цифр не встречается в официальном анонсе Microsoft. Модель, которую Microsoft действительно выпустила на Ignite, называется Microsoft-Decision-1.1, а опубликованные компанией данные говорят о 50-кратном ускорении и 79-кратном удешевлении по сравнению с GPT-Sol 6.1 — в сравнении с конкретной моделью и в конкретных условиях тестирования, а не с «обычной моделью». Этот разрыв стоит обсудить в первую очередь, поскольку это разница между маркетинговым коэффициентом и проверяемыми данными. Ниже приведено то, что было выпущено, что задокументировала Microsoft и какое место модели отводят независимые эксперты.
Во-первых, название
В материалах Microsoft нигде не используется строка «MAI Decision 1». В посте о линейке Ignite модель называется Decision 1.1, в блоге Foundry — Microsoft-Decision-1.1, и карточка модели в каталоге Foundry носит то же имя. Метка «MAI Decision 1» появилась в сторонних обзорах презентации вместе с «MAI Code 2», «MAI Code 2 Flash» и «MAI Cyber 2 Flash» — это то же семейство, переименованное наблюдателями, а не вендором.
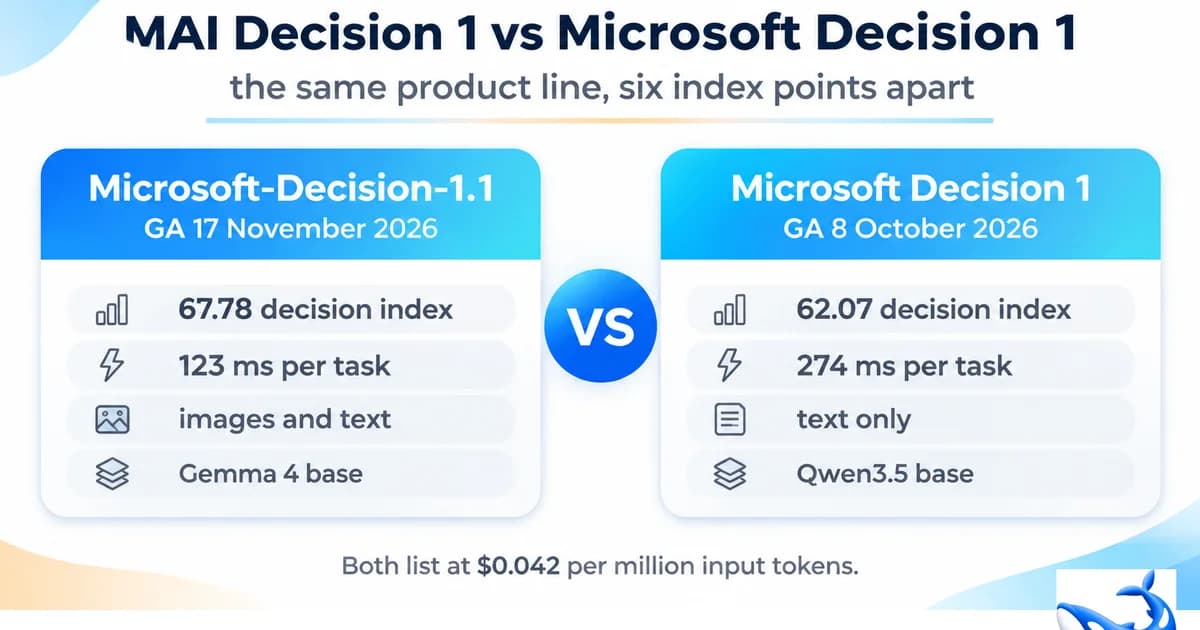
Это важно по одной практической причине: Microsoft-Decision-1.1 — не первая модель для принятия решений, выпущенная Microsoft. Microsoft-Decision-1 стала общедоступной в Foundry 8 октября 2026 года, была построена на базе Qwen3.5-9B от Alibaba, работала только с текстом и не имела опубликованных показателей производительности на момент запуска. То, что появилось 17 ноября, — это версия 1.1 той же линейки продуктов с другой базовой моделью, поддержкой мультимодального ввода и гораздо более подробной историей производительности. Считайте, что всё, что вы читаете о «MAI Decision 1», относится к версии 1.1, если не указано иное.
Что на самом деле внутри
Контракт по форме остался прежним, но стал значительно шире по охвату. Вы отправляете состояние — текст или JSON — плюс один или несколько типизированных вопросов, каждый с фиксированным набором вариантов, и получаете обратно вероятности вместо текста. Задокументированы три примитива вопросов: да/нет («noul» в API), выбор из помеченного набора и оценка по упорядоченным уровням, где возвращаемое значение — это средневзвешенное по вероятности значение индексов уровней. Всё в одном вызове, за один проход, без цикла декодирования.
Что нового в версии 1.1:
• Базовая модель — Gemma 4 26B-A4B, смесь экспертов с открытыми весами от Google, дообученная Microsoft. Версия 1 была дообучена на Qwen3.5-9B.
• Ввод — текст и изображения. Версия 1 работала только с текстом.
• Обработка изображений — PNG или JPEG, от 280 до 1568 пикселей по каждой стороне, до 8 изображений на вопрос, включая те, на которые есть ссылки в состоянии, с ограничением в 645 120 обработанных пикселей в сумме. Сервис меняет размер до фиксированного рабочего значения, поэтому загрузка большего изображения не потребляет больше токенов.
• Контекст — 32 768 входных токенов для комбинации состояния и вопроса, тот же потолок, что и в версии 1.
• Языки — обучение и оценка проводились на 25+ языках, при этом базовая модель поддерживает 35+. Microsoft прямо заявляет, что охват базовой модели не гарантирует подтвержденную калибровку для каждого языка.
• Обслуживание — эндпоинт для принятия решений, а не для чата: запросы направляются по адресу /providers/microsoft/v1/systemone в вашем ресурсе Foundry с именем развертывания в поле модели. Microsoft утверждает, что использует собственный движок вывода, написанный для рабочих нагрузок принятия решений, а не стек генерации текста.
• Цена — $0,042 за миллион токенов в Global Standard, $0,05 в зонах данных ЕС и Азиатско-Тихоокеанского региона. Столько же, сколько в версии 1, при этом вызовы принятия решений тарифицируются по входным токенам, так как выходных данных для оплаты практически нет.
• Окно обучения — с октября по ноябрь 2026 года, согласно карточке модели.
• Веса — отсутствуют. Это хостинговая модель в портфолио Foundry «Direct from Azure». Скачивание и дообучение не предусмотрены.
Исключения указаны так же четко, как и функции, и они по-прежнему определяют продукт. Microsoft-Decision-1.1 не предназначена для генерации текста, ответов на вопросы открытого типа, ведения диалога, перевода или суммаризации, а также для задач, требующих знаний, отсутствующих во входных данных. Она не предоставляет обоснований. Ответ содержит вероятности и ничего, что можно было бы показать пользователю в качестве объяснения, а это значит, что объяснение — ваша работа, а порог — ваше решение: 0,7 — эскалация, 0,95 — нет, и эта граница устанавливается приложением, а не вендором.
Два заявления о скорости и стоимости, и какое из них выдерживает проверку
Циркулирующая версия — «в 10 раз быстрее и в 200 раз дешевле, чем обычная модель» — не имеет под собой основы. Коэффициент по отношению к неназванной модели невозможно воспроизвести, а два опубликованных сравнения Microsoft, в которых что-то называется, одновременно более узкие и более масштабные.
В посте Ignite говорится, что Decision 1.1 «в 50 раз быстрее и в 79 раз дешевле, чем GPT-Sol 6.1». В посте о запуске Foundry говорится, что она «более чем в два раза быстрее нашей первой модели при той же стоимости», и приводится пример Copilot: маршрутизация между Copilot и Cowork с той же точностью, что и у большой языковой модели, в 2,2 раза быстрее и в 4,4 раза дешевле. Это измерения вендора на собственном трафике Microsoft и в собственной тестовой среде. Они не ошибочны, они ограничены рамками. Цифры 50x и 79x касаются одного конкурента в одном типе задач маршрутизации, а не моделей принятия решений в целом.
Одно из заявлений можно проверить с помощью третьей стороны, и оно подтверждается. Artificial Analysis оценивает Decision 1.1 в 123,25 миллисекунды на задачу в своем Decision Index v2.1 против 274,25 мс для Microsoft-Decision-1. Это 2,23 раза, что и означает «более чем в два раза быстрее». Заявление о стоимости также подтверждается, хотя и в ослабленном виде: AA вычисляет $139,64 за миллион задач для версии 1.1 против $142,56 для версии 1 — примерно на 2% дешевле, а не по той же цене, потому что две версии используют разное количество токенов на задачу даже при одинаковой ставке за токен. Фраза «при той же стоимости» верна в отношении прайс-листа, но немного оптимистична в отношении счета.
Какое место она занимает и в чем суть заявления Microsoft
В посте о запуске Microsoft говорится, что Decision 1.1 «набирает 68 баллов, что на шесть пунктов выше нашей первой модели и опережает Jev 1.14, Google Gemini Decision 1 и OpenAI GPT-6 Luna (Decisions)». В индексе Artificial Analysis Decision Index v2.1 на 18 ноября 2026 года всё это верно. Decision 1.1 имеет 67,78 балла. Jev 1.14 — 66,23, Gemini Decision 1 — 65,98, GPT-6 Luna — 60,25. Версия 1 имеет 62,07 балла, так что прирост на шесть пунктов также реален.
Чего не сказано в этом предложении, так это того, какое место модель занимает в общем списке. Она находится на восьмом месте, отставая на семь пунктов от абсолютного лидера и на полтора пункта опережая модель, которую назвала Microsoft:
• 74.85 — d1.2-ultra (Liquid AI)
• 72.62 — Drex Max v1.1 (Nace.AI)
• 72.58 — SubQ Snap 1.2 (Subquadratic)
• 72.52 — GLiDE v1.2 (Fastino)
• 71.36 — Mammoth 27B (Base Labs)
• 70.41 — Decider v1.3 (Perplexity)
• 68.69 — d1.2 (Liquid AI)
• 67.78 — Microsoft-Decision-1.1
Семь моделей набрали больше баллов, а лидер опережает на 7,1 пункта. Отдельное заявление Microsoft — о «наивысшей средней точности среди восьми моделей принятия решений» в рамках собственного внутреннего набора из 102 тестов и 385 000 вопросов — это утверждение относительно области, выбранной самой Microsoft, что является нормальной практикой для публикации вендором, но плохой для восприятия в качестве рейтинга. Независимый рейтинг включает восемнадцать моделей, и Microsoft находится в его верхней половине.
Промежуточные оценки более информативны, чем итоговая, поскольку они показывают, что именно дало дообучение. По шести составляющим оценкам AA модель Decision 1.1 набирает 95,1 балла в вызове инструментов When2Call, 88,8 в EvalSafe-O*NET, 75,7 в симметрии, 58,7 в принятии решений по документам AA-Paperclip, 60,5 во всезнании и 46,1 в тестах с множественным выбором HLE. Индекс точности составляет 48,45 против 40,59 у версии 1, а оценка Брайера — показатель калибровки, где чем ниже, тем лучше — улучшилась с 0,1965 до 0,1604. Это изменение показателя Брайера — самая значимая цифра в релизе: она говорит о том, что вероятности стали ближе к истинным, что является единственным свойством, делающим установку пороговых значений для модели принятия решений разумным инженерным выбором.
Смена базовой модели — вот в чем суть
Версия 1 была результатом дообучения Qwen3.5-9B, плотной модели на 9 млрд параметров. Версия 1.1 — это дообучение Gemma 4 26B-A4B, смеси экспертов (MoE) с примерно 4 млрд активных параметров. Собственное объяснение Microsoft касается экономики обслуживания, а не качества: достаточно активных параметров для суждения, при этом модель достаточно мала, чтобы работать на парках A100, H100/200 и GB200/300, с кастомным движком, который распределяет запросы по пулу GPU исходя из стоимости, а не только задержки.
Из этого следуют три вывода, которые важны для платформенной команды. Во-первых, MoE с 4 млрд активных параметров дешева в обслуживании на один вызов именно потому, что большая часть модели простаивает — именно отсюда берутся 123 мс. Во-вторых, смена модели обнуляет историю с языками и калибровкой: база изменилась, заявление о 25 языках относится к новой базе, а любая калибровка, измеренная вами на версии 1, не переносится. В-третьих, лицензия на базу принадлежит Google, в то время как дообученная модель принадлежит Microsoft и доступна только через хостинг — так что открытые веса исходной модели не дают вам никаких операционных преимуществ. Вы не можете скачать эту модель, и то, что база открыта, этого не меняет.
Сколько стоит вызов в единицах, которые вы реально оплачиваете
При цене $0,042 за миллион входных токенов вызов маршрутизации, содержащий тикет на 1200 токенов и вопрос с тремя вариантами ответа, стоит около $0,00005 — пять сотых цента. Миллион таких вызовов стоит примерно $50 по прайс-листу; измеренная AA стоимость в $139,64 за миллион задач выше, потому что их задачи длиннее, чем тикет поддержки, что служит полезным напоминанием: цены за токен и стоимость за задачу — это разные единицы измерения, и именно вторая фигурирует в бюджетном отчете.
Сравнение, которое делает экономику понятной, — это сопоставление с общей моделью, выполняющей ту же работу в режиме JSON. Вы платите за выходные токены, которых для структурированного ответа требуется от десятков до сотен на вызов, а не ноль, и вы платите за рассуждения, которые она проводит перед ответом. Это тот самый разрыв, который Microsoft описывает как 79-кратный, и он реален, даже если точный коэффициент — это выбор базовой линии вендором.
Сложности возникают там же, где и всегда с хостинговым решением от одного вендора: есть один прайс-лист, один лимит запросов и одна история с регионами. Foundry предлагает развертывания Global Standard и Data Zone Standard, причем вариант Data Zone стоит на 19% дороже — $0,05 за миллион токенов. Если ваша рабочая нагрузка чувствительна к задержкам, документация рекомендует размещать ресурс Foundry в одном месте с вашим приложением, что является честным советом, который также говорит о том, что модель — не магия, а небольшая MoE за очередью.
Как получить доступ, не перестраивая стек
Сам эндпоинт принятия решений отсутствует в каталоге OrcaRouter, как и его предшественник — Microsoft поставляет эту модель только через Foundry. Что есть в каталоге по цене провайдера с 0% наценкой — это два объекта, которые нужны для оценки решения перед покупкой. Gemma 4 26B A4B — это база для дообученной модели, маршрутизация стоит $0,25 за миллион входных токенов и $2,90 за миллион выходных; это база, а не дообученная модель, поэтому она не вернет откалиброванные вероятности Decision 1.1, но это та же архитектура и честный нижний порог стоимости общей модели такого типа. Jev 1.14, которую Microsoft называет и обходит на 1,55 пункта в независимом рейтинге, стоит $0,042 за миллион токенов на вход и выход.
Эта комбинация полезна для этапа оценки, а не для продакшена. Если вы решаете, стоит ли вообще включать модель принятия решений в путь маршрутизации, вы можете протестировать два маршрутизируемых эндпоинта на своих размеченных тикетах через один ключ с автоматическим переключением между провайдерами, прежде чем открывать развертывание в Azure. Если ответ «да» и цифры в пользу Decision 1.1, вы развертываете ее в Foundry и оставляете маршрутизатор перед ней — один эндпоинт как для вызовов принятия решений, так и для генеративных вызовов, чтобы лимит модели принятия решений не стал причиной простоя вашего приложения.
Кому стоит переходить сейчас, а кому подождать пару недель
Переходите сейчас, если вы уже платите общей модели за классификацию, оценку или фильтрацию, и ваш объем достаточно велик, чтобы стоимость одного вызова была заметна на графике. Медианное время 123 мс и цена $0,042 — это явное преимущество перед фронтирной моделью, выполняющей то же суждение, а мультимодальный ввод — это разница между оценщиком, которому можно показать скриншоты, и тем, которому нельзя.
Подождите, если ваше решение затрагивает людей — кредит, трудоустройство, жилье, страхование, здравоохранение, юридические вопросы — потому что в собственной карточке Microsoft сказано не использовать ее в качестве единственного лица, принимающего решения, и в версии 1.1 ничего не изменилось. Подождите также, если вам нужна калибровка, которую вы можете обосновать: показатель Брайера 0,160 у версии 1.1 — это улучшение, а не гарантия, и в документации прямо сказано, что оценки меняются в зависимости от формулировок и порядка вариантов. Проводите валидацию на своих метках, рандомизируйте порядок вариантов и устанавливайте пороги исходя из стоимости двух типов ошибок, а не на основе графиков вендора.
Честное резюме от 17 ноября короче и полезнее, чем заголовок про 200-кратное преимущество: Microsoft выпустила более быстрый, мультимодальный и лучше откалиброванный оценщик решений по цене, которая делает суждение по каждому запросу доступным, и он достаточно хорош, чтобы находиться в верхней половине независимого рейтинга, а не на его вершине. Модель реальна. Соотношение в твите — нет.