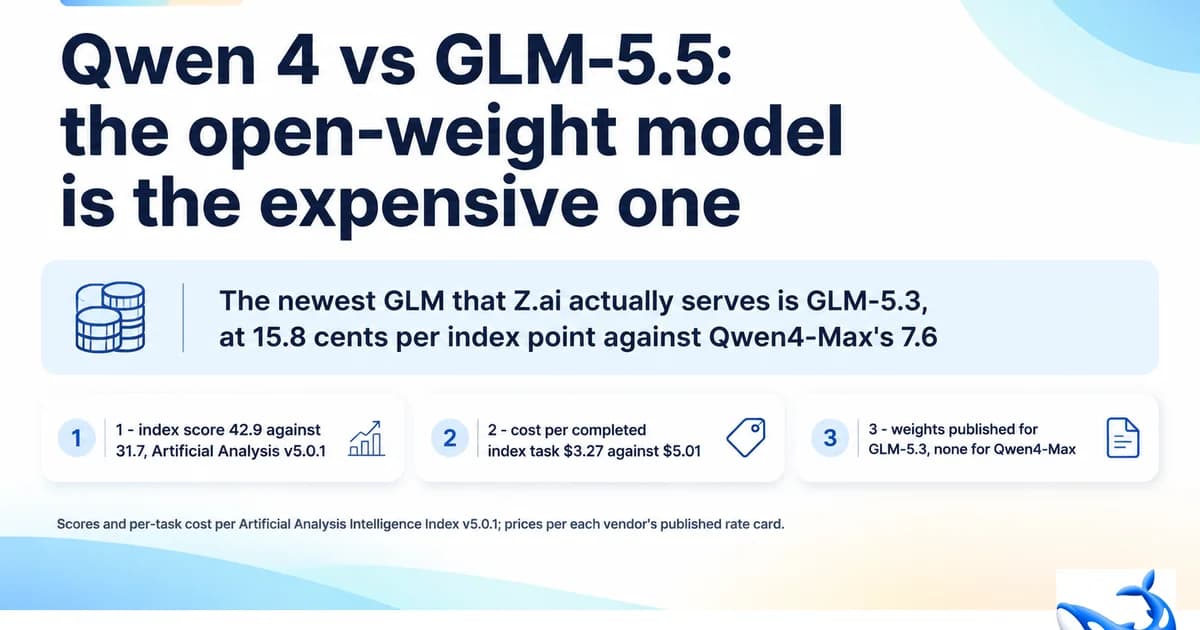
Существует интуитивное представление о том, что модели с открытыми весами — это более дешевый вариант. В данном сравнении это не так. GLM-5.3, новейшая модель GLM, которую действительно предоставляет Z.ai, обходится в 5,01 доллара за выполнение набора тестов Artificial Analysis и набирает в нем 31,7 балла — 15,8 цента за один индексный балл. Qwen4-Max стоит 3,27 доллара за 42,9 балла — 7,6 цента за балл. Проприетарная модель более чем в два раза эффективнее в пересчете на единицу измеренной производительности, и именно ее вы не можете скачать. Тем временем GLM-5.5, модель из заголовка этой статьи, не существует: индекс документации и страница с ценами Z.ai заканчиваются на GLM-5.3, а пути к документации 5.4 и 5.5 возвращают ошибку «не найдено». Таким образом, ниже представлено сравнение с той версией GLM, которая доступна, а отсутствующий номер версии рассматривается как отсутствие версии, а не как спецификация, которую нужно выдумывать.
Во-первых, карта, которая существует
GLM-5.3 появилась 18 августа 2026 года под лицензией GLM-5.3, с опубликованными весами и поддержкой только текстового ввода. Qwen4-Max перешла на тарификацию 16 ноября 2026 года, она является проприетарной, поддерживает ввод изображений и доступна только через Alibaba Cloud. Эти две модели разделяют девяносто дней с момента выпуска, и они находятся по разные стороны границы между закрытыми и открытыми системами, что и является основной темой этой статьи.
• Цена за миллион токенов — GLM-5.3: 1,40 $ на вход / 4,40 $ на выход; Qwen4-Max: 1,50 $ / 4,50 $ в Сингапуре, 1,413 $ / 4,24 $ в других регионах. По тарифам на токены Z.ai является более дешевым вариантом на 7% и 2%.
• Кэшированный ввод — GLM-5.3: 0,26 $ за миллион при чтении; Qwen4-Max: 0,075 $, при этом запись в кэш стоит 1,875 $ за пять минут и 3,00 $ за час. Чтение из кэша у Qwen в 3,5 раза дешевле, именно поэтому результаты для конкретной задачи и результаты в пересчете на токен указывают в разных направлениях.
• Контекст — 1 000 000 токенов у обеих моделей. GLM-5.3 ограничивает вывод 128 000 токенов; Qwen4-Max позволяет использовать 131 072 без «размышлений» или 262 144, распределенных между рассуждением и ответом.
• Веса — у GLM-5.3 опубликованы под собственной лицензией; у Qwen4-Max отсутствуют, доступна только у одного поставщика. В этом заключается вся разница, и все, что следует ниже, вытекает из этого факта.
• Модальность — Qwen4-Max принимает текст и изображения; GLM-5.3 работает только с текстом. Если ваш конвейер обработки данных использует скриншоты или PDF-файлы, на этом сравнение заканчивается.
• Управление рассуждением — GLM-5.3 всегда выполняет рассуждение с низким, высоким и максимальным уровнями усилий, по умолчанию используя максимальный; Qwen4-Max предлагает уровни «низкий», «высокий» и «сверхвысокий», по умолчанию используя «высокий».
• История обучения — Z.ai описывает GLM-5.3 как ту же базовую модель, что и GLM-5.2, улучшенную за счет пост-обучения, а не нового предварительного обучения. Это стоит учитывать при сравнении ее результатов с моделью, имеющей новую архитектуру.
Семь центов против шестнадцати: объяснение
Разрыв в стоимости за балл не является артефактом ценообразования. Стоимость GLM-5.3 в 5,01 доллара за задачу складывается из 4,49 доллара за ввод и 0,52 доллара за вывод — 90% приходится на ввод, из которых 4,13 доллара — это чтение из кэша. Стоимость Qwen4-Max в 3,27 доллара состоит из 2,80 доллара за ввод и 0,47 доллара за вывод, при этом 1,12 доллара приходится на чтение из кэша и 1,67 доллара — на запись в кэш. Таким образом, обе модели тратят почти ничего на генерацию токенов и почти все — на повторное чтение контекста.
Разница заключается в том, какой объем контекста потребляет каждая модель для получения ответа. GLM-5.3 считывает 10,3 миллиарда входных токенов по всему набору тестов и выдает 135 миллионов выходных токенов; Qwen4-Max считывает 9,9 миллиарда и выдает 127 миллионов. Объем практически идентичен. Следовательно, разрыв в девятнадцать баллов — это не вопрос объема, а просто результат того, что одна модель лучше справляется с задачами, а разница в стоимости за задачу возникает из-за тарифов на кэш, где чтение за 0,075 $ против чтения за 0,26 $ суммируется на десяти миллиардах токенов.
Это механизм, который стоит запомнить: при выполнении бенчмарков с длинным контекстом счет формирует тариф на чтение кэша, а не базовая ставка за ввод. Модель с ценой 1,40 $ на вход и 0,26 $ за чтение кэша может стоить дороже за задачу, чем модель с ценой 1,50 $ на вход и 0,075 $ за чтение кэша.
Где находятся эти девятнадцать баллов
• Terminal-Bench 4.0 — Qwen4-Max 48,5%, GLM-5.3 41,9%. Семь баллов, самый близкий результат среди агентских наборов тестов.
• FrontierCode 2.0 — 26,5% против 21,6%. Пять баллов; обе модели здесь слабы в абсолютном выражении.
• HLE Diamond — 44,9% против 17,9%. Двадцать семь баллов, самый большой разрыв в сравнении.
• Omniscience — 27,7 против 6,0, с уровнями галлюцинаций 28,4% и 38,9% соответственно. GLM-5.3 одновременно менее точна и менее склонна воздерживаться от ответа, что является худшим сочетанием.
• Подбаллы по возможностям — Qwen4-Max лидирует во всех пяти категориях, которые сообщают обе модели: инженерия 50,1 против 37,6, финансы и бухгалтерский учет 54,1 против 42,1, право 49,6 против 35,8, стратегия и операции 56,9 против 47,4, экономика 51,3 против 37,3.
Ни один из показателей в этом списке не является достаточно близким, чтобы спорить о нем. Интересный вопрос не в том, лучше ли Qwen4-Max, потому что это очевидно.
Единственное, чего не может Qwen4-Max
Каждая строка выше — это сравнение возможностей, но возможности — это неверная рамка, когда одну из двух моделей можно забрать домой. Z.ai публикует веса GLM-5.3 под своей лицензией; Alibaba не публикует ничего для Qwen4-Max и указывает только одного хостинг-провайдера. Эта разница меняет три вещи, которые не измеряет ни один бенчмарк.
• Непрерывность — модель, которую вы размещаете сами, продолжает отвечать, даже если у поставщика меняется страница с ценами, регион выводится из эксплуатации или приходит уведомление о прекращении поддержки. У Qwen4-Max есть прецедент от 25 ноября 2026 года: идентификатор предварительной версии был отозван через девять дней после общего выпуска, и любая конфигурация, все еще указывающая на qwen4-max-preview, перестала работать.
• Кривая затрат — предельные издержки GLM-5.3 становятся вашими затратами на использование GPU. При стабильно высоком объеме это обычно ниже, чем тариф API; при редком и низком объеме — хуже. Точка пересечения — это расчет использования, а не качества модели.
• Контроль — дообучение (fine-tuning), квантование, выбор ядра и возможность проверять, что делает модель. Ничего из этого не существует для Qwen4-Max.
Противопоставление: открытая модель слабее на девятнадцать индексных баллов, хуже справляется с воздержанием от ответа и «слепа» к изображениям. Для нового проекта такой обмен выглядит непривлекательно. Для системы, уже построенной вокруг стека инференса с самостоятельным хостингом — где альтернативой GLM-5.3 является не Qwen4-Max, а предыдущая версия GLM — лицензия становится решающим фактором, а разрыв в баллах — издержками ведения бизнеса.
Почему открытая модель — самая дорогая, в одном предложении
Потому что открытые веса переносят затраты с счетчика токенов в инженерный бюджет, а инженерный бюджет не отображается в прайс-листе. Развертывание GLM-5.3 на собственном оборудовании означает планирование мощностей, стек обслуживания, который вы можете исправлять, и систему оценки, достаточно хорошую, чтобы сказать вам, соответствует ли ваше развертывание эталону — затраты, которые превышают разницу в 3,27 доллара за задачу при любом объеме, который выполняет одна команда. 15,8 цента за индексный балл — это видимая цифра; невидимая — больше, и она оплачивается один раз, независимо от того, обслуживаете ли вы тысячу запросов или миллион.
Этот расчет меняется в масштабе, и еще сильнее, если вам нужно дообучение. Дообучение — это единственное требование, которое делает открытую модель не просто дешевле, а единственным вариантом, и никакое лидерство Qwen4-Max в баллах не может его заменить.
Вызов той, которую можно маршрутизировать
GLM-5.3 представлен в нашем каталоге как z-ai/glm-5.3 по прейскурантной цене Z.ai: 1,26 доллара за входные и 3,96 доллара за выходные токены на миллион, без каких-либо дополнительных наценок — по тем же тарифам, которые публикует Z.ai, включая любые их изменения. Qwen4-Max отсутствует в нашем каталоге; идентификатор qwen4 возвращает ошибку «не найдено», а его маршрут проходит через API Alibaba Model Studio и несколько сторонних платформ. Ближайшая модель Qwen, которую мы предоставляем, — это qwen/qwen3.8-max по цене 2,00 и 6,00 долларов.
Это оставляет практическую последовательность действий для тех, кому нужна более мощная модель без заключения второго контракта: запустите оценку на z-ai/glm-5.3 через уже имеющуюся у вас конечную точку, и если разрыв в девятнадцать пунктов критичен для вашего сценария использования, оцените стоимость Qwen4-Max исходя из вашего собственного соотношения токенов, а не индекса. Показатели для каждой задачи в этой статье смоделированы на основе тестового набора с необычно интенсивным кэшированием; рабочая нагрузка в реальных условиях с короткими запросами и длинными ответами значительно сократит разрыв между 5,01 и 3,27 долларами, поскольку почти вся сумма счета не будет приходиться на выходные данные.
Что нам нужно увидеть
GLM-5.5 изменит это сравнение, но на данный момент о ней нет никаких сведений — ни пути к документации, ни строки с ценами, ни идентификатора модели на собственных страницах Z.ai по состоянию на 17 ноября 2026 года. Если она выйдет, стоит задаться вопросами: публикует ли Z.ai веса, как это было с 5.3, добавляет ли она поддержку ввода изображений и исправляет ли поведение при отказе от ответа, поскольку именно последний показатель (38,9%) делает GLM-5.3 трудным для рекомендации в любых неконтролируемых сценариях, независимо от разрыва в индексе.
Тем временем честное резюме выглядит контринтуитивно и кратко. Открытая модель стоит дороже в пересчете на балл, показывает более низкие результаты во всех измеренных наборах тестов и остается правильным выбором только для одного типа покупателей: тех, чьим главным ограничением является лицензия, а не результаты тестирования.