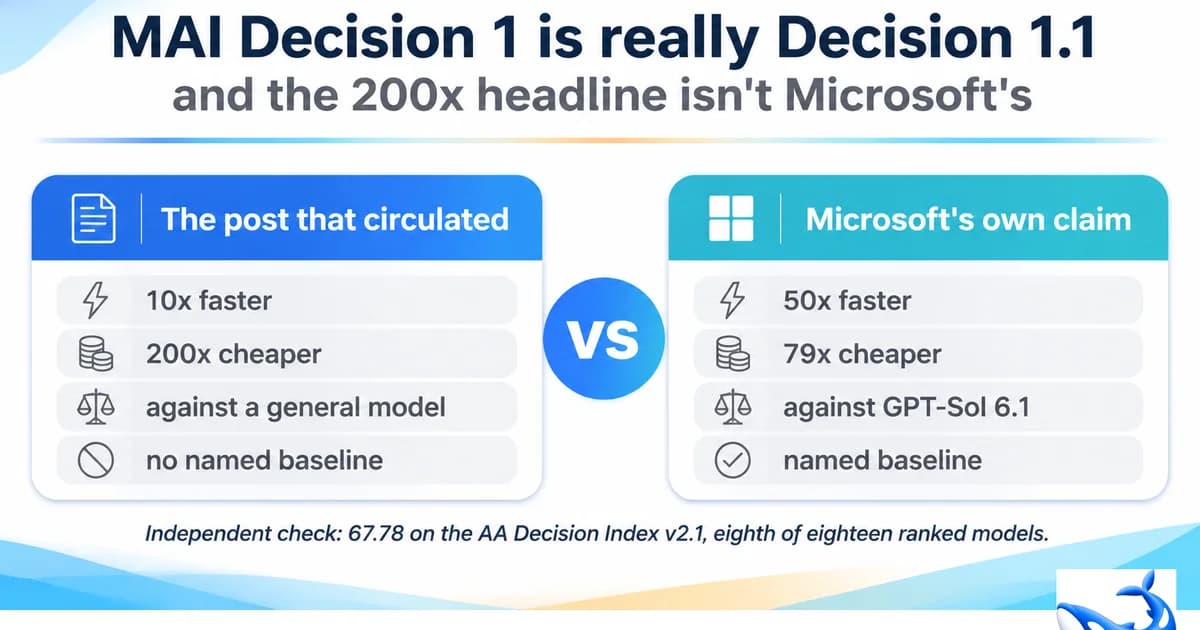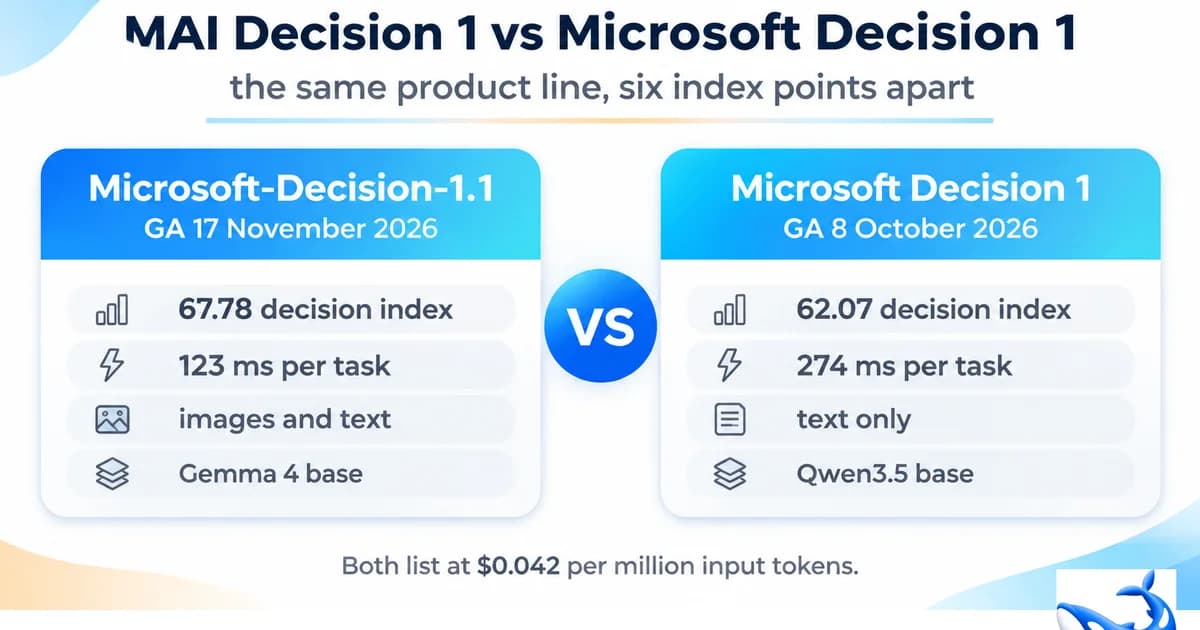
В этом сравнении есть подвох, и он кроется в самой предпосылке. MAI Decision 1 и Microsoft Decision 1 — это не две конкурирующие модели. Это одна и та же линейка продуктов Microsoft, различающаяся на одну версию: модель, которую в обзорах Ignite назвали MAI Decision 1, — это Microsoft-Decision-1.1, а Microsoft-Decision-1 — это октябрьский релиз, который она заменяет. Таким образом, полезное сравнение заключается не в том, «какой вендор победит», а в том, «что дали пять недель и новая базовая модель, и стоит ли обновление миграции для тех, кто уже использует старую конечную точку в продакшене». Краткий ответ: шесть индексных пунктов, задержка в два раза меньше, поддержка ввода изображений и прайс-лист, который не изменился.
Именование, раз и навсегда
Название слева в этом сравнении взято из освещения ключевого доклада, а не от Microsoft. Собственные строки вендора — «Decision 1.1» в анонсе линейки Ignite и «Microsoft-Decision-1.1» в блоге Foundry и карточке модели; префикс MAI перекочевал вместе с MAI Code 2 и MAI Cyber 2 Flash через одни и те же сторонние статьи и закрепился. Поэтому на этой странице сравниваются версия 1.1 и версия 1 одной линейки продуктов, и интересный вопрос заключается не в том, какой вендор победит, а в том, что изменили пять недель и другая базовая модель.
Версия 1 не была отозвана. Она по-прежнему числится в Foundry и по-прежнему оценивается независимым советом, поэтому два названия продолжают появляться рядом в сравнительных таблицах — иногда как соперники от разных компаний, которыми они не являются.
Шесть недель, две модели, одна цена
Версия 1 стала общедоступной (GA) 8 октября 2026 года: это текстовая модель, прошедшая дообучение на базе Alibaba Qwen3.5-9B, с калиброванными вероятностями по фиксированному набору опций, ограничением в 32 768 токенов, без весов и без опубликованных показателей бенчмарков. Версия 1.1 появилась 17 ноября с базой Gemma 4 26B-A4B, поддержкой ввода изображений и полноценным отчетом о производительности — при этом прайс-лист остался на прежнем уровне: $0,042 за миллион токенов.
• Базовая модель — Qwen3.5-9B, плотная, 9B параметров против Gemma 4 26B-A4B, смесь экспертов (MoE) с примерно 4B активных параметров; обе дообучены собственными силами
• Модальность — только текст против текста, JSON и изображений PNG/JPEG, до 8 на вопрос
• Ограничение ввода — 32 768 токенов против 32 768 токенов, без изменений
• Типы вопросов — да/нет, множественный выбор, рейтинг, классификация, рубрикатор против того же набора, представленного в виде трех типизированных примитивов (noul, choice, score)
• Цена — $0,042/млн токенов Global Standard, $0,05 EU и APAC против идентичной
• Измеренная задержка — 274,25 мс на задачу против 123,25 мс на задачу, Artificial Analysis
• Измеренная стоимость — $142,56 за миллион задач против $139,64 за миллион задач, Artificial Analysis
• Decision Index v2.1 — 62,07 против 67,78
• Веса — отсутствуют, размещены только в Foundry против отсутствуют, размещены только в Foundry
Единственный показатель, который не изменился, — это тот, на который ориентируется большинство команд при планировании бюджета, а тот, который изменился больше всего, — это тот, который никто не рекламирует: задержка сократилась вдвое, в то время как цена за токен осталась прежней, поскольку новая база представляет собой разреженную модель, которая выполняет гораздо меньше работы на каждый вызов.
Из чего складываются эти шесть пунктов
Совокупный разрыв в 5,71 пункта распределен неравномерно, и эта неравномерность показывает, для каких рабочих нагрузок было создано обновление. Согласно шести составляющим оценкам Artificial Analysis на 18 ноября 2026 года:
• When2Call (вызов инструментов) — 95,1 в версии 1.1 против 87,9 в версии 1, прирост на 7,1 пункта, что важно для ограничений агентов
• EvalSafe-O*NET (оценка суждений на рабочем месте) — 88,8 против 86,8
• AA-Symmetry (инвариантность решений при перефразировании) — 75,7 против 70,4
• AA-Paperclip (документальные решения) — 58,7 против 51,8, самый большой абсолютный скачок
• AA-Omniscience (знания и галлюцинации) — 60,5 против 54,9
• HLE (рассуждение с множественным выбором) — 46,1 против 39,4
Каждый подпункт улучшился, что необычно и делает совокупный показатель заслуживающим доверия; совокупный индекс, который растет по одной оценке и падает по двум, обычно является артефактом взвешивания. Прирост инвариантности — это тихий показатель, который стоит отметить. Симметрия измеряет, сохраняется ли решение при изменении порядка опций или перефразировании вопроса — именно тот тип сбоев, о котором предупреждает документация Microsoft, и именно то свойство, которое определяет, будет ли порог, настроенный вами в стейджинге, срабатывать в продакшене. Переход с 70 на 76 по этому показателю — это более значительное операционное изменение, чем переход с 62 на 68 в заголовке.
Калибровка улучшилась в том же направлении. Оценка Брайера, которая измеряет квадратичный разрыв между заявленной вероятностью и истиной, упала с 0,1965 до 0,1604 — чем ниже, тем лучше. Точность выбранного варианта выросла с 40,6 до 48,5. Оба числа являются измерениями Artificial Analysis, выполненными на собственных задачах, а не Microsoft, что является причиной доверять им: собственная оценка Microsoft для версии 1.1 составляет 68 баллов, «на шесть пунктов выше нашей первой модели», и независимый совет приходит к результату 67,78 с приростом в 5,71 пункта, что находится в пределах полупункта от этого значения. Впервые вендор и аудитор в целом согласны.
Когда старая модель все еще является правильным выбором
Существует три веские причины остаться на Microsoft-Decision-1, и ни одна из них не связана с производительностью.
Первая — это замороженная оценка. Если вы откалибровали пороги относительно версии 1 на своих собственных размеченных данных — а вы должны были это сделать, — то изменение базовой модели аннулирует эту работу. Плотная модель 9B, дообученная для оценки, и 26B MoE, дообученная для оценки, дают сбои в разных местах, и в документации к 1.1 прямо указано, что калибровка наиболее сильна на знакомых типах задач и может меняться в зависимости от формулировок. Повторная настройка — это реальные затраты, и они ложатся на команду, а не на вендора.
Вторая — это языковой охват. Версия 1 имела историю дообучения на 25 языках на базе Qwen, поддерживающей более 200 языков. Версия 1.1 имеет историю на 25+ языках на базе Gemma, документированной как поддерживающая 35+. Двадцать пять плюс — это не двадцать пять, и если вы используете многоязычную очередь, честный подход — протестировать, а не предполагать, что число увеличилось.
Третья — это форма вашей зависимости. Обе версии доступны только через хостинг, от одного вендора, с одним прайс-листом и одним режимом ограничения скорости. Обновление меняет вашу область сбоев, не уменьшая ее. Если вы уже обернули конечную точку собственным механизмом отката, то использование версии 1 стоит вам задержки и точности, но не доступности; если нет, то обновление дает вам более быструю модель за той же единственной точкой отказа.
Запуск двух моделей параллельно перед принятием решения
Сама миграция невелика, и это приятная часть. Форма конечной точки не изменилась — состояние плюс типизированные вопросы к маршруту принятия решений на ресурсе Foundry — и развертывание представляет собой изменение версии модели, а не переписывание интеграции. Что меняется, так это все, что идет после ответа: вероятности, пороги и подпункты, указанные выше.
Поэтому запустите обе. Отправьте одну и ту же размеченную партию в оба развертывания, сравните точность выбранного варианта при пороге, который вы действительно используете, и посмотрите конкретно на «хвосты» — случаи, когда версия 1 возвращала 0,55, а версия 1.1 возвращает 0,88, — именно они незаметно изменят ваш уровень эскалации. Прирост симметрии предполагает, что 1.1 должна быть более стабильной при изменении порядка опций; проверьте это на своих собственных промптах, а не доверяйте цифрам.
Судья и объект оценки в рамках одного ключа — это конфигурация, к которой в конечном итоге стремятся многие команды, но ни одна из моделей Decision не может ее обеспечить: обе они являются конечными точками, размещенными исключительно в Foundry, поэтому маршрутизатор перед ними — это ваш собственный код. Тем временем маршрутизатор может предоставлять элементы управления. Gemma 4 26B A4B — базовая версия, на основе которой была выполнена пост-тренировка 1.1 — маршрутизируется через OrcaRouter по цене 0,25 доллара за миллион входных токенов и 2,90 доллара за миллион выходных, а Jev 1.14, модель принятия решений, по которой Microsoft оценивает себя, — по 0,042 доллара за миллион входных и выходных токенов. Ни одна из них не воспроизводит откалиброванные ответы версии 1.1. Обе они показывают, приближается ли общая модель на ваших собственных данных к модели принятия решений в пределах нескольких пунктов, что и является вопросом, определяющим, нужна ли вам такая модель вообще.
Вопрос о версии: ответ найден
Если вы делаете выбор сегодня и у вас нет устаревших пороговых значений, которые нужно защищать, выбирайте 1.1. Согласно независимым измерениям, она работает в 2,2 раза быстрее, немного дешевле в расчете на задачу, лучше откалибрована, эффективнее справляется с управлением вызовами инструментов и является единственной из двух, способной считывать скриншоты. Прайс-лист идентичен, поэтому обновление является бесплатным с точки зрения маржинальных затрат.
Если вы уже используете версию 1 в продакшене, обновление стоит выполнить, хотя оно и не является срочным в том смысле, в каком срочны патчи безопасности. Заложите бюджет на повторную настройку, сохраняйте старое развертывание активным до тех пор, пока новые пороговые значения не подтвердят свою эффективность на реальном трафике, и рассматривайте улучшение симметрии как причину ожидать меньше сюрпризов, а не как гарантию их полного отсутствия.
Это сравнение — не выбор между поставщиками. Оба названия указывают на линейку решений Microsoft, разделенных пятью неделями и одной базовой моделью, при той же цене 0,042 доллара за миллион токенов. Интересный вопрос никогда не заключался в том, кто победит; он в том, достаточно ли хороша вторая модель, чтобы оправдать затраты на перекалибровку. Согласно независимой оценке, да, достаточно.