Введение
У пользователей есть специфические для их рабочих процессов предпочтения и требования, о которых модель общего назначения не может знать заранее. Агенту необходимо изучать эти детали, чтобы адаптировать свою работу под пользователя, а не требовать от него объяснения одной и той же процедуры или внесения одних и тех же правок в каждой сессии. Непрерывное обучение (continual learning) делает это возможным: опыт выполнения прошлых задач должен определять, как агент подходит к будущей работе.
Brain, персонализированная система самосовершенствования Computer, обеспечивает обучение на основе опыта. Она уже ведет структурированную базу знаний (wiki), которая связывает информацию о пользователе и его работе с подтверждающими ее фактами. Фоновые агенты обновляют wiki по мере накопления новой информации, благодаря чему система памяти со временем улучшается.
Навыки агента (agent skills) предоставляют еще один способ направлять поведение агента без изменения базовой модели. Навыки — это переиспользуемые инструкции, которые ведут агента через конкретные задачи. Они фиксируют требования и вспомогательные ресурсы для повторяющихся рабочих процессов, которые в противном случае агенту приходилось бы каждый раз извлекать из памяти или получать от пользователя, что повышает производительность при выполнении задач вне привычного распределения (out-of-distribution). Они также могут включать скрипты для повторяющихся процедур или обработки, которые можно надежно выразить в коде, чтобы агент мог просто запускать их при необходимости. Среда выполнения (harness) делает доступные навыки обнаруживаемыми и загружает их инструкции в контекст по запросу агента. Пользователи также могут напрямую указывать в промпте, какие навыки следует использовать.
Мы расширяем возможности Brain, чтобы автоматически создавать и обновлять навыки агента. Brain опирается на память и историю сессий пользователя, создавая и дорабатывая персональные навыки, отражающие процедуры для рабочих процессов этого пользователя. Мы применяем аналогичный подход для обновления встроенных навыков (built-in skills), доступных каждому пользователю Perplexity, на основе агрегированных закономерностей по всем сессиям.
Сначала мы опишем наш общий движок самосовершенствования, используемый для всех типов навыков, и объясним, как он работает для персональных и встроенных навыков.
Общий движок самосовершенствования
Полезный навык всё равно должен меняться по мере появления новых предпочтений или обнаружения пробелов в его инструкциях на основе опыта. Brain отвечает за выявление того, как должно измениться поведение агента в следующий раз, когда Computer столкнется с аналогичной задачей, и за определение того, как должен измениться навык для лучшего достижения желаемого результата.
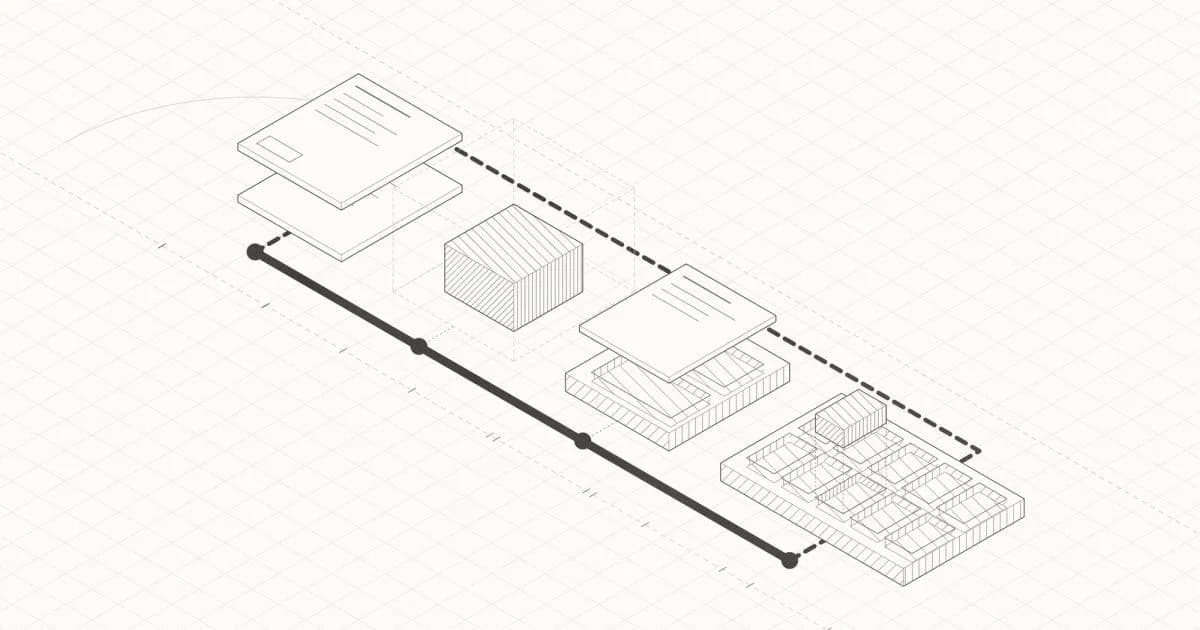
Этот процесс улучшения образует цикл из четырех этапов:
- Доказательства (Evidence). Brain находит прошлые сессии, в которых использовался навык, особенно те, где результат был неудовлетворительным.
- Рефлексия (Reflection). Агент улучшения изучает эти доказательства и предлагает обновления для навыка.
- Проверка (Verification). Проверки подтверждают, что предложение корректно сформулировано и с высокой вероятностью улучшит результаты.
- Активация (Activation). Проверенное изменение применяется. В будущих сессиях используется новая версия, что дает доказательную базу для следующего итерационного цикла.
Этот цикл опирается на множество существующих возможностей, созданных для Computer и Brain. Здесь мы описываем общие механизмы, обеспечивающие сбор доказательств и рефлексию. Процедуры проверки и активации зависят от того, затрагивает ли изменение одного пользователя или каждого пользователя Perplexity, поэтому мы рассмотрим их в следующих разделах, посвященных циклам улучшения персональных и встроенных навыков.
Доказательства из прошлых сессий
Для рефлексии требуется поиск сессий, в которых использовался навык, особенно тех, где есть задел для улучшения. Среда выполнения (harness) Computer записывает сигналы, которые делают это возможным. Когда агент загружает навык, harness фиксирует событие загрузки навыка (skill-load event), связывающее навык с сессией. Когда агент замечает недовольство пользователя, некорректное поведение или очевидную неэффективность, он формирует краткую структурированную диагностику, а harness прикрепляет используемые навыки. Это особенно полезно для встроенных навыков, где потенциально релевантной может быть любая сессия, поэтому системе нужен способ быстро сузить пул доказательств.
Агентам выгодно иметь доступ к полной записи, а не делать выводы только на основе итогового результата или краткого резюме. Computer сохраняет прошлые сессии с использованием независимых от провайдера представлений траекторий, которые фиксируют сообщения, вызовы инструментов, рассуждения и результаты. Мы также разработали набор инструментов командной строки, которые агенты могут использовать для декодирования этих траекторий и восстановления полных сессий. Это позволяет агенту рефлексии анализировать конкретные загрузки навыков и вызовы инструментов, определяя точные моменты, где возникли проблемы или могут быть внесены улучшения.
bash
# Декодировать сохраненную траекторию в структурированные сообщения, # включая вызовы инструментов, их аргументы и результаты. python3 deserialize_trajectory.py \ --convo-path session/convo.pb.lz4 \ --jsonl -o session.jsonl # Определить, какие навыки загружал агент и как часто. python3 list_skills_used.py session.jsonl # Подробно прочитать один ход, включая вызовы инструментов и результаты. python3 deserialize_trajectory.py \ --convo-path session/convo.pb.lz4 \ --turn 3 -o turn-3.md # Восстановить более ранние шаги, сохраненные до сжатия контекста. python3 deserialize_trajectory.py \ --convo-path session/compactions/001/original_convo.pb.lz4 \ --jsonl -o earlier-history.jsonl
Пример использования внутренних инструментов инспектирования траекторий в Computer. Пути и идентификаторы упрощены для иллюстрации; имена команд и аргументы соответствуют реализации.
Рефлексия с помощью фоновых агентов
Brain использует команду фоновых агентов для непрерывной оптимизации взаимодействия с каждым пользователем. Например, агенты Dream анализируют накопленный опыт для обновления базы знаний wiki. Аналогичным образом улучшение навыков осуществляется агентами улучшения, которые рефлексируют над доказательствами использования навыков для предложения обновлений.
Каждый агент работает в своей изолированной среде (sandbox) с передовой моделью (frontier model), релевантными доказательствами и текущей библиотекой навыков, руководствуясь плагинами и навыками. Он решает, какие сессии читать, извлекает из каждой конкретный урок и группирует уроки, требующие одинакового повторно используемого поведения. Поскольку исправление одной ошибки может противоречить другой инструкции или добавить работы в другом месте, он считывает полный навык перед предложением правки и воздерживается от изменений, если доказательства их не подтверждают.
Агенты улучшения работают в той же среде выполнения (harness), что и Computer. Мы сделали harness модульным, поэтому новое приложение-агент может повторно использовать его механизмы для рассуждений, использования инструментов и управления контекстом, определяя при этом свои собственные инструкции и возможности через плагины. Выделенный парк фоновых воркеров позволяет нам масштабировать эту обработку независимо от основных задач.
Цикл улучшения персональных навыков
Сначала мы опишем, как общий движок самосовершенствования применяется к циклу персонального улучшения, который превращает историю задач пользователя в новые или обновленные персональные навыки. На рисунке ниже показан пример прохождения навыка через полный цикл, заканчивающийся обновленной версией.
Во время ежедневного запуска генерации агент по улучшению просматривает недавние сессии пользователя, чтобы определить изменения, которые стоит внести. Набор недавних сессий вместе с данными об использовании навыков предварительно загружается в «песочницу»; остальную историю сессий пользователя можно получить по мере необходимости. Агент по улучшению также получает каталог существующих навыков. У него нет доступа к интернету или другим коннекторам.
Плагины и навыки, разработанные для рабочего процесса улучшения личных навыков, направляют процесс рефлексии, опираясь на наши принципы того, что делает обновление качественным. Сначала агент анализирует полные траектории, чтобы выявить конкретный урок в каждой сессии. Затем он сравнивает эти уроки с существующими инструкциями и решает, нужно ли обновить навык, создать новый или оставить всё как есть. Создание навыка требует двух независимых случаев проявления одного и того же воспроизводимого поведения, в то время как обновление существующего навыка может быть обосновано одним подтвержденным случаем.
Агент не изменяет навык напрямую. Вместо этого он создает предложение, записывая предполагаемые изменения, а также обоснование и доказательства в их поддержку. Обновления ограничены одним изменением за один навык на один запуск. Детерминированные проверки подтверждают, что предложения составлены корректно и могут быть применены к навыку. Отдельно LLM-судья проверяет выборочные предложения, оценивая, подтверждают ли доказательства необходимость изменения и предоставляет ли полученный навык полезные инструкции.
Активация превращает проверенное предложение в изменение библиотеки навыков пользователя, поэтому новая версия может быть загружена и использована в будущих сессиях. Поскольку система загружает индекс всех доступных навыков в начале каждой сессии, большая библиотека навыков может перегрузить контекстное окно и затруднить поиск и загрузку нужных навыков агентом. В результате система сохраняет только самые ценные навыки, удаляя те, которые не являются необходимыми, чтобы поддерживать небольшую, отобранную библиотеку. В частности, мы устанавливаем ограничение в 10 автоматически созданных навыков на пользователя. При достижении лимита агент по улучшению всё ещё может обновлять или удалять навыки, но для добавления нового навыка он должен удалить существующий и обосновать, почему новый навык более полезен для работы пользователя.
Встроенный цикл улучшения навыков
Мы также расширяем структуру непрерывного улучшения навыков Brain на встроенные навыки. Вместо того чтобы использовать память и историю сессий одного пользователя для улучшения его личных навыков, встроенный цикл использует данные многих пользователей для улучшения навыков, доступных каждому пользователю Perplexity. Поскольку встроенные навыки могут использоваться кем угодно, требования к изменениям высоки; обновления, которые непреднамеренно ухудшают производительность, могут повлиять на тысячи сессий. Встроенный агент по улучшению изменяет только версии-кандидаты навыков. Чтобы достичь канонической версии навыка, эти обновления должны пройти через парное воспроизведение и внутреннюю проверку человеком. Мы снова прослеживаем полный цикл на примере навыка и подтверждающих доказательств.
Встроенный цикл улучшения использует очищенные данные из сессий, подходящих для использования в обучении. Диагностика и сигналы об ошибках используются для выбора релевантных доказательств, наряду с контрольными сессиями, где навык использовался без каких-либо проблем. Конвейер очистки удаляет учетные данные и другие секреты, а также прикрепленные файлы и медиа.
Агент генерации сценариев превращает очищенные доказательства в конкретные сценарии сбоев. Он сохраняет только контекст, необходимый для понимания случая сбоя и улучшения навыка; остальная часть сессии воссоздается синтетически, создавая автономный тест для процесса верификации. Сценарии должны запускаться без подключенных приложений или входа в систему; если исходная задача зависела от коннектора, этот ввод заменяется синтетическими файлами в сценарии. Отдельная проверка подтверждает, что навык дает сбой в сгенерированном сценарии.
Рефлексия происходит посредством еженедельной задачи по пересмотру, которая превращает наблюдаемые сбои в исправления. Она ищет сбои навыков, которые повторяются в нескольких сессиях, поэтому один неудачный сеанс не приводит к правке. Каждый повторяющийся сбой получает отдельный запуск агента по улучшению. Агент получает описание первопричины вместе с очищенными записями из успешных сессий. Он использует эти доказательства для написания версии-кандидата навыка. Он не получает полные сценарии сбоев, так как они используются при оценке.
Отдельная задача воспроизведения использует сгенерированные сценарии для сравнения оригинальной и пересмотренной версий навыка. LLM-судья оценивает ответы и траектории агента по рубрикатору каждого сценария. Чтобы предложение было принято, каждый тестовый сценарий должен быть пройден с пересмотренным навыком, и как минимум один должен завершиться неудачей с оригинальным. Сценарии, построенные на основе контрольных сессий, также воспроизводятся, чтобы подтвердить, что ничего не перестало работать. Для сценариев сбоев судья также проверяет, что произошел именно конкретный сбой, а не просто рассматривает неудачную задачу как доказательство той же проблемы.
Рабочий процесс упаковывает изменения-кандидаты и результаты оценки в запрос на включение (pull request) для внутренней проверки человеком. Изменения вступают в силу только в том случае, если инженер одобряет PR.
Оценки
Автоматическое улучшение навыков значительно увеличило создание и использование навыков. В период с 1 августа по 14 ноября Brain написал более 80 000 личных навыков для более чем 20 000 пользователей. Кроме того, с 4 сентября по 14 ноября было применено более 100 000 автоматических обновлений к более чем 30 000 существующих личных навыков.
Эти навыки охватывают широкий спектр областей и задач: от проверки программного обеспечения до сверки платежных ведомостей и проектирования фигур. Мы классифицировали навыки, созданные Brain, на основе рабочих процессов, которые они описывают. Даже крупнейшая область, разработка программного обеспечения, составила лишь 11% навыков; за ней следуют исследования и брифинги (10,1%), продажи и операции (9,9%), а также финансы и инвестиции (9,9%).
Мы провели восьминедельный рандомизированный тест на производственном трафике, сравнивая пользователей с включенным автоматическим улучшением личных навыков с контрольной группой, у которой эта функция была отключена. 72,9% людей с включенным улучшением навыков получили как минимум один новый личный навык, в то время как только 6,5% людей без этой функции добавили новый навык вручную. Более половины группы тестирования (53%) имели личный навык, загруженный в начатом ими разговоре, по сравнению с 13% в контрольной группе; их сессии загружали личный навык примерно в 3,6 раза чаще. Среди клиентов, получивших навык, написанный Brain, 63% использовали его снова в последующих разговорах в течение четырех недель.
Наши оценки направлены на определение того, как эти новые и обновленные навыки влияют на выполнение задач и общую производительность.
Результаты того же рандомизированного эксперимента показывают снижение количества сбоев при вызове инструментов и уровня неудовлетворенности пользователей. У пользователей с функцией автоматического улучшения навыков частота сбоев при вызове инструментов снизилась на 11% во всех действиях Computer. Если исключить фоновые процессы самой системы, частота сбоев при вызове инструментов все равно снизилась примерно на 7%, что свидетельствует о повышении надежности при выполнении пользовательских задач. Уровень неудовлетворенности пользователей, измеряемый как количество веток обсуждения со средним или высоким уровнем неудовлетворенности на одного пользователя, снизился на 7,6%. Мы не зафиксировали заметных изменений в стоимости или времени отклика. Эти ранние тесты демонстрируют многообещающие результаты, и мы ожидаем, что улучшения будут расти со временем по мере совершенствования системы и предоставления функций самообучения большему числу пользователей.
Офлайн-эксперименты также зафиксировали улучшения в более узких сценариях. В эксперименте SkillLearnBench Computer использовал предыдущие траектории выполнения задач для создания одного персонального навыка для каждого из девяти семейств задач. В 16 парных оценочных примерах успешность выполнения задач выросла с 43,8% без использования навыков до 62,5% с использованием созданных навыков, что доказывает, что навыки, полученные на основе прошлого опыта, могут повысить эффективность при выполнении повторяющихся задач. В одном встроенном тематическом исследовании внесение правок в навык для электронной коммерции привело к повышению качества на 6% при снижении затрат на 32%, где качество оценивалось автоматизированным алгоритмом.
Заключение
Самосовершенствующиеся навыки дают Computer еще один способ учиться на выполняемой им работе. Это расширяет возможности Brain по созданию и поддержанию процедурной памяти, повышая эффективность выполнения сложных рабочих процессов. Автоматическое улучшение навыков уже привело к увеличению использования навыков, снижению частоты сбоев инструментов и уменьшению неудовлетворенности пользователей.
Персональное улучшение навыков теперь доступно всем подписчикам Max в США. Эта функция включена по умолчанию для соответствующих критериям пользователей, но ее можно отключить. На вкладке «Плагины» отображаются доступные навыки, указываются те, которые были созданы Brain, и пользователям предоставляется возможность выбирать, какие навыки будут включены.
Далее мы расширим возможности улучшения на большее количество классов навыков, включая навыки, созданные пользователями, навыки, используемые в рамках проектов, и организационные навыки. Мы продолжим совершенствовать конвейер улучшений и методы его оценки, чтобы вносимые изменения приводили к более надежным процедурам и лучшим результатам.