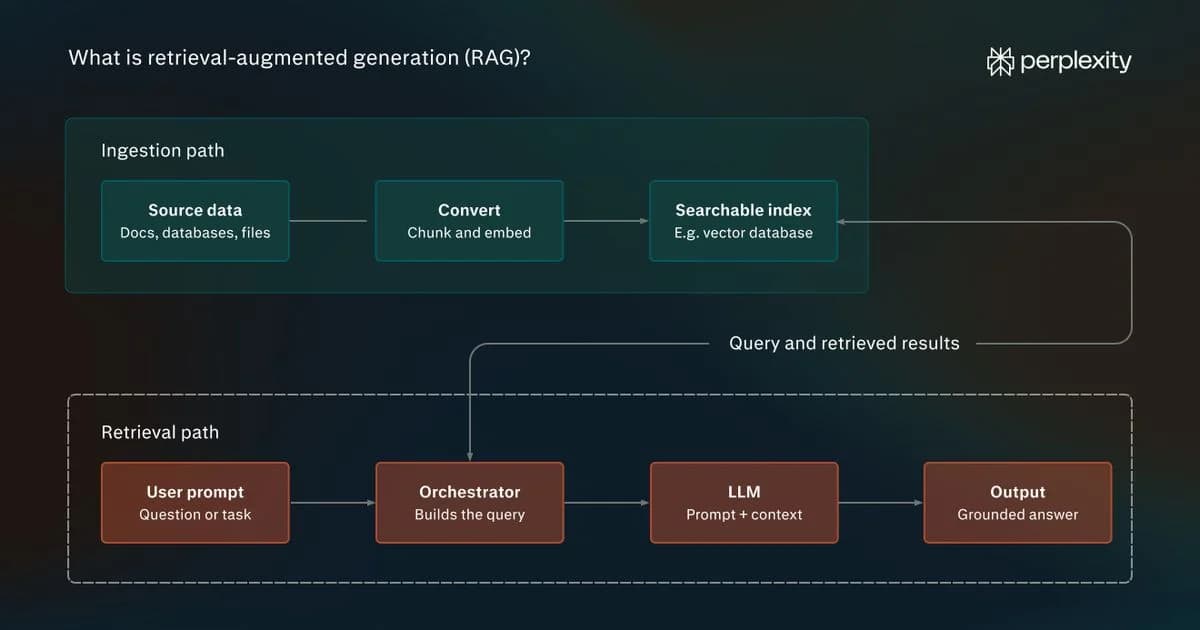
RAG, или генерация с дополнением поиска (Retrieval-Augmented Generation), — это процесс, с помощью которого инструменты на базе больших языковых моделей (LLM) получают доступ к внешней информации. Эта информация, не содержащаяся в параметрах обучения LLM, добавляется в соответствующий контекст ввода и используется при генерации ответа.
RAG является одним из важнейших компонентов современных систем искусственного интеллекта. Он используется всеми популярными агентными инструментами (ChatGPT, Claude, Perplexity и др.) и имеет широкий спектр потребительских и корпоративных сценариев использования. С момента своего широкого распространения RAG претерпел несколько инноваций и продолжает развиваться впечатляющими темпами.
Генерация с дополнением поиска (RAG) — это метод улучшения результатов работы больших языковых моделей (LLM) путем предоставления им релевантной внешней информации.
Типичный «конвейер» RAG, термин, используемый для обозначения широкой базовой архитектуры RAG, имеет два пути: путь приема данных и путь поиска. Путь приема данных берет информацию и преобразует ее в формат, доступный для поиска. Путь поиска формирует запрос на основе подсказки пользователя и обращается к источнику информации.
Часто системы RAG строятся вокруг векторных баз данных. В этом сценарии компонент-оркестратор инструмента LLM, который управляет подсказками пользователей, отправляет запросы и извлекает результаты из индекса для поиска, генерирует векторное представление (эмбеддинг). Он использует его для запроса к базе данных векторов, представляющих принятые данные. Затем он добавляет извлеченную информацию к существующему контексту ввода для LLM с инструкциями о том, как использовать ее для генерации ответа.
RAG не относится исключительно к типу плотного векторного поиска, описанному выше. Обход графов знаний, семантический поиск, традиционные запросы к базам данных или любая комбинация этих методов также подходят под это определение.
Преимущества RAG
Одна из причин, по которой RAG стал таким популярным, заключается в том, что он решает две основные проблемы, связанные с генерацией ответов только с помощью LLM: галлюцинации и отсутствие доступа к информации, не содержащейся в обучающих материалах.
Проверка фактов и обоснование
LLM имеют репутацию моделей, испытывающих трудности с фактической точностью. Часто, если они не могут надежно ответить на вопрос, они уверенно галлюцинируют. Это может происходить либо из-за того, что информация не содержалась в обучающих материалах, либо из-за того, что сами обучающие материалы содержат неточности. Процесс проверки фактов с помощью RAG включает в себя обоснование ответа информацией из надежного стороннего источника.
Актуальная информация
LLM могут отвечать на вопросы только по темам, которые охватывают их данные обучения до определенного момента, называемого точкой отсечения знаний (knowledge cut-off). Системы RAG могут подключаться к самым актуальным источникам информации, таким как новостные материалы с использованием API веб-поиска или внутренние базы данных с актуальной информацией о продуктах. Это позволяет генерировать ответы на темы, которые не охвачены данными обучения.
Доступ к частным внешним данным
Системы RAG позволяют предприятиям подключать инфраструктуру ИИ к источникам конфиденциальной, проприетарной и узкоспециализированной информации, которой они не могут делиться публично. Многие популярные инструменты, такие как Perplexity, теперь включают возможность загрузки конфиденциальных данных и создания частных баз знаний, что является распространенным корпоративным сценарием использования.
Обзор и эволюция RAG: основные типы архитектуры
Хотя конкретный термин «генерация с дополнением поиска» впервые появился в крупной статье 2020 года под названием Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, системы информационного поиска использовались за многие десятилетия до этого. Ранние поисковые системы — хороший тому пример. Однако настоящая инновация в области ИИ заключалась в объединении параметрических знаний модели с плотным векторным индексом (в статье для этого использовалась Википедия).
Вот обзор основных типов RAG:
- Базовый RAG: также называемый наивным RAG, базовый RAG — это самая простая итерация конвейера RAG. Он следует потоку «поиск и генерация», где поиск по векторной базе данных является основным сценарием использования. Он по-прежнему подходит для создания простой реализации RAG, особенно для ограниченного внутреннего использования.
- Гибридный RAG: включает в себя объединение более чем одного типа RAG. Обычно это относится к комбинации простого поиска по ключевым словам и плотного векторного поиска.
- Корректирующий RAG: форма RAG, в которой извлеченная информация оценивается дообученной моделью для определения релевантности подсказке пользователя.
- Самокорректирующийся RAG (Self-RAG): хотя он похож на корректирующий RAG, в Self-RAG сама LLM оценивает свои результаты и при необходимости инициирует повторный поиск. Для этого она использует специализированные токены рефлексии.
- Агентный RAG: агентный RAG относится к способу, которым платформы агентного ИИ могут вызывать различные методы поиска. LLM может рассуждать и выбирать из различных вариантов RAG через оркестратор.
- Мультимодальный RAG: этот тип RAG включает в свои конвейеры приема и поиска другие формы медиа, такие как изображения и аудио.
- GraphRAG: GraphRAG включает обход графа знаний (поиск сущностей) для извлечения информации. Это может происходить в сочетании с плотным векторным поиском, но не обязательно.
- Ветвящийся RAG: эта архитектура RAG предполагает выполнение нескольких поисковых запросов одновременно, часто с использованием различных архитектурных шаблонов. Ветвящийся RAG — распространенная функция в инструментах ИИ, которые выполняют сложные рабочие процессы.
- HyDE (Hypothetical Document Embeddings): гипотетические эмбеддинги документов — это сгенерированные ИИ ответы, которые имитируют идеальный ответ на запрос пользователя. Они используются для уточнения запроса RAG, тем самым повышая точность извлекаемой информации.
Основные сценарии использования RAG с примерами
Как RAG выглядит в реальном мире? Если вы задавали чат-боту с ИИ вопрос на актуальную тему, обращались к боту службы поддержки или использовали персонального помощника для административных задач, вы пользовались RAG.
Лучшие примеры RAG в потребительском и корпоративном контекстах — это веб-поиск, персональные помощники (включая помощь в программировании), помощники по написанию кода, поддержка клиентов и управление корпоративными знаниями.
Веб-поиск
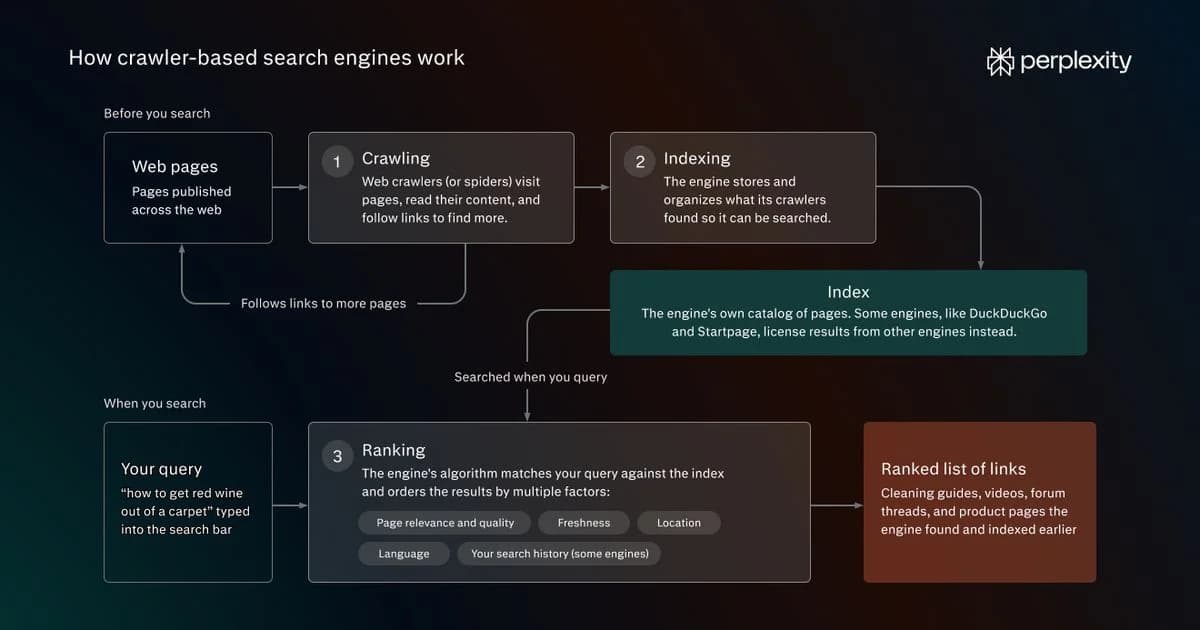
Веб-поиск — это широко используемая форма RAG и, возможно, самое распространенное потребительское приложение. Все популярные чат-боты предлагают функцию веб-поиска, в которой LLM использует актуальные источники для дополнения информации, содержащейся в ее обучающих материалах.
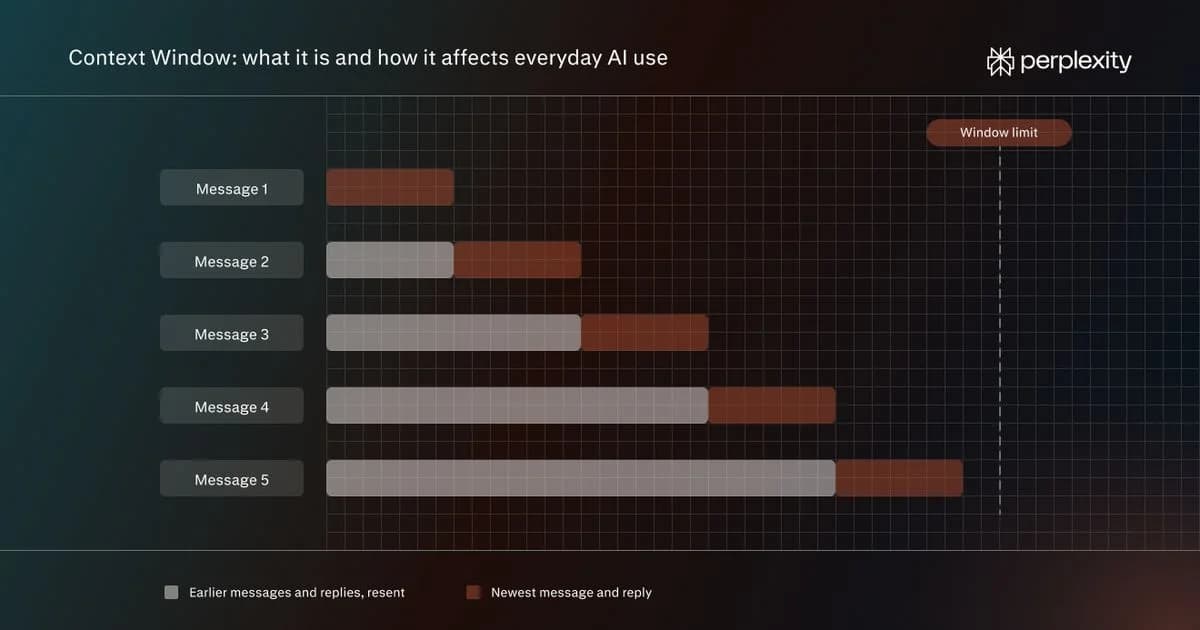
Оркестратор в инструменте ИИ подключается к сторонней поисковой системе с помощью вызова API, а результаты в виде фрагментов добавляются в контекстное окно LLM. Это позволяет пользователям получать доступ к текущим событиям, недавним исследованиям, информации о продуктах и другим темам, где информация часто меняется.
На практике запрос API может выглядеть следующим образом:
json
{ "query": "последние новости об инфляции в США", "max_results": 1, "language": "ru", "country": "US" }
Возвращенная информация будет включать источник и фрагмент:
json
{ "query": "последние новости об инфляции в США", "results": [ { "title": "Инфляция в США немного выросла в последнем отчете", "url": "https://example.com/us-inflation-report", "snippet": "Потребительские цены выросли согласно последним ежемесячным данным, при этом жилье и энергия способствовали росту.", "published_date": "2026-11-05" } ] }
Персональные ИИ-помощники
Персональные помощники используют RAG для подключения к источникам информации в личной или корпоративной среде. Примеры источников информации включают электронную почту, файлы, календарь и базы данных пользователя.
Поскольку информация может храниться самыми разными способами, персональные помощники лучше всего рассматривать как полностью автономные агентные RAG-системы. В зависимости от запроса они могут использовать вызовы API, поиск по ключевым словам, плотный векторный поиск или обход графов знаний.
Все чаще корпоративные RAG-системы будут кодировать знания в векторные базы данных, чтобы общекорпоративные персональные помощники могли легко их извлекать, и многие корпоративные ИИ-продукты создаются с учетом этого.
Помощники по написанию кода также заслуживают внимания, поскольку они представляют собой еще один важный вариант использования. Помощник по написанию кода, такой как GitHub Copilot, может подключаться к репозиторию и специфичной для проекта документации для извлечения релевантных файлов, функций, символов, руководств, API и истории коммитов.
Служба поддержки
Служба поддержки клиентов — еще один крупный вариант использования RAG, и внедрение ИИ-чат-ботов в последние годы стремительно растет. В своем отчете State of AI Customer Support компания Crisp выяснила, что 40% диалогов решаются без участия человека, что говорит о высоком уровне эффективности.
Когда пользователь задает вопрос боту службы поддержки, оркестратор обычно выполняет поиск по внутренней базе знаний компании. Для обеспечения точности часто также применяются корректирующий RAG (corrective RAG) и self-RAG с передачей запроса оператору-человеку там, где это необходимо.
Корпоративные базы знаний
Внедрение ИИ-рабочих процессов и инструментов генеративного ИИ на средних и крупных предприятиях происходило одновременно с созданием внутренних баз знаний. Это позволяет общекорпоративным помощникам получать доступ к внутренним данным при сохранении конфиденциальности, будь то конфиденциальная информация о клиентах, частные корпоративные данные или специализированные знания в определенной предметной области.
Эти системы обычно строятся на базе векторных баз знаний, но используются и другие методы RAG. Например, Microsoft 365 Copilot имеет уровень API, который предоставляет различные источники информации, включая векторные базы данных, графы знаний и семантические индексы, обеспечивая широкий доступ к данным компании.
Эти RAG-системы также обычно встроены в корпоративные пакеты универсальных агентных инструментов. Например, Perplexity Enterprise позволяет пользователям загружать большие объемы документации для безопасного внутреннего использования.
Пользователи также могут загружать собственные файлы в рамках изолированных проектов, по сути создавая мини-RAG-системы. Поиск может сочетаться с другими формами RAG, такими как веб-поиск, для гибридного дополнения.
В чем разница между RAG и LLM?
Большая языковая модель (LLM) может создавать результаты только на основе информации, представленной в ее параметрах. Она присваивает вероятности внутреннему словарю для прогнозирования следующего слова или токена в последовательности. Таким образом, она не может предоставить точные ответы, если ее параметры не были обучены на релевантной информации.
В универсальной или специализированной ИИ-платформе RAG-пайплайны функционируют вместе с LLM или группой LLM. Они подключаются к внешним источникам информации, чтобы дополнить входной контекст, предоставляемый языковой моделье, и в этом заключается основное различие между RAG и LLM.
Решение о том, следует ли извлекать дополнительную информацию или полагаться исключительно на параметрические знания, может приниматься либо на уровне оркестратора (обычно с использованием логики на основе правил), либо самой LLM.
В чем разница между RAG и MCP?
RAG и протокол контекста модели (MCP) лучше всего понимать как взаимодополняющие технологии. MCP — это открытый стандарт для построения архитектуры, который позволяет ИИ-инструментам получать доступ к внешним функциональным возможностям, ресурсам и промптам через единую конечную точку.
Когда ИИ-инструмент подключается к серверу MCP, сервер предоставляет все примитивы (инструменты, ресурсы и промпты MCP), к которым у клиента есть разрешение на доступ. Клиент — это компонент, который устанавливает соединение между оркестратором на стороне клиента и сервером. Иногда это может включать предоставление доступа к базам данных и источникам информации, и в этом случае MCP выступает в качестве посредника на уровне извлечения в RAG-пайплайне.
В чем разница между RAG и API?
API — это определенный интерфейс, который два приложения могут использовать для отправки запросов друг другу. RAG — это процесс, с помощью которого LLM могут получать доступ к внешней информации для улучшения и расширения своих результатов.
RAG часто использует вызовы API для извлечения информации. Например, при поиске информации в веб-поиске оркестратор формирует запрос API к соответствующей поисковой системе на основе промпта пользователя.
Почему RAG важен и как он будет развиваться дальше
RAG важен, потому что LLM по своей сути ограничены своими обучающими данными. Существуют целые пласты информации — от текущих событий до знаний частных компаний, — к которым у них нет доступа. RAG решает эту проблему, не требуя непомерного количества ресурсов.
Тем не менее, самого по себе извлечения информации недостаточно, и именно поэтому RAG продолжит развиваться. RAG составляет значительную часть текущих исследований в области ИИ и направлен на улучшение систем таким образом, чтобы они возвращали правильную информацию в самых разных форматах, а также эффективно оценивали ее и расставляли приоритеты.
По мере того как RAG становится мощнее, возрастает и полезность ИИ-систем в важных потребительских и корпоративных приложениях. К ним относятся поддержка клиентов, веб-поиск, программирование, персональные помощники, специализированные исследования и многое другое.