Мы выпускаем Decider v1.3 и Decider Flash v1.3, преемников наших предыдущих моделей принятия решений: v1, v1.1, v1.2 и Flash v1.2.
Decider Flash v1.3 — это более компактная модель, дистиллированная из Decider v1.3. Обе модели доступны на Hugging Face по лицензии Apache, через OpenRouter и API Perplexity Decisions.
Perplexity Decider вдохновлена Jev, моделью System One от TypeSafe AI. Она поддерживает бинарную и многоклассовую классификацию с упорядоченными или неупорядоченными метками, возвращая вероятности, которые приложения могут использовать для классификации, маршрутизации, ранжирования и оценки входных данных.
Обе модели версии 1.3 повышают производительность и надежность в широком спектре текстовых и визуальных задач за счет двунаправленного внимания, более тщательно отобранных обучающих данных и усовершенствованного процесса обучения. Мы также представляем locate — новую функцию для выделения выбранного контента для задач распознавания именованных сущностей, идентификации персональных данных и экстрактивного ответа на вопросы.
В этой статье мы объясняем, как мы обучаем и оцениваем Decider, и рассказываем, как мы используем ее внутри Perplexity.
Что такое модель принятия решений?
Модель принятия решений — это классификатор общего назначения. Вы предоставляете ей входные данные и набор вопросов, каждый из которых имеет возможные варианты ответов. Для каждого вопроса модель возвращает распределение вероятностей по ответам. Она поддерживает 3 типа вопросов:
- Да / Нет: бинарные решения.
- Множественный выбор: пользовательские многоклассовые метки.
- Оценка: упорядоченные уровни.
Модели принятия решений поддерживают широкий спектр задач классификации и оценки:
- Оценка результатов: проверка на достоверность, качество и безопасность.
- Маршрутизация: направление запросов к более компактным или более мощным моделям в зависимости от сложности.
- Модерация и безопасность: обнаружение вредоносного контента, фишинга и инъекций промптов в результатах работы инструментов.
- Фильтрация и тегирование: организация больших коллекций контента.
- Поиск и переранжирование: оценка результатов поиска по релевантности.
Многие из этих задач ранее решались генеративными моделями, такими как LLM, хотя они не требуют генерации текста в свободной форме. Модели принятия решений занимают нишу между LLM и специализированными классификаторами. Они возвращают вероятности для нескольких вопросов об одних и тех же входных данных за один проход, избегая по-токеновой генерации ответов и разделяя вычисления между вопросами. В отличие от специализированных классификаторов, они могут справляться с новыми задачами с помощью промптов на естественном языке — гибкость, полученная благодаря обучению на разнообразных задачах в едином формате «вопрос-ответ».
Обучение
Превращение генеративной LLM в модель принятия решений
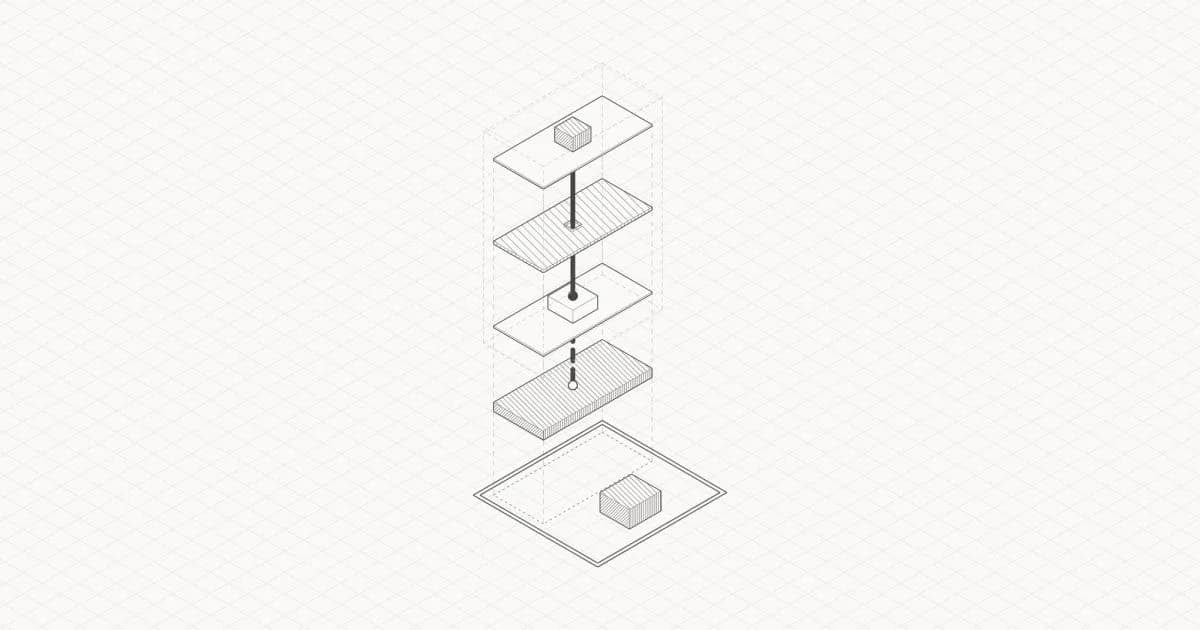
Мы создаем Decider, адаптируя мощные генеративные LLM-основы. Чтобы объяснить адаптацию, сначала опишем, как представляется запрос. Как показано ниже, запрос состоит из общего контекста (состояния) и ряда вопросов. Состояние будет повторно использоваться для всех вопросов.
Например, имея документ и его краткое содержание, один запрос может уточнить, точно ли содержание отражает документ и предназначено ли оно для экспертов или широкой аудитории. После состояния каждый блок вопроса содержит сам вопрос и возможные варианты ответов, каждому из которых присвоен предопределенный токен метки, такой как A, B или C. Специальный токен <|marker|> указывает, где считывать предсказание модели. В этой позиции обученный линейный выходной слой (голова принятия решений) отображает скрытое состояние в оценки для вариантов ответа на вопрос, которые затем преобразуются в вероятности.
Мы инициализируем выходной слой из базовой модели, которая обычно оценивает следующий токен из всего словаря, и оставляем только строки, соответствующие предопределенным токенам вариантов, таким как A, B или C. Этот сокращенный слой затем обучается превращать скрытое состояние <|marker|> в оценки ответов. Этот подход охватывает все вопросы классификации, поскольку все они могут быть сформулированы как множественный выбор.
Для обучения мы берем сотни общедоступных наборов данных, охватывающих разнообразные задачи (анализ тональности, логический вывод на естественном языке, определение интента, сопоставление сущностей, модерация, проверка фактов, рейтинги и т. д.), и преобразуем каждый пример в описанный выше унифицированный формат: состояние, один или несколько вопросов, их варианты и целевой результат. Целевым результатом может быть единственный правильный вариант, если у нас есть эталонные метки, или распределение вероятностей по вариантам.
В версии 1.3 мы представляем locate, который извлекает текст из состояния вместо выбора из предопределенных вариантов. Вопрос locate описывает, что нужно найти, используя либо короткую метку, например «location», либо инструкцию, например «Извлеките название города, в котором находится вакансия». Модель возвращает точное совпадение текста из состояния вместе с начальной и конечной позициями символов. Если совпадений не найдено, возвращается пустой список.
Благодаря общему состоянию один запрос может объединять вопросы типа locate, классификации и оценки для одних и тех же входных данных. Например, можно спросить, требует ли вакансия опыта старшего уровня, и одновременно извлечь требуемые навыки.
Двунаправленное внимание: позволяем модели читать в обоих направлениях
Наши модели основаны на мощных предобученных генеративных архитектурах, чье причинно-следственное внимание позволяет каждому токену обращать внимание только на себя и предыдущие токены. Наши исследования показали, что перевод слоев полной архитектуры в режим двунаправленного внимания улучшает производительность, поэтому мы используем этот дизайн, чтобы каждый токен мог учитывать контекст всего входного сообщения.
Двунаправленное внимание вводит еще один выбор дизайна: как должны взаимодействовать состояние и вопросы? Мы рассмотрели три паттерна внимания с различными последствиями для производительности, стабильности ответов и повторного использования кэша:
- Все видят всё (v1.2): Состояние и все вопросы обрабатываются вместе с полным двунаправленным вниманием. Вычисления по состоянию общие, но ответ на один вопрос может измениться в зависимости от того, что еще спрашивается.
- Изолированные вопросы (v1.3): Состояние обращает внимание на все вопросы, в то время как каждый вопрос обращает внимание только на состояние и свои собственные токены. Вопросы все еще могут влиять друг на друга косвенно через общее состояние, но результаты более стабильны.
- Полностью кэшируемое: Состояние обращает внимание только на себя, в то время как каждый вопрос обращает внимание на состояние и свои собственные токены. Состояние не зависит от вопросов и может повторно использоваться в разных запросах для использования кэширования промптов. Мы не используем это по умолчанию, так как для многих задач важно, чтобы состояние «видело» вопросы, но небольшая донастройка может переключить модель в этот режим.
В конечном итоге мы выбрали изолированные вопросы из-за их высокой производительности и стабильности.
Процесс обучения
Обучение проходит в три этапа для моделей обоих размеров. Сначала мы обучаем более крупную модель на основе Qwen3.8-27B, используя кросс-энтропию на больших наборах данных, а затем дистиллируем ее в меньшую модель Qwen3.5-4B.
Первый этап — это обучение модели общего профиля, где мы проводим полную донастройку модели на крупномасштабных корпусах. На этом этапе мы принимаем только те данные, которые помогают модели в целом и не являются специфичными для какого-либо бенчмарка; поэтому мы исключаем любые обучающие выборки бенчмарков.
После обучения этой модели общего назначения мы запускаем второй, более детальный этап с использованием LoRA. Данные, используемые на этом этапе, ориентированы на конкретные предметные области и задачи. Мы добавляем данные на втором этапе, а не на первом, если наблюдаем незначительный прирост или регрессию в других задачах. Мы используем LoRA, чтобы избежать слишком сильного отклонения от модели общего назначения и риска потери производительности при адаптации к этим конкретным областям. Цель состоит в том, чтобы улучшить производительность, сохранив при этом общие знания базовой модели. Мы также используем весовой коэффициент при слиянии LoRA обратно в базовую модель, чтобы более точно контролировать отклонение и отдавать предпочтение отложенным метрикам, а не приросту внутри домена.
Наконец, мы добавляем этап, специфичный для зрения. Подобно второму этапу, этап зрения рассматривается как еще один этап детальной специализации с использованием адаптера LoRA, который объединяется с базовой моделью с определенным весом. Некоторые возможности зрения могут быть достигнуты ценой снижения производительности в работе с текстом. Поскольку мы наблюдаем гораздо более частое использование моделей для работы с текстом, мы отдаем приоритет текстовым метрикам перед метриками зрения.
Для обоих текстовых этапов мы используем средние веса трех прогонов, каждый из которых использует разные случайные начальные числа. Мы обнаружили, что это повышает производительность и надежность агрегированной модели.
После получения финальной большой модели мы применяем ту же трехэтапную процедуру обучения к меньшей модели. Здесь большая модель выступает в роли учителя: ее предсказанное распределение выходных данных заменяет эталонные метки, а меньшая модель обучается минимизировать дивергенцию Кульбака-Лейблера (KL) между своими предсказаниями и предсказаниями учителя. Эта цель дистилляции превосходит кросс-энтропию на тех же обучающих данных. Хотя кросс-энтропия лучше работает на бенчмарках со специализированными обучающими данными, она хуже обобщается на отложенных данных. Мы предполагаем, что дистилляция лучше передает выходное распределение учителя, включая его уверенность в неэталонных альтернативах, тогда как кросс-энтропия поощряет переобучение на специфическом для бенчмарка обучающем распределении. Поэтому мы принимаем цель дистилляции на основе KL.
Чтобы смягчить проблему загрязнения данных при обучении и тестировании, мы удаляем любые обучающие выборки, которые могут пересекаться с используемыми нами оценками. Это важно, поскольку некоторые общедоступные обучающие наборы данных содержат большие части некоторых оценочных наборов данных. Мы также проводим тщательный аудит и устранение предвзятости, чтобы убедиться, что наши достижения надежны и не обусловлены только усвоенными искажениями.
Добавление возможности извлечения информации
Функция поиска (locate) извлекает информацию, такую как именованные сущности, из текста, не меняя при этом способ ответа на обычные запросы. Для этого мы вводим дополнительный этап обучения: мы добавляем новый специальный токен <|locate|>, заголовок диапазона (span head) и адаптер LoRA в Decider.
Мы инициализируем эмбеддинг <|locate|> из <|marker|>, изученного на предыдущих этапах обучения. Мы обучаем только этот новый эмбеддинг, заголовок диапазона и адаптеры LoRA, сохраняя при этом исходные веса основы и заголовок принятия решений замороженными. Каждое запрашиваемое поле получает свой собственный токен <|locate|>.
Заголовок диапазона использует представление <|locate|> вместе с представлениями токенов состояния, чтобы оценить, где начинаются и заканчиваются соответствующие диапазоны и какие пары начало-конец принадлежат друг другу. Он также использует представление токена <|locate|> для предсказания специфических для поля пороговых значений для этих оценок. Выбранные диапазоны возвращаются в виде позиций символов в исходном тексте.
Мы обучаем заголовок диапазона с адаптированной функцией потерь InfoNCE, которая подталкивает каждый эталонный диапазон выше порогового значения, а пороговое значение — выше любого другого диапазона. Функция потерь имеет два члена: первый подталкивает оценки правильных диапазонов выше порогового значения и неправильных диапазонов. Второй член подталкивает пороговое значение выше оценок неправильных диапазонов. Поля без ответа получают только второй член, который учит модель возвращать пустой список.
Мы обучаемся на смеси задач извлечения диапазонов, включая распознавание именованных сущностей, обнаружение PII и экстрактивное вопросно-ответное взаимодействие. Мы варьируем описания полей от коротких меток до подробных инструкций, чтобы модель училась следовать запросу, а не запоминать фиксированный набор меток.
Функция поиска учит модель структурно другой задаче, и мы хотим добавить ее, не теряя того, что модель уже делает хорошо. Объединение адаптеров поиска в основу вызывает некоторую регрессию в запросах на принятие решений. Чтобы ограничить это, мы проводим исследования, такие как использование большего количества данных повторного воспроизведения с более ранних этапов и вспомогательных целей, которые сохраняют выходные данные модели по запросам на принятие решений близкими к результатам исходной модели. Однако мы обнаружили, что слияние в настоящее время все еще не является без потерь, поэтому мы оставляем адаптеры неслитыми и активируем их только для запросов поиска.
Оценка
Мы оцениваем Decider v1.3 и Decider Flash v1.3 на внешних бенчмарках от Hugging Face Decision Index, Vals AI и Artificial Analysis Decision Index.
В ходе этих оценок наши модели демонстрируют высокую производительность. Несмотря на то, что эти таблицы лидеров включают частные задачи, их все равно можно «взломать» путем многократной отправки и итеративной настройки на основе отзывов таблицы лидеров. Чтобы дополнить эти таблицы лидеров, мы оцениваем модели на внутреннем наборе, объединяющем частные производственные задачи с отложенными оценками, взятыми из общедоступных наборов данных, не являющихся бенчмарками. Эти оценки обеспечивают дополнительную проверку обобщения за пределами общедоступных бенчмарков, помогая нам отличить более широкие улучшения от достижений, специфичных для знакомых наборов оценки.
Внутри компании мы создали набор из более чем 200 задач, охватывающих различные области и задачи, такие как классификация, скоринг, переранжирование и извлечение сущностей. Чтобы честно оценить реальную производительность Decider, все оценки проводятся в режиме zero-shot, без специфической для задачи донастройки, что дает нам четкий сигнал о том, где нужно улучшить модель.
Классификация запросов
В Perplexity мы используем многоголовую систему классификации для обработки каждого пользовательского запроса. Каждый запрос сначала проходит через модель эмбеддинга, которая действует как экстрактор признаков. Полученный эмбеддинг затем подается в несколько отдельных классификационных голов, включая как бинарные, так и мультилейбл-классификаторы. Например, одна голова определяет, должен ли пользовательский запрос инициировать веб-поиск.
По 63 задачам классификации с независимо перемаркированными ссылками от передовой LLM, Decider v1.3 достигает средней точности 91,6%, превышая наши производственные классификаторы на 6,54 процентных пункта. Decider Flash v1.3 также превосходит производственный базовый уровень, в то время как Decider v1.3 превосходит Jev 1.14.
Классификация по предметным областям
Мы собрали набор оценок по предметным областям из общедоступных наборов данных для оценки производительности классификации моделей принятия решений по семи областям: проверка утверждений (6 задач), здравоохранение (7), кибербезопасность (8), программирование (16), правительство (7), право (9) и финансы (9).
Например, «оцените временную сложность программы на Python» или «используйте годовой финансовый отчет, чтобы определить, покрывает ли свободный денежный поток компании основную сумму долга, подлежащую погашению в течение следующих двенадцати месяцев». Decider v1.3 лидирует во всех семи доменах, превосходя Jev 1.14 на величину до 12,9 процентных пункта в финансах и на 9,3 пункта в праве. Decider Flash v1.3 отстает от Jev 1.14 в финансах, программировании и праве, а в других доменах показывает схожие результаты.
Поиск и переранжирование
Поиск лежит в основе Perplexity. Мы поддерживаем широкий набор задач поиска для оценки эффективности переранжирования наших моделей. Для каждой задачи мы сначала используем пул моделей эмбеддингов для извлечения 50 лучших документов-кандидатов из каждого корпуса. Затем мы переранжируем этих кандидатов с помощью Decider и сравниваем его производительность с сильным базовым переранжировщиком — Qwen3-Reranker-8B.
Мы оцениваем Decider в режиме zero-shot, используя модель для непосредственной оценки каждой пары «запрос-документ» независимо и ранжирования документов по релевантности. По результатам 72 задач поиска Decider v1.3 достигает среднего значения nDCG@10, равного 83,99, превосходя Qwen3-Reranker-8B на 1,81 пункта, а Jev 1.14 — на 2,24 пункта.
В бенчмарке BEIR обе модели превосходят Qwen3-Reranker-8B на 8,78 и 7,05 nDCG@10 соответственно. По сравнению с Jev 1.14 модель Decider v1.3 показывает результат на 1,33 пункта выше, в то время как версия Flash набирает на 0,4 меньше.
Многоязычная классификация
Чтобы оценить модели принятия решений за пределами английского языка, мы собрали многоязычный бенчмарк классификации, включающий 19 специфичных для языка задач из 8 публичных наборов данных, содержащих 46 484 примера на восьми языках: немецком, испанском, французском, итальянском, русском, японском, корейском и китайском. Бенчмарк охватывает определение интента, классификацию тем, анализ тональности, логический вывод на естественном языке, обнаружение парафраз, обнаружение оскорбительной лексики и грамматическую приемлемость.
Мы приводим среднюю точность по задачам внутри каждого языка, придавая каждой задаче равный вес. Decider v1.3 превосходит Jev 1.14 по всем восьми языкам, а Decider Flash v1.3 — по шести, при этом средняя точность задач составляет 88,16% для Decider v1.3 и 86,50% для Decider Flash v1.3 по сравнению с 85,41% для Jev 1.14.
NER, PII и экстрактивное QA
Мы оцениваем функцию поиска на 17 задачах вне домена, которые проверяют возможности извлечения данных в различных областях, форматах ввода (текст, таблицы, структурированные документы) и инструкциях (короткие метки, вопросы и подробные описания). Домены варьируются от Википедии до научных статей, отчетов о киберугрозах, технической поддержки, политик конфиденциальности, резюме и юридических контрактов. Запросы варьируются от коротких названий меток, таких как «лицо» или «адрес электронной почты», через вопросы о таблице или тикете поддержки, до подробных описаний полей для структурированного извлечения, таких как стороны соглашения о неразглашении (NDA) или общая сумма в счете-фактуре.
Мы оцениваем NER и PII с использованием F1 по точным диапазонам (exact-span F1), что требует, чтобы предсказанные диапазоны точно соответствовали эталонным границам. В экстрактивном QA используется F1 на уровне символов, что дает частичный балл за перекрывающийся текст ответа, в то время как в структурированном извлечении используется точность полей — доля правильно извлеченных полей. Для парсинга резюме мы усредняем показатели F1 по точным диапазонам NER и PII.
Мы сравниваем наши модели с моделями извлечения данных общего назначения разных размеров: GLiNER large v2.5 (0,5 млрд), Liquid d1 (2 млрд) и Clairic от Cloudflare (размер не разглашается). Decider v1.3 достигает среднего балла 69,0 (используя основную метрику каждой задачи), а Decider Flash v1.3 — 63,6, по сравнению с 43,3 у Liquid d1, 41,5 у Clairic и 33,6 у GLiNER large v2.5. Обе модели Decider лидируют в каждой категории.
Классификация изображений
Decider нативно поддерживает задачи компьютерного зрения начиная с версии v1. Чтобы оценить его производительность за пределами текста, мы собрали набор из пяти задач с особым акцентом на классификацию документов, включая счета-фактуры, письма и резюме. Набор также охватывает классификацию спутниковых снимков, классификацию текстур, классификацию пород домашних животных и подсчет животных.
Decider v1.3 достигает средней точности 76,99% по пяти визуальным задачам, превосходя Jev 1.14 на 1,47 процентных пункта. Decider Flash v1.3 достигает 72,77%, демонстрируя возможности визуальной классификации в более компактной модели.
Реальные запросы на принятие решений
Мы отобрали один миллион дедуплицированных запросов с маскировкой PII, отправленных в Perplexity Decision API в течение первых 18 дней его доступности. Поскольку каждый запрос может содержать несколько вопросов об одном и том же состоянии, выборка включает 2 318 887 отдельных вопросов. Все запросы были включены с явного разрешения пользователей для исследовательских целей.
Производственные запросы не имеют эталонных меток, поэтому мы используем LLM-судьи передового уровня для генерации эталонных ответов и измерения степени согласия каждой модели с ними. Мы также группируем запросы по 10 категориям задач, включая извлечение информации, классификацию доменов, анализ тональности, определение интента и маршрутизацию, ранжирование по релевантности, модерацию контента, проверку качества и соответствия требованиям, сопоставление сущностей, бизнес-анализ и категорию «Другое». Эта разбивка показывает, как производительность варьируется в зависимости от реальных сценариев использования.
Распределение задач неравномерно: на извлечение информации приходится 425 402 вопроса, на классификацию доменов — 409 564, а на анализ тональности — 344 158. Вместе эти три категории составляют 50,8% от общего числа вопросов в выборке.
Decider v1.3 достигает наивысшего согласия с судьями — 93,98% по сравнению с 93,68% у Decider v1.2 и 93,35% у Jev 1.14. Decider v1.3 и Jev 1.14 показывают близкие результаты в классификации доменов и анализе тональности с разрывом в 0,34 и 0,07 процентных пункта соответственно. Jev лидирует на 0,69 пункта в ранжировании по релевантности, в то время как Decider v1.3 лидирует на 0,93 пункта в извлечении информации (самая частая задача в выборке) и на 1,21 пункта в определении интента и маршрутизации.
На графике ниже сравнивается заявленная стоимость выполнения того же миллиона производственных запросов. Каждый запрос может содержать несколько вопросов, поэтому единицей измерения здесь являются запросы, а не отдельные вопросы.
Устойчивость
Мы оценили чувствительность к меткам на 372 вопросах с множественным выбором, сделав 4 788 запросов для каждой модели. Мы меняли порядок вариантов, переназначали метки для текстов ответов и переименовывали метки, сохраняя смысл каждого вопроса, а затем проверяли, изменился ли семантический ответ модели. Более низкие показатели изменения ответов указывают на большую стабильность.
Decider v1.3 изменил свой ответ всего на 0,27% вопросов при каждой трансформации по сравнению с 2,69–4,84% у Jev 1.14. Мы также повторили идентичные входные данные, чтобы измерить вариативность обслуживания: Decider v1.3 не показал изменений, в то время как Jev 1.14 изменил ответ на 1,88% вопросов.
Как мы используем Decider
Decider создан для рабочих процессов, требующих быстрых и структурированных решений. В этом разделе мы исследуем, как использовать их для достижения значимого влияния на то, как мы работаем. Вот некоторые из них, которые особенно выделяются.
Самосовершенствующиеся правила безопасности
Внутри компании мы уже используем Decider для улучшения наших политик безопасности.
Действия наших агентов записываются, после чего выполняется ряд проверок на основе правил для выявления любого проблемного поведения. Подход на основе правил означает, что мы можем отслеживать наших агентов в режиме реального времени с минимальной задержкой. В автономном режиме мы используем Decider для анализа выборок из этих записанных журналов агентов. В случае, если проблемное поведение не было отмечено, Decider проверяет, не упустил ли наш набор правил что-либо; а если был подан сигнал тревоги, Decider проверяет, не был ли он ложным. Любые записи, в которых наш набор правил дает сбой в любом из случаев, отправляются агенту для сортировки, после чего предлагается исправление правил, которое должен утвердить член нашей команды безопасности.
За один день Decider обработал 1 миллиард токенов в 7000 сеансах агентов и выявил недостатки, которые привели к 14 исправлениям правил, 6 из которых были одобрены и внедрены в течение двух дней. При повторном прогоне на журналах за неделю исправления сократили объем работы нашего самого загруженного правила на 52%, а расширенные правила позволили выявить примерно на 40% больше законных действий для расследования.
Мониторинг развертываний RL
Когда мы проводим дообучение моделей с помощью обучения с подкреплением, совокупные метрики, такие как терминальное вознаграждение, не объясняют, почему развертывание (отдельная попытка выполнения задачи) прошло успешно или завершилось неудачей. Модель может несправедливо потерять вознаграждение из-за сбоя инструментальной службы или «песочницы», или получить незаслуженное вознаграждение, если оценщик упустит из виду неподтвержденное утверждение, например, выдуманное значение, которое не вернул ни один инструмент.
Мы используем Decider для мониторинга развертываний в таких случаях. Код сначала определяет части развертывания, требующие более тщательного изучения: неудачный вызов инструмента и сопутствующие рассуждения, код, который выполнился без ошибок, или окончательный ответ. Затем Decider отвечает на вопросы с несколькими вариантами ответов по каждой части, например, что именно вышло из строя на определенном этапе (инструментальная служба, внешний сайт, «песочница», обвязка или собственный код агента) и правильно ли агент интерпретировал результат. Мы объединяем все вопросы по конкретной части в один запрос и сохраняем вероятности, а не вердикт, чтобы мы могли корректировать пороговые значения позже без повторного обращения к Decider. Монитор только наблюдает и диагностирует: он никогда не меняет вознаграждение и не останавливает выполнение.
Фильтрация качества страниц
При сканировании веб-страниц для индексации и предоставления пользователям многие страницы оказываются слишком низкого качества, чтобы быть полезными. Сюда входят антибот-защита, CAPTCHA и страницы ошибок, а также корректно загруженные веб-страницы, которые просто не содержат полезной информации, такие как спам, SEO-мусор или страницы, предназначенные только для навигации. Эти низкокачественные страницы необходимо идентифицировать и исключать из нашего индекса.
Используя Decider, мы можем оценивать качество страниц по мере их сканирования. В рамках того же прямого прохода мы выполняем ряд других задач классификации, таких как определение домена и целевой аудитории контента, а также проверка на наличие вредоносной, незаконной или персонально идентифицируемой информации. По сравнению с использованием LLM-судьи, Decider работает значительно быстрее и дешевле.
Помимо этих внутренних целей, Decider также подходит для следующих рабочих процессов.
Визуальный контроль качества
Поскольку Decider считывает изображения, он также работает как визуальный проверяющий, просматривая изменения стиля веб-страниц или приложений и выявляя ошибки. Он может проверять скриншоты страниц на наличие обрезанного текста, перекрывающихся элементов, нарушенной верстки перед выпуском изменений или помечать графики, дизайн которых может ввести читателя в заблуждение или нарушить руководство по бренду.
Навигация в браузере
Планирование исследовательских задач
Начало работы
Обе модели доступны в виде загружаемых весов на Hugging Face по лицензии Apache, через , а также через API Perplexity Decisions.