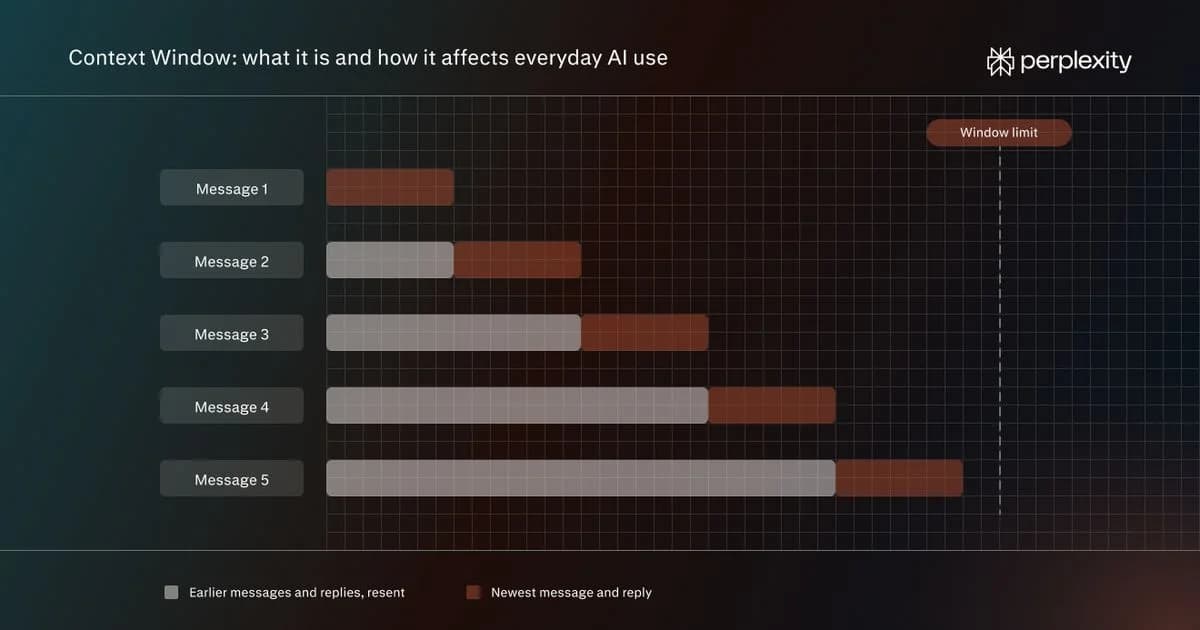
LLM полагаются на свой контекст для генерации следующего набора токенов. На длинной дистанции контекст заполняется множеством типов компонентов: системным промптом, прошлыми репликами диалога, инструкциями, которые воздействуют на извлеченные документы, ответами инструментов или пользовательскими данными, требованиями, ограничивающими допустимый вывод, и цепочками рассуждений. Контекст обладает богатой структурой, большая часть которой либо неявна для модели, либо закодирована в форматах, таких как JSON, которые не были предназначены для обработки LLM. Это одна из главных причин, почему LLM, особенно модели меньшего размера, хрупки и иногда дают сбои неожиданным образом. Отсутствие явной структуры также может быть использовано злоумышленниками, например, в виде инъекций промптов.
Чтобы решить эту проблему, мы разработали LLMON (LLM Object Notation, произносится как «lemon») — LLM-ориентированный язык разметки для явной передачи структуры и семантики моделям. Семантически связные компоненты помечаются значимыми тегами, которые заключены в зарезервированные специальные разделители-токены. Схемы данных, включая вложенность, формулируются способом, однозначным для каузальной LLM. Уникальные идентификаторы позволяют ссылаться на конкретные инструкции, которые могут находиться в любом месте контекста, и привязывать их к полезным данным, на которые они должны воздействовать, подобно тому, как функции вызываются и аргументы передаются им в языках программирования.
Сегодня мы выпускаем две экспериментальные предварительные модели, производные от базовых моделей Granite 4.1, обученные потреблять и генерировать текст с разметкой LLMON: granite-4.1-3b-LLMON-preview и granite-4.1-8b-LLMON-preview. Мы также выпускаем репозиторий GitHub, который включает инструментарий для работы с LLMON и примеры рабочих процессов и шаблонов.
Что это дает:
- Косвенные инъекции промптов, скрытые в пользовательских данных, в основном игнорируются моделями LLMON благодаря четкому разделению инструкций и данных. Для некоторых бенчмарков уровень успеха атак падает почти до нуля, тогда как обычные модели, настроенные на выполнение инструкций, перехватываются с высокой вероятностью. Это достигается при сохранении общих возможностей относительно моделей Granite 4.1 Instruct.
- Несвязанные отрывки, старые реплики чата и выводы инструментов не попадают в ответ, потому что каждая инструкция привязана к конкретным данным, к которым она применяется.
- Инструкции, данные и требования четко помечены, чтобы их структура и значения на уровне кода приложения могли быть использованы моделью. Попробуйте это в Mellea, где реализована встроенная поддержка LLMON за счет автоматической «LLMON-изации» вызовов LLM.
- Вам больше не нужно беспокоиться о том, чтобы заставить LLM соблюдать структуру JSON. Используйте наши конвертеры, чтобы превратить существующий JSON в LLMON без потерь. Вы также можете определить свою собственную структуру и связанные с ней теги, а также дообучить LoRA поверх моделей LLMON, чтобы они понимали ее.
Почему не JSON?
JSON был разработан для парсеров, а не для каузальных языковых моделей. Токенизатор не обязан соблюдать грамматику, а структура кодируется токенами ({, ", :), которые также могут встречаться в обычном тексте. Для модели кавычка внутри документа и кавычка, закрывающая поле, — это один и тот же токен. Правила экранирования, понятные парсеру, для модели являются лишь статистическими закономерностями. Глубина вложенности кодируется подсчетом скобок, с чем трансформеры, как известно, справляются плохо, особенно на длинных отрезках.
LLMON, с другой стороны, представляет собой XML-подобную разметку, структурными разделителями которой являются зарезервированные специальные токены, а не символы, поэтому структура и контент используют разные части словаря. Теги указываются в начале каждого сегмента, а границы между сегментами явные. Вложенные структуры указываются локально, поэтому модели не нужно отслеживать иерархию на длинных отрезках.
Поскольку у большинства команд уже есть конвейеры, построенные вокруг JSON, мы создали инструменты преобразования и примеры блокнотов, которые переводят JSON в LLMON и обратно без потерь.
Как LLMON связан с шаблонами чата?
LLMON не заменяет шаблоны чата; скорее, он дополняет их. В то время как обычные шаблоны чата сообщают модели, какая часть принадлежит какой роли (система, пользователь, ассистент), LLMON сообщает ей, что означает каждый компонент и как компоненты связаны друг с другом внутри ролей и между ними.
Предварительные модели LLMON поставляются со своим собственным шаблоном чата, поэтому вы создаете тот же список сообщений, который передали бы любой модели чата, и вызываете apply_chat_template как обычно; он отображает LLMON, показанный ниже. Единственное отличие заключается в том, что теперь можно именовать части реплики и помечать каждую из них как exec: True или False. Часть, помеченная как True, привязывается к блоку exec в нижней части вывода, который указывает, какую инструкцию запустить и на чем она работает; часть, помеченная как False, по-прежнему отображается в контексте, но ни на что не ссылается.
Которую модель получает в следующем виде (здесь добавлены переносы строк и отступы для читаемости, так как шаблон их не генерирует):
Двухсимвольные идентификаторы блоков взяты из фиксированного набора, который этот токенизатор кодирует как отдельные токены, поэтому адресация блока всегда стоит два токена, независимо от того, какой идентификатор выбран.
Роль по-прежнему является одной репликой пользователя, но ее компоненты доходят до модели как пять отдельных адресуемых блоков, связанных шестым (блоком exec), который гласит: выполнить эту инструкцию, над этими данными, с учетом этих двух требований, и поместить ответ в блок, названный здесь, который является тем же блоком ассистента, который затем заполняет модель. Обычный шаблон свел бы все компоненты в одну строку и оставил бы модели задачу самостоятельно определить, какая часть является задачей, какая — объектом, а какие — ограничениями.
Как LLMON борется с атаками типа «инъекция промпта»
Косвенная инъекция промпта — это тип атаки, при которой вредоносная инструкция скрыта в полезных данных, таких как извлеченный документ, ответ инструмента или предоставленные пользователем данные. Это проблема, на решение которой направлено разделение инструкций и данных в LLMON.
Мы сравнили предварительные версии LLMON с несколькими моделями с открытым и закрытым исходным кодом. Мы провели оценку на бенчмарке OPI, который помещает инъекцию в данные классических задач NLP. Используется несколько стратегий атаки. Мы сообщаем об устойчивости, определяемой как 1 − уровень успеха атаки: доля атак, при которых модель не выполняет внедренную инструкцию.
Все модели, не использующие LLMON, крайне уязвимы и выполняют внедренные инструкции с высокой вероятностью. LLMON практически устраняет проблему на этом бенчмарке, предотвращая на 47% больше атак по сравнению с лучшей протестированной нами пограничной моделью и на 95% больше, чем лучшая модель с открытым исходным кодом. Мы наблюдаем схожие тенденции на других бенчмарках (ASB и StruQ). Стоит отметить, что эти бенчмарки проверяют устойчивость к статическим косвенным инъекциям промптов. Разделение инструкций и данных напрямую решает этот тип атаки. Мы активно работаем над улучшением защиты от адаптивных атак, которые разворачиваются на протяжении многих реплик чата.
Общие возможности
Повышение безопасности не достигается за счет снижения общих возможностей. Во всех стандартных категориях бенчмарков модели LLMON демонстрируют производительность на уровне моделей Granite 4.1 Instruct.
Короче говоря, если вы сегодня экспериментируете с Granite 4.1 3B или 8B, вы можете заменить их на превью LLMON и получить сопоставимую общую производительность со значительно более сильной устойчистью к инъекциям промптов. Никакого конвейера конвертации не требуется. Достаточно указать части хода (например, инструкцию, данные, требование, как в примере выше). Поставляемый шаблон чата преобразует их в блоки LLMON за вас. Наша библиотека конвертеров LLMON идет на уровень глубже: если сама часть структурирована, например, как документ JSON, ее «LLMONизация» сохраняет эту структуру в виде типизированных, индивидуально адресуемых блоков, а не одной непрозрачной строки.
Как мы обучали модели
Модели создаются на базе базовых чекпоинтов Granite 4.1, а не выпущенных instruct-моделей, поэтому поведение LLMON изучается во время постобучения, а не накладывается поверх существующего формата чата.
LLMON определяет шесть разделителей, которые отмечают начало и конец тегов и поддерживают вложенность и привязку; они устанавливаются в токенизатор как зарезервированные одиночные токены. Мы пересохранили традиционный корпус для настройки инструкций в формат LLMON: каждый компонент промпта становится собственным адресуемым блоком, а каждый ход содержит блок выполнения, указывающий, какую инструкцию запустить, с какими входными данными она работает и куда направляется вывод. Набор задач совпадает с тем, который видит обычная instruct-модель (чат, многоходовые диалоги, RAG, вызов инструментов), поэтому производительность в бенчмарках остается близкой к традиционно настроенной модели. Кроме того, мы дополняем данные обманными инструкциями и блоками данных, которые присутствуют в контексте, но намеренно остаются несвязанными, в то время как целевой вывод остается неизменным. Таким образом, модель учится следовать зависимостям, диктуемым блоком выполнения, и игнорировать остальное. Далее следует обучение с подкреплением: пять последовательных этапов GRPO, охватывающих многодоменные рассуждения, RLHF, калибровку знаний и математику, за которыми следует финальный этап DPO на тысяче пар предпочтений on-policy, построенных на основе собственных ответов модели на попытки инъекций.
Полученное правило привилегий вытекает из этой структуры, а не из добавленного защитного барьера: инструкция, к которой осуществляется доступ через блок выполнения, является авторитетной, в то время как все, к чему осуществляется доступ как к входным данным (данные, документы, схемы инструментов, результаты работы инструментов), является материалом для чтения, а не командой для выполнения. Кроме того, инструкции и диапазоны данных, которые не вызываются в блоке выполнения, игнорируются. Это приобретенное поведение, а не принудительная гарантия. Чтобы увидеть, как это проявляется в слоях внимания модели LLMON, попропробуйте инструмент визуализации внимания LLMON Attention Visualization на Hugging Face Spaces.
Привнесите собственный словарный запас (ScienceWorld)
LLMON не привязан к фиксированной схеме: вы можете выбрать имена тегов и структуру, которые подходят для вашей предметной области, и дообучить адаптер для их чтения и записи. Мы демонстрируем это на ScienceWorld, текстовом бенчмарке, где агент выполняет элементарные научные задачи (например, кипячение воды), выдавая по одной команде за раз и получая оценку от симулятора. Мы определили словарный запас, отражающий структуру траекторий планирования, задействованных в решении этих задач. Словарь включает такие теги, как instr.task.goal, req.planning_policy.rule, data.state.room, data.state.inventory и assistant.next_action. Мы визуализировали каждый шаг эталонных решений ScienceWorld с помощью этих тегов и настроили LoRA поверх модели LLMON. Обученная модель затем играет в отложенные игры и записывает свое следующее действие в новом словарном запасе. Этот ноутбук подробно описывает весь рабочий процесс: от конвертации эталонных траекторий до прохождения тестовых игр и оценки адаптера по сравнению с необученной базовой моделью. Другой пример для агентов вызова инструментов можно найти в этом ноутбуке.
Попробуйте сегодня
Это экспериментальное превью, готовое к исследованию и оценке, но не для использования в продакшене.
- Модели: granite-4.1-3b-LLMON-preview и granite-4.1-8b-LLMON-preview
- Демонстрация визуализации: LLMON Attention Visualization
- Репозиторий LLMON:
- Mellea:
- Научные работы: https://arxiv.org/abs/2610.38120, https://arxiv.org/abs/2603.22519
Расскажите нам о своих результатах: что сработало, что сломалось и какие сценарии использования вы хотели бы увидеть. Опубликуйте это в GitHub Discussions.