С помощью V-JEPA2-AC система решает, что манипулятор робота должен делать дальше, оценивая сотни возможных вариантов будущего и выбирая тот, который ближе всего к цели. Между движениями проходит значительное количество времени. В этом документе представлены проект и протестированная реализация, позволяющие сократить это время до менее чем одной секунды за счет переноса поиска в кластер Ray.
Link01 · Введение в робототехнику
Робот воспринимает частичное наблюдение окружающей среды, выбирает действие с помощью некоторой политики, выполняет его через контроллер и повторяет это с частотой контура управления. Классически каждая из этих трех функций решается в замкнутой форме, и CPU на борту робота достаточно для выполнения всех из них.
Классическая робототехника строила каждый из этих трех блоков с нуля: кинематика, выведенная вручную для восприятия, оптимизация траектории для планирования, PID-регуляторы или контроллеры с прогнозирующими моделями для управления. Этот подход, показанный на Рисунке 1, лежит в основе десятилетий промышленной автоматизации, но каждая новая задача, объект или среда обычно требуют новой инженерной разработки.
Классическая робототехника — ~1 мс / действие
Рисунок 1. Цикл, который выполняет каждый робот. Восприятие превращает показания датчиков в состояние, планирование создает путь, управление выполняет его, а манипулятор замыкает цикл через физический мир. Все три задачи решаются в замкнутой форме на одном бортовом CPU. Цена этого — инженерные затраты: политика охватывает только ту задачу, для которой она была разработана.
Физический ИИ стремится заменить некоторые или все эти блоки сетями, обученными на данных, обменивая точность, полученную вручную, на универсальность: модель, обученная на достаточных данных, переносится на ситуации, для которых она не была явно запрограммирована.
LinkКак архитектура JEPA заполняет блок «планирование»
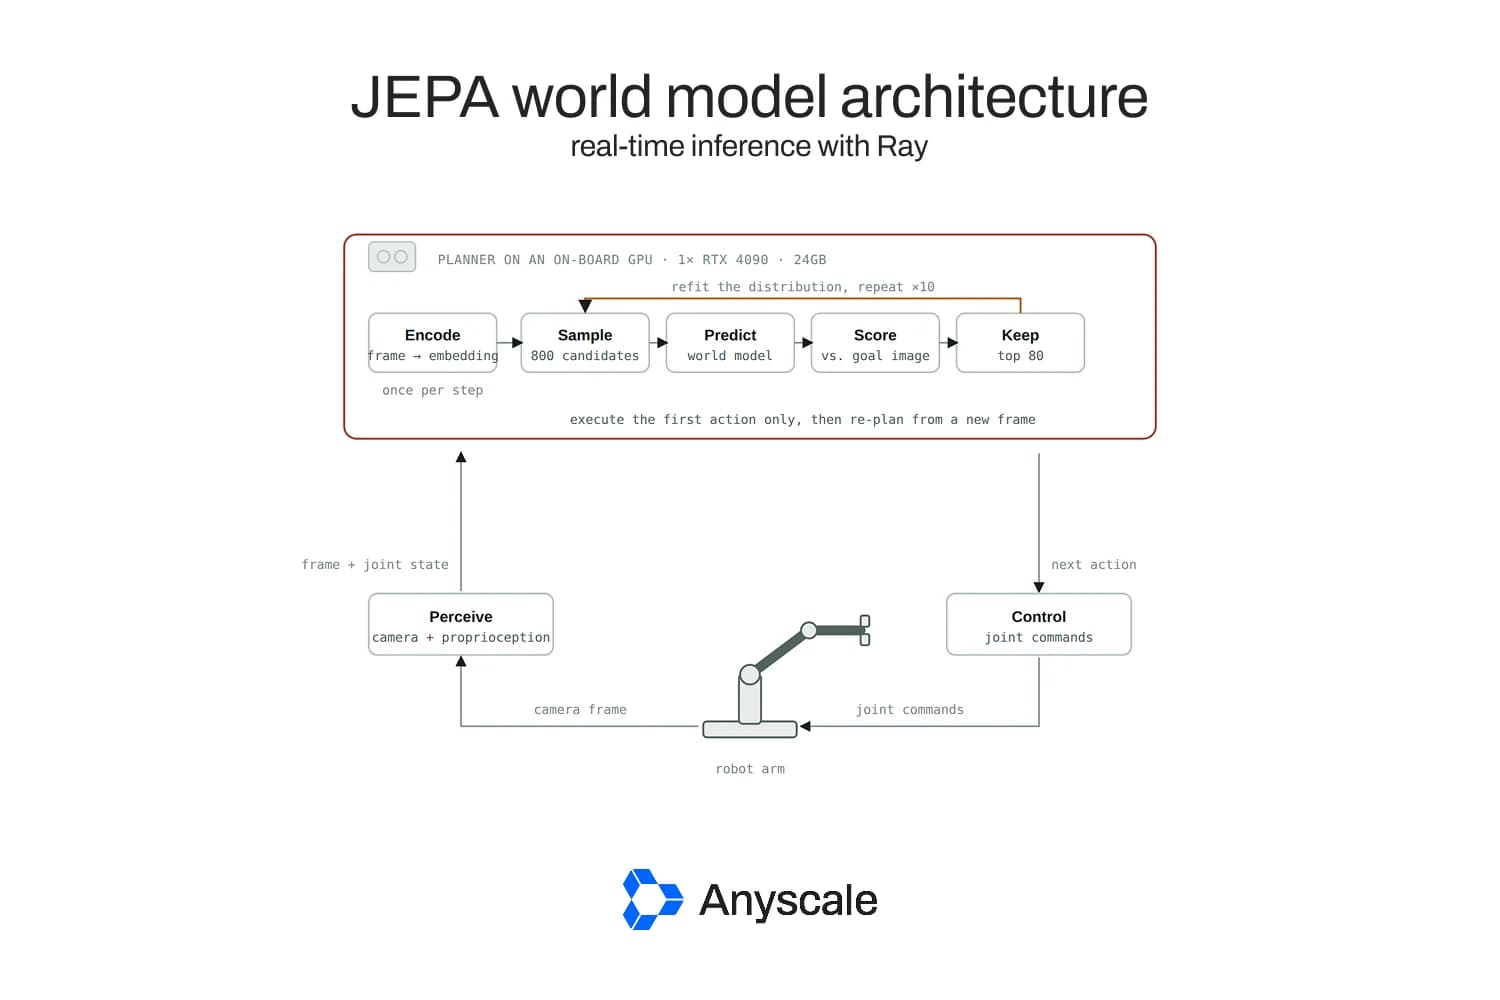
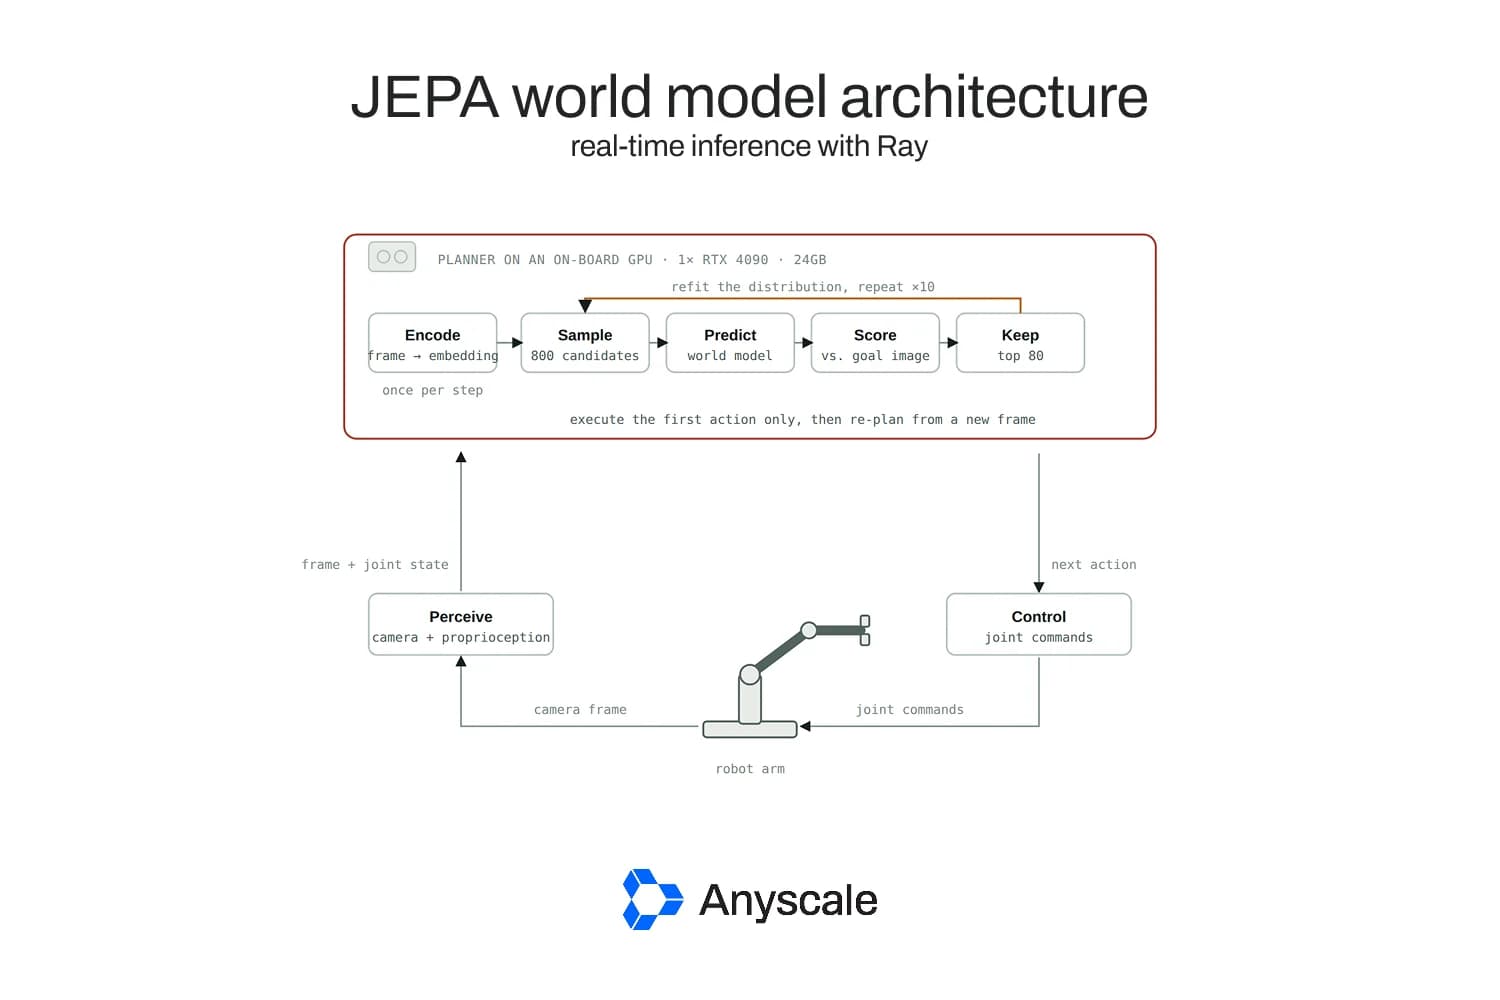
V-JEPA2-AC — одна из таких моделей. Она построена на архитектуре Joint-Embedding Predictive Architecture (JEPA). В этой архитектуре система решает, что манипулятор робота должен делать дальше, оценивая сотни возможных вариантов будущего с помощью модели и выбирая тот, который ближе всего к цели. На Рисунке 2 показан весь цикл, работающий на оборудовании, которое его исполняет.
Развернутая в режиме zero-shot на манипуляторах Franka в двух лабораториях, без дообучения под конкретную среду, V-JEPA2-AC показывает 65–80% успеха в задачах захвата и перемещения новых объектов. Это работало на одном RTX 4090. Однако такая конфигурация тратит 16 секунд на планирование каждого отдельного действия. Это недостаточно быстро для непрерывной работы.
LinkКуда на самом деле уходят шестнадцать секунд
Стоит разобрать один шаг планирования от начала до конца, потому что арифметика объясняет остальную часть этого документа. Манипулятор остается неподвижным. Кадр с камеры и целевое изображение кодируются один раз. Алгоритм поиска, CEM, затем извлекает 800 последовательностей действий-кандидатов из распределения Гаусса, центрированного вокруг текущего лучшего предположения, прогоняет каждую через предиктивную модель, оценивает результаты относительно целевого эмбеддинга, оставляет лучшие 80 и перецентрирует распределение Гаусса на них. Это один раунд, и он повторяется десять раз: примерно 8 000 оценок предиктора для одного небольшого движения одного манипулятора. Затем система выполняет только первое действие из выигрышной последовательности, отбрасывает остальные и начинает заново с нового кадра. Стоимость является структурной и повторяется на каждом шаге.
V-JEPA2-AC на одном бортовом GPU — 16 с / действие
Рисунок 2. Меняется только блок планирования. Робот по-прежнему захватывает кадр с камеры и состояние своих сочленений, а управление остается нетронутым, но планировщик в замкнутой форме заменяется моделью и поиском вокруг нее. Энкодер является частью модели, поэтому кодирование происходит здесь, один раз за шаг; последующий цикл из десяти раундов — это самая затратная часть.
Контроллер также является блокирующим: он ждет завершения предыдущего действия перед отправкой следующего, поэтому планирование никогда не перекрывается с движением. Робот делает паузу, планирует в течение шестнадцати секунд, двигается и снова делает паузу. Эта задержка, а не точность модели, является проблемой, которую этот документ призван решить.
Link02 · Подход
Мы используем подход, при котором сначала переносим инференс мировой модели с робота на облачный сервер. Хотя это вводит новые затраты на сетевой обмен данными на каждом шаге управления, они компенсируются другими улучшениями. Во-первых, это открывает возможность обслуживания модели на более мощном GPU. В этой реализации мы используем GPU NVIDIA A100-40GB, которые имеют больше памяти, чем 24 ГБ у RTX 4090, использованного в статье, и значительно большую пропускную способность bf16.
Тот же поиск на одном облачном GPU — 21,4 с / действие (измерено, A100, оптимизированная модель)
Рисунок 3. Блок планирования выносит инференс за пределы робота. Локально остаются только сенсоры и приводы, поэтому через сеть передается один кадр с камеры плюс состояние сочленений, а обратно возвращается один вектор действия.
Сам по себе более мощный GPU — это недостаточно. Эталонный планировщик Meta, запущенный без изменений на одном A100 с этими настройками, занимает 81,8 с на действие; с оптимизациями на уровне модели из Раздела 05 это занимает 21,4 с. Наши 81,8 с медленнее, чем 16 с в статье на 4090, потому что мы запускали выпущенный код планирования Meta «как есть» (fp32, 800 кандидатов × 10 раундов, горизонт в два шага); время в статье, вероятно, отражает другие настройки или точность. Каждое ускорение в этом посте измеряется относительно нашего собственного базового показателя 81,8 с на том же оборудовании. Быстрее, но манипулятор все еще останавливается между движениями.
Второй шаг — распределение нагрузки между несколькими GPU. Возможность появляется, если заметить, что в рамках одного раунда уточнения CEM развертывания (rollouts) могут вычисляться независимо и собираться перед переходом к следующему раунду. В статье они запускаются как один большой пакет на одном GPU; ничто не требует, чтобы они оставались на одном GPU. В нашей реализации мы используем один узел с восемью GPU (8× A100-40GB) на Anyscale.
Поиск, распределенный по кластеру Ray — 2,86 с / действие (измерено, 8× A100); 0,86 с при 3 раундах на шаг
Рисунок 4. Один шаг внутри блока планирования меняется. 800 кандидатов в раунде независимы, поэтому шаг прогнозирования распределяется по «теплым» репликам, которые уже содержат модель, и собирается перед оценкой. Десять раундов по-прежнему последовательны, что и задает нижний предел.
Мы реализуем это с помощью Ray.
Link03 · Введение в Ray
LinkОбщий фреймворк для превращения Python-кода в кластерную программу
Ray — это фреймворк с открытым исходным кодом, изначально созданный в RISELab Калифорнийского университета в Беркли, а ныне поддерживаемый Anyscale, для масштабирования обычного Python-кода с ноутбука на кластер без необходимости переписывания его как распределенной системы. Он предоставляет небольшой набор примитивов и сохраняет преимущественно последовательную структуру кода.
LinkRay Core
Ray Core имеет два строительных блока, которые важны здесь. Функция @ray.remote становится задачей (task), планируемой где-то в кластере и возвращающей future. Класс @ray.remote становится актором (actor): рабочим процессом с состоянием, закрепленным за машиной и, опционально, за GPU, который сохраняет загруженные веса модели в памяти между вызовами. Задачи подходят для разовой параллельной работы; акторы подходят для процесса, который один раз загружает чекпоинт с 1,2 миллиарда параметров, а затем отвечает на множество дешевых запросов.
LinkRay Serve
Ray Serve работает поверх Ray Core: объявления @serve.deployment достаточно для того, чтобы Ray управлял пулом реплик, маршрутизировал запросы и масштабировался под нагрузкой. Ray Core отвечает на вопрос, как запустить функцию на множестве воркеров; Ray Serve отвечает на вопрос, как представить её в виде сервиса, к которому обращаются другие системы — именно в таком виде нуждается контур управления робота: низкозадержковая конечная точка, вызываемая один раз за шаг.
Link04 · Реализация
LinkДва развертывания Ray Serve, объединенные вместе
Архитектура состоит из двух развертываний Ray Serve и связующего их дескриптора (handle). WorldModel — это уровень GPU: по одной реплике на GPU, каждая из которых содержит энкодер и предсказатель (мы запустили 8 реплик на 8 A100). Planner — это драйвер: он выполняет цикл CEM из десяти раундов, распределяет каждый раунд по этим репликам и обслуживает конечную точку, к которой робот обращается один раз за шаг управления. Такое объединение, а не использование отдельных акторов Ray Core, помещает их под контроль Serve: размещение, проверки работоспособности, перезапуски и декларативная конфигурация, которую KubeRay RayService может развернуть без простоев. На схеме ниже опущены внутренние детали; важно то, где происходит распределение нагрузки (fan-out). См. рисунок 5 для ознакомления со схемой развертывания.
serve_app.py — Ray Serve · архитектура, детали опущены
В основе дизайна лежат два решения. Уровень GPU зафиксирован на значении num_replicas=8, а не масштабируется автоматически, поскольку поиск, количество реплик в котором меняется в середине раунда, имеет непредсказуемую задержку, а цель состоит в обеспечении стабильного бюджета на шаг. Параметр max_ongoing_requests=1 заставляет каждую реплику обрабатывать по одному шарду за раз, поэтому 8-кратное распределение нагрузки направляет по одному шарду на каждый GPU вместо постановки нескольких в очередь на подмножестве. Внутри каждая реплика по-прежнему является актором Ray Core, поэтому веса остаются в памяти; разница в том, что Serve владеет жизненным циклом.
Рисунок 5: Ray Serve на Anyscale соединяет развертывание Planner, обращенное к роботу, с «теплыми» репликами WorldModel через DeploymentHandle, с одной моделью
Чему мы научились в процессе создания. Три детали определили задержку. Во-первых, латентные представления наблюдений и целей (2.8 МБ) попадают в объектное хранилище Ray один раз за план с помощью ray.put; каждая реплика считывает их из общей памяти и кэширует на своем GPU, поэтому каждый раунд перемещает только около 5 КБ данных о действиях-кандидатах и возвращает значения энергии, а вся доля Ray в раунде (распределение, сбор, уточнение) составляет менее 10 мс. Во-вторых, при max_ongoing_requests=1 стандартный маршрутизатор Serve «выбор из двух» (power-of-two-choices) иногда помещал два шарда на одну реплику, пока другая простаивала, удваивая время раунда; маршрутизатор запросов round-robin в Serve направляет шарды раунда на последовательные реплики, по одной на GPU (ноль коллизий за 50 раундов). В-третьих, наши процессы реплик Serve начинались с TORCHDYNAMO_DISABLE=1 в окружении, что молча превращало torch.compile в фиктивную операцию; удаление этой переменной в конструкторе реплики обеспечило ускорение в 1.35 раза.
Исходный код. Полная реализация, включая загрузку модели, путь быстрого скоринга, полный шаг уточнения CEM, два развертывания Serve, каждый скрипт бенчмарка и запускаемый ноутбук, находится в сопутствующем репозитории: https://github.com/anyscale/robotics_world_model_inference/tree/main/v3_realtime_inference_for_jepa
Link05 · Результаты
LinkИзмерено на 8× A100
Мы построили описанную выше архитектуру и измерили её на одном узле Anyscale с восемью GPU A100-40GB, используя настройки поиска из раздела 01 (800 кандидатов × 10 раундов, сохранение 80, горизонт 2). Точкой отсчета является эталонный планировщик Meta, запущенный без изменений в fp32 на одном A100: 81.8 с на действие. Перед добавлением GPU мы ускорили саму модель на одном GPU: KV-кэш по шагам развертывания (предсказатель является причинно-следственным по кадрам, поэтому предыдущие кадры никогда не требуют пересчета), bf16 с FlashAttention и torch.compile. Результат совпадает с эталонными энергиями (Пирсон r = 0.9999) и доводит один GPU до 21.4 с на действие, что в 4 раза быстрее.
Рисунок 6. Измеренное время планирования на действие. Ray Serve распределяет каждый раунд по 8 A100 (2.86 с, 29× быстрее эталона). Запуск 3 раундов поиска на шаг вместо 10 позволил достичь той же точности в тестах с замкнутым контуром (раздел 06), что дает 0.86 с на действие, 96× быстрее эталона.
Затем распределение нагрузки. 800 кандидатов каждого раунда распределяются между W репликами WorldModel, по одному GPU на каждую. Переход с 1 на 8 GPU сокращает время плана с 21.4 с до 2.86 с, ускорение в 7.5 раз. Одинаковые начальные числа (seeds) дают идентичные планы при любом количестве GPU, поэтому шардирование меняет скорость поиска, но не его результат. Модель задержки, предложенная в первом черновике этого поста, подтверждается: откалиброванная на нашем измеренном одно-GPU раунде (2.14 с), она предсказывает 2.94 с при 8 GPU против 2.86 с измеренных.
LinkЗадержка планирования в зависимости от размера кластера
Реплики A100-40GB на одном 8-GPU узле. Точки — измеренные значения; линия — модель задержки.
2.86 с / действие на 8 воркерах A100. Это в 7.5 раз быстрее, чем на одном A100, и в 29 раз быстрее эталонного планировщика Meta.
Рисунок 7. Задержка плана в зависимости от количества реплик GPU, измерено на 8× A100 (точки) в сравнении с моделью задержки, откалиброванной на измеренном одно-GPU раунде (линия; пунктир за пределами 8 GPU = проекция).
Модель: time(W) = 10 × ( r / effective(W) + 0.001с × (W − 1) ), где effective(W) = W / (1 + 0.008×(W−1)) и r — измеренный одно-GPU раунд, 2.14 с на A100. За пределами 8 GPU кривая выравнивается, так как доля каждого GPU в 800 кандидатах становится мала. Более крупные кластеры окупаются в основном за счет обслуживания большего количества роботов или более масштабных поисков на том же уровне.
Две вещи остаются неизмеренными: сетевая задержка между локальным роботом и облачным регионом, а также производительность на физическом манипуляторе (наши тесты с замкнутым контуром используют модель мира в качестве симулятора). «Холодный старт» остается вне пути запроса: реплики загружаются и компилируются примерно за 50 с во время развертывания, прежде чем они начнут принимать трафик. Разное пакетирование кандидатов не меняет точность: планы идентичны при 1, 2, 4 и 8 GPU.
Link06 · Дальнейшая оптимизация
LinkЧто попробовать, когда сам поиск перестает быть узким местом
Как только каждый раунд выполняется так быстро, как позволяют GPU, остается цепочка из десяти последовательных раундов, и следующие улучшения придут от реструктуризации цикла, а не от добавления GPU.
LinkA. Неблокирующее управление
Начните планирование шага t+1, пока робот еще выполняет шаг t. Это скрывает задержку планирования за временем выполнения, а не добавляет её, и это изменение контроллера, а не модели.
Измерено. Мы симулировали манипулятор, который тратит 1 с на действие и приземляется с ошибкой выполнения 4 мм. Блокирующий контроллер тратил 1.86 с на шаг (планирование, затем движение). Неблокирующее управление, планирующее шаг t+1 на основе предсказания модели мира о том, где окажется шаг t, тратило 1.04 с на шаг, т.е. само движение плюс 40 мс. Оно достигло той же итоговой точности, а 12-шаговый эпизод занял 15.3 с вместо 25.3 с.
Рисунок 8. Эпизоды с замкнутым контуром к цели на расстоянии 21.6 см, с моделью мира вместо робота. Слева: 3 раунда поиска на шаг достигают той же точности, что и 10, за треть времени планирования. Справа: неблокирующее управление убирает планировщик из критического пути робота.
LinkB. Warm-started CEM
Управление с отступающим горизонтом отбрасывает всё, кроме первого действия. Повторное использование остального для инициализации распределения следующего шага вместо нового гауссовского распределения позволяет каждой повторной планировке сходиться менее чем за десять раундов, сокращая последовательную цепочку, к которой параллелизм не имеет отношения.
Измерения. В замкнутых тестах три раунда на шаг (0,86 с на 8 A100) достигли той же точности, что и все десять раундов (2,83 с): оба варианта сходятся примерно на 4 см от цели, которая изначально находится на расстоянии 21,6 см. Разогрев от предыдущего плана сработал, но в этой задаче новый поиск из трёх раундов показал такой же результат, поэтому выигрыш был получен за счёт выполнения меньшего количества раундов. Сколько раундов нужно для задачи, стоит настраивать для каждой задачи.
LinkC. Батчинг на уровне флота
Уровень GPU, рассчитанный на одного робота, простаивает между его запросами. За эндпоинтом Serve тот же уровень обслуживает флот, и батчинг запросов может упаковывать шарды от разных роботов в один GPU-батч, амортизируя использование разогретых GPU для многих рук.
LinkD. Сжатие модели
Дистилляция или квантизация предиктора уменьшает сам вычислительный термин, независимо от того, на сколько работников он разделён. Это сочетается с распределением, а не конкурирует с ним.
LinkE. Оптимизация на уровне обслуживания
Предиктор прокручивает шаг за шагом по горизонту, поэтому то, на чём уже основано обслуживание LLM, переносится: кэширование KV между шагами роллаута, разделение префилла и декодирования, непрерывное батчинг. Это уменьшает тот же вычислительный термин с другой стороны, внутри того же развертывания Serve.
Реализовано. Кэширование KV между шагами роллаута вместе с bf16, FlashAttention и torch.compile является частью измеряемой системы. Это дает 4× на одном GPU и соответствует эталонным энергозатратам с точностью до r = 0,9999.
Link07 · Выводы
Шестнадцать секунд — это не дефект реализации. Это результат сознательного архитектурного выбора: модель JEPA предсказывает состояние, а не действия, поэтому действие должно быть найдено во время инференса, а не прочитано из головы политики. Это тот же компромисс, который делают агентные системы, когда они выбирают много кандидатов и оценивают их, и это дает ту же выгоду: систему, которую можно направить на новую цель без переобучения.
Четыре настройки делают этот компромисс конкретным. Ручная политика покупает действия в миллисекундах и платит за них в виде специфической для задачи инженерии. V-JEPA2-AC торгует этой скоростью за систему, которая принимает любую цель, которую вы можете сфотографировать. Перенос поиска в кластер возвращает скорость обратно, не жертвуя общностью, и делает это в инфраструктуре, а не в модели. Измерения на одном узле из восьми A100 показывают, что Ray Serve сокращает полный поиск с 82 с до 2,9 с на одно действие, причем распределение выполняет большую часть работы, а Ray добавляет менее 10 мс на раунд. Десять последовательных раундов устанавливают нижний предел, который не может быть изменён с помощью большего количества оборудования. Атака на этот нижний предел с меньшим количеством раундов на шаг приводит его к 0,86 с, а неблокирующее управление скрывает то, что остается, за движением самой руки.
LinkReferences
- Assran, M. et al. V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning. arXiv:2506.09985, 2025. arxiv.org/abs/2506.09985
Assran, M. et al. V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning. arXiv:2506.09985, 2025.
- Meta AI. Представляем мировую модель V-JEPA 2 и новые эталонные данные для физического мышления. ai.meta.com/blog/v-jepa-2-world-model-benchmarks
Meta AI. Представляем мировую модель V-JEPA 2 и новые эталонные данные для физического мышления.
- Проект Ray. Ray Core: ключевые концепции, задачи и акторы.
Проект Ray. Ray Core: ключевые концепции, задачи и акторы.
- Проект Ray. Документация Ray Serve. docs.ray.io/en/latest/serve
Проект Ray. Документация Ray Serve.
- Проект Ray. KubeRay: RayService. docs.ray.io/en/latest/cluster/kubernetes
Проект Ray. KubeRay: RayService.
Показатели времени планирования и успеха приведены в статье V-JEPA2-AC (arXiv:2506.09985). Размер кластера, параллельная архитектура CEM, модель задержки и весь показанный код являются независимой инженерной реализацией, построенной на основе опубликованной работы, не связанной с Meta AI или проектом Ray и не одобренной ими. Измерения задержки в разделах 05 и 06 были проведены на одном узле 8× A100-40GB на Anyscale (ноябрь 2026 года); расширение Figure 6 за пределы 8 GPU является проекцией.