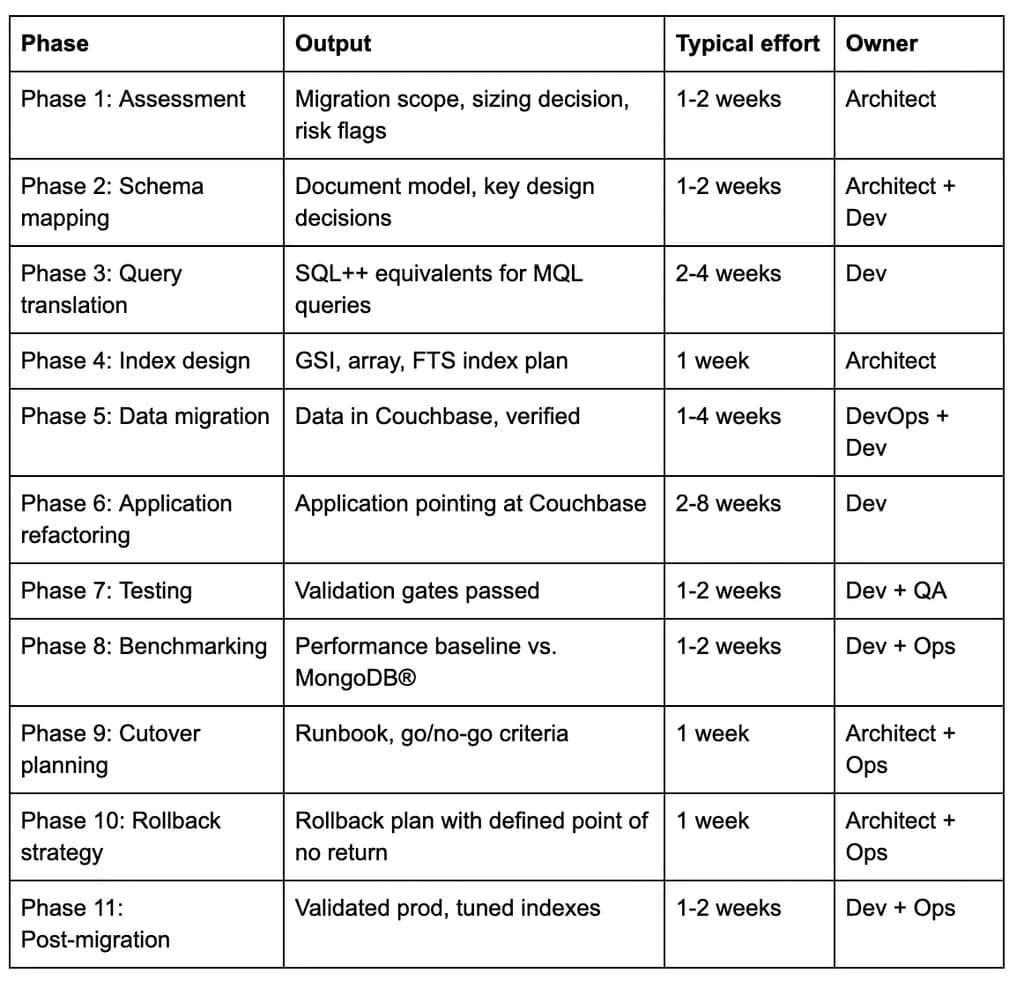
Миграция с MongoDB® на Couchbase включает 11 этапов: оценка, сопоставление схем, трансляция запросов, проектирование индексов, миграция данных, рефакторинг приложений, тестирование, бенчмаркинг, планирование переключения, стратегия отката и проверка после миграции. Перенос данных — это самая простая часть. Трансляция запросов и рефакторинг приложений — это то, на что инженерные команды тратят больше всего времени, а результаты первых тестов производительности следует рассматривать лишь как отправную точку, поскольку именно редизайн позволяет довести производительность до ожидаемого уровня.
Это руководство предназначено для ведущих инженеров-программистов и архитекторов решений, которые приняли решение оценить или выполнить миграцию. Оно не предназначено для читателей, которые все еще сравнивают поставщиков. Если вы все еще решаете, является ли Couchbase правильным выбором, начните с этого сравнения Couchbase и MongoDB® и вернитесь сюда, когда будете готовы планировать свой переход.
Вот краткий обзор того, что дает каждый этап, какой объем усилий обычно требуется и кто, как правило, отвечает за него:
Этап 1: Оценка миграции
Прежде чем писать какой-либо код миграции, сначала проведите инвентаризацию того, что вы на самом деле переносите. Эти данные помогут определить каждое последующее решение, включая то, выполнять ли миграцию напрямую или инкрементально, какое окно простоя является реалистичным и может ли приложение допускать промежуточные изменения схемы.
Ваша инвентаризация должна охватывать количество коллекций и объем документов, количество и типы индексов, сложность конвейеров агрегации, использование ODM или фреймворков (Mongoose, Spring Data MongoDB®, Morphia), шаблоны записи и требования к согласованности, а также любые специфические сервисы MongoDB® Atlas, которые вы используете, включая Atlas Search, Charts, Triggers или Device Sync. Специфические сервисы Atlas не имеют прямых аналогов в Couchbase, поэтому вам нужно будет принять соответствующие архитектурные решения до начала миграции.
Объем документов определяет ваш подход к миграции. Используйте следующие диапазоны в качестве отправной точки, а затем корректируйте их в зависимости от пропускной способности сети, допустимого времени простоя и оборудования:
Ваша оценка миграции также выявит три решения, которые влияют на каждый последующий этап. Она позволит вам определить допустимое окно простоя, может ли приложение работать в режиме двойного чтения во время перехода и может ли ваша команда принять изменения схемы до переключения.
Этап 2: Сопоставление схем и моделей данных
Преобразование BSON в JSON
Большинство данных MongoDB легко конвертируются из BSON в JSON, но несколько типов BSON требуют принятия явных решений перед миграцией:
- ObjectId: Couchbase хранит строковое представление. Вам нужно будет решить, сохранить ли строку ObjectId в качестве ключа документа или создать на ее основе новый ключ.
- Decimal128: Преобразуйте в число JSON, если это сохраняет требуемую точность. Если нет, сохраните его как строку и обновите приложение, чтобы при необходимости преобразовывать его обратно в числовое значение.
- BinData: Преобразуйте бинарные данные в строки в кодировке base64 во время миграции. Обновите приложение, чтобы при необходимости декодировать эти строки обратно в бинарные данные.
- Date: MongoDB хранит даты как метки времени UTC в миллисекундах, в то время как Couchbase обычно представляет их как строки ISO 8601 в формате JSON. Убедитесь, что приложение может читать и записывать правильный формат в период, когда используются обе базы данных.
Структурное сопоставление
Иерархия база данных/коллекция в MongoDB сопоставляется с иерархией бакет/область/коллекция в Couchbase. Одна база данных MongoDB становится бакетом Couchbase. Коллекции сопоставляются с коллекциями Couchbase внутри области. Распространенный шаблон — одна область на базу данных MongoDB, когда один бакет Couchbase объединяет несколько баз данных MongoDB.
Проектирование ключа документа
Couchbase поддерживает как доступ по ключу-значению, так и запросы к документам. Выбор правильных ключей документов позволяет вашему приложению извлекать документы напрямую по ключу вместо выполнения запроса, что может быть быстрее и эффективнее. Поиск по ключу-значению обычно занимает менее миллисекунды, тогда как запросы SQL++ требуют дополнительной обработки, даже если соответствующие поля проиндексированы.
Три шаблона проектирования ключей охватывают большинство случаев.
- Производный ключ от _id (например, “user::507f1f77bcf86cd799439011”) сохраняет идентификатор MongoDB и является вариантом с наименьшим сопротивлением.
- Составные ключи (например, “order::2026-09::customer-42”) кодируют несколько атрибутов, делают ключ самоописываемым и позволяют выполнять прямой поиск без вторичных индексов.
- Естественные ключи из бизнес-идентификаторов (адреса электронной почты, номера счетов, артикулы товаров) полностью устраняют необходимость в индексе поиска, когда бизнес-идентификатор всегда известен во время доступа.
Когда стоит пересмотреть модель, а не переносить ее
Прямой перенос (lift-and-shift) схемы MongoDB в Couchbase будет работать и является правильным выбором для команд, которым нужно двигаться быстро. Это оставляет потенциал производительности неиспользованным, но такой процесс обратим.
Командам, имеющим возможность для редизайна модели, следует рассмотреть три шаблона:
- Неограниченные встроенные массивы, которые бесконтрольно росли в MongoDB, могут быть разделены на отдельные документы в Couchbase.
- Ссылки, реализованные как соединения (lookups) в MongoDB, могут стать SQL++ JOIN, которые иногда более эффективны.
- Документы, приближающиеся к лимиту MongoDB в 16 МБ, следует разделить во время миграции, а не достигать лимита Couchbase в 20 МБ позже.
Этап 3: Трансляция запросов (MQL в SQL++)
SQL++ — это надмножество SQL, которое работает непосредственно с JSON. Для инженеров, знакомых с SQL, большая часть синтаксиса покажется привычной. Для инженеров, которые сначала изучили MongoDB, переход ментальной модели от поэтапных конвейеров агрегации к декларативному SQL — это то, на что команды тратят больше всего времени.
Таблица трансляции MQL в SQL++
Конвейеры агрегации сопоставляются с подзапросами SQL++ или CTE (предложения WITH). Поэтапная модель конвейера MongoDB сопоставляется с одним декларативным запросом в SQL++, который, как считают многие инженеры, легче осмыслить, как только они привыкнут к синтаксису. Усилия по трансляции масштабируются в зависимости от количества различных шаблонов запросов в кодовой базе, а не от объема данных. Например, кодовая база с 200 различными конвейерами агрегации требует больше работы по трансляции, чем база с 20, независимо от количества документов.
Помощник по кодированию Couchbase Capella iQ включает функцию трансляции запросов с поддержкой ИИ, которая преобразует MQL в SQL++ непосредственно в рабочей области запросов. Это полезно для ускорения работы с рутинными запросами, но результат следует проверять и тестировать перед использованием в продакшене, а не рассматривать как окончательный.
Этап 4: Трансляция и проектирование индексов
Проектирование индексов — это область, где мигрированные развертывания чаще всего требуют настройки, прежде чем они достигнут ожидаемой производительности. Выбор индексов в MongoDB кодирует шаблоны доступа MQL, а шаблоны доступа SQL++ отличаются. Перенос индексов без их перепроектирования под структуру запросов SQL++ является наиболее частой причиной разочарования от первых тестов производительности.
Сопоставление типов индексов
Последовательность индексации для больших наборов данных
Для наборов данных объемом более 100 млн документов создание индексов во время загрузки данных значительно увеличивает время миграции. Правильная последовательность для крупных миграций — сначала загрузить все данные, а затем создать индексы. Согласно диапазонам размеров в Фазе 1, для наборов данных объемом более 100 млн документов следует использовать параллельную загрузку с последующим созданием индексов.
Index Advisor
После миграции инструмент Index Advisor в Couchbase Query Workbench анализирует фактические шаблоны запросов и рекомендует отсутствующие или избыточные индексы. Запуск Index Advisor после начальной загрузки и после первого этапа тестирования производительности (Фаза 8) — это самый надежный способ исправить структуру индексов, которые были перенесены из MongoDB, а не спроектированы специально для механизма запросов Couchbase.
Фаза 5: Выбор подхода к миграции данных
Правильный подход к миграции зависит от размера набора данных, допустимого времени простоя и того, может ли приложение работать в режиме двойного чтения во время перехода. Существует два варианта: прямая миграция и инкрементальная миграция.
Прямая миграция с помощью cbmigrate
cbmigrate — это инструмент командной строки (CLI), который переносит коллекции MongoDB напрямую в Couchbase Capella. Он управляет подключением, передачей данных, опциональной миграцией индексов и базовым преобразованием типов. Плагины для VS Code и JetBrains обеспечивают интеграцию cbmigrate в среду разработки.
Базовая последовательность миграции:
- Запустите cbmigrate connect для настройки подключений к источнику (MongoDB) и месту назначения (Couchbase Capella).
- Запустите cbmigrate migrate –collection <имя> для переноса коллекции.
- Повторяйте для каждой коллекции или используйте –all-collections для пакетной передачи.
- Создавайте индексы после завершения загрузки (для больших коллекций не используйте –migrate-indexes во время загрузки).
- Проверьте количество документов и содержимое выборочных документов.
Флаг миграции индексов cbmigrate (–migrate-indexes) переносит определения индексов, но не оптимизированные структуры индексов, обсуждавшиеся в Фазе 4. Этот флаг помогает быстро запустить новое развертывание, но вам следует просмотреть и оптимизировать перенесенные индексы с помощью Index Advisor перед вводом системы в эксплуатацию.
Инкрементальная миграция с помощью Apache Kafka®
Путь через Apache Kafka® использует исходный коннектор MongoDB для потоковой передачи изменений из oplog MongoDB и коннектор-приемник Couchbase для записи этих изменений в Couchbase Capella. Этот подход поддерживает практически нулевое время простоя, так как позволяет Couchbase «догнать» текущее состояние MongoDB перед переключением приложения.
Конфигурация Apache Kafka требует трех компонентов: (1) работающего кластера Kafka (Confluent Cloud — один из широко используемых управляемых вариантов), (2) MongoDB Kafka Connector в качестве источника и (3) Couchbase Kafka Connector в качестве приемника.
Ключевыми параметрами конфигурации являются токен возобновления (который определяет, с какого места в oplog начинается потоковая передача) и стратегия извлечения ключей приемника (которая определяет, как _id из MongoDB отображается на ключи документов Couchbase).
Два эксплуатационных аспекта, заслуживающих особого внимания:
- Мониторинг задержки потока — отслеживайте задержку потребителя для коннектора Kafka Connect, чтобы видеть, обрабатывает ли он записи так же быстро, как они поступают. Растущая задержка может указывать на то, что коннектор не справляется.
- Обработка ошибок преобразования — настройте коннектор на перенаправление записей, которые не прошли преобразование, в топик для «мертвых» сообщений (dead-letter topic), вместо остановки потока. Это позволит вам исследовать и устранять сбои, не прерывая миграцию.
Фаза 6: Рефакторинг приложения
Усилия по рефакторингу приложения зависят от количества различных шаблонов запросов и степени связности ODM в кодовой базе, а не от объема данных. Кодовая база с прямыми вызовами драйверов и 50 написанными вручную конвейерами агрегации требует меньше усилий по рефакторингу, чем база, построенная на жестко связанном ODM с 300 хуками на уровне коллекций.
Сравнение операций SDK
Для команд, работающих с Python, Couchbase Python SDK следует тому же шаблону: couchbase.collection.get(key) для операций KV и couchbase.cluster.query(sql) для запросов SQL++. Интерфейс SDK согласован для Java, .NET, Go, Ruby, PHP и Kotlin.
Пути миграции фреймворков
- Пользователи Mongoose могут перейти на Ottoman.js, который предоставляет ODM-интерфейс, похожий на Mongoose, для Couchbase с определениями моделей, проверкой схемы и построением запросов.
- Пользователи Spring Data MongoDB могут перейти на Spring Data Couchbase, который сопоставляет шаблоны репозиториев MongoDB с эквивалентами Couchbase.
- Пользователи Entity Framework имеют провайдер EF Core для Couchbase.
- Для рабочих нагрузок ИИ, использующих LangChain или LlamaIndex, оба фреймворка имеют интеграции с Couchbase, которые используют собственный векторный поиск Couchbase, вместо того чтобы требовать отдельное векторное хранилище.
Фаза 7: Тестирование и проверка данных
Тщательное тестирование и проверка необходимы перед переключением. Не продолжайте работу, не пройдя все три уровня проверки: сверку данных, паритет запросов и функциональную корректность.
Сверка данных
Сравните количество документов в каждой коллекции между MongoDB и Couchbase. Для выборочных документов (10% — разумная начальная выборка для коллекций объемом менее 10 млн документов) вычислите контрольную сумму или хэш для исходных и целевых документов и сравните их. Отмечайте любые документы, где количество или хэш не совпадают, для ручной проверки.
Уделите особое внимание нескольким случаям, которые могут вызвать различия между двумя базами данных. Проверьте, как каждая из них обрабатывает значения null по сравнению с отсутствующими полями, поскольку MongoDB различает поле, установленное в null, и поле, которое не существует, а поведение запросов Couchbase может различаться в зависимости от операции. Также проверьте форматы дат, сравнение строк Unicode и любые документы, близкие к лимиту размера MongoDB в 16 МБ.
Тестирование паритета запросов
Запускайте эквивалентные запросы MQL и SQL++ для одного и того же набора данных и сравнивайте их результаты. Результаты не обязательно должны отображаться в одном и том же порядке, если приложение не полагается на определенный порядок сортировки. Однако фактические результаты должны совпадать, включая значения, возвращаемые запросами агрегации. Любые различия в поведении запросов или результатах агрегации следует исследовать до миграции.
Создайте набор тестов паритета запросов до начала Фазы 5 (миграция данных), чтобы он был готов к запуску, как только данные окажутся в Couchbase. Запуск его сразу после загрузки, до завершения рефакторинга приложения, позволяет выявить ошибки трансляции на ранней стадии, когда их исправление обходится дешевле всего.
Функциональный набор тестов как «ворота» перед переключением
Перед принятием решения о переключении все интеграционные тесты должны пройти проверку в Couchbase, чтобы подтвердить, что приложение работает правильно от начала до конца. Функциональный набор тестов является критерием «годен/не годен» для Фазы 9, а не этапом проверки после миграции.
Фаза 8: Тестирование производительности
Первые тесты производительности после миграции методом «lift-and-shift» редко отражают то, что может обеспечить настроенное развертывание. Это связано с тем, что индексы не были переработаны для шаблонов доступа SQL++, ключи документов еще не оптимизированы для доступа KV, а архитектура Couchbase, ориентированная на память, еще не успела прогреть свой кэш. Рассматривайте эти ранние результаты как признак того, что миграция не завершена, а не как окончательный вердикт по производительности.
Методология тестирования производительности
Всегда проводите тестирование с использованием реалистичных объемов данных и набора запросов, отражающих реальную работу вашего приложения. Простые тесты с однородными рабочими нагрузками, такие как последовательная вставка или повторяющиеся операции чтения одного типа, не покажут, как Couchbase ведет себя в реальных условиях, поэтому не используйте их для принятия решений о запуске.
Обязательно измеряйте задержку p95 и p99, а не только среднее время отклика. Эти показатели демонстрируют, сколько времени занимают более медленные запросы, и помогают выявить задержки, которые могут скрываться за средними значениями. Перед измерением производительности дайте кэшу Couchbase время на прогрев. Couchbase использует архитектуру, ориентированную на работу с памятью, поэтому измерения, выполненные во время загрузки данных в память, могут не отражать типичную производительность.
Зафиксируйте следующие конкретные показатели:
- Задержка чтения и записи KV (p50, p95, p99) при целевом количестве одновременных подключений
- Задержка запросов SQL++ по шаблону запроса (не агрегированная)
- Время построения индекса для полного производственного набора данных
- Пропускная способность при целевой параллельности (операций в секунду)
- Использование памяти при нагрузке на рабочий набор
Интерпретация результатов тестирования
- Если задержка p99 выше, чем у MongoDB после начальной загрузки, запустите Index Advisor (Этап 4), прежде чем делать выводы.
- Если задержка KV высока, пересмотрите дизайн ключей (Этап 2). Поиск по ключу документа обычно занимает менее миллисекунды, в то время как поиск по вторичному индексу на индексированных полях обычно занимает несколько миллисекунд.
- Если запросы агрегации SQL++ работают медленно, проверьте покрытие индексов и подумайте, можно ли реструктурировать агрегацию.
Сравните результаты тестирования после настройки с базовыми показателями Этапа 8, чтобы подтвердить правильность направления улучшений перед переходом.
Этап 9: Планирование перехода
План перехода — это регламент. В нем прописан каждый шаг, ответственные за его выполнение, порядок действий и условия для запуска отката в случае возникновения проблем. Одного списка шагов недостаточно. План должен содержать четкие и понятные инструкции, которым команда сможет следовать во время миграции.
Критерии готовности (Go/no-go)
Критерии готовности — это контрольные точки проверки на Этапе 7: сверка данных, паритет запросов и функциональная корректность. Если какая-либо проверка не пройдена к запланированному времени перехода, переход не выполняется. Определите этот порог четко до начала окна перехода, а не во время него.
Подходы к переходу в зависимости от типа миграции
Процесс перехода зависит от того, как вы переносили данные. Прямая миграция требует запланированного окна обслуживания, в то время как инкрементальная миграция на основе Kafka может сократить время простоя до секунд.
Прямая миграция
Запланируйте окно обслуживания для завершения финальной синхронизации и переключения приложения на Couchbase Capella.
- Остановите все операции записи в MongoDB.
- Запустите финальную синхронизацию cbmigrate, чтобы захватить все оставшиеся изменения.
- Сверьте количество документов между MongoDB и Couchbase.
- Обновите строки подключения приложения, чтобы они указывали на Couchbase Capella.
- Запустите дымовые тесты, чтобы убедиться, что приложение работает корректно.
- Подтвердите успешность миграции и завершите окно обслуживания.
Время простоя зависит от того, сколько времени займут финальная синхронизация и дымовые тесты.
Инкрементальная миграция с использованием Kafka
Kafka поддерживает актуальность данных в Couchbase по мере внесения изменений в MongoDB, что позволяет выполнить переключение без длительного окна обслуживания.
- Убедитесь, что задержка потребителя Kafka равна нулю, что означает, что поток догнал изменения.
- Переключите запись приложения на Couchbase Capella с помощью функционального флага или изменения строки подключения.
- Убедитесь, что новые записи поступают в Couchbase.
- Подтвердите, что MongoDB больше не получает записи от приложения.
- Завершите период двойной записи после того, как убедитесь, что приложение корректно работает с Couchbase.
Переход происходит в момент переключения записи приложения на Couchbase. При полностью синхронизированном потоке и правильно подготовленном переключении время простоя можно сократить до секунд.
Особенности двойной записи
Если приложение записывает данные одновременно в MongoDB и Couchbase во время окна перехода, порядок записи не гарантирует согласованность между обеими системами. Это допустимо для окон перехода, измеряемых минутами, но становится риском для согласованности, если окна измеряются часами. Определите максимально допустимое окно двойной записи до начала перехода.
Этап 10: Стратегия отката
Откат становится сложнее, чем дольше Couchbase обслуживает производственные записи. После первой производственной записи в Couchbase откат — это уже не просто изменение строки подключения. Он требует сверки записей, которые произошли в Couchbase, но не в MongoDB.
Определение окна отката
Держите MongoDB в режиме ожидания только для чтения (не выводите из эксплуатации) в течение как минимум 48–72 часов после перехода, в зависимости от объема записи. В течение этого окна обратный поток Kafka или экспорт Couchbase на определенный момент времени могут восстановить записи, которые необходимо воспроизвести в MongoDB для чистого отката. После этого окна откат требует ручной сверки расходящихся данных, что операционно сложно.
Точка невозврата — это не временной порог, а порог объема данных. Когда объем записей, произошедших в Couchbase, но не в MongoDB, превышает тот, который команда может сверить за доступное время отката, откат становится нецелесообразным. Определите этот порог до перехода.
Что зафиксировать перед переходом
Перед открытием окна перехода убедитесь, что у вас есть следующее.
- Сохраните полный снимок MongoDB. Используйте mongodump или экспорт Atlas, чтобы зафиксировать состояние базы данных на момент перехода.
- Запишите контрольную точку миграции. Задокументируйте точное смещение Kafka или временную метку запуска cbmigrate, которые знаменуют окончание миграции.
- Проверьте путь отката. Если вы используете обратный поток Kafka для отправки изменений обратно в MongoDB, убедитесь, что он настроен и протестирован до перехода.
Для производственных миграций тестирование процесса отката перед переходом является обязательным. Не предполагайте, что он сработает, когда вам это понадобится.
Этап 11: Проверка и настройка после миграции
Контрольный список проверки
Выполните эти проверки в течение первых 24 часов после перехода:
- Задержка запросов относительно базовых показателей Этапа 8 (p95 и p99 должны быть на уровне или ниже базовых)
- Обзор использования индексов в Query Workbench (неиспользуемые индексы следует удалить, так как они потребляют память без пользы)
- Квота памяти и соответствие рабочему набору (убедитесь, что часто используемые данные помещаются в настроенную квоту памяти, либо увеличьте квоту или скорректируйте политику вытеснения)
- Уровень ошибок по типам операций (ошибки KV, ошибки запросов и частота тайм-аутов должны быть на уровне или ниже показателей до перехода)
Возможности, доступные после миграции
После завершения миграции команды могут воспользоваться преимуществами Couchbase. Репликация между центрами обработки данных (XDCR) обеспечивает активные развертывания в нескольких регионах с настраиваемым разрешением конфликтов. Couchbase Capella полностью управляет запланированным резервным копированием и восстановлением, включая восстановление на определенный момент времени. Couchbase Mobile через App Services или Sync Gateway добавляет постоянную мобильную и периферийную синхронизацию для приложений, которым требуется автономная работа. Векторный поиск Couchbase позволяет создавать конвейеры RAG и семантический поиск без использования отдельного векторного хранилища.
Команды, использующие Capella, должны применять встроенные панели мониторинга Couchbase. Команды, использующие самостоятельно управляемый Couchbase Server, могут использовать метрики Prometheus через экспортер Couchbase. Ключевые метрики для мониторинга в установившемся режиме те же, что измерялись на этапе 8: задержка KV по операциям, задержка SQL++ запросов по шаблонам и использование памяти относительно квоты.
Часто задаваемые вопросы по миграции с MongoDB на Couchbase
Можно ли выполнить миграцию с MongoDB на Couchbase с нулевым временем простоя? Почти нулевое время простоя достижимо через инкрементальный путь Kafka. Поток Kafka догоняет текущее состояние MongoDB до того, как приложение переключится, что делает момент переключения переключением флага функции, измеряемым секундами, а не окном обслуживания, измеряемым часами. Компромиссом является эксплуатационная сложность. Запуск и мониторинг кластера Kafka, настройка двух коннекторов, обработка сбоев потоков и определение окна двойной записи добавляют значительные накладные расходы по сравнению с прямой миграцией с запланированным окном простоя.
Как конвертировать запросы MongoDB в SQL++? Начните с таблицы перевода на этапе 3 этого руководства, которая охватывает наиболее распространенные операторы MQL и их эквиваленты в SQL++. Для конвейеров агрегации сопоставьте каждый этап с соответствующим предложением SQL++: $match становится WHERE, $group становится GROUP BY, $sort становится ORDER BY, $unwind становится UNNEST, а $lookup становится JOIN.
Capella iQ, ИИ-помощник, встроенный в интерфейс Couchbase Capella, может генерировать эквиваленты SQL++ для запросов MQL напрямую. Используйте его для ускорения начального перевода, но обязательно проверяйте и тестируйте результат перед использованием в рабочей среде.
Мигрирует ли cbmigrate индексы вместе с данными? Миграция индексов поддерживается через флаг –migrate-indexes и является необязательной. Для большинства миграций это стоит сделать, чтобы быстро получить рабочее развертывание, но мигрированные индексы следует просмотреть и настроить с помощью Index Advisor перед использованием в рабочей среде. Индексы MongoDB кодируют шаблоны доступа MQL, а шаблоны доступа SQL++ часто достаточно сильно отличаются, чтобы сделать прямой перенос неоптимальным.
Что происходит с полями _id из MongoDB в Couchbase? Поле _id становится ключом документа Couchbase (доступным как META().id в SQL++). По умолчанию cbmigrate извлекает ключ документа из _id, поэтому существующие идентификаторы сохраняются. Ключевое проектное решение заключается в том, сохранять ли необработанное значение _id в качестве ключа или реструктурировать его в составной или естественный ключ. Хорошо спроектированный ключ позволяет выполнять KV-поиск по идентификатору документа за доли миллисекунды без поиска по вторичному индексу, что является наиболее важным решением по производительности на этапе 2.
Можно ли откатить миграцию с MongoDB на Couchbase? Да, но сложность отката резко возрастает после первой записи в Couchbase в рабочей среде. До того, как произойдут какие-либо записи, откат — это просто изменение строки подключения. После начала записи откат требует согласования данных в Couchbase, которых нет в MongoDB. Практическое окно отката составляет от 48 до 72 часов после переключения, в течение которых можно использовать обратный поток Kafka или экспорт Couchbase на определенный момент времени для восстановления записей. После этого окна откат превращается в проект по разработке данных. Определите и протестируйте свой план отката до переключения, а не после.