Метрики, которые имеют значение (и как их измерять)
Когда вы тестируете систему на масштабе нескольких миллионов векторов, можно обойтись простыми скриптами. Но когда вы переходите порог в 1 миллиард векторов, «производительность» перестает быть просто вопросом скорости и становится вопросом выживания — выживания подсистемы памяти, пропускной способности сети и сборщика мусора.
Прежде чем написать хотя бы одну строку кода для генерации нагрузки для этого бенчмарка, нам нужно было договориться о том, что именно мы измеряем. В распределенной векторной базе данных стандартные метрики, такие как «задержка» (latency) и «загрузка CPU», ведут себя иначе. Ниже приведено описание нашей системы оценки и скрытые ловушки, которые мы обнаружили для каждой метрики.
1. Задержка: «Хвост» управляет процессом (P99)
В партиционированном индексе «средняя» задержка (Avg) — это тщеславная метрика. Она скрывает сбои. Мы сосредоточились исключительно на задержках P99 (99-й перцентиль) и P99.9.
- Определение: Время, необходимое для возврата результата для самых медленных 1% запросов.
- Заметки с полей: При масштабе в миллиард векторов ваш запрос, скорее всего, является операцией «scatter-gather» (рассылка-сбор). Вы обращаетесь к 100+ партициям, и время отклика определяется самой медленной из них. Если 99 узлов отвечают за 10 мс, а один узел выполняет паузу сборки мусора (GC) и тратит 500 мс, ваша задержка P99 составит 500 мс.
- Методология: Мы измеряли задержку со стороны клиента, а не сервера. Серверные метрики упускают время, затраченное на сетевую очередь или десериализацию огромного набора результатов.
2. Recall@K против Accuracy@K
«Быстро» бесполезно, если результаты нерелевантны. Но при масштабе в миллиард векторов мы не можем вручную проверить, являются ли результаты «релевантными». Мы полагаемся на математическую близость.
- Recall@K: Процент из топ-K истинных ближайших соседей (найденных методом грубой силы или ground truth), которые присутствуют в ваших топ-K результатах, независимо от порядка.
- Accuracy@K: Мы определили Accuracy@K как метрику, отличную от Recall@K, для измерения абсолютной точности. Для одного запроса она проверяет, возвращен ли единственный истинный ближайший сосед на самой верхней позиции (позиция 1). Итоговая метрика — это среднее значение этих бинарных (да/нет) результатов по множеству запросов.
3. Пропускная способность (QPS)
- Определение: Количество успешных запросов в секунду, которое кластер может обработать до того, как задержка выйдет за рамки нашего SLA.
- Заметки с полей: Существует «колено кривой». По мере добавления одновременных пользователей QPS растет линейно, пока не упрется в стену (насыщение CPU или конкуренция за блокировки), после чего задержка резко возрастает. Мы не просто сообщали «Макс. QPS»; вместо этого мы сообщали «Макс. QPS при приемлемом уровне recall». В векторном поиске часто можно удвоить QPS, снизив recall на 5%. Мы строго измеряли QPS при фиксированном целевом показателе recall (например, 80%, 90% и т. д.).
4. Время построения индекса
- Определение: Время по настенным часам, необходимое для загрузки 1 миллиарда векторов и обеспечения возможности поиска по ним.
- Заметки с полей: Это самый сложный тест. Если построение занимает три дня и прерывается на 99%, вы теряете три дня. Мы научились измерять «скорость загрузки» (векторов/сек) отдельно от «скорости индексации».
- Ключевая проблема: Налог на «слияние» (merge). Многие векторные индексы (например, LSM-деревья или сегменты Lucene) работают быстро в начале, но замедляются по мере роста индекса и запуска фонового слияния. Мы измеряли время построения не только для первого миллиарда векторов, но и для инкрементальных обновлений после того, как миллиард был загружен.
- Определения: RSS (resident set size): Фактически используемая физическая оперативная память. Размер индекса (на диске): Объем занимаемого места в хранилище.
- RSS (resident set size): Фактически используемая физическая оперативная память.
- Размер индекса (на диске): Объем занимаемого места в хранилище.
- Заметки с полей: Для «гипермасштабирования» (что подразумевает, что набор данных больше объема RAM) RSS является критической зоной. Если RSS достигает предела, OOM-killer (out of memory) операционной системы убивает процесс базы данных. Мы отслеживали пики RSS во время тяжелых фаз «ребалансировки графа», а не только в состоянии покоя. Мы также отслеживали байты на вектор, чтобы понять, насколько эффективна наша квантование (SQ/PQ).
6. Использование CPU: Ловушка конкурентности
- Определение: Загрузка CPU по всем ядрам в кластере.
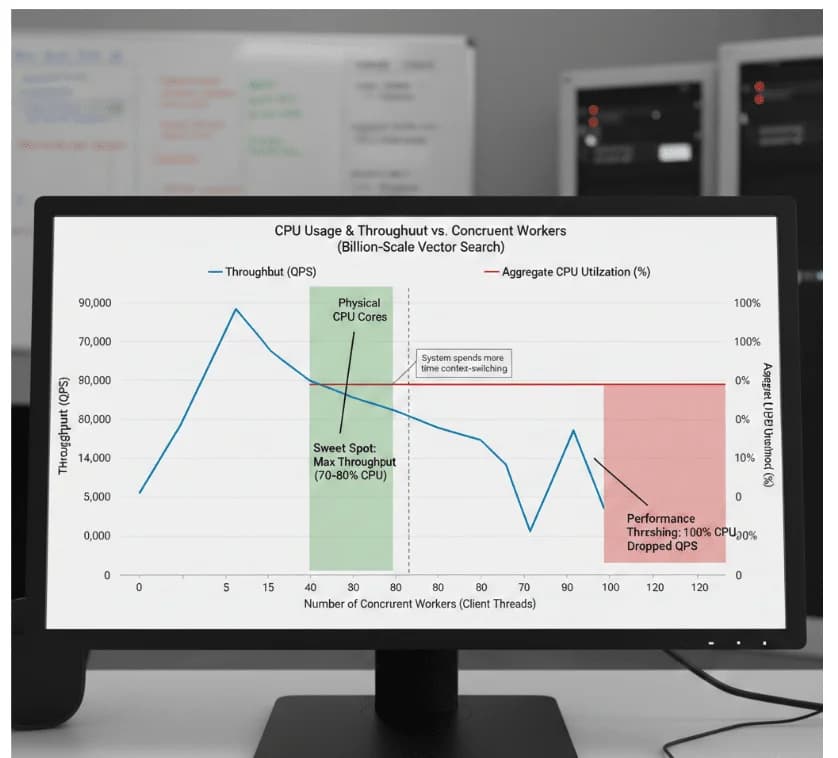
- Заметки с полей: Эта метрика продиктовала конфигурацию нашего тестового клиента. Слишком мало клиентов: CPU загружен на 50%, и мы не тестируем предел. Слишком много клиентов: CPU достигает 100%, и система тратит больше времени на переключение контекста, чем на поиск.
- Слишком мало клиентов: CPU загружен на 50%, и мы не тестируем предел.
- Слишком много клиентов: CPU достигает 100%, и система тратит больше времени на переключение контекста, чем на поиск.
Методология: Мы использовали загрузку CPU для калибровки наших «параллельных воркеров». Мы обнаружили, что оптимальная точка обычно чуть выше количества физических ядер, чтобы скрыть ожидания ввода-вывода. Дальнейшее увеличение вызывало «трешинг» (thrashing), при котором пропускная способность фактически падала по мере добавления нагрузки.
Поиск набора данных для миллиарда векторов (и недостающая истина)
Когда вы читаете технические документы от поставщиков векторных баз данных, они часто умалчивают о том, откуда взялись данные. Они говорят: «Мы протестировали на 1 миллиарде векторов», как будто они просто скачали zip-файл.
В реальности для инженера по производительности, проводящего бенчмаркинг гипермасштабируемого векторного индекса, поиск набора данных часто сложнее, чем проведение самого теста. Нам нужны были не просто «данные». Нам нужен был миллиард векторов, чтобы найти пределы масштабируемости, и векторы, похожие на реальные производственные данные, чтобы понять, имеют ли эти пределы значение для реальной рабочей нагрузки. Оказалось, что это два разных набора данных.
Три набора данных, три задачи
В итоге мы использовали три набора данных. Каждый из них существует потому, что предыдущий не мог ответить на вопрос, который мы исследовали.
SIFT-1B — источник каждого числа масштаба миллиардов в этой статье. Мы выбрали его по одной причине: это единственный набор данных на 1 млрд, который поставляется с опубликованным ground truth, поэтому recall на миллиарде можно было проверить по официальным ответам, а не по нашим собственным. Подвох в том, что это uint8 с 128 измерениями. Наша производственная нагрузка и большинство современных AI-нагрузок используют float32 с 1000+ измерениями. Тестирование оптимизированного под float индекса на 128-мерных целочисленных данных — это как тестировать Ferrari на дизельном топливе. Это доказывает, что двигатель работает в масштабе, но паттерны пропускной способности памяти совершенно другие.
LAION-100M решает проблему типов. Это реальные CLIP-эмбеддинги изображений, float32, 768 измерений, с публичным ground truth. Их загрузка была основной причиной, по которой мы написали драйвер Couchbase для VectorDBBench. При 100 млн x 768 измерений вы перемещаете ~300 ГБ чисел с плавающей запятой, чего достаточно, чтобы увидеть, как ведет себя float-индекс, когда стоимость одного вектора в шесть раз выше, чем у SIFT. Это все еще десятая часть масштаба, а 768 измерений все еще далеки от того, что выдает LLM класса 7B.
BookCorpus-10M — это то, что нам пришлось создать самим. В открытом доступе нет ничего с 1536+ измерениями в сколько-нибудь интересном масштабе. Остальная часть этой главы посвящена тому, почему это так и что потребовалось для создания нашего собственного набора.
1. Пустыня open source для многомерных наборов данных (и почему мы не могли просто сгенерировать свои)
Найдя SIFT и LAION, мы начали искать еще один набор данных: набор float32 с размерностью LLM (от 1536 до 4096) в масштабе, близком к миллиарду. Такого не существует.
- Разрыв в доступности: другие наборы данных float32, существующие на данный момент (Deep1B, набор Yandex Text-to-Image), имеют размерность от 96 до 200, что ничем не лучше LAION. После 1000 измерений публичные наборы данных просто заканчиваются. Самые большие хостинговые наборы LLM-эмбеддингов, которые нам удалось найти, исчислялись десятками миллионов векторов. При объеме 1 млрд x 1536-d вы получаете 6 ТБ «сырых» чисел с плавающей запятой, которые никто не предоставляет бесплатно.
Поэтому очевидной следующей мыслью было сгенерировать свои собственные, используя реальную модель. Но это уперлось в другую стену.
- Математика денег: один 1536-мерный вектор — это немного. Но генерация миллиарда таких векторов через API для эмбеддингов — совсем другое дело. Если предположить, что на отрывок приходится около 256 токенов, то 1 млрд элементов — это около 256 млрд токенов: примерно 5000 долларов при использовании text-embedding-3-small или более 30 000 долларов при использовании text-embedding-3-large по прейскуранту (примерно вдвое меньше через Batch API). И это для 1536 или 3072 измерений, еще до того, как у вас появится хоть один эталонный показатель.
- Вычислительный барьер: запуск модели своими силами позволяет избежать счетов за API, но нам нужен был вывод размерности 4096, что означает использование LLM класса 7B, а не небольшой модели эмбеддингов. При скорости около 170 векторов в секунду, которую мы замерили на нашем кластере из пяти GPU, генерация миллиарда отрывков заняла бы более двух месяцев. Нам нужен был бенчмарк сейчас, а не в следующем квартале.
Что мы сделали на самом деле
Мы отказались от идеи создания 1 млрд реальных эмбеддингов и задались другим вопросом: какой самый большой набор данных, близкий к промышленным стандартам, мы можем позволить себе создать один раз и больше никогда не переделывать?
Ответом стали 10 миллионов векторов размерностью 4096. Мы взяли набор данных BookCorpus с Hugging Face и прогнали его через Llama 2 (развернутую через Ollama) на кластере из пяти GPU-машин, каждая из которых работала над своей частью корпуса. Вместо того чтобы записывать векторы в файлы и загружать их позже, каждая машина записывала их напрямую в сервис «ключ-значение» Couchbase по мере обработки. В конечном итоге выполнение задачи заняло 16 часов при совокупной скорости около 173 векторов в секунду.
При 4096 измерениях этот набор данных обладает более высокой размерностью, чем любой публичный эталонный набор данных. Кроме того, он пугающе близок к тому, что выдают реальные LLM-конвейеры, в чем и заключалась суть.
Вторая часть хитрости — это cbbackupmgr. Как только загрузка завершилась, мы сделали резервную копию бакета. Набор данных 10 млн x 4096 занимает около 164 ГБ «сырых» чисел с плавающей запятой, а его восстановление занимает всего 2–3 минуты. С тех пор мы восстанавливали его десятки раз. Мы один раз заплатили за 16 часов работы GPU и больше никогда не были вынуждены платить за это снова.
Таким образом, лестница выстроена осознанно: SIFT-1B для масштаба, LAION-100M для реальных чисел с плавающей запятой и 10M BookCorpus для размерности LLM. Там, где результаты расходятся, набор 10M обычно является тем, который говорит вам что-то о вашей реальной рабочей нагрузке.
2. Парадокс «истины» (Ground Truth)
SIFT-1B и LAION-100M поставляются с готовыми ответами. Как только мы создали свой собственный набор данных, мы потеряли это преимущество, и это оказалось самой болезненной частью всего процесса. Чтобы измерить производительность, нам нужны задержка и пропускная способность. Чтобы измерить корректность, нам нужен Recall@K. А чтобы измерить Recall@K, нам нужна «истина» (ground truth). Именно здесь все начинает разваливаться.
- Барьер проверки: «истина» вычисляется путем выполнения полного перебора (Flat scan) всего набора данных для поиска фактических ближайших соседей.
- Стена памяти: использование полного перебора наивным способом означает загрузку всего набора данных в оперативную память. 10 млн x 4096-d — это 164 ГБ; при 100 млн — 1,6 ТБ; при 1 млрд — 16 ТБ. Вся причина, по которой мы тестируем гипермасштабируемый индекс, заключается в том, что данные не помещаются в оперативную память.
- Результат: без «истины» задержка P99 в 10 мс не имеет смысла. База данных может просто выдавать случайный мусор на высокой скорости.
Что мы сделали на самом деле
Мы перестали пытаться вычислить одну гигантскую «истину» и вместо этого разделили проблему на части.
Мы разбили набор из 10 млн на 10 разделов по 1 млн векторов каждый, примерно по 16 ГБ на раздел, чтобы полный перебор одного раздела комфортно помещался на одной машине. Каждый вектор несет в себе ID своего раздела, и мы вычислили точную «истину» для нашего набора запросов внутри каждого раздела. Затем мы делаем запрос с ключом раздела, чтобы база данных искала только в этом разделе, и сравниваем результаты с его «истиной».
Выяснились две неожиданные вещи:
- «Сырой» набор данных без опубликованной «истины» внезапно стал доступным для запросов и проверки. Одно это разблокировало большую часть тестирования корректности на наборе 10M.
- Ключ раздела, который мы добавили для «истины», — это тот же ключ, который использует механизм запросов для исключения разделов. Таким образом, структура, которая сделала проверку корректности возможной, также дала нам основу для масштабирования, описанную в следующей главе. Один набор данных, два эксперимента.
Компромисс заключается в том, что это дает вам полноту (recall) внутри раздела, а не глобальную полноту по всему набору. Оглядываясь назад, разрыв меньше, чем кажется: сохраняйте списки top-K для каждого раздела для каждого запроса, а затем объединяйте их в глобальный top-K с помощью K-way сортировки P x K кандидатов. «Стена памяти» никогда на самом деле не была связана с памятью; она была связана с выполнением одного полного прохода по данным. Метод не меняется при 100 млн или 1 млрд векторов, меняется только количество разделов.
3. Несоответствие набора запросов
SIFT-1B и LAION-100M поставляются с наборами запросов, взятыми из того же распределения, что и базовые данные. Наш собственный набор данных не имел ничего, и мы быстро поняли, что нельзя просто сгенерировать случайный набор запросов.
- Пустота: если бы мы использовали random.uniform() для генерации запросов, они бы статистически попадали в пустые пространства между нашими кластерами данных. База данных все равно вернула бы каких-то соседей, но все они были бы далеко, искажая измерения задержки и не имея ничего общего с реальной рабочей нагрузкой, ориентированной на поиск близких совпадений.
- Требование: векторы запросов должны следовать тому же распределению, что и набор данных, включая те же скопления и многообразия.
Что мы сделали на самом деле
Это оказалось проще всего решить, потому что под векторами у нас был реальный текст.
Во-первых, мы отложили 1000 сгенерированных векторов и использовали их в качестве запросов. Поскольку они были получены из той же модели по тому же корпусу, они попадают внутрь реальных кластеров и имеют реальных ближайших соседей. (Убедитесь, что отложенные векторы не находятся в индексе. Иначе ближайшим соседом каждого запроса будет он сам на нулевом расстоянии, что сделает ваши показатели полноты фиктивными.)
Во-вторых, и это рекомендуемый подход для всех, у кого есть доступ к исходному тексту: мы сгенерировали 1000 вопросов на естественном языке об отрывках из корпуса и встроили их в ту же модель. Они выглядят как реальные пользовательские запросы. Они связаны с данными, но никогда не вставлялись в индекс, что делает этот случай более сложным и реалистичным.
Отложенный набор показывает наилучший сценарий работы индекса. Набор вопросов показывает то, что увидят пользователи. В итоге мы сообщили о полноте для обоих случаев, и разрыв между ними сам по себе оказался информативным.
Налог на «Scatter-Gather»: сила исключения разделов
Когда вы масштабируете векторный индекс до миллиарда элементов, вы неизбежно переходите от одного узла к распределенному кластеру, и ваш индекс разбивается на разделы. С этого момента каждый запрос имеет скрытый ценник, который не имеет ничего общего с тем, насколько быстр любой отдельный узел.
В стандартном распределенном векторном поиске каждый запрос представляет собой операцию «scatter-gather» (рассылка-сбор). Ваш запрос транслируется на каждый раздел (partition) в кластере. Каждый раздел должен активироваться, использовать свой процессор для обхода локального графа HNSW/Vamana и отправить отчет. Затем координатор объединяет результаты. Это работает, и при хорошо спроектированном движке система масштабируется: вы добавляете узлы, разделы распределяются, и количество запросов в секунду (QPS) растет. Мы наблюдали именно это на составном индексе.
Но обратите внимание на то, что не меняется при добавлении узлов. Запрос, затрагивающий 100 разделов, по-прежнему затрагивает 100 разделов. У вас больше машин, выполняющих тот же общий объем работы на запрос, а это означает, что пропускная способность на ядро, а следовательно, и стоимость одного запроса остаются неизменными. Scatter-gather позволяет вам купить большую пропускную способность. Но он никогда не позволяет получить ее бесплатно.
Полевые заметки: куда на самом деле уходит процессорное время
Что сделало это очевидным для нас, так это наблюдение за загрузкой процессора на каждом разделе во время глобального поиска на наборе данных 1B SIFT. Запрос по одному вектору «зажигал» каждый раздел в кластере. Подавляющее большинство из них выполняли полный обход графа только для того, чтобы не внести никакого вклада в итоговый топ-K. Ответ находился в нескольких разделах; остальные тратили процессорное время, чтобы подтвердить, что у них его нет.
Это и есть налог на scatter-gather: дело не в том, что он не масштабируется, а в том, что большая часть работы, которую он масштабирует, тратится впустую.
Именно здесь исключение разделов (partition elimination) меняет правила игры.
- Проблема: при глобальном поиске запрос «синие кроссовки Nike» активирует раздел, содержащий данные о «промышленном оборудовании». Этот раздел тратит реальные процессорные циклы на поиск кроссовок, которых у него нет, просто чтобы сообщить: «здесь нет ничего релевантного».
- Оптимизация: если вы «помечаете» свои векторы ключом раздела (например, category_id или tenant_id), движок запросов становится хирургически точным. Он считывает ключ из запроса и отправляет его только в те разделы, которые содержат ответ.
- Результат: в нашей конфигурации из 10 разделов запрос с ключом затрагивал один из 10 разделов, устраняя 90% работы на запрос еще до того, как был пройден хотя бы один граф.
Почему это «чит-код» для тестировщика производительности:
С точки зрения бенчмаркинга, исключение разделов — это тот рычаг, который меняет стоимость запроса, а не просто количество машин, оплачивающих его.
- Пропускная способность на ядро растет, а не только общая пропускная способность. Если запрос попадает только в 1/10 часть разделов, тот же кластер может, в принципе, обслуживать почти в 10 раз больше одновременных пользователей. Добавление узлов теперь дает кумулятивный эффект, а не просто позволяет поддерживать темп.
- P99 улучшается. Хвостовая задержка (tail latency) в системе с веерной рассылкой определяется самым медленным разделом, которого вы касаетесь. Вероятность столкнуться с «отстающим» (пауза GC, холодный кэш страниц или «шумный сосед») растет с каждым разделом в веерной рассылке. При вероятности задержки p на раздел, шанс того, что хотя бы один из N разделов будет медленным, составляет 1 − (1 − p)^N. Сократите N со 100 до 10, и «хвост» станет значительно спокойнее без вмешательства в работу движка. Это эффект «хвоста в масштабе», и исключение разделов — самое дешевое известное нам решение этой проблемы.
- Это решение по компоновке, а не функция движка. Вот что должны учитывать тестировщики производительности: вы можете получить это почти на любом распределенном индексе, если у ваших данных есть естественный ключ и вы выполняете разбиение по нему. Задача движка — соблюдать этот ключ; выигрыш достигается за счет модели данных.
Перспективы на будущее: что нам нужно, чтобы решить эти проблемы
Мы все еще ищем стандартизированное решение этих проблем. Чтобы сделать бенчмаркинг 1B+ доступным для инженеров не из FAANG, индустрии нужно:
- «Стандартный» Float32-1B с размерностью LLM: существуют SIFT-1B и LAION-100M, но нет общедоступного хостингового набора данных 1B с размерностью 1536+ для бенчмаркинга векторных баз данных (что-то вроде TPC-C для SQL), хранящегося в удобном для потоковой передачи формате (например, Parquet или Arrow), а не в виде сырых двоичных блобов.
- Инструменты для распределенного определения ground truth: инструмент с открытым исходным кодом, который может вычислять ground truth для 1B+ векторов путем разбиения и слияния (то, что мы делали вручную для 10M), чтобы никому не требовалась машина с 16 ТБ оперативной памяти для проверки своих результатов.
- Процедурные генераторы: стандартный алгоритм, который может процедурно генерировать «реалистичные» векторные распределения «на лету», проверенные на реальных эмбеддингах, чтобы мы могли генерировать 1B векторов исключительно с помощью процессора на этапе загрузки, без необходимости сетевых загрузок или вывода на GPU.