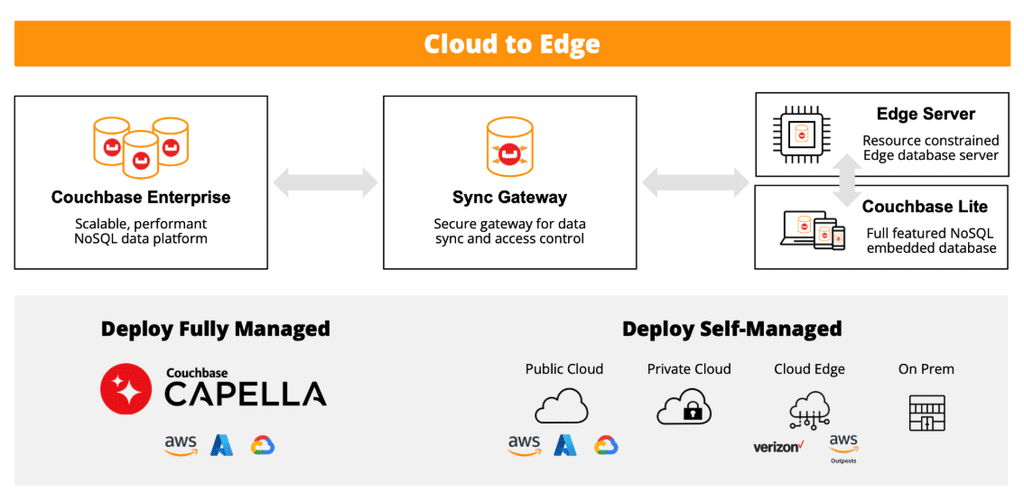
«Проще в обслуживании» означает восстановление после ошибок с точностью до секунды, масштабирование без ожидания окна обслуживания, шифрование всего без подключения дополнительных инструментов и репликацию между облаками без тикетов в брандмауэре для каждого узла. «Умнее в поиске» означает, что ИИ-приложения получают более точные ответы на основе имеющихся у вас данных, ваше озеро данных присоединяется к разговору без ETL-конвейера, а разработчики могут задавать уточняющие вопросы на обычном естественном языке.
Couchbase Server 8.5 дает два обещания: им проще управлять в масштабах предприятия, и он стал умнее в поиске. В настоящее время этот выпуск находится на этапе закрытого предварительного тестирования (зарегистрируйтесь здесь) для команд, использующих Couchbase Server Enterprise Edition, а общая доступность (GA) ожидается в январе 2027 года.
Вот как это выглядит на практике и какую проблему решает каждый компонент.
Как Couchbase Server 8.5 упрощает корпоративные операции?
Вы выбрали Couchbase Server, потому что вашим приложениям необходимо сохранять высокую скорость при пиковых нагрузках и оставаться доступными при сбое узла. Эта часть не меняется. Изменилось всё, что находится вокруг нее. Теперь агенты искусственного интеллекта пишут в вашу базу данных. Наборы данных продолжают расти. Ваша служба безопасности хочет, чтобы каждый байт был зашифрован, а сетевая команда хочет меньше открытых портов, а не больше.
Сервер 8.5 берет на себя четыре задачи, которые обычно заставляют вашу операционную команду заниматься устранением последствий, позволяя ей вернуться к запланированной работе.
Восстановление с точностью до секунды до совершения ошибки
Представьте обычный вторник. Последнее полное резервное копирование выполнялось в полночь. В 14:03 кто-то запускает удаление с пропущенным фильтром. Возможно, это уставший инженер. Возможно, это агент искусственного интеллекта, который работает быстро, неутомимо и временами очень уверен в неправильном условии WHERE.
Сегодня лучший вариант для вас — вчерашнее ночное резервное копирование. Это означает потерю 14 часов заказов, бронирований или претензий, их ручное восстановление, а затем долгий разговор с вашими аудиторами. Никому не нравится этот разговор.
Версия 8.5 помогает на двух фронтах:
- Восстановление на определенный момент времени (PITR) восстанавливает данные с точностью до конкретной секунды. Непрерывное резервное копирование отправляет каждое изменение в хранилище резервных копий с частотой до двух минут. Когда что-то идет не так, вы выбираете секунду перед ошибкой и выполняете восстановление. Вы можете ограничить область восстановления одной коллекцией, чтобы одно неудачное удаление не откатывало всю корзину.
- Неизменяемые резервные копии отправляются в объектное хранилище, заблокированное на период хранения (в AWS, Google Cloud или Azure). Никто не может изменить или удалить их до окончания этого периода, включая злоумышленника с украденными учетными данными администратора. Это основывается на таких функциях, как Amazon S3 Object Lock, часто называемых хранилищем WORM (запись один раз, чтение многократно). PITR работает в корзинах, использующих движок хранения Magma.
Результат: вы теряете секунды данных, а не часы, и программы-вымогатели не смогут незаметно отредактировать вашу страховочную сеть. Когда терять и перестраивать приходится меньше, следующий анализ инцидентов проходит гораздо быстрее.
Добавление емкости без окна обслуживания
Couchbase Server уже позволяет добавлять узлы, пока ваше приложение остается в сети. Однако данные все равно должны перемещаться на новые узлы. Этот процесс называется перебалансировкой, и до сих пор он перемещал данные по одному документу за раз. В крупном кластере это настолько медленно, что многие команды планируют его на ночь и выходные. Или они добавляют емкость за недели до пиковой нагрузки и платят за нее все это время.
Это реальные деньги, потраченные на простаты аппаратного обеспечения. Это также превращает простую задачу масштабирования в проект с тикетом на изменение и, во многих компаниях, с заказом пиццы на предстоящую ночь.
Версия 8.5 помогает на трех фронтах:
- Файловая перебалансировка копирует целые файлы данных между узлами вместо отдельных документов. В ходе нашего тестирования она работала в среднем в 4 раза быстрее. Ваши результаты будут зависеть от ваших данных и оборудования.
- 30 ТБ на узел — это в три раза больше предыдущего лимита, поэтому очень большие наборы данных помещаются на меньшем количестве серверов.
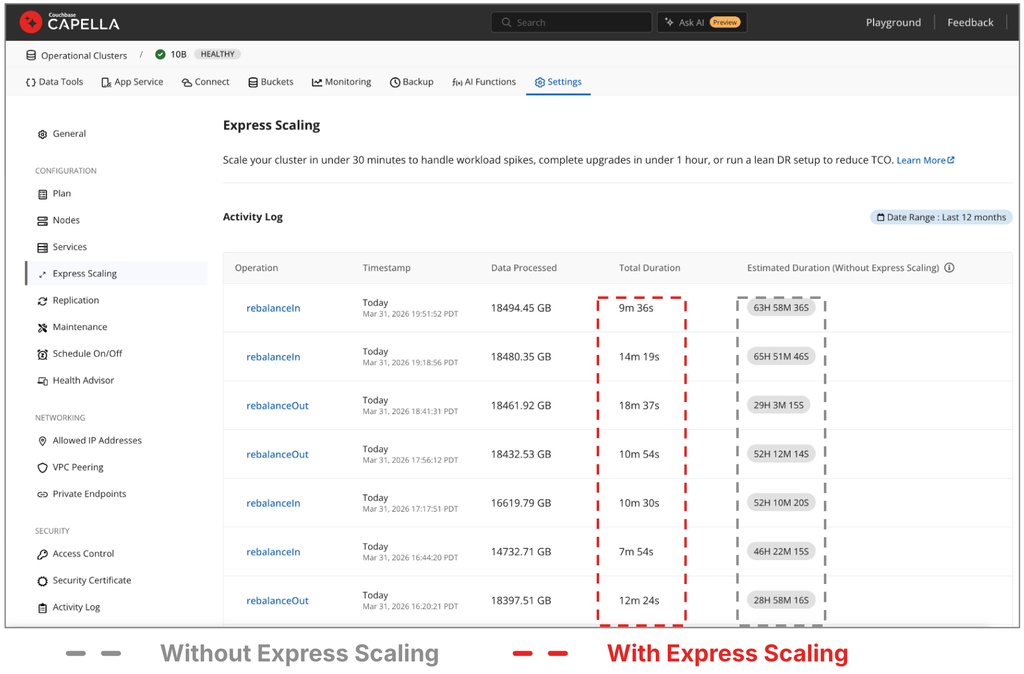
- Capella Express Scaling на базе версии 8.5 идет еще дальше для Capella на AWS. Новые узлы загружают свои данные параллельно из облачного объектного хранилища вместо их копирования с загруженных узлов. В ходе внутреннего тестирования масштабирование 10 ТБ на узел заняло менее 30 минут. Эта функция находится на собственном этапе закрытого предварительного тестирования, поэтому уточняйте информацию у вашей команды по работе с клиентами.
Результат: вы добавляете емкость в день, когда она вам нужна, размещаете больше рабочих нагрузок на каждом кластере и перестаете покупать оборудование под трафик, который еще не появился.
Устранение уязвимостей безопасности без подключения дополнительных инструментов
Шифрование данных в состоянии покоя обычно означает покупку и администрирование еще одного уровня, например дисковой утилиты или стороннего продукта. В этих уровнях остаются пробелы. Журналы и файлы конфигурации — это именно те места, где аудиторы находят незашифрованные данные. И аудиторы очень любят хорошие пробелы.
Версия 8.5 закрывает эти пробелы внутри базы данных:
- Встроенное шифрование данных в состоянии покоя теперь охватывает все, что Couchbase записывает на диск: данные, индексы, поиск, журналы, файлы аудита и конфигурацию. Ключи остаются в уже используемой вами системе управления ключами и меняются по расписанию без простоев. В ходе нашего тестирования затраты на пропускную способность составляли в среднем единицы процентов.
- JWT и единый вход (SSO) заменяют сохраненные пароли для пользователей и служб.
- Встроенное хранилище учетных данных содержит ключи для облачного хранения и провайдеров ИИ-моделей, поэтому секреты не попадают в файлы конфигурации.
Результат: меньше замечаний по результатам аудита, меньше инструментов для управления и на один разговор меньше на тему «мы думали, что это закрыто».
Репликация с меньшим количеством правил брандмауэра и меньшими затратами на передачу данных
Репликация между центрами обработки данных (XDCR) поддерживает синхронизацию кластеров между регионами и облаками в обоих направлениях. Это работает хорошо. Однако традиционно исходному кластеру требовался прямой доступ к каждому узлу целевого кластера. В Kubernetes, за частной ссылкой облачного провайдера или на периферийном узле это означает множество портов для каждого узла, которые сетевые команды не очень любят.
Здесь есть и финансовая сторона. В полномасштабной глобальной ячеистой сети, где каждый кластер реплицируется в каждый другой кластер, одно и то же изменение может передаваться более одного раза. Каждая лишняя поездка отображается в облачном счете как передача данных.
Версия 8.5 делает репликацию более удобной для вашей сети и вашего бюджета:
- XDCR через Cloud Native Gateway. Репликация теперь может осуществляться через Cloud Native Gateway по портам HTTPS с использованием gRPC. Целевой кластер предоставляет одну конечную точку вместо каждого узла, поэтому ваша сетевая команда один раз одобряет одну дверь.
- Отправка только локальных изменений. В полномасштабной ячеистой сети каждый кластер пересылает только те изменения, которые начались в нем, и только один раз. Меньшее количество дублирующегося трафика означает меньший счет за передачу данных.
- Поэтапные учетные данные. Заранее добавьте второй набор учетных данных к соединению XDCR. Когда старые перестанут работать, XDCR переключится самостоятельно, поэтому смена учетных данных не нарушит репликацию.
Благодаря этим обновлениям репликация вписывается в стандартные облачные сети, обходится дешевле в обслуживании и переживает вашу следующую смену паролей.
Как Couchbase Server 8.5 делает запросы более интеллектуальными?
Вторая тема посвящена получению лучших результатов с меньшими инфраструктурными затратами. У большинства команд уже есть необходимые им данные. Они просто рассредоточены по базе данных, векторному хранилищу и озеру данных, а задания синхронизации объединяют их все воедино. Сервер 8.5 переносит большую часть этой работы в один SQL-запрос с новыми способами использования SQL++ от Couchbase. SQL++ — это SQL для JSON. Любой, кто пишет на SQL, может использовать его.
Поиск точного совпадения и правильного значения в одном запросе
Большинство проектов в сфере ИИ начинаются с добавления автономной векторной базы данных рядом с операционной. Затем появляются задачи синхронизации. Затем появляются тикеты в службу поддержки, когда ИИ отвечает на основе вчерашних данных.
Существует и вторая проблема: векторный поиск понимает смысл того, что вы имеете в виду, но не всегда понимает то, что вы напечатали. Он может пропустить точные совпадения, такие как SKU, код ошибки или номер детали 4471B. Полнотекстовый поиск имеет противоположную проблему. Ваши пользователи столкнутся с обеими.
Server 8.5 помогает решить обе проблемы:
- Гибридный поиск в SQL++ объединяет результаты ключевых слов и векторов в одном запросе. Он также может смешивать разреженные векторы (в стиле ключевых слов) и плотные векторы (в стиле смысла). Затем он объединяет оценки в единый ранжированный список с использованием таких методов, как ранжирование на основе взаимного ранга (RRF), которое объединяет рейтинги из разных поисковых запросов.
- Бинарная квантизация сохраняет векторы в компактном виде. В векторных индексах Hyperscale и Composite она сократила объем памяти индекса примерно на 75% по сравнению с 8-битной квантизацией в ходе нашего тестирования. Память обычно является самой дорогой статьей в счете за базу данных, поэтому именно здесь пилотные проекты ИИ перестают быть слишком дорогими для масштабирования.
Результат: надежные ответы ИИ, на одну базу данных меньше для защиты и патчей, а также меньшие расходы на память.
Вы можете проверить, есть ли у вас эта проблема сегодня, без необходимости предварительного просмотра. Поищите в своей текущей системе точный номер детали или код ошибки. Если лучший результат только звучит похоже, вы нашли пробел, который устраняет гибридный поиск.
Запрашивайте свое озеро данных без его копирования
Вот типичная настройка: данные вашего реального приложения находятся в Couchbase, но их агрегированная история — в озере данных. Кто-то построил конвейер ETL для копирования одних данных в другие, чтобы приложение могло показать пожизненную ценность клиента рядом с сегодняшним заказом. Конвейеры ETL — это самый дорогой способ устареть данным из всех, когда-либо изобретенных. Каждый конвейер — это код, который нужно поддерживать, вторая копия, за которую нужно платить, и данные, которые уже устарели к моменту их получения.
Server 8.5 позволяет озеру оставаться озером:
- Внешние коллекции для Apache Iceberg. Укажите Couchbase Server на таблицы Apache Iceberg в Amazon S3, Google Cloud Storage или Azure и запрашивайте их так же, как любую другую коллекцию.
- Один запрос SQL++ для обоих источников. Объединяйте оперативные данные в реальном времени с историческими данными в одном запросе. Ничто не перемещается и не копируется.
Это создано для объединения оперативных данных с историей внутри приложения или рабочего процесса ИИ. Это не предназначено для тяжелой аналитики, для которой используется Couchbase Operational Insights.
Все это означает меньше конвейеров, за которыми нужно присматривать, отсутствие дубликатов копий, за которые нужно платить, и ответы, которые объединяют «прямо сейчас» с записанной историей ваших данных.
Задавайте уточняющие вопросы на простом английском языке
Начиная с Couchbase Server 8.0, USING AI превращает вопросы на простом английском в запросы SQL++. Это работает через SDK, REST API и командную строку. Однако в 8.0 каждый вопрос был отдельным, как будто вы разговариваете с кем-то без кратковременной памяти.
Server 8.5 превращает это в диалог. Спросите, сколько отелей находится в Хーフ-Мун-Бей, затем скажите «покажи мне его детали», и он поймет, какой именно отель вы имеете в виду. Приостановите чат, сходите на обед, обновите некоторые данные с помощью обычного SQL++ и возобновите работу позже с сохраненным контекстом. Вы также можете обучить его своим бизнес-терминам, например тому, что означает «чистая выручка» в вашей компании.
Одна важная деталь: USING AI выполняет только запросы SELECT самостоятельно. Если вопрос превращается в insert, update или delete, он возвращает запрос в виде текста и не выполняет его.
Цель поддержки диалогов заключается в том, чтобы разработчики тратили меньше времени на написание одноразовых запросов, а люди, ожидающие ответов, получали их быстрее.
Что ждет Couchbase Server 8.5 в будущем?
Запуск базы данных в масштабе предприятия не должен означать потерю данных за день из-за одного неудачного удаления, ожидания выходных для добавления емкости или открытия порта брандмауэра для каждого узла. Получение хороших ответов не должно требовать второй базы данных и трех конвейеров. Couchbase Server 8.5 — наш ответ на обе проблемы. Им проще управлять, а запрашивать данные в нем умнее, и все это на том же движке, которому вы уже доверяете.
Если вы посетили нашу конференцию пользователей Catalyst, то смогли лично познакомиться с версией 8.5, включая демонстрации восстановления на момент времени и шлюза Cloud Native Gateway. (Видео с мероприятия скоро появятся на нашем канале YouTube!) Общий выпуск (GA) ожидается в январе 2027 года. Если вы хотите попробовать ее раньше на собственной рабочей нагрузке, запросите место в закрытом превью.