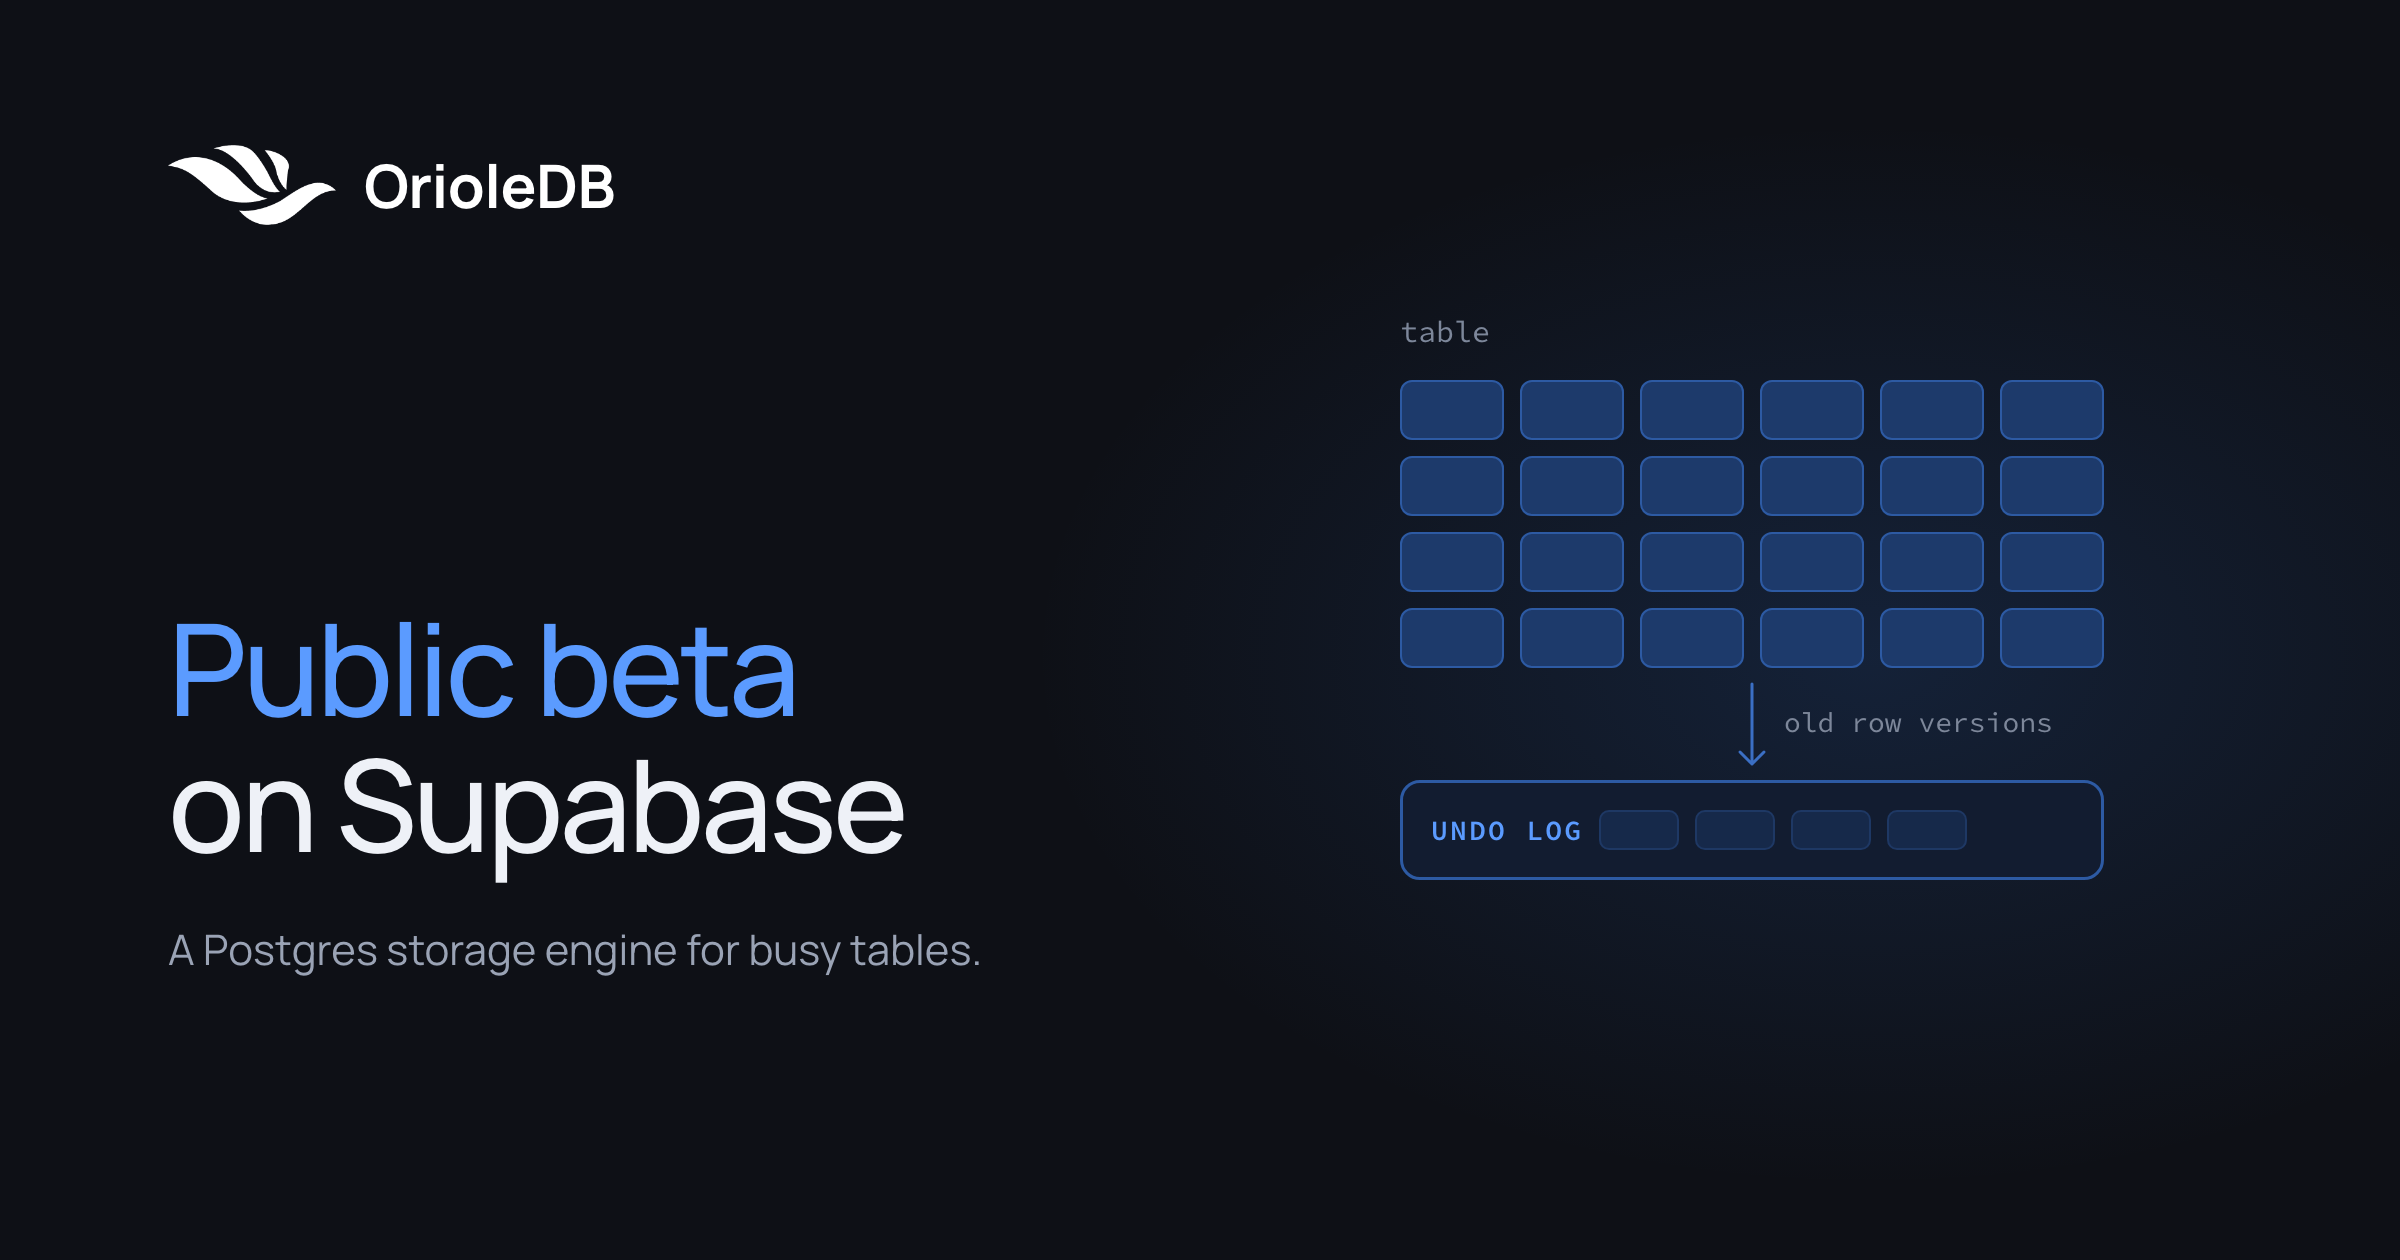
OrioleDB, open-source движок хранения для Postgres, теперь доступен в публичной бета-версии на всех тарифах Supabase. Мы объявили о запуске публичной бета-версии на конференции Supabase Select вместе с Multigres и DBArena. Выберите OrioleDB при создании проекта. Стоимость тарификации такая же, как для стандартного Postgres. Изменение ресурсов процессора и диска, реплики для чтения, обновления Postgres и запланированные резервные копии работают штатно. Однако движок пока не готов для использования в producción.
Проблема стандартного движка хранения в Postgres#
Postgres хранит строки таблиц в формате, известном как куча (heap). Обновление не изменяет строку на месте. Postgres записывает новую версию, а старую оставляет в виде мертвых кортежей (dead tuples). Поскольку каждый индекс указывает на физическое расположение строки, новая версия обычно требует новой записи в каждом индексе таблицы, даже в те индексы по столбцам, которые не менялись. Удаления также оставляют мертвые кортежи.
Postgres очищает старые версии строк с помощью процесса VACUUM, а фоновый процесс autovacuum запускает его автоматически, как только в таблице накапливается достаточное количество мертвых кортежей. В таблицах с большим количеством обновлений или удалений autovacuum может не успевать справляться с нагрузкой. Это приводит к раздуванию (bloat): таблицы и индексы становятся больше, чем хранящиеся в них данные, а запросы замедляются, поскольку им приходится читать больше страниц. В результате команды настраивают параметры autovacuum для каждой таблицы, планируют ручной запуск VACUUM или используют такие инструменты, как pg_repack, для перестройки таблиц.
Хранение в виде кучи также имеет ограничения при высокой степени параллелизма. Поиск по первичному ключу должен считывать как индекс, так и саму таблицу, каждое чтение проходит через общий пул буферов (shared buffer pool), за который конкурируют множество соединений, а нагрузки с преобладанием записи создают высокую нагрузку на дисковый ввод-вывод при каждой контрольной точке (checkpoint). На более мощных серверах эти издержки могут помешать Postgres задействовать всю вычислительную мощность процессора и диска, за которые вы платите.
OrioleDB заменяет кучу через Table Access Method — интерфейс плагинов Postgres для движков хранения. Ваши строки подключения, аутентификация, политики Row Level Security и клиентские библиотеки остаются прежними.
- Журнал отката (undo log) вместо мертвых кортежей. Когда строка обновляется или удаляется, OrioleDB записывает предыдущую версию в журнал отката, который очищается автоматически. В большинстве случаев в таблицах не накапливаются мертвые кортежи, поэтому для VACUUM не остается работы по очистке.
- 64-разрядные идентификаторы транзакций. 32-разрядные идентификаторы транзакций в Postgres имеют свойство циклически переполняться, и если процесс VACUUM отстает, Postgres перестает принимать операции записи. Таблицы OrioleDB используют 64-разрядные идентификаторы, поэтому переполнение им не грозит. Системные каталоги и любые таблицы на основе кучи по-прежнему используют 32-разрядные идентификаторы.
- Таблицы с индексной организацией (Index-organized tables). Строки хранятся внутри индекса первичного ключа, а не в отдельной куче, поэтому поиск по первичному ключу считывает одну структуру вместо двух. Вторичные индексы указывают на первичный ключ, поэтому при обновлении запись происходит только в те индексы, чьи столбцы были изменены. Если у таблицы нет первичного ключа, OrioleDB создает скрытый.
- Отсутствие маппинга буферов. Страницы в оперативной памяти ссылаются напрямую на страницы хранения, благодаря чему OrioleDB избегает конкуренции за маппинг общих буферов Postgres. Чтение страниц происходит без блокировок, что помогает, когда множество соединений выполняют чтение одновременно.
- Контрольные точки с копированием при записи (copy-on-write) и WAL на уровне строк. Контрольные точки записывают только те данные, которые изменились, что снижает нагрузку на дисковый ввод-вывод при интенсивной записи.
Разработка OrioleDB ведется с 2021 года, а ее создатели входят в команду Supabase. Эта бета-версия поставляется с OrioleDB beta19 на базе Postgres 17.11.
Мы проводим бенчмаркинг OrioleDB на DBArena, нашем открытом сайте для тестирования производительности размещенного Postgres. Там запускается рабочая нагрузка на основе TPC-C для Supabase Postgres, Supabase с OrioleDB, Amazon RDS и Google Cloud SQL на семи конфигурациях вычислительных мощностей. Тестируются два сценария: когда данные целиком помещаются в память и когда их объем в четыре раза превышает объем памяти. Код бенчмарка, методология и необработанные результаты каждого запуска находятся в открытом доступе, поэтому вы можете проверить наши цифры или запустить тесты самостоятельно. Эта рабочая нагрузка создана на основе бенчмарка TPC-C и несравнима с опубликованными результатами бенчмарка TPC-C, поскольку данная реализация не удовлетворяет всем требованиям бенчмарка TPC-C.
Когда данные не помещаются в память, OrioleDB показала самую высокую пропускную способность на доллар среди всех протестированных продуктов при любом размере вычислительных ресурсов. На инстансе уровня 8XL (32 vCPU, 128 ГБ ОЗУ) она выполняла примерно в 1,8 раза больше транзакций в минуту, чем Supabase Postgres на хранении в виде кучи, достигнув 113 850 транзакций в минуту. На небольшом размере (Small), при той же стоимости, она обеспечила примерно на 46% большую пропускную способность на доллар по сравнению с кучей. Когда данные помещаются в память, разница меньше. OrioleDB опережала кучу примерно на 13% на размере Large и примерно на 29% на 8XL. На Small вариант с кучей оказался впереди. Вы можете сравнить результаты для любого размера и сценария.
Преимущества производительности OrioleDB зависят от вашей рабочей нагрузки. OrioleDB наиболее полезна для таблиц, которые часто обновляются или удаляются (таких как статусы заказов, остатки на складе, очереди задач и данные сеансов), поскольку именно в таких таблицах хранилище на основе кучи накапливает наибольшее раздувание. Она также эффективна, когда набор данных превышает объем памяти, когда множество соединений одновременно читают и пишут на крупном инстансе, и когда большинство запросов ищут строки по первичному ключу. Рабочие нагрузки, состоящие преимущественно из чтения и целиком помещающиеся в память, покажут меньшую разницу. Нагрузки, зависящие от не-B-дерево индексов (например, pgvector HNSW), могут пока не дать прироста производительности, поскольку эти индексы работают через экспериментальный мост. Мы рекомендуем протестировать вашу собственную нагрузку, прежде чем делать выводы.
- Откройте Create a new project в панели управления (Dashboard).
- Разверните раздел Advanced Configuration.
- В поле Postgres Type выберите Postgres with OrioleDB.
- Завершите создание проекта.
В проекте на базе OrioleDB новые таблицы используют OrioleDB по умолчанию. Какая-либо специальная синтаксическая поддержка не требуется:
_10
create table orders (
_10
id bigint generated always as identity primary key,
_10
customer_id bigint not null,
_10
status text not null,
_10
updated_at timestamptz not null default now()
_10
Для локальной разработки инициализируйте свой проект с помощью Supabase CLI (версии 2.119.0 или новее):
_10
supabase init --use-orioledb
- Пока не предназначено для production. Публичная бета-версия предназначена для тестирования и не имеет SLA.
- Выбор при создании проекта. Вы не можете добавить OrioleDB к существующему проекту или удалить ее позже.
- Отсутствие восстановления на определенный момент времени (Point-in-Time Recovery). Восстановление резервной копии в новый проект также недоступно.
- Типы индексов. Нативные B-дерево индексы показывают наилучшую производительность. Другие типы индексов, включая pgvector HNSW, работают через экспериментальный мост.
- Неподдерживаемые команды. Команды CLUSTER, VACUUM FULL и некоторые другие не работают с таблицами OrioleDB.
- Расширения. Образ OrioleDB не включает plv8, plls, plcoffee или timescaledb-apache.
- Транзакции SERIALIZABLE. По умолчанию OrioleDB устанавливает блокировку на каждую таблицу, к которой обращается SERIALIZABLE-транзакция. Вы можете изменить это поведение с помощью параметра orioledb.serializable.
- OrioleDB или Multigres. Проект может использовать либо одно, либо другое, но не оба варианта одновременно.
- Самостоятельное размещение (Self-hosting). OrioleDB пока не входит в состав стека self-hosted Supabase.
- Альфа-проекты. Существующие альфа-проекты не мигрируют в публичную бета-версию и продолжают работать в прежнем режиме.
В документации OrioleDB описаны настройки и приведен полный список ограничений.