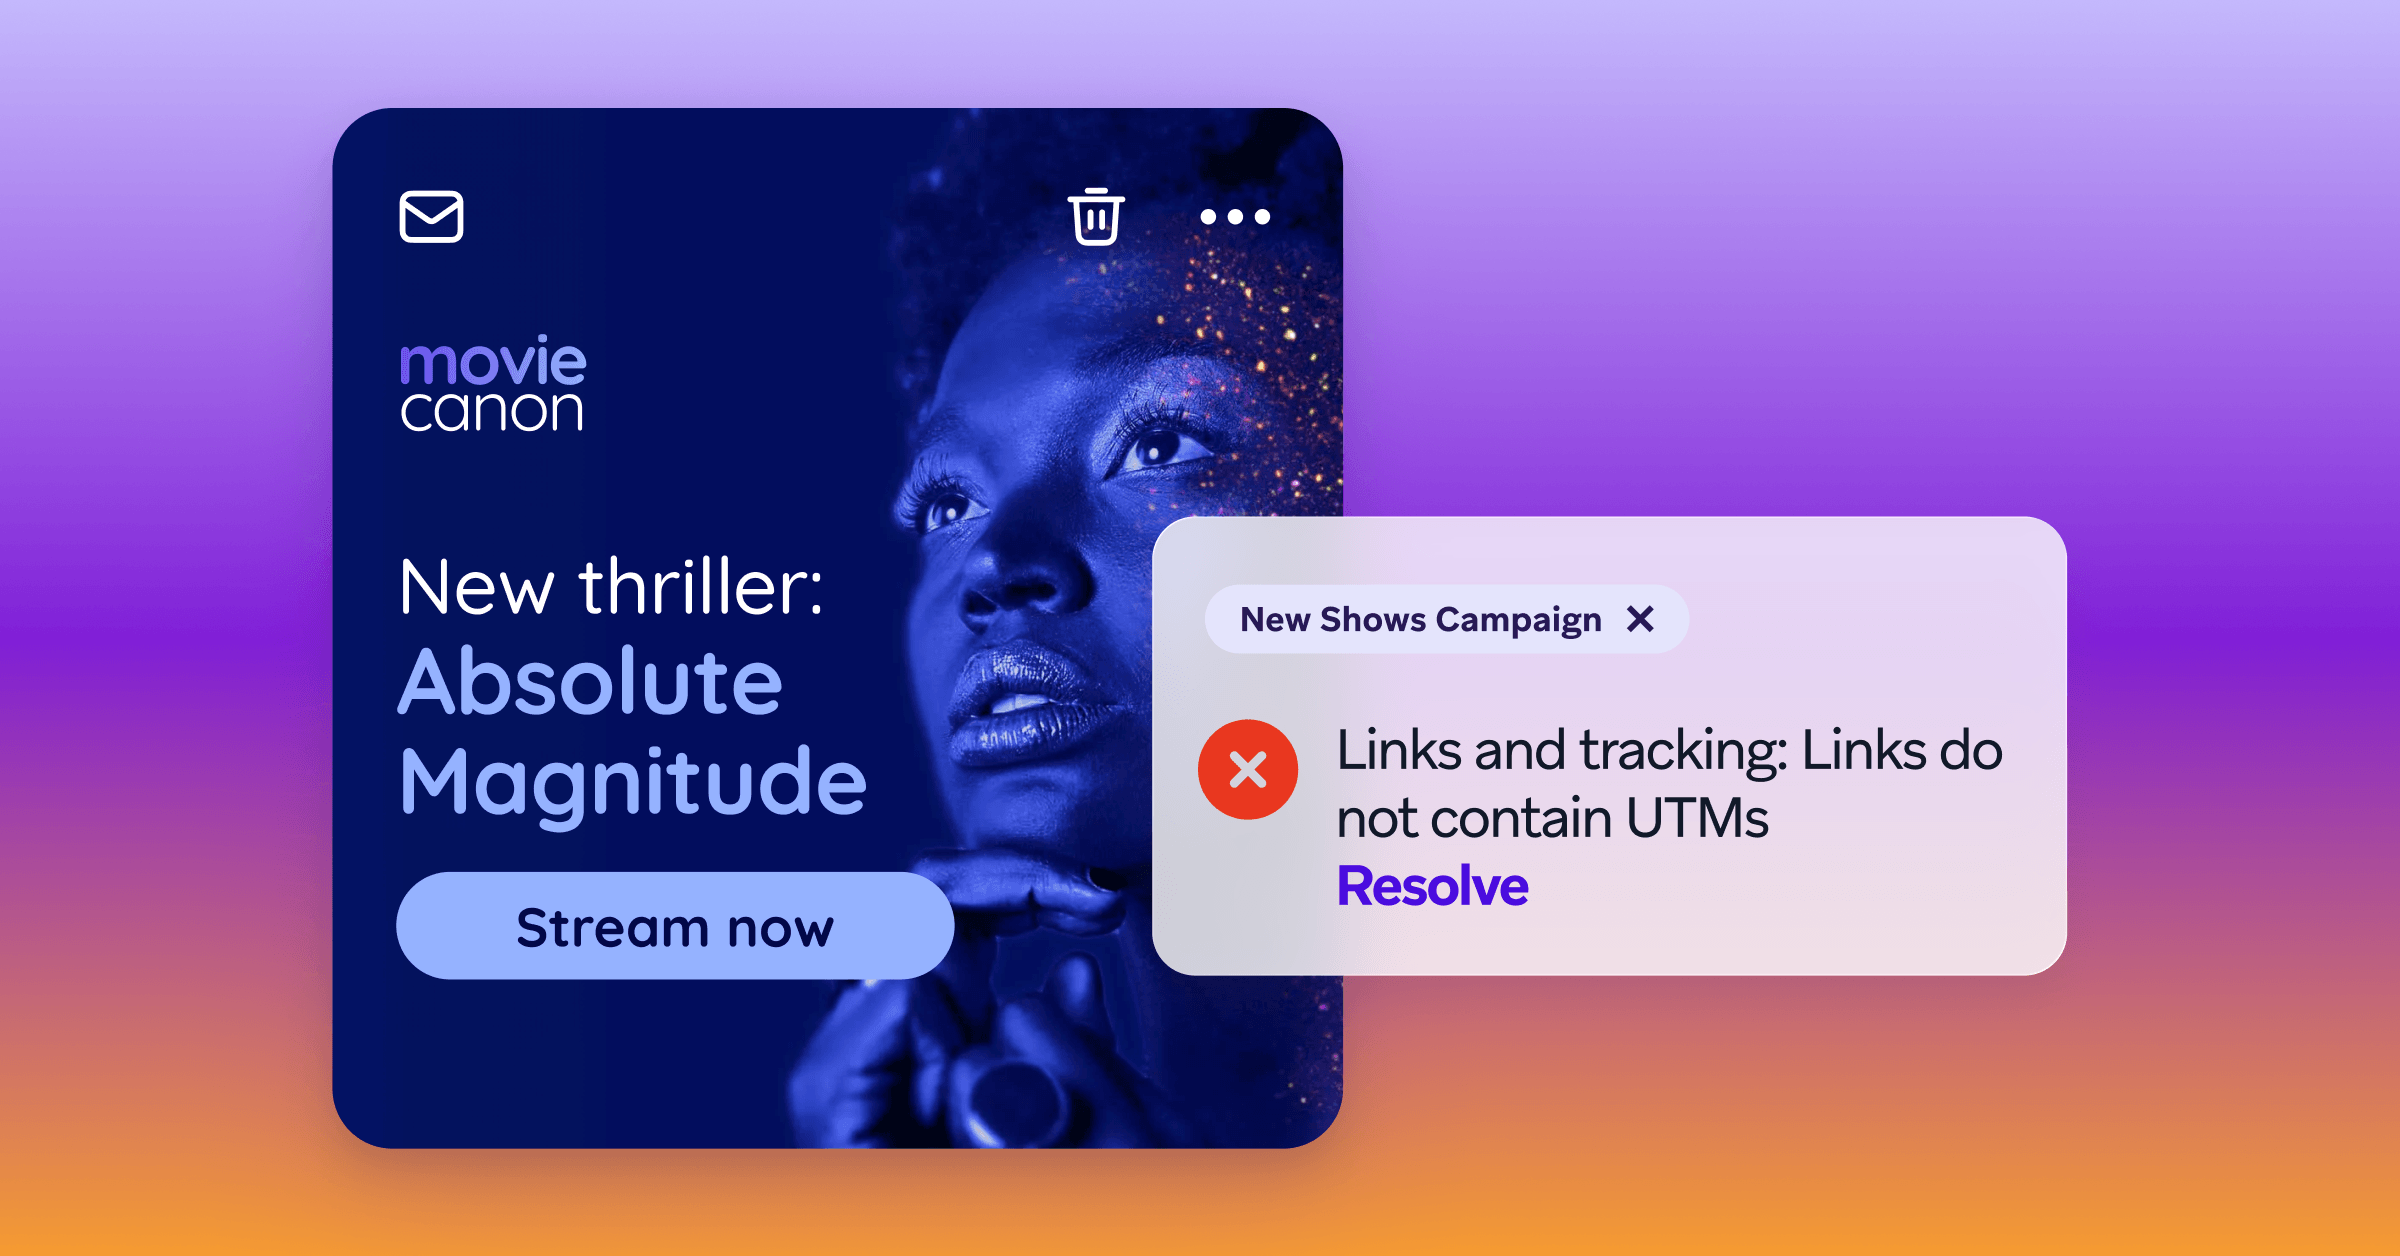
Выполнение 100 маркетинговых задач в день с помощью Claude Opus 5 обойдется в $286 по счету за использование модели. Те же 100 задач на Kimi K3 будут стоить $68.
в день за использование моделей для 100 маркетинговых задач на Claude Opus 5
в день за те же 100 задач на Kimi K3
Эти цифры — результат Mark-Bench, нашего маркетингового бенчмарка. Мы создали его в Optimizely, потому что ничего подобного раньше не существовало. Это набор реальных маркетинговых задач, к каждой из которых прилагается бриф, сопутствующие исходные файлы и контрольный список критериев, которым должен соответствовать результат.
Строгий критерий оценки — прохождение всего списка: задача засчитывается только в том случае, если модель выполнила каждый пункт чек-листа.
По этому показателю Opus 5 успешно справилась с 58,2% задач. Kimi K3 — с 55,8%. Разрыв составляет всего 2,4 пункта при цене, которая примерно в четыре раза выше ($2,86 за задачу против $0,68). Баллы попадают на заголовки газет. Затраты — редко.
Марк в настоящее время работает на моделях с закрытыми весами. Вскоре мы добавим в Марк модели с открытыми весами, поэтому сначала мы протестировали их в нашей маркетинговой лаборатории. Вот к чему это привело.
Модели, которые вы уже знаете: с закрытыми весами
Сегодня Марк работает на передовых моделях (наиболее мощных из доступных на коммерческом рынке) от Google, Anthropic и OpenAI (через Microsoft). Знакомые всем имена. Opus, Sonnet, Gemini, GPT.
У них есть общая черта, о которой редко заикаются в маркетинговых кругах. Все они имеют закрытые веса. Веса модели — это то, чему она научилась в процессе обучения, и компания-разработчик держит их в секрете. Вы можете использовать модель, но только через сервис этой компании. Представьте себе ресторан с секретным рецептом. Вы можете заказать что угодно из меню, но кухню вам никогда не покажут.
Что такое модели с открытыми весами?
Затем есть совершенно другая группа: модели с открытыми весами. Их создатели публикуют веса, поэтому любой желающий может скачать модель и запустить ее. Представьте, что шеф-повар отдает вам готовое блюдо, чтобы вы забрали его домой. Вы можете запустить его на собственной кухне, добавить свои специи (выполнить дообучение), и, если вы развернете модель самостоятельно, ваши данные никогда не покинут пределы дома.
Но рецепт вам все равно не дают, поэтому вы не можете точно узнать, что входило в состав. (Это отличается от полностью открытого исходного кода, где шеф-повар также передает рецепт: данные для обучения и код, лежащие в основе блюда). Возможно, эти названия вам знакомы. GLM. Kimi. DeepSeek.
Мы взяли их в лабораторию и прогнали через те же 285 сценариев, что и закрытые модели, используя нашу ИИ-обвязку — слой инструкций, контекста и инструментов, который окружает модель.
Одно примечание перед цифрами: в скором времени мы собираемся внедрить модели с открытыми весами в Марк. Вот что мы выяснили, протестировав их первыми.
Что говорит бенчмарк
Оценка здесь — это процент успешного прохождения всех тестов: либо соблюден каждый критерий, либо задача провалена. Этот подход намеренно строг. Стоимость — это цена выполнения моделью одной задачи.
Либо выполнен каждый критерий, либо задача провалена. Источник: Optimizely, Mark-Bench (ранняя версия, 285 сценариев)
Стоимость выполнения моделью одной задачи. Данные для DeepSeek V4.1 Flash являются приблизительными (около $0,20). Источник: Optimizely, Mark-Bench (ранняя версия, 285 сценариев)
Kimi K3 и GLM-5.3 отстают от Opus 5 менее чем на 3 балла, при этом их цена составляет примерно четверть от стоимости Opus. По сравнению с лидирующей в таблице Gemini 4 Argon они стоят примерно в два раза дешевле. Argon действительно набирает больше баллов — на 5,6 пункта выше Kimi K3.
Бюджетный сегмент выглядит еще интереснее. DeepSeek V4.1 Flash справилась с 52,6% задач при стоимости около 20 центов за задачу. Kimi K3 на более легких настройках набрала 54,0% при цене 37 центов. Это на 1,4 балла больше почти при двойной стоимости.
Затем идет GLM-5.3 Flash: 36,5% при стоимости менее двух центов за задачу. Это примерно 63% от результатов Opus 5 при цене менее 1% от ее стоимости.
Как 100 запусков в день бьют по бюджету
Цены за задачу кажутся микроскопическими, пока маркетинговая работа не начинает повторяться. Возвращаясь к тем самым $286 против $68: разница составляет $218 в день или почти $80 000 в год, если работа выполняется ежедневно.
Если вы запускаете модель 100 раз в день, вы платите несколько сотен долларов сверху ежедневно. А теперь умножьте это на месяц и на год. Все эти расходы накапливаются.Имран Юсуф|Вице-президент по разработке программного обеспечения, Optimizely
Если вы запускаете модель 100 раз в день, вы платите несколько сотен долларов сверху ежедневно. А теперь умножьте это на месяц и на год. Все эти расходы накапливаются.
Имран Юсуф|Вице-президент по разработке программного обеспечения, Optimizely
Мы не единственные, кто это замечает. OpenRouter — платформа, которую разработчики используют для доступа к множеству моделей через единый API, — недавно опубликовал данные о том, какие модели люди чаще всего используют для аудита безопасности, ранжированные по доле затрат. GLM 5.3 заняла первое место с 27,8%, за ней следуют Kimi K3 (10.7%) и DeepSeek V4.1 Flash (10.5%) — все три модели присутствуют в наших результатах выше. Самая популярная модель с закрытыми весами, Grok 4.7, заняла пятое место с 3,6%.
Это лишь узкая сфера (аудит безопасности составляет 0,9% от всех расходов), ориентированная преимущественно на разработчиков. Она ничего не говорит о том, насколько хорошо эти модели справляются с маркетинговыми задачами, для чего и создан наш бенчмарк.
Правильная модель для правильной задачи
Не каждая задача требует самой мощной модели.
Допустим, вам нужно составить краткое содержание электронной почты. Полтора цента могут оказаться более чем достаточной суммой. Вам не обязательно использовать модель за $2,86.Имран Юсуф|Вице-президент по разработке программного обеспечения, Optimizely
Допустим, вам нужно составить краткое содержание электронной почты. Полтора цента могут оказаться более чем достаточной суммой. Вам не обязательно использовать модель за $2,86.
Имран Юсуф|Вице-президент по разработке программного обеспечения, Optimizely
Для сложной многоэтапной работы Opus 5, Kimi K3, GLM-5.3 и Gemini 4 Argon находятся примерно в одном диапазоне по количеству баллов. Какую из них выбрать, зависит от цены и того, как часто запускается задача.
Главная сложность заключается в том, чтобы понимать возможности каждой модели.
Если вы не знаете, на что способна модель, вы не сможете эффективно использовать ее в нужном месте для нужного типа задач.Имран Юсуф|Вице-президент по разработке программного обеспечения, Optimizely
Если вы не знаете, на что способна модель, вы не сможете эффективно использовать ее в нужном месте для нужного типа задач.
Имран Юсуф|Вице-президент по разработке программного обеспечения, Optimizely
Именно здесь тестирование, адаптированное под маркетинг, оправдывает себя на все сто. Общий лидерборд не сможет подсказать, как модель справляется с брифом кампании, к которому приложено руководство по бренду. Mark-Bench может, потому что каждый сценарий представляет собой маркетинговую задачу, а критерии оценки составлены реальными маркетологами. Мы также тестируем модели, выходящие за рамки тех, на которых Марк работает сегодня, поскольку эти результаты помогают всем, кто выбирает подходящий инструмент.
Имейте в виду: это ранняя версия
Оценивайте разницу в несколько баллов как общую тенденцию.
Эти результаты получены на основе ранней версии Mark-Bench. Версии 1.5 и 2 уже на подходе, поэтому цифры еще изменятся. Тест Opus 5 — это именно тот результат, который мы показывали на Opticon. Модели Opus 5.5 и GPT 6.1 пока не тестировались.
Это дает относительное представление о моделях, но вряд ли отражает реальность.Имран Юсуф|Вице-президент по разработке программного обеспечения, Optimizely
Это дает относительное представление о моделях, но вряд ли отражает реальность.
Имран Юсуф|Вице-президент по разработке программного обеспечения, Optimizely
Куда это приведет дальше
Эти данные существуют для того, чтобы вам не приходилось заниматься расчетами. Маркетологам не нужно быть экспертами по токенам, поэтому план следующий:
Контроль над тем, какие модели активны в вашем экземпляре.
Рекомендации в процессе создания собственных агентов. Основываясь на Mark-Bench, платформа может подсказать, что модель хорошо подходит для созданной вами задачи, и порекомендует ее протестировать.
Где работают эти модели и что происходит с вашими данными в процессе (кто управляет кухней в нашей метафоре) — все это заслуживает отдельной публикации. И мы ее напишем. А если у вас идет кругом голова от закрытых весов, открытых весов и открытого исходного кода, мы напишем и об этом.
Более крупные модели заслуживают своего места на самой сложной работе. Множество повседневных маркетинговых задач можно выполнять на чем-то гораздо более дешевом, и теперь у нас есть цифры, подтверждающие это.