Наиболее распространенные сценарии использования векторных баз данных — это семантический поиск, генерация с дополненным извлечением (RAG), рекомендательные системы, чат-боты и виртуальные ассистенты, обнаружение аномалий и мультимодальный поиск. Каждый сценарий зависит от способности векторной базы данных находить результаты по смыслу и сходству, а не по точному совпадению ключевых слов. Эта фундаментальная возможность отличает векторный поиск от традиционных запросов к базе данных.
В этой статье рассматривается, что такое векторные базы данных, как они работают, почему каждый сценарий использования получает преимущества именно от векторного поиска, а также как выбрать между автономной векторной базой данных и многомодельной платформой со встроенным векторным поиском.
Что такое векторная база данных?
Векторная база данных — это специализированная система для хранения, управления и запроса данных в виде многомерных векторов. В отличие от реляционных баз данных, хранящих структурированные данные в строках и столбцах, или документных баз данных, работающих с JSON, векторные базы данных хранят математические представления данных, называемые эмбеддингами. Они извлекают наиболее релевантные результаты путем измерения расстояния между этими эмбеддингами.
Модель эмбеддингов преобразует текст, изображения, аудио и видео в набор чисел, называемый вектором. Эти числа кодируют семантический смысл контента. В векторном пространстве слова «король» и «королева» математически ближе друг к другу, чем «король» и «яблоко», поскольку они имеют схожий контекст. Именно эта позиционная взаимосвязь обеспечивает поиск на основе сходства.
Векторные базы данных сосуществуют с транзакционными и аналитическими базами данных в современной архитектуре. Они обеспечивают долгосрочную память и контекстуальный поиск, необходимые ИИ-моделям, сокращая разрыв между сырыми корпоративными данными и возможностями рассуждения больших языковых моделей (LLM).
Более подробно с архитектурой можно ознакомиться в материале «Архитектура векторной базы данных: что следует оценить техническим специалистам».
Как работают векторные базы данных
Эмбеддинги и поиск по сходству
Эмбеддинги — это векторные представления, создаваемые моделями ИИ (такими как модели текстовых эмбеддингов от OpenAI или их открытые аналоги от Hugging Face), которые обрабатывают данные и преобразуют их в плотный массив чисел с плавающей запятой. Эти числа фиксируют семантическую сущность данных, а не их буквальное содержание.
Поиск по сходству измеряет расстояние между вектором запроса и сохраненными векторами. Чем ближе векторы в многомерном пространстве, тем релевантнее сохраненный элемент запросу. Это позволяет по запросу «автомобиль» возвращать результаты для «машины» и «транспортного средства», поскольку эти концепции занимают схожие позиции в векторном пространстве даже без явной настройки синонимов.
Индексация и поиск ближайших соседей
Поиск по миллионам или миллиардам векторов без индекса является вычислительно неэффективным. Векторные базы данных используют специализированные алгоритмы индексации, такие как Hierarchical Navigable Small World (HNSW) или Inverted File Index (IVF), для организации векторов с целью быстрого приближенного поиска ближайших соседей (ANN). Эти индексы позволяют системе находить наиболее релевантные результаты быстро и точно даже при масштабных объемах данных.
Чем векторный поиск отличается от поиска по ключевым словам
Традиционный поиск по ключевым словам опирается на лексическое сопоставление. Поиск по словесному запросу «автомобиль» находит документы, содержащие строку «автомобиль». Он пропустит документы о «машинах» или «транспортных средствах», если списки синонимов не поддерживаются и не обновляются вручную.
Векторный поиск возвращает результаты на основе смысла. «Автомобиль» и «машина» семантически эквивалентны в векторном пространстве, поэтому оба термина появляются в результатах независимо от точного совпадения строк. Этот переход от буквального сопоставления к семантическому пониманию делает векторные базы данных незаменимыми для ИИ-приложений.
Почему векторные базы данных важны для ИИ-приложений
Семантическое понимание против лексического сопоставления
Лексическое сопоставление дает сбой, когда намерение пользователя двусмысленно или когда в запросе и исходных данных используется разная лексика. В контексте техподдержки пользователь может описать проблему нетехническим языком, в то время как решение задокументировано в терминах. В этом случае поиск по ключевым словам не сработает, но векторный поиск справится, поскольку он сопоставляет смыслы, а не строки. Практическим результатом является сокращение времени решения проблем и повышение удовлетворенности клиентов без необходимости изучать техническую терминологию.
Масштабируемость, производительность и инференс в реальном времени
ИИ-приложения, ориентированные на конечных пользователей, требуют низкой задержки. Когда пользователь взаимодействует с поисковой строкой или чат-ботом, результаты должны появляться за миллисекунды. Традиционные базы данных с трудом выполняют вычисления сходства с достаточной скоростью, но векторные базы данных созданы специально под этот шаблон запросов. Это позволяет им обеспечивать высокую пропускную способность и низкую задержку, необходимые для инференса в реальном времени.
Подключение проприетарных данных к LLM
Модель LLM, обученная на публичных данных, не знает частную документацию вашей компании, текущие спецификации продуктов или историю клиентов. Сохраняя проприетарные данные в виде векторных эмбеддингов в векторной базе данных, организации могут снабжать ИИ-модель релевантным и актуальным контекстом во время инференса. Эта возможность лежит в основе архитектуры RAG и имеет решающее значение для развертывания ИИ, адаптированного под конкретную бизнес-область.
Сценарии использования векторных баз данных
Семантический поиск
Семантический поиск — один из наиболее распространенных вариантов применения векторных баз данных. Он позволяет организациям искать по обширным коллекциям внутренних документов, юридических записей или каталогов продукции с помощью повседневного языка, даже если формулировки отличаются от исходного материала. Например, запрос «политика отмены контракта» может поднять документ под названием «процедуры расторжения соглашения», поскольку эти две фразы имеют схожий смысл.
В результате получается более полезный опыт поиска. Сотрудники могут быстрее находить нужную информацию, а клиенты — открывать для себя продукты, которые точнее соответствуют их запросам. Семантический поиск особенно ценен, когда информация распределена по разным коллекциям документов, а люди используют разные термины для описания одного и того же.
RAG
RAG является основным драйвером внедрения корпоративных векторных баз данных. В архитектуре RAG, когда пользователь отправляет вопрос ИИ-модели, система сначала запрашивает векторную базу данных для извлечения наиболее семантически релевантных внутренних документов. Затем система передает эти документы и исходный вопрос в LLM, которая генерирует ответ на основе извлеченного контента, а не полагается исключительно на данные обучения.
Практическая польза огромна, поскольку ИИ генерирует ответы на основе проверенных данных вашей организации. Это кардинально сокращает количество галлюцинаций и гарантирует, что ответы отражают актуальную, авторизованную информацию, а не потенциально устаревшие знания из обучающей выборки LLM.
Рекомендательные системы
Векторные базы данных отлично подходят для поиска «похожих элементов». Представляя поведение пользователей и характеристики продуктов или контента в виде векторов, рекомендательная система может находить элементы, семантически или поведенчески схожие с теми, с которыми пользователь взаимодействовал ранее. Системе не требуются предопределенные правила или явные таксономии, поскольку она измеряет сходство напрямую в пространстве эмбеддингов.
Персонализированные рекомендации повышают вовлеченность и доход без необходимости инженерных затрат на поддержание сложных систем правил по мере изменения каталогов продуктов и поведения пользователей.
Чат-боты и виртуальные ассистенты
Эффективным чат-ботам необходим контекст. Без доступа к предыдущей истории разговоров или актуальным справочным материалам виртуальный ассистент выдает общие ответы, которые не учитывают конкретные ситуации пользователей. Векторные базы данных позволяют чат-ботам в реальном времени извлекать контекстно релевантные статьи поддержки, предыдущие ветки разговоров или документацию по продуктам. Это обеспечивает ответы, которые воспринимаются как конкретные и персонализированные, а не шаблонные.
Бизнес-результат выражается в автоматизированной поддержке, которая разрешает проблемы, снижает объем тикетов, обрабатываемых агентами-людьми, и уменьшает стоимость поддержки на одно взаимодействие.
Обнаружение аномалий и поиск сходства
Поскольку векторные базы данных измеряют расстояние между точками данных, они эффективно выявляют выбросы. Финансовая транзакция или шаблон сетевого входа, находящиеся далеко от устоявшегося кластера нормальной активности, могут быть помечены как аномальные на основе их векторного расстояния от известных корректных примеров. Тот же механизм работает и в обратную сторону для дедупликации. В этом случае система определяет практически идентичные элементы в массивных наборах данных по векторной близости, а не по точному сравнению строк.
Обнаружение мошенничества улучшается по мере того, как система непрерывно обновляет свою модель нормального поведения. Это помогает ей адаптироваться к изменяющимся паттернам атак без опоры на статические правила, требующие ручного обслуживания.
Поиск по изображениям, аудио и мультимодальный поиск
Векторные базы данных также могут обеспечивать поиск по изображениям, аудио и видео в дополнение к тексту. С помощью подходящих моделей встраивания (эмбеддингов) пользователи могут находить изображения, описывая то, что они ищут, на естественном языке, например «красный спортивный автомобиль на пляже», или загружая похожее изображение. Это значительно упрощает для организаций поиск по крупным библиотекам цифровых активов такими способами, которые системы на основе ключевых слов не могут эффективно поддержать.
Эта возможность открывает новые перспективы для управления цифровыми активами, поиска контента и любой предметной области, где мультимедиа является основным форматом данных. Вот пример того, как можно создать мультимодальное приложение на базе ИИ, которое преобразует изображение в эмбеддинг и извлекает визуально похожие результаты.
Чем векторные базы данных отличаются от традиционных баз данных?
Векторные базы данных и традиционные базы данных оптимизированы под разные рабочие нагрузки и лучше всего работают в паре, а не в качестве альтернатив. В этой таблице суммированы их основные различия:
Когда использовать векторную базу данных, а когда — традиционную
Векторные базы данных хорошо подходят, когда приложению необходимо находить информацию по смыслу, а не по точному совпадению. Это включает в себя поиск на естественном языке, персонализированные рекомендации и конвейеры RAG, которые извлекают релевантный контекст для моделей ИИ.
Традиционные базы данных лучше подходят для рабочих нагрузок, которые опираются на структурированные запросы, транзакционную целостность, контроли доступа и стабильную производительность для повседневных операций.
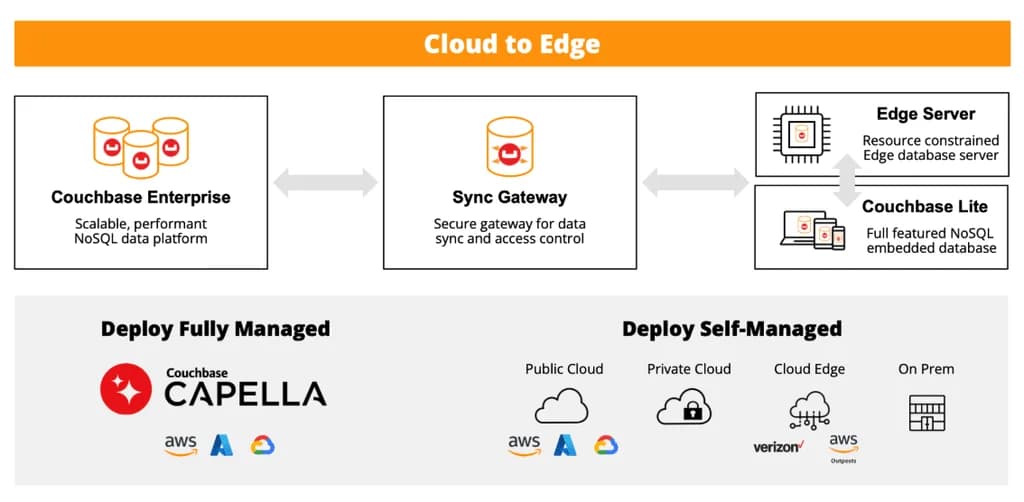
Во многих производственных приложениях ИИ лучший подход заключается в их комбинации. Традиционная база данных хранит основные данные приложения, в то время как векторный поиск помогает системам ИИ находить релевантную информацию и обеспечивать более контекстно-зависимый опыт. Такие платформы, как Couchbase, объединяют эти возможности, позволяя командам создавать приложения ИИ без разделения данных по отдельным системам и без ущерба для управления и масштабируемости.
Архитектурные соображения для векторного поиска
Конвейеры приема данных и эмбеддингов
Создание возможности векторного поиска требует конвейера для преобразования сырых данных в векторы. Это предполагает выбор модели встраивания (например, от OpenAI, Cohere или Hugging Face) и автоматизацию процесса, при которой новые данные векторизуются и индексируются по мере поступления в систему. Выбор модели встраивания имеет последствия для последующих этапов, поскольку разные модели производят векторы различной размерности, а смена модели после приема данных требует повторного встраивания всего набора данных.
Требования к задержке, масштабу и согласованности
Большие наборы векторных данных требуют значительного объема памяти и вычислительных ресурсов для индексации. Команды должны оценить, справляется ли полностью управляемое решение DBaaS с операционными накладными расходами на масштабирование, или же требования нормативного соответствия предполагают развертывание on-premises. В масштабе миллиардов векторов характеристики производительности подхода к индексации (HNSW против IVF) и архитектура памяти базы данных становятся значительными переменными.
Интеграция со стеками приложений и ИИ
Векторные базы данных должны интегрироваться с фреймворками оркестрации, такими как LangChain или LlamaIndex, а также со слоем API, используемым приложением. SDK на языках, которые команда разработки уже использует (например, Python, JavaScript и Java), являются практической предпосылкой. Couchbase Vector Search интегрируется как с LangChain, так и с LlamaIndex и предоставляет SDK для всех основных языков.
Основные выводы
1. Векторные базы данных извлекают результаты по семантическому сходству, а не по совпадению ключевых слов. Это делает их незаменимыми для приложений ИИ, где намерение пользователя важнее точной терминологии.
2. RAG — это наиболее распространенный корпоративный вариант использования. Генерация с дополненным извлечением использует ваши проприетарные данные для обоснования ответов LLM, снижения галлюцинаций и повышения точности.
3. Векторный поиск одинаково применим к тексту, изображениям, аудио и видео. По любому типу данных, который может быть представлен в виде эмбеддинга, можно выполнять поиск по сходству.
4. Векторные базы данных дополняют традиционные базы данных, а не заменяют их. Продуктивные архитектуры ИИ используют традиционные базы данных для оперативных данных и векторный поиск для семантического извлечения.
5. Масштабируемость на уровне индекса определяет жизнеспособность в продакшене. Индексы HNSW и IVF эффективно обрабатывают поиск сходства в масштабе миллиардов объектов. Без них линейный векторный сканер непрактичен при объемах промышленных данных.
6. Инференс в реальном времени требует векторного поиска с низкими задержками. Ориентированным на пользователя приложениям нужны результаты быстрее чем за 100 миллисекунд, и это требование определяет как выбор индекса, так и подбор инфраструктуры.
7. Обнаружение аномалий и дедупликация — это недостаточно используемые приложения. Векторное расстояние выявляет выбросы и почти точные дубликаты так, как системы на основе ключевых слов не могут. Приложения включают обнаружение мошенничества, мониторинг безопасности и контроль качества данных.
- Начните работу с Couchbase Vector Search за 5 минут — Блог
- Векторный поиск — Продукты
- Улучшите ваше RAG-приложение с помощью Couchbase Vector Search и Unstructured.io — Блог
- Архитектура векторной базы данных: что следует оценить технологическим покупателям — Блог
- Создание более умных агентов: как векторный поиск обеспечивает семантический интеллект — Блог
- Векторная база данных против графовой базы данных: различия и сходства — Блог
Часто задаваемые вопросы
Когда организации следует добавить векторную базу данных в существующий стек данных? Добавляйте векторную базу данных при создании функций ИИ, требующих работы с неструктурированными данными или извлечения контекста по смыслу, а не по точным ключевым словам. Семантический поиск, рекомендательные системы, чат-боты на базе LLM и конвейеры RAG — это самые очевидные сигналы о том, что вам необходима возможность векторного поиска.
Каковы наиболее распространенные сценарии использования корпоративных векторных баз данных в продакшене? Наиболее распространенными сценариями использования в продакшене являются RAG для работы внутренних ботов знаний и агентов техподдержки, за которыми следуют семантический поиск для электронной коммерции и контентных платформ. Обнаружение мошенничества и аномалий быстро растет по мере того, как организации осознают, что векторное расстояние является более адаптивным сигналом, чем статические правила.
Как требования к задержке варьируются в зависимости от сценариев использования векторных баз данных? Пользовательские приложения, такие как поисковые строки и чат-боты, требуют чрезвычайно низкой задержки, обычно менее 100 миллисекунд, для поддержания приемлемого пользовательского опыта. Фоновые процессы, такие как обнаружение дубликатов или пакетные рекомендации, могут допускать более высокую задержку, но часто требуют более высокой пропускной способности. Подбор инфраструктуры и выбор индекса должны соответствовать требованиям к задержке основного сценария использования.
Как актуальность данных и частота обновлений влияют на приложения на основе векторов? Высокочастотные обновления создают нагрузку на векторные индексы, которым может потребоваться перестроение или частичные обновления по мере поступления новых данных. Приложения, полагающиеся на данные в реальном времени (свежие новости, рыночные данные, потоки с датчиков), требуют векторной базы данных, оптимизированной для приема данных в реальном времени и инкрементных обновлений индекса, а не пакетного перестроения.
Могут ли векторные базы данных соответствовать корпоративным требованиям к фильтрации, безопасности и управлению доступом? Да. Векторные базы данных корпоративного уровня поддерживают фильтрованный поиск, который объединяет семантические запросы с метаданными (например, «найти контракты, похожие на этот, но только за 2025 год»). Они также поддерживают ролевой контроль доступа и шифрование. Поиск по векторам в Couchbase поддерживает гибридные запросы, объединяющие векторное сходство, сопоставление по ключевым словам и структурированные фильтры метаданных в одном SQL-запросе.
Какие метрики измеряют успех развертывания векторных баз данных? Основной технической метрикой является Recall@K, которая показывает, как часто релевантный элемент появляется в топ-K результатов. Задержка запросов (время отклика на перцентилях p95 и p99) измеряет производительность в продакшене. Что касается бизнес-результатов, показатель кликабельности (CTR) для результатов поиска и процент урегулирования для ботов техподдержки преобразуют производительность векторной базы данных в измеримый результат.