Контекстное окно — это объем текста, с которым модель ИИ может работать одновременно. В этом руководстве рассказывается, чем оно заполняется, каков его размер в современных моделях и как эффективно использовать его в повседневной работе.
Что такое контекстное окно
Контекстное окно — это ограничение на объем текста, который модель ИИ может обработать за один раз. Это ограничение включает в себя входящий текст, например, вопрос и прикрепленный к нему документ, а также исходящий ответ. Если что-то не помещается в окно, модель не сможет это увидеть или использовать при ответе.
Контекстное окно отличается от того, что модель усвоила в процессе обучения. Обучение происходит до выпуска модели на очень большом массиве текста, что дает модели общие знания и языковые навыки. Контекстное окно содержит только материал для текущей задачи.
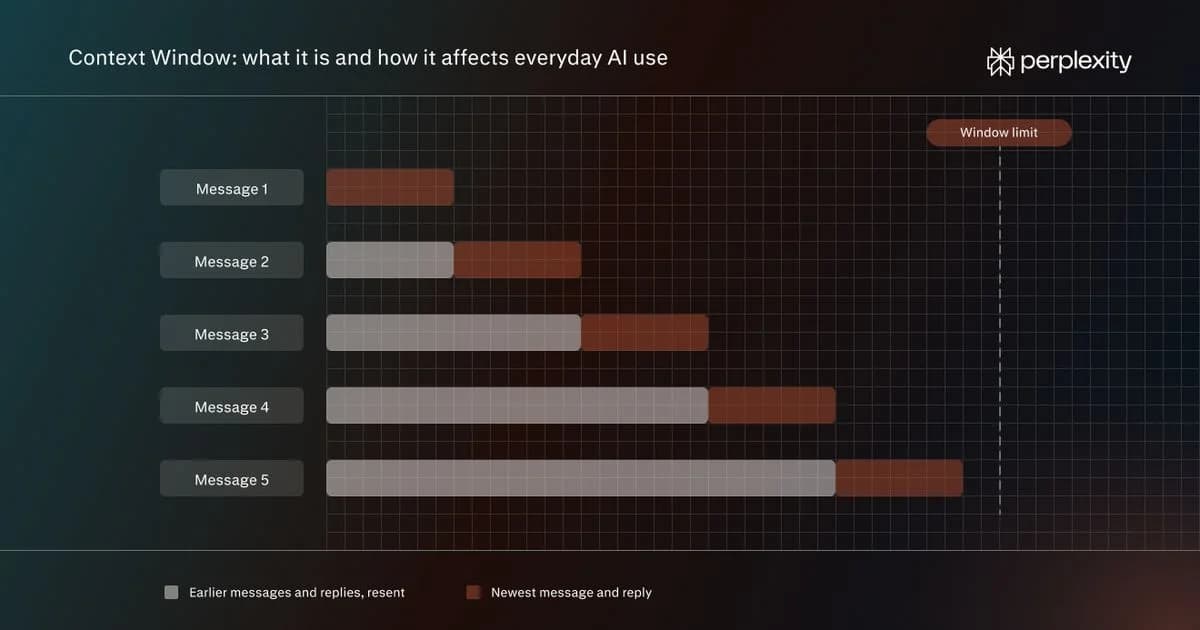
Сама модель ИИ не запоминает предыдущие сообщения. Приложение, в котором она работает, например Perplexity или ChatGPT, сохраняет историю переписки. С каждым новым сообщением приложение отправляет модели всю историю диалога, а не только последнее сообщение. Модель заново считывает всё это перед ответом, и этот ответ становится частью того, что будет отправлено в следующий раз. Объем диалога в окне растет с каждым обменом репликами, поэтому длинная переписка из коротких сообщений может занимать много места.
Как измеряется контекстное окно
Каждое сообщение, документ и ответ в диалоге занимают место в окне. Доступный объем измеряется в токенах, а не в количестве слов или страниц.
Токен — это фрагмент текста, который модель обрабатывает как единое целое. Это может быть короткое слово, часть длинного слова, знак препинания или слово с пробелом перед ним. Согласно OpenAI, при такой приблизительной оценке для английского языка отчет объемом 3000 слов будет составлять около 4000 токенов.
Прежде чем модель прочитает текст, инструмент под названием токенизатор разбивает его на токены и преобразует каждый из них в число. Модель обрабатывает эти числа, генерирует ответ в виде последовательности токенов, а инструмент преобразует их обратно в текст.
Количество токенов не стандартизировано. Оно зависит от языка и содержания. Токенизаторы могут различаться в разных моделях, поэтому один и тот же абзац может давать разное количество токенов в разных моделях.
Контекстное окно против сохраненной памяти
Контекстное окно содержит то, что модель может использовать для ответа на текущий вопрос. Например, когда ИИ редактирует отчет, сам отчет, инструкции по редактированию и сообщения, которыми обменивались в процессе работы, занимают место в окне.
Сохраненная память хранит выбранные детали между диалогами. В Perplexity приложение автоматически выбирает, что сохранить, отслеживая предпочтения и важную информацию, и придавая вес часто упоминаемым деталям. Постоянная инструкция, например «Используй британский английский для всех моих текстов», иллюстрирует тип деталей, которые стоит сохранить, в то время как «Сделай этот абзац короче» относится к текущей задаче.
Когда приложение переносит одну из таких деталей в новый диалог, она становится частью контекста модели и занимает место в окне. В Perplexity настройки памяти находятся в разделе Настройки → Память. Отключение памяти прекращает ее использование в будущих ответах, но не удаляет уже сохраненные детали.
Чем заполняется контекстное окно во время диалога
Контекстное окно содержит гораздо больше, чем просто слова, которые вводит пользователь. В типичном диалоге место делят четыре типа текста: инструкции от приложения, история диалога, материал из файлов или интернета и ответ модели. Большая часть этого никогда не отображается на экране.
Инструкции от приложения
Прежде чем сообщение пользователя попадет в модель, приложение добавляет свои собственные инструкции (часто называемые системным промптом). Они сообщают модели, как себя вести: как форматировать ответы, какой тон использовать, какие инструменты применять, а также содержат такие детали, как текущая дата. Часть этого материала, например внутренние инструкции приложения, обычно не показывается пользователю.
История диалога
Сюда входят предыдущие ответы модели, а также все сообщения пользователя для текущего ответа. Часто ответы ИИ намного длиннее, чем вопросы пользователя.
Загруженные файлы, веб-страницы и результаты поиска
Текст из файлов использует место в контексте наряду с диалогом, но приложение может предоставить файл целиком или выбрать соответствующие фрагменты. Например, Perplexity может анализировать короткие файлы полностью и извлекать важные части из длинных файлов для ответа на запрос.
Результаты поиска также занимают место. Например, чтобы ответить на запрос, Perplexity может выполнить поиск в интернете и предоставить модели результаты для ознакомления.
Ответ модели и рассуждения
Ответ записывается в то же окно, поэтому приложение должно оставить для него место. Некоторые модели также генерируют внутренние рассуждения во время работы над ответом, которые пользователь может никогда не увидеть. Текст рассуждений — это пошаговая работа модели, например разбиение вопроса на части или проверка собственных расчетов, записанная до окончательного ответа. Обычно это также учитывается в лимите окна.
Размеры контекстных окон в современных моделях ИИ
Большее контекстное окно означает, что модель может обрабатывать более длинные документы, больше источников и более длительные диалоги. Ведущие модели от OpenAI, Anthropic и Google теперь предлагают окно размером около 1 миллиона токенов. Это примерно 1500 страниц текста.
Модель
Провайдер
Контекстное окно (токены)
GPT-6 Astra
OpenAI
1,05 миллиона
Claude Opus 5.5
Anthropic
1 миллион
Gemini 4 Argon
1 048 576
Спецификации API провайдеров, проверено 5 ноября 2026 года. Лимиты, доступные внутри приложения, могут отличаться.
Большее окно не означает, что модель использует его одинаково эффективно. Исследования показали, что надежность работы может снижаться по мере увеличения длины входных данных — это явление известно как «контекстное гниение» (context rot).
Лимиты на ввод и вывод
Контекстное окно — это общий бюджет для всего, что модель читает и пишет. Модель может прочитать гораздо больше, чем может написать за один ответ.
При обработке входных данных модель может работать со многими токенами параллельно. При генерации ответа она обычно создает токены последовательно, используя то, что было раньше, чтобы выбрать, что будет дальше. Она не может выбрать пятое слово предложения, пока не узнает первые четыре, поэтому должна создавать ответ по одному токену за раз.
Это делает длинные ответы намного медленнее и дороже в производстве, чем чтение длинных входных данных. Вот почему запрос на переписывание или перевод очень длинного документа может остановиться на полпути, и почему лучше запрашивать результат по частям.
Что происходит, когда диалог превышает лимит
Когда диалог становится слишком большим для контекстного окна, приложению приходится освобождать место, прежде чем модель сможет ответить. Приложения делают это несколькими способами, и каждый из них меняет то, что модель еще может видеть.
Один из подходов — удалять самые старые сообщения первыми. Модель продолжает работать с недавней частью диалога. Ранние инструкции пользователя, решения или фрагменты документов могут выпасть из окна. Модель не может ссылаться на текст, которого у нее больше нет, но она не обязательно сообщит пользователю, что что-то пропало.
Другой подход заключается в обобщении предыдущей части беседы и сохранении этого резюме вместо полного текста. Это форма того, что называется сжатием контекста. Резюме занимает гораздо меньше места, поэтому беседа может длиться намного дольше. Однако при этом могут быть упущены такие детали, как точные цифры, имена или формулировки.
Когда модель отбрасывает или сжимает контекст, она может начать запрашивать информацию, которую уже должна знать. Она может внезапно перестать следовать инструкциям, данным в начале, например, касающимся формата или предпочтительного тона. Она может противоречить более раннему решению пользователя или стать расплывчатой в отношении документации, предоставленной ранее.
Некоторые приложения вместо этого останавливают беседу и просят пользователя начать новую или отклоняют сообщение или файл, которые слишком велики, чтобы поместиться в контекстное окно.
Повседневные привычки для работы в рамках контекстного окна
- Начинайте новую ветку для каждой новой задачи: например, рассматривайте отчет в отдельной беседе, а не добавляйте его в существующую ветку, посвященную планированию мероприятия.
- Переносите только то, что необходимо: когда задача основывается на предыдущей работе, попросите модель извлечь подтвержденные детали и утвержденные формулировки, необходимые для следующей задачи.
- Найдите нужный раздел перед тем, как делиться длинным документом: если в отчете или руководстве есть оглавление, сначала поделитесь им. Спросите модель, какие разделы, скорее всего, ответят на ваш вопрос, а затем скопируйте эти разделы в беседу.
- Изучайте длинные документы по частям: разделите руководство или отчет по правилам, главам или темам. Используйте отдельные ветки для независимых проверок с одинаковыми инструкциями для каждой из них.
- Запрашивайте длинные ответы поэтапно: для объемного переписывания или перевода запрашивайте по одному разделу за раз в рамках одной ветки. Укажите раздел или диапазон страниц и проверьте результат, прежде чем просить модель продолжить.
- Устанавливайте полезную длину ответа: просите пять выводов, краткое объяснение или таблицу с определенными столбцами. Избегайте запросов на детальный анализ, когда достаточно краткого ответа.
- Просите о точечных исправлениях: чтобы изменить один абзац в черновике, попросите модель переписать только этот абзац. Укажите, что именно нужно изменить, вместо того чтобы просить ее воспроизвести весь черновик целиком.
Как Perplexity управляет контекстом
Контекст Perplexity включает в себя не только саму беседу. Он также может опираться на информацию, найденную с помощью поиска в реальном времени, сохраненные настройки и файлы, предоставленные для задачи.
Для исследовательского вопроса поиск в реальном времени предоставляет исходный материал, который модель может использовать для построения ответа, с цитатами, указывающими, откуда была взята информация. Например, запрос о новом постановлении может добавить соответствующую информацию из сети в задачу без необходимости предварительного сбора статей и их вставки в чат.
Сохраненная память предоставляет другой вид контекста: соответствующие детали из предыдущих бесед, такие как предпочтения в стиле письма или справочная информация о текущем проекте. Perplexity извлекает эти детали при ответе, и память работает во всех предлагаемых ею моделях. Таким образом, сохраненная настройка может оставаться доступной при переключении моделей внутри Perplexity.
Для работы, охватывающей несколько бесед, «Проекты» (Projects) позволяют хранить файлы и инструкции вместе, а инструкции проекта применяются к каждому запросу. Аудитория отчета, его цель и требования к написанию могут оставаться привязанными к проекту, в то время как исследование и написание черновиков происходят в отдельных ветках.
Ознакомьтесь с разделом Начало работы с Perplexity для получения рекомендаций по задаванию вопросов, работе с файлами и развитию ответов с помощью уточняющих запросов.
Часто задаваемые вопросы
Учитываются ли изображения в контекстном окне?
Да. Изображения преобразуются в токены, которые занимают место наряду с текстом. Количество токенов зависит от того, как модель их обрабатывает. Скриншот или отсканированная страница используют место в контексте, даже если их текст не был скопирован в чат.
Стоит ли большее контекстное окно дороже?
Не обязательно. Большее окно описывает, какой объем данных модель может обработать, а не то, сколько этой емкости использует конкретная задача.
Есть ли способ увидеть, сколько контекстного окна использовала беседа?
Иногда. Некоторые приложения показывают индикатор контекста, указывающий, насколько заполнено окно. Счетчик, показывающий «оставшиеся сообщения», означает другое: сколько еще запросов может сделать учетная запись, а не сколько информации модель еще может вместить в беседу. Ищите именно индикатор контекста.
Может ли кто-то продолжить беседу, которой с ним поделились?
Да. В Perplexity можно прочитать общую беседу и задать уточняющий вопрос. Этот вопрос начинает новую беседу в учетной записи пользователя, оставляя исходную беседу без изменений.