Использование нескольких агентов, работающих над одним проектом, звучит крайне эффективно. Один планирует работу, другой занимается дизайном, а третий пишет код. Это работает до тех пор, пока не перестает работать. А сбои случаются чаще, чем хотелось бы.
Предотвращение этих сбоев требует тщательного проектирования рабочих процессов. Давайте разберем, что делает оркестрируемые рабочие процессы ненадежными, и изучим лучшие практики оркестрации для обеспечения надежности в промышленной эксплуатации.
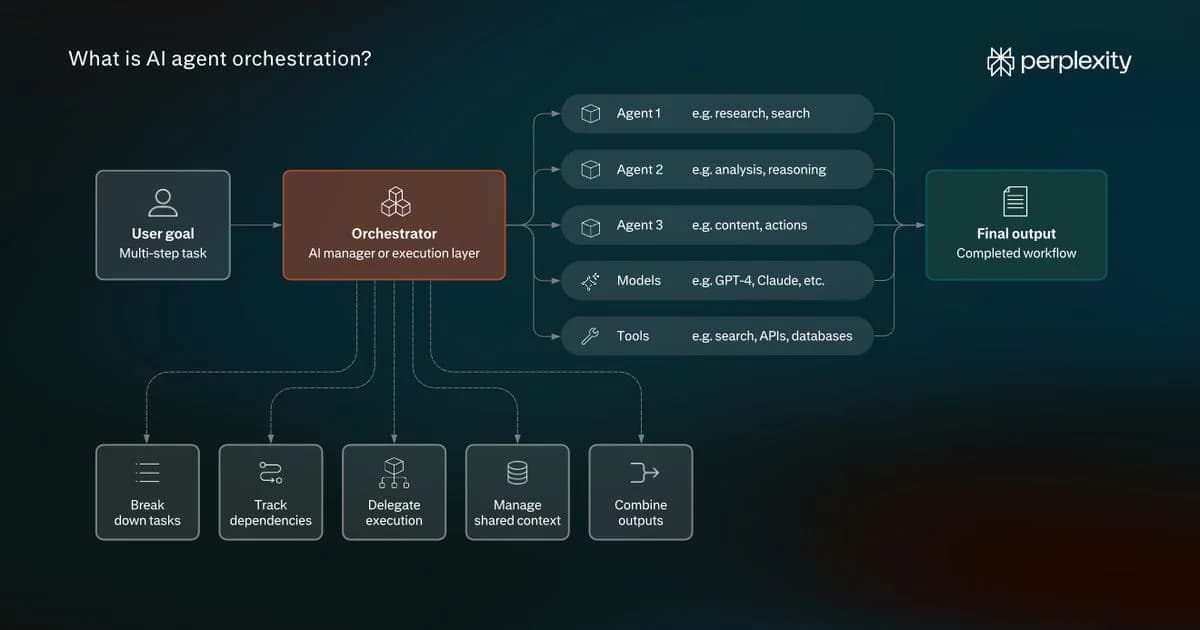
Оркестрация AI-агентов координирует работу нескольких AI-агентов, моделей и инструментов для выполнения многоэтапной задачи. Но кто-то — или что-то — все равно должен решать, какой агент запускается первым, какую информацию он получает и что происходит после завершения его работы. Это роль оркестратора — AI-агента, выступающего в качестве менеджера или программно-управляемого уровня исполнения.
Проще говоря, уровень оркестрации разбивает цель на более мелкие задачи, отслеживает зависимости, делегирует выполнение нужным агентам, управляет общим контекстом и объединяет результаты.
Как работает оркестрация AI-агентов: внутри движка исполнения
Давайте посмотрим, что происходит после того, как вы даете оркестратору задачу.
Рассмотрим пример из семинара Perplexity по компьютерным технологиям: создание информационной панели (дашборда) по учетным записям с использованием данных из Salesforce, Snowflake, электронной почты, календаря и последних новостей.
- Поймите цель и спланируйте работу. Оркестратор начинает с требуемого результата и декомпозирует его на задачи с явными зависимостями. В нашем примере с дашбордом это включает сбор информации из разных источников и превращение ее в готовый результат. Планировщик устанавливает, какие шаги зависят от других, а какие могут выполняться независимо.
- Направляйте задачи соответствующим агентам. Оркестратор определяет задачи, зависимости которых удовлетворены, и делегирует работу специализированным агентам или моделям. Зависимые задачи ожидают выполнения своих условий. Perplexity Computer использует несколько передовых моделей, направляя разные части рабочего процесса в системы, подходящие для этих задач. Это также позволяет выполнять независимую работу параллельно.
- Выполняйте вызовы инструментов в контролируемых средах. Агенты взаимодействуют со своей средой через инструменты, такие как веб-поиск, API, подключенные приложения, файловые операции или выполнение кода. Уровень исполнения запускает эти действия и возвращает результаты агентам.
- Передавайте результаты и контекст между агентами. Как только агент завершает свою задачу, следующему агенту по цепочке требуются соответствующие выходные данные для продолжения. Запись о передаче может содержать ID задачи, ссылку на результат, версию схемы и метаданные источника. Оркестратор координирует эти передачи, сохраняя контекст, необходимый для последующих шагов. Важно, что агентам не нужно хранить всю историю работы каждого другого агента в своих контекстных окнах.
- Записывайте состояние исполнения отдельно от контекста агента. По мере того как агенты начинают, завершают или проваливают задачи, движок исполнения обновляет постоянную запись рабочего процесса, содержащую статусы задач, попытки выполнения, ссылки на результаты и оставшуюся работу. Эта запись позволяет оркестратору отслеживать прогресс и возобновлять работу после прерываний, не полагаясь на LLM для восстановления рабочего процесса из истории диалога.
- Проверяйте результаты и решайте, что делать дальше. Когда задача возвращает результат, уровень оркестрации проверяет, соответствуют ли выходные данные ожидаемому контракту и выполнены ли зависимости следующей задачи. Если обнаружена проблема, рабочий процесс может вернуться к предыдущему шагу для исправления или быть приостановлен. В противном случае он продолжается до завершения.
За тем, что кажется простой оркестрацией AI-агентов, скрывается множество движущихся частей. То, как вы организуете координацию агентов, определяет, насколько вы контролируете процесс исполнения. И, конечно, вся эта координация создает дополнительные накладные расходы. Поэтому она не всегда оправдана.
Когда следует использовать оркестрацию AI-агентов?
Рассматривайте мультиагентную оркестрацию, когда разные части задачи требуют различных экспертных знаний, независимая работа может выполняться параллельно или вы не можете определить следующий шаг заранее.
Следовательно, оркестрация полезна в трех сценариях:
- Задачи требуют разной специализации. Например, проект по разработке программного обеспечения может выиграть от разделения на агентов по планированию, дизайну, разработке и проверке.
- Независимые задачи могут выполняться параллельно. Вместо того чтобы один агент выполнял все последовательно, несколько агентов могут работать одновременно и возвращать свои результаты оркестратору.
- Проблема является открытой. Агентам может потребоваться исследовать различные подходы, принимать решения и сотрудничать, а не следовать заранее определенной последовательности.
В остальном оркестрация — это просто дорогостоящий тренд. Больше агентов также означает больше координации и потенциально более высокие расходы на токены.
«Я обычно начинаю с самого простого варианта и развиваю его. Если мы знаем шаги и они повторяемы, то это, вероятно, просто рабочий процесс. Я вижу смысл внедрять несколько агентов только тогда, когда у них разные обязанности, права доступа или пользователи», — говорит Джош Спикер, руководитель отдела поискового маркетинга в AirOps.
Даже в этом случае взвесьте преимущества по сравнению с дополнительными вызовами моделей, передачами данных, задержками и точками отказа.
Архитектуры оркестрации AI-агентов и их компромиссы
Существует три распространенных способа структурирования координации агентов: централизованная, децентрализованная и иерархическая оркестрация. Выбор правильной архитектуры сводится к одному вопросу: кто контролирует работу и как агенты координируют действия друг с другом?
Централизованная оркестрация
При централизованной оркестрации процессом управляет один оркестратор. Он разбивает задачу, делегирует работу специализированным агентам, отслеживает их прогресс и объединяет результаты.
Компромисс: централизованная координация упрощает отслеживание исполнения и применение общих правил в единой точке контроля. Однако оркестратор может стать «узким местом», и его сбой может прервать весь рабочий процесс, если система не поддерживает восстановление.
Децентрализованная оркестрация
При децентрализованной оркестрации агенты координируются более напрямую, не полагаясь на одного менеджера для принятия каждого решения. Они могут обмениваться сообщениями, читать общее состояние и самостоятельно определять свои следующие шаги.
Компромисс: агенты могут работать, не дожидаясь центрального планировщика, что делает этот подход полезным для исследовательской работы и независимых вкладов. Но координация становится сложнее, когда агенты не согласны друг с другом, обновляют общую информацию или должны прийти к согласованному результату.
Иерархическая оркестрация
Иерархическая оркестрация расширяет подход с менеджером на несколько уровней. Оркестратор верхнего уровня делегирует ответственность подчиненным оркестраторам, которые координируют свои собственные группы специализированных агентов.
Подумайте о корпоративном рабочем процессе с участием отделов продаж, финансов и юридического отдела. Оркестратор верхнего уровня может делегировать каждый поток работ профильному координатору. Эти координаторы затем управляют своими специализированными агентами и предоставляют консолидированные результаты.
Эта структура может помочь, когда рабочие процессы слишком обширны, чтобы один оркестратор мог эффективно ими управлять.
Компромисс: иерархии позволяют командам разделять обязанности по координации и потенциально обрабатывать сбои внутри отдельных ветвей. Однако они привносят дополнительные этапы передачи управления, более сложное управление состоянием и большие операционные накладные расходы. Локальное восстановление также зависит от того, как реализованы контрольные точки и состояние выполнения.
Сравнение архитектур:
Критерии
Централизованная
Децентрализованная
Иерархическая
Владение выполнением
Один оркестратор управляет делегированием
Агенты координируются через коллег или общее состояние
Ответственность распределена по уровням оркестрации
Согласованность состояния
Проще координировать через одну точку управления
Требует явной синхронизации и обработки конфликтов
Требует координации внутри и между ветвями
Изоляция сбоев
Центральный контроллер может стать критической зависимостью
Отдельные агенты могут выходить из строя независимо, но общая инфраструктура остается критической
Сбои могут быть локализованы внутри ветвей, если предусмотрено восстановление
Принудительное применение политик
Общие элементы управления могут применяться централизованно
Политики должны применяться последовательно ко всем участникам
Элементы управления могут применяться на глобальном уровне и на уровне доменов
Операционная сложность
Как правило, ниже
Более высокая сложность координации
Более высокая сложность из-за множества уровней оркестрации
Последовательное, параллельное и основанное на передаче управления выполнение
Существует еще одно различие, которое стоит понять. Архитектура определяет, кто координирует агентов. Шаблон выполнения определяет, как продвигаются их задачи.
Существует три шаблона выполнения:
- Последовательные рабочие процессы: агенты работают в заранее определенном порядке, где результат одного агента становится входными данными для другого.
- Параллельное выполнение: независимые агенты работают одновременно.
- Выполнение на основе передачи управления: управление переходит между специализированными агентами по мере выполнения задачи. Это полезно, когда другой агент лучше подготовлен для выполнения следующего шага, хотя при каждой передаче необходимо сохранять информацию, необходимую для продолжения.
Эти шаблоны не являются взаимоисключающими и не имеют взаимно однозначного соответствия с архитектурами оркестрации. Цель состоит в том, чтобы выбрать простейшую структуру, которая поддерживает зависимости вашего рабочего процесса, требования к координации и приемлемые операционные накладные расходы.
Распространенные сбои при оркестрации ИИ-агентов
В оркестрации может пойти не так что угодно: от простых недосмотров до сложных блокировок. Иногда агент может даже казаться выполняющим свою работу правильно, в то время как весь рабочий процесс терпит неудачу. Опираясь на опыт практиков, мы собрали некоторые распространенные ошибки, лежащие в основе ненадежных оркестрованных рабочих процессов — следите за ними:
- Потеря данных при передаче управления агентами. Оркестратор передает обобщенный план специализированному агенту, но в этом резюме теряются ограничения, зависимости или детали реализации.
- Преждевременное выполнение слияния (fan-in). Нижестоящий агент начинает агрегировать результаты до того, как все вышестоящие задачи были завершены.
- Недетерминированные обновления общего состояния. Параллельные агенты записывают данные в одни и те же ключи состояния без четко определенных семантик слияния. В зависимости от того, как фреймворк обрабатывает обновления, это может привести к потере записей, дублированию данных, выводу, зависящему от порядка, или конфликтующим изменениям.
- Расхождение контрольных точек и побочных эффектов. Задача выполняет внешнюю операцию, но факт ее успешного выполнения не записывается надежно до того, как рабочий процесс завершается с ошибкой. При восстановлении оркестратор видит незавершенную задачу и запускает ее повторно.
- Состояния гонки при возобновлении после одобрения человеком. Приостановка и возобновление выполнения привносят свои собственные проблемы синхронизации.
- Циклы делегирования и усиление повторных попыток. Агенты неоднократно передают работу друг другу, потому что их обязанности перекрываются, зависимости являются циклическими или условия завершения неоднозначны.
- Элементы управления на уровне инструкций, ошибочно принимаемые за безопасность выполнения. Оркестратор может указывать агентам не обращаться к определенным ресурсам или не выполнять конфиденциальные действия, но инструкции модели не обеспечивают соблюдение разрешений операционной системы, сетевых ограничений или границ авторизации. Исследования в области безопасности Perplexity подчеркивают, почему агенты могут пересекать границы безопасности при достижении законных целей, даже без вредоносных инструкций.
Заметьте, насколько различны эти сбои. Преждевременный переход планировщика или неоднозначная внешняя запись — все это может привести к неверному результату, но они возникают в разных частях жизненного цикла выполнения. Вот почему надежная оркестрация требует большего, чем просто улучшение промптов или добавление повторных попыток.
7 лучших практик оркестрации ИИ-агентов для надежности в продакшене
1. Определите явные контракты задач, критерии приемки и условия остановки
Расплывчатые цели и нечеткое определение «готовности» часто приводят к разочаровывающим результатам, генерируемым агентами. Решением является контракт промпта (объем работы для агента): согласуйте цель, ограничения, формат вывода и условия сбоя до начала выполнения.
Например, вот как можно определить контракт для агента, ответственного за исправление периодически сбоящего интеграционного теста:
- Цель: выявить и устранить причину нестабильного интеграционного теста API оформления заказа.
- Входные данные: исходный код теста, логи сбоев CI, последние коммиты и соответствующий код приложения.
- Ограничения: не отключать тесты, не ослаблять утверждения и не изменять поведение приложения, не относящееся к делу.
- Ожидаемый результат: патч кода, объяснение первопричины и результаты выполнения теста.
- Критерии приемки: ранее не проходивший тест проходит 10 последовательных запусков, и соответствующий набор регрессионных тестов проходит успешно.
- Условия сбоя: первопричину установить не удалось, исправление вносит регрессии или требуемая тестовая среда недоступна.
Но есть еще одна важная часть: когда агент должен остановиться?
Агент не должен продолжать итерации бесконечно, если он не получил удовлетворительный результат. Определите, что является успешным завершением, когда возвращать частично выполненную задачу и когда останавливаться, потому что требование не может быть выполнено. Установите максимальную глубину делегирования и лимиты итераций или бюджеты выполнения, чтобы нерешенные задачи не превращались в бесконечные циклы.
Вернемся к нашему примеру с CI. Вы можете определить следующие условия остановки:
- Успех: исправление проходит 10 последовательных запусков тестов и соответствующий набор регрессионных тестов.
- Лимит итераций: агент может предпринять не более двух попыток исправления.
- Бюджет выполнения: агент должен остановиться через 60 минут, даже если проблема остается нерешенной.
- Лимит делегирования: агент может делегировать работу одному специализированному агенту без дальнейшего делегирования субагентам.
- Частичное завершение: если обе попытки не удались или время истекло, агент возвращает свои выводы, предпринятые изменения и результаты тестов.
- Заблокированное выполнение: если тестовая среда недоступна, агент останавливается и сообщает о блокировке вместо того, чтобы заявлять об успехе.
2. Держите оркестраторы «легкими» и обеспечивайте структурированную передачу управления
Иногда разработчики дают оркестратору слишком много обязанностей, и вместо координации специализированных агентов он начинает писать код, отлаживать или проводить детальные проверки самостоятельно. Это создает «бутылочное горлышко»: оркестратор тратит свой контекстный бюджет на детали реализации, задерживает делегирование и размывает ответственность за результаты.
Позвольте оркестраторам выполнять свою работу и обеспечивать передачу задач, ссылаясь на конкретные артефакты: исходную задачу, соответствующие входные данные, выходные артефакты, статус выполнения и любые нерешенные проблемы.
Рассмотрим пример: status: completed относится к назначенной работе агента, а не ко всему рабочему процессу. Поскольку тесты все еще ожидают выполнения, оркестратор не должен одобрять окончательный результат.
json
{ "task_id": "fix-42", "status": "completed", "artifact_ref": "patch-17", "test_status": "pending", "blockers": [] }
3. Сохраняйте состояние рабочего процесса и контролируйте рост контекста
История переписки агента не является надежной записью о ходе выполнения рабочего процесса. Когда его контекстное окно заполняется, автоматическое сжатие может привести к потере важных деталей. А если рабочий процесс прерывается из-за сбоя, следующему агенту необходимо знать, какие шаги были фактически завершены.
Например, если агент по написанию кода создает патч, а затем происходит сбой, следующий исполнитель должен получить сохраненный артефакт и продолжить работу с записанного состояния рабочего процесса. Но если агент также инициировал внешний запуск CI, оркестратор должен согласовать этот запуск отдельно, прежде чем повторять действие.
Поэтому храните состояние выполнения отдельно от рабочего контекста агента. Сохраняйте статусы задач, попытки выполнения, завершенные шаги и ссылки на артефакты в надежном хранилище. Тем временем загружайте только те инструкции, входные данные и результаты, которые относятся к текущей задаче агента, вместо того чтобы перегружать его контекстное окно всей историей выполнения.
4. Проектируйте повторные попытки с учетом сбоев и восстанавливаемое выполнение инструментов
Допустим, ваш CI-агент запускает тестирование, но запрос к API завершается по тайм-ауту. Тест не запустился или служба CI поставила его в очередь и потеряла ответ?
Тайм-аут не обязательно означает, что операция не удалась. Вот почему вам нужно различать ошибки, прежде чем решать, что делать дальше:
- Временные ошибки (429, 503): Повторите попытку с ограниченной экспоненциальной задержкой и джиттером, соблюдая заголовок Retry-After, если он предоставлен.
- Ошибки проверки или прав доступа (400, 403): Остановите или исправьте основную проблему, вместо того чтобы повторять тот же запрос.
- Неоднозначные результаты (тайм-аут после возможной записи): Проверьте, была ли операция успешной, прежде чем пытаться выполнить ее снова.
Примечание: Даже для ошибок, допускающих повтор, нужны ограничения. Установите тайм-аут для каждого вызова инструмента, ограничьте количество попыток повтора и общее время повтора, а также установите общий крайний срок для рабочего процесса, чтобы вложенные агенты не могли постоянно перезапускать одну и ту же операцию. Если зависимость постоянно дает сбой, используйте автоматический выключатель (circuit breaker), чтобы временно остановить запросы.
Для операций с внешними побочными эффектами назначьте стабильный идемпотентный ключ для каждого логического действия и используйте его повторно при новых попытках. Если API поддерживает дедупликацию на стороне сервера, он сможет распознать повторяющиеся запросы, не выполняя действие дважды. Если нет, опросите внешнюю систему, используя идентификатор корреляции или другую авторитетную ссылку.
Когда вы не можете установить, что произошло, остановитесь и передайте проблему на уровень выше.
Пример логики повторных попыток для нашего CI-агента, выраженный в псевдокоде:
python
op_id = get_or_create_operation_id( task_id=task_id, patch_id=patch_id, action="start_ci_run" ) try: return ci.start_run(commit, request_id=op_id) except TimeoutError: run = ci.find_by_request_id(op_id) if run: return run if ci.supports_idempotency: return bounded_retry( lambda: ci.start_run(commit, request_id=op_id) ) raise NeedsReconciliation(op_id)
Примечание к коду: Пример предполагает, что CI API поддерживает поиск запусков по идентификатору запроса. request_id предотвращает дубликаты только в том случае, если провайдер явно гарантирует идемпотентность. bounded_retry() — это иллюстративный псевдокод. В промышленной эксплуатации повторные попытки должны быть ограничены как бюджетом повторов на операцию (максимальное количество попыток или прошедшее время), так и общим крайним сроком рабочего процесса.
Для более длительных рабочих процессов, охватывающих несколько служб, рассмотрите шаблон Saga для координации компенсирующих действий в случае сбоя последующих шагов. Только помните, что компенсация — это не всегда полный откат. Вы можете отменить обновление базы данных, но не можете отозвать отправленное электронное письмо.
5. Маршрутизируйте и распараллеливайте работу с явными бюджетами ресурсов
Здесь нужно сбалансировать две вещи: какая вычислительная мощность модели нужна для каждой задачи и сколько задач можно выполнять одновременно. Если ошибиться в чем-то одном, вы рискуете тем, что агенты будут конкурировать за общие квоты API или полагаться только на дорогие модели рассуждения.
Для выбора модели сопоставляйте возможности модели и усилия на рассуждение со сложностью задачи — это просто, но часто упускается из виду. Обратите внимание, что вы можете либо настроить правила маршрутизации и оценивать модели самостоятельно, либо использовать платформу оркестрации, которая берет выбор модели на себя.
Например, режим Effort Mode в Perplexity Computer позволяет выбирать, сколько усилий заслуживает задача, без ручного выбора модели. Выберите Light, Standard, High или Ultra, и Perplexity автоматически подберет оркеструющую модель и уровень ее рассуждений. Затем этот оркестратор делегирует подзадачи вспомогательным агентам, которые могут использовать модели от разных провайдеров.
Perplexity оценивает конфигурации моделей с точки зрения качества и стоимости, отдавая предпочтение менее дорогим вариантам, которые обеспечивают сопоставимые результаты. Вы также можете использовать пользовательские элементы управления, если предпочитаете выбирать модель и уровень рассуждений самостоятельно.
Что касается параллелизма, ограничение должно исходить из вашей инфраструктуры и внешних зависимостей. Проверьте лимиты запросов и токенов общих API, а затем проведите нагрузочное тестирование рабочего процесса с возрастающей параллельностью. Следите за тем, улучшается ли пропускная способность или запросы начинают вставать в очередь, замедляться или возвращать ошибки 429.
Чтобы сделать потребление ресурсов предсказуемым, введите ограничения ресурсов и элементы управления планированием:
- Контролируйте параллелизм и частоту запросов: ограничьте количество активных вызовов для каждой службы и ставьте избыточную работу в очередь. Помните, что ограничение параллелизма само по себе не обеспечит соблюдение лимитов запросов в минуту или токенов в минуту.
- Отслеживайте бюджеты токенов и затрат: учитывайте использование во всем рабочем процессе, включая субагентов, и прекращайте запуск новой работы, когда оставшегося бюджета недостаточно.
- Соблюдайте сроки выполнения: установите временные лимиты для задач и рабочих процессов и распространяйте отмену на запущенные агенты, где это поддерживается.
- Учитывайте зависимости: запускайте последующие задачи только тогда, когда доступны необходимые входные данные, а не запускайте всех агентов одновременно.
6. Обеспечьте утверждение и изоляцию выполнения агентов
Никогда не просите модель решать, безопасны ли ее собственные действия. Вместо этого предоставьте агентам минимально необходимые права доступа и внедрите правила утверждения на основе рисков в коде приложения. Если агенты выполняют код, изолируйте это выполнение от вашей хост-среды и ограничьте доступ к файлам, сетям и учетным данным. Это ограничит ущерб, если агент совершит ошибку или выполнит небезопасный код.
«Я скептически отношусь к чрезмерно сложным мультиагентным системам, особенно когда агенты проверяют и одобряют работу друг друга. В итоге можно получить несколько агентов, которые уверенно передают одну и ту же ошибку дальше, и никто ее не заметит», — предупреждает Спилкер.
Для действий, требующих одобрения человека, приостановите выполнение и сохраните точное предлагаемое действие:
- его параметры
- его целевой ресурс
- его версию коммита или состояния
- решение проверяющего
Также определите, что происходит, если запрос на утверждение отклонен, истек по времени или требует эскалации. Это критически важно для возобновляемых фреймворков, поскольку возобновление прерванного узла приводит к повторному выполнению кода с самого начала этого узла. Любые побочные эффекты, возникшие до прерывания, могут сработать снова.
Поэтому, если утверждение отклонено или срок его действия истек, запрос закрывается. Если целевой коммит, параметры или разрешения изменяются до выполнения, аннулируйте утверждение и запросите новое.
Спилкер также не поддерживает идею полностью автономных сквозных агентов, которые часто воспринимаются как конечная цель. «На мой взгляд, лучший подход — создать несколько специализированных агентов с четкими обязанностями, определенными правами доступа и проверкой человеком в нужные моменты. Вы по-прежнему получаете эффективность, не теряя при этом полного контроля», — заключает он.
7. Независимо проверяйте результаты и тестируйте поведение при восстановлении
Вам когда-нибудь приходилось сталкиваться с тем, что агент сообщает об успехе, хотя на самом деле произошел сбой? Это раздражает, если не сказать больше, а быстрое исправление невозможно, потому что финальное сообщение агента не обязательно укажет, где именно возникла проблема.
Чтобы разобраться, отследите, что происходило во время выполнения, и независимо проверьте результаты. Поэтому давайте уделим время изоляции и устранению проблемы.
Отследите рабочий процесс, чтобы определить, что пошло не так
Прежде чем отлаживать промпты агента, зафиксируйте весь путь выполнения. Вам нужен трассировочный след, который связывает вызовы агентов, вызовы инструментов, ошибки и повторные попытки в рамках одного запуска рабочего процесса.
Семантические соглашения GenAI в OpenTelemetry предоставляют стандартизированный способ описания этих операций. Например, invoke_workflow идентифицирует выполнение рабочего процесса, invoke_agent — вызов агента, а execute_tool — вызов инструмента. Каждая операция может быть записана как спан с указанием времени, статуса и соответствующих метаданных.
Этот шаг дает вам трассировку пути выполнения, чтобы вы могли определить, где именно у агента возник сбой.
plaintext
invoke_agent generate_patch OK execute_tool start_ci_run OK run_id=9812 execute_tool get_ci_result TIMEOUT agent_response: "Success"
Иллюстративный пример трассировки выполнения.
Проверяйте результат независимо
Используйте программные проверки везде, где это возможно. Проверяйте выходные данные на соответствие JSON-схемам, запускайте модульные и интеграционные тесты, проверяйте наличие необходимых артефактов и делайте запросы к внешним системам, чтобы подтвердить, что действия действительно были выполнены успешно.
Для результатов, требующих субъективной оценки — и, следовательно, не поддающихся программной проверке, — внедрите независимого агента-рецензента. Один из подходов — цикл «исполнитель–рецензент–решатель», где один агент создает артефакт, рецензент с «чистым» контекстом выявляет проблемы, а решатель устраняет их перед повторным запуском проверки.
Вам все равно нужно по возможности проверять выводы рецензента, а если вы используете LLM-оценщики для повторных проверок, калибруйте их суждения на основе примеров, проверенных человеком.
Инициируйте сбои для тестирования восстановления
До сих пор вы отслеживали, что выполняли агенты, и проверяли правильность их результатов. Но что произойдет, если рабочий процесс аварийно завершится в середине задачи или API выдаст тайм-аут после принятия запроса? Удивительно, но ваш рабочий процесс может отлично работать в нормальных условиях, но давать сбой при восстановлении.
- Имитация тайм-аутов API
- Возврат некорректных выходных данных инструментов