Уровни интенсивности в API Perplexity Agent позволяют разработчикам выбирать баланс между стоимостью, скоростью и глубиной исследования для каждой задачи. Сегодня каждый уровень интенсивности стоит меньше за запрос, при этом качество исследований стало выше или осталось прежним. Доступен новый уровень «ultra» для самых масштабных и всесторонних исследований. Любой запрос, в котором уровень выбран по названию, например effort="fast", автоматически получает обновленную конфигурацию.
Создание исследовательского агента означает выбор правильного баланса между стоимостью, скоростью и глубиной для каждой задачи. Уровни интенсивности в Agent API упрощают это решение для пользователя. Каждый уровень представляет собой комплексную конфигурацию, определяющую модель, бюджет шагов, настройки поиска и инструменты для конкретного типа задачи. Perplexity оценивает и обновляет каждый уровень с течением времени, чтобы обеспечить наилучшие результаты исследований по текущей цене или ниже.
Эти улучшения стали результатом двух типов изменений. Оптимизация бюджетов, обработки контекста и извлечения данных снизила стоимость каждого запуска, а навыки, выбор моделей и параллельная работа агентов повысили или сохранили качество ответов.
Производительность уровня «medium» улучшилась с 55% до 77% в тестах BrowseComp и DSQA, при этом затраты снизились почти на 90%. BrowseComp и DSQA — это публичные исследовательские бенчмарки; WANDR — это бенчмарк Perplexity для длительных исследовательских задач с множеством сущностей. Уровень «xhigh» выполняет агентную работу, такую как выполнение кода в «песочнице», поддержание длительных циклов использования инструментов и одновременная работа с множеством источников. Уровень «xhigh» сохранил свой показатель WANDR на уровне 76,5%, работая при этом примерно за 25% от стоимости конфигурации августа 2026 года.
Стоимость исследования
Запрос на глубокое исследование может включать десятки поисковых операций, чтение сотен страниц и проверку доказательств перед формированием ответа. Каждое из этих действий добавляет токены в контекст и увеличивает стоимость. Без ограничений агент продолжает выполнять действия, которые повышают стоимость и перегружают контекст, не улучшая при этом ответ. Пять факторов определяют большую часть этих затрат:
- Распределение бюджета. Агенты с установленным бюджетом могут исчерпать количество шагов и завершить работу раньше, не выполнив задачу до конца. И наоборот, агенты без фиксированного бюджета могут продолжать работу, увеличивая расходы без улучшения итогового ответа.
- Избыточность контекста. Результаты поиска и загруженные страницы содержат доказательства, но если их не контролировать, контекстное окно может быстро заполниться нерелевантной информацией. Контекстные окна требуют затрат на каждом шаге, а перегруженные окна могут снизить производительность агента.
- Выбор рабочего процесса. Разные задачи требуют разных подходов. Поиск одного факта, многоходовой вопрос и широкий обзор источников требуют разных рабочих процессов. Если оставить выбор модели на усмотрение самой модели, она часто выбирает неэффективный путь. Детализация каждой доступной стратегии в промпте агента не решает эту проблему. Дополнительные инструкции передаются как токены на каждом шаге, и модель со временем все менее надежно следует каждой из них.
- Выбор модели. Переход на более крупную модель не всегда обеспечивает улучшение производительности, соразмерное дополнительным затратам. Новые модели появляются с громкими заголовками и опубликованными результатами бенчмарков. Однако результаты бенчмарков могут быть искажены или отражать переобучение модели. Без оценки на реальных задачах смена модели может увеличить расходы, не повышая качество.
- Масштабирование мультиагентных систем. Один агент может искать, читать и анализировать ограниченное количество источников за один запуск. Запуск нескольких агентов параллельно улучшает качество при выполнении наиболее сложных задач, но также увеличивает затраты и вносит сложность, если управление ими организовано неправильно.
Решение каждой из этих проблем позволило снизить затраты для каждого уровня интенсивности без снижения производительности.
Контроль исследовательского бюджета
Каждый уровень интенсивности имеет фиксированный исследовательский бюджет, состоящий из трех компонентов:
- Лимиты шагов: количество итераций, которые может выполнить агент.
- Вызовы инструментов: ограничение на общее количество вызовов инструментов в запросе. Один шаг может инициировать несколько вызовов разных инструментов одновременно, поэтому одного лимита шагов недостаточно для контроля количества действий внутри шага.
- Напоминания о бюджете: периодические уведомления о том, сколько шагов осталось, чтобы агент мог расставить приоритеты и оставить место для написания ответа, а не исчерпать бюджет в середине задачи.
Бюджет — это главный компромисс: больше шагов означает лучшие ответы, но каждый шаг влечет за собой расходы. При использовании openai/gpt-6-luna увеличение лимита шагов с 1 до 15 повышает точность в BrowseComp + DSQA с 41% до 80%, при этом стоимость запроса возрастает с $0,0017 до $0,0152 — примерно в 9 раз дороже при двукратном росте показателя.
Одного лимита шагов недостаточно для контроля стоимости исследования. При одинаковом бюджете в пять шагов openai/gpt-6.1-terra делает больше вызовов инструментов, чем openai/gpt-6-luna, поскольку более способные модели склонны выполнять несколько вызовов за один шаг. Уровни интенсивности ограничивают как вызовы инструментов, так и количество шагов. Для этих моделей ограничение на вызовы инструментов так же важно, как и лимит шагов.
Каждый уровень интенсивности настраивает эти лимиты, но агент также должен знать, сколько шагов и действий у него осталось для выполнения запроса. Без этой информации он может исчерпать лимиты и быть вынужденным дать ответ до завершения исследования. Бюджет указывается в начале запуска, а напоминания приходят по мере приближения агента к лимитам, чтобы оставалось время для проверки и предоставления результатов. Для уровня «high» напоминания охватывают как бюджет шагов, так и бюджет вызовов инструментов.
Два агента, один с напоминанием о бюджете, а другой без, были протестированы на задаче BrowseComp по поиску телесериала 1990-х годов на основе трех биографий актеров. Агент с напоминанием нашел правильный ответ, используя 13 из 40 шагов бюджета. Агент без напоминания использовал все 40 шагов и не нашел правильный ответ. Цикл работы этого агента завершился неожиданно, и модель не знала об оставшемся исследовательском бюджете. Напоминания помогают агентам сохранять фокус и эффективно расставлять приоритеты при использовании оставшихся ресурсов.
Управление контекстом
Сжатие
Длительные исследовательские задачи заполняют контекстное окно модели результатами поиска, загруженными страницами и промежуточными заметками. Как только оно заполняется, агент должен прекратить работу.
Сжатие позволяет продолжать длительные сессии, не переполняя контекстное окно. Когда контекст превышает пороговое значение, агент заменяет проделанную работу кратким резюме того, что уже найдено и что еще предстоит сделать, а затем продолжает работу.
Сжатие всегда сохраняет в контексте три элемента: системный промпт, исходный запрос и любые навыки, которые агент уже загрузил. После каждого сжатия агент получает две короткие инструкции. Первая инструкция: «Продолжай работу, пока задача не будет выполнена». Это не дает агенту воспринимать резюме как точку остановки. Вторая инструкция сообщает агенту, сколько сжатий уже произошло, чтобы он мог планировать оставшиеся исследовательские задачи. Длительные сессии позволяют удерживать в поле зрения исходную цель и план, а стоимость длинных циклов снижается без потери качества.
Загрузка только важного
Каждая страница, которую читает агент, добавляется в его контекст, и агент несет этот груз на каждом последующем шаге. Веб-страница содержит информацию, не относящуюся к вопросу, такую как навигация, шаблонный текст и другой контент.
Вместо того чтобы передавать агенту всю страницу целиком, fetch_url сначала выполняет проход извлечения данных. Текст страницы отправляется меньшей модели вместе с текущей задачей агента. Модель возвращает только релевантные фрагменты, цитируемые дословно, чтобы агент мог на них ссылаться. В ходе оценки страница объемом 5561 токен была сокращена до 293 токенов, что освободило место для дополнительного релевантного контекста.
Использование fetch_url с извлечением данных на высоком уровне усилий сократило количество входных токенов на запрос примерно на 50%. Извлечение также улучшило показатели производительности, достигнув 88,0% при стоимости $0,073 за запрос по сравнению с 83,5% при $0,094 без извлечения.
Целенаправленный веб-поиск
Поиск в интернете является центральным элементом любого исследовательского запроса агента. Были внесены три изменения в то, как агенты выполняют поиск:
- Больше контекста на каждый поиск: теперь каждый поиск возвращает до 4 тыс. токенов результатов вместо 2 тыс. Агент быстрее находит то, что ему нужно, что приводит к меньшему количеству поисковых запросов и снижению затрат.
- Новый механизм сниппетов: результаты поиска получают сниппеты, которые лучше соответствуют запросу, поэтому агент не перегружен нерелевантным текстом.
- Быстрый поиск: при стоимости $1,00 за 1 тыс. запросов Fast Search снижает как затраты, так и задержку для каждого поискового вызова.
Команда Perplexity Search постоянно улучшает качество поиска по широкому спектру задач. Последние обновления принесли улучшения в работе с кодом, документацией для разработчиков, справочными страницами, юридическим и нормативным контентом.
Выбор правильного рабочего процесса
Некоторые задачи требуют параллельного выполнения множества поисковых запросов; другие требуют внимательного прочтения нескольких длинных документов.
Однако загрузка каждого рабочего процесса в системный промпт агента увеличивает накладные расходы на контекст и может привести к снижению эффективности модели при выполнении простых задач. Вместо этого навыки организованы в дерево с прогрессивным раскрытием. Модель загружает соответствующие навыки и инструкции по мере работы, оставляя нерелевантную информацию вне контекста. Каждый навык стоит лишь своего названия и описания, пока модель не решит, что он подходит для задачи, и не загрузит его; в этот момент полные инструкции добавляются в контекст, и модель следует предписанному рабочему процессу.
Чтобы измерить вклад отдельных навыков, каждый навык удаляется по одному для сравнения качества и стоимости выполнения задач, в которых базовый агент загружал этот навык. Эти абляции показывают, какие рабочие процессы помогают агенту и как они влияют на эффективность исследования.
Приведенные ниже результаты теста WANDR демонстрируют, как агенты выбирают правильные рабочие процессы для конкретных задач. Руководства по широкому поиску (wide-search) и веерной рассылке (fanout) загружались для каждой задачи, что отражает необходимость исследования нескольких сущностей. Навык поиска людей (people-search) загружался только для 6% задач, и только тогда, когда вопросы касались людей.
При тестировании другой задачи WANDR агент загрузил навык поиска людей с шаблоном веерной рассылки, чтобы найти инженеров по выводу (inference engineers) в Лондоне. Он расширил 39 терминов ролей до 117 запросов, а затем объединил результаты первого прохода в 43 уникальных профиля для дальнейшего отбора. Навык поиска людей помог агенту выполнить это расширение без добавления нерелевантного контекста. Приведенный ниже отрывок адаптирован из скрипта агента; имена вспомогательных функций являются иллюстративными.
text
Python # roles содержит 39 вариантов ролей, выбранных агентом. queries = [] for role in roles: queries.extend([ {"query": f"Google DeepMind {role} London"}, {"query": f"Google {role} London"}, {"query": role, "company": "Google", "location": "London"}, ]) results = pplx_sdk.search.people_many( queries, limit_per_query=50, concurrency=8 ) profiles = {} for result in results: if not result.ok: continue for profile in result.result: if "linkedin.com/in/" not in profile.url: continue url = profile.url.split("?")[0].rstrip("/") previous = profiles.get(url, {}) if url not in profiles or len(profile.summary or "") > len( previous.get("summary") or "" ): profiles[url] = { "url": url, "title": profile.title, "summary": profile.summary, }
Контрольные точки (checkpointing) — это еще один рабочий процесс, который помогает агентам при выполнении длительных задач. Шаблон контрольных точек пришел из пакетного программирования. Когда скрипт обрабатывает длинный список, он записывает каждый результат на диск сразу после получения, вместо того чтобы хранить все в памяти до самого конца. Если скрипт аварийно завершается или сталкивается с ошибками на полпути, ничего не теряется: следующий запуск считывает то, что уже было сохранено, и продолжает с того места, где остановился, повторяя только те элементы, которые завершились неудачей.
В другой задаче WANDR агенту нужно было проверить профили 188 инженеров. Он загрузил шаблон контрольных точек, чтобы записывать каждый результат по мере работы. Первый проход извлек 160 профилей, но не справился с 28. Когда агент запустил скрипт снова, он пропустил уже записанные профили и повторил попытку только для оставшихся 28. Без контрольной точки одна плохая запись означала бы повторную загрузку всех 188 профилей. Адаптированный отрывок на Python; входные страницы, инструкции по отбору, схема и импорты опущены; имена вспомогательных функций являются иллюстративными.
text
Python checkpoint = Checkpoint("research/profile-screening") config = instruction + json.dumps(schema) config_id = hashlib.md5(config.encode()).hexdigest()[:6] def checkpoint_key(page): url_id = hashlib.md5(page["url_in"].encode()).hexdigest()[:10] return config_id + url_id pending = [ page for page in pages if not checkpoint.has(checkpoint_key(page)) ] for offset in range(0, len(pending), 20): batch = pending[offset : offset + 20] inputs = [ json.dumps({ "url": page["url_in"], "content": page["content"][:30_000] }) for page in batch ] results = pplx_sdk.llm.extract_many( inputs, instruction=instruction, output_schema=schema, chunk_size=5, concurrency=4, ) for page, result in zip(batch, results): if not result.ok or result.result.error: continue checkpoint.record( checkpoint_key(page), [{"url": page["url_in"], **result.result.result}], )
Контрольная точка записывает успешные результаты; она не запускает повторные попытки. Включение инструкции и схемы в ключ гарантирует, что измененные критерии отбора вызовут повторную обработку.
Не каждый тест привел к повышению качества и эффективности. Была проведена оценка предварительной загрузки всех навыков в агента перед началом выполнения задачи. В тестах BrowseComp и DSQA предварительная загрузка увеличила затраты на 13%. В WANDR, где более длинные траектории исследования делают извлеченный контент большей долей входных токенов, предварительная загрузка также снижает оценки. Эти результаты подтвердили необходимость дальнейшего использования прогрессивного раскрытия.
Выбор модели
По мере развития возможностей моделей меняется и лучшая модель для каждого уровня усилий. Perplexity использует автоматизированный исследовательский цикл, который отслеживает анонсы новых моделей и их доступность. Оценки запускаются, как только модель становится доступной.
Когда выпускается новая модель, автоматизированный агент пропускает ее через систему оценки. Он варьирует уровень усилий рассуждения, бюджеты шагов и вызовов инструментов, а также конфигурации инструментов, и оценивает каждый запуск по качеству и стоимости в сравнении с текущими уровнями усилий. Если показатели запуска ухудшаются, агент исследует причину, корректирует настройки и запускает оценку снова. Модель-кандидат заменяет текущую только тогда, когда она выигрывает по качеству при той же или более низкой стоимости.
Публичные бенчмарки полезны, но их результаты не всегда отражают эффективность в реальных задачах. Например, на графике ниже показана модель-кандидат, которая набрала на 13,3 балла больше базовой на BrowseComp, но оказалась значительно ниже соответствующих базовых показателей на внутренних корпоративных, юридических и финансовых исследовательских задачах.
Масштабирование мультиагентных систем
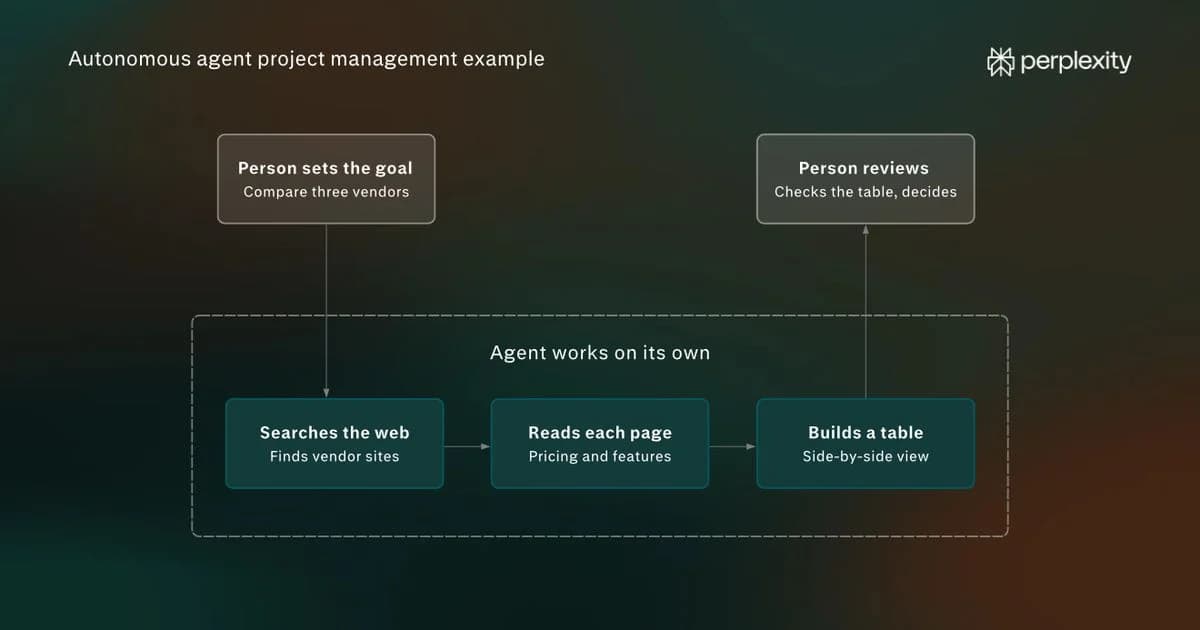
Один агент может охватить лишь ограниченное число источников за один цикл. Для сложных задач несколько агентов работают параллельно, причем каждый координирует свою часть проблемы.
Основной агент выступает в роли оркестратора. Он вызывает spawn_agent для создания дочерних агентов и назначает каждому конкретную, сфокусированную задачу. Каждый дочерний агент выполняет собственный цикл исследования в отдельном контексте, используя собственную модель, инструменты и бюджет шагов. Дочерние агенты сообщают о своих результатах родительскому агенту, который может отправить дочернему агенту повторное задание или проверить его прогресс. Оркестратор и его дочерние агенты обмениваются сообщениями для обмена доказательствами, обозначения препятствий и корректировки дальнейших шагов. По мере поступления новой информации оркестратор уточняет задания и, когда работа завершена, объединяет результаты в единый ответ.
Agent API поддерживает предопределенные роли агентов, а оркестратор может создавать дочерние агенты с пользовательскими инструкциями.
Уровень максимальной производительности (ultra) запускает трех агентов для работы над задачей параллельно. Каждый агент независимо исследует всю задачу, что приводит к получению различных доказательств. Четвертый агент объединяет их выводы, удаляет дубликаты и пишет окончательный ответ.
На WANDR режим ultra набирает 85,9% при стоимости $21,71 за задачу. Он достигает наивысшего балла среди протестированных конфигураций.
Что дальше
Уровни усилий постоянно оцениваются и совершенствуются. Выбираемый пользователем уровень определяет объем исследований для задачи и ее стоимость. Бюджеты шагов и вызовов инструментов с напоминаниями по мере их исчерпания удерживают запросы в рамках бюджета. Сжатие, извлечение данных и более качественные фрагменты помогают удерживать контекст сосредоточенным на доказательствах. Навыки сопоставляют рабочий процесс с задачей, а параллельные агенты расширяют то, что может охватить один цикл. Цикл автоматической оценки допускает новую модель только тогда, когда она повышает качество исследований при той же стоимости.
Каждый уровень усилий будет продолжать развиваться по мере того, как новые модели и конфигурации будут доказывать свою эффективность при оценке. Вызов уровня по имени автоматически подхватывает эти улучшения; закрепление версии фиксирует конфигурацию.
Попробуйте Agent API и сравните уровни усилий на собственных рабочих нагрузках. Подробную информацию об уровнях усилий можно найти в нашей документации по Agent API.