Память ИИ — это информация, которую разговорный ИИ-ассистент сохраняет из прошлых бесед и переносит в новые, чтобы учитывать ваши предпочтения и контекст. Сама модель ничего из этого не хранит. Ассистент сохраняет данные отдельно и добавляет их обратно при необходимости, обеспечивая модели постоянный контекст, которого ей в противном случае не хватало бы.
В этом руководстве объясняется, как ассистенты сохраняют и воспроизводят эту информацию, что они хранят, почему иногда ошибаются, а также как просмотреть, изменить или отключить эту функцию.
Что такое память ИИ?
Память ИИ, также известная как постоянная память, относится к функции ИИ-ассистента, которая хранит информацию о вас — например, предпочтения, факты и контекст прошлых взаимодействий, — которую ассистент может использовать в последующих беседах.
ИИ-ассистент может формировать эту базу на основе того, что вы просите его запомнить, деталей, которые он улавливает самостоятельно, и более ранних чатов, к которым он может обращаться.
Уровень памяти ИИ позволяет ассистентам предлагать персонализированные ответы без необходимости делиться своими предпочтениями в каждом чате. Если вы сказали ассистенту, что готовитесь к марафону и предпочитаете километры, ваш следующий вопрос о темпе получит ответ в километрах без повторения этой информации.
По сравнению с необходимостью заново объяснять свою ситуацию в каждом чате, память экономит время на ввод текста и делает промпт коротким, что важно, поскольку длинные входящие данные снижают точность ответов.
Память — это не стенограмма каждой беседы, а набор ключевых фактов о вас. Поэтому ИИ запомнит, что вы предпочитаете километры. Поиск точного плана тренировок, составленного в прошлом месяце, зависит от того, умеет ли ассистент также просматривать прошлые чаты.
Типы памяти ИИ
Разработчики заимствовали терминологию из науки о человеческой памяти для классификации систем памяти ИИ. Их структура разделяет рабочую память и долговременную память:
- Рабочая память: то, что модель удерживает для текущего шага, то есть текущая беседа плюс все извлеченные данные. Также известна как кратковременная память.
- Долговременная память: постоянная память между сеансами. Именно об этом типе памяти идет речь в данной статье.
Долговременная память состоит из трех типов:
- Эпизодическая память: записи о прошлых взаимодействиях, такие как чат, в котором вы запросили план тренировок в прошлом месяце.
- Семантическая память: знания о мире и о вас, например предпочтение километров.
- Процедурная память: то, как ведет себя ИИ-агент, заложенное в веса модели, а также в код и промпты, управляющие агентом. В ИИ-ассистенте ближайшим эквивалентом являются системный промпт и ваши пользовательские инструкции.
Память ИИ-ассистента против памяти ИИ-агента
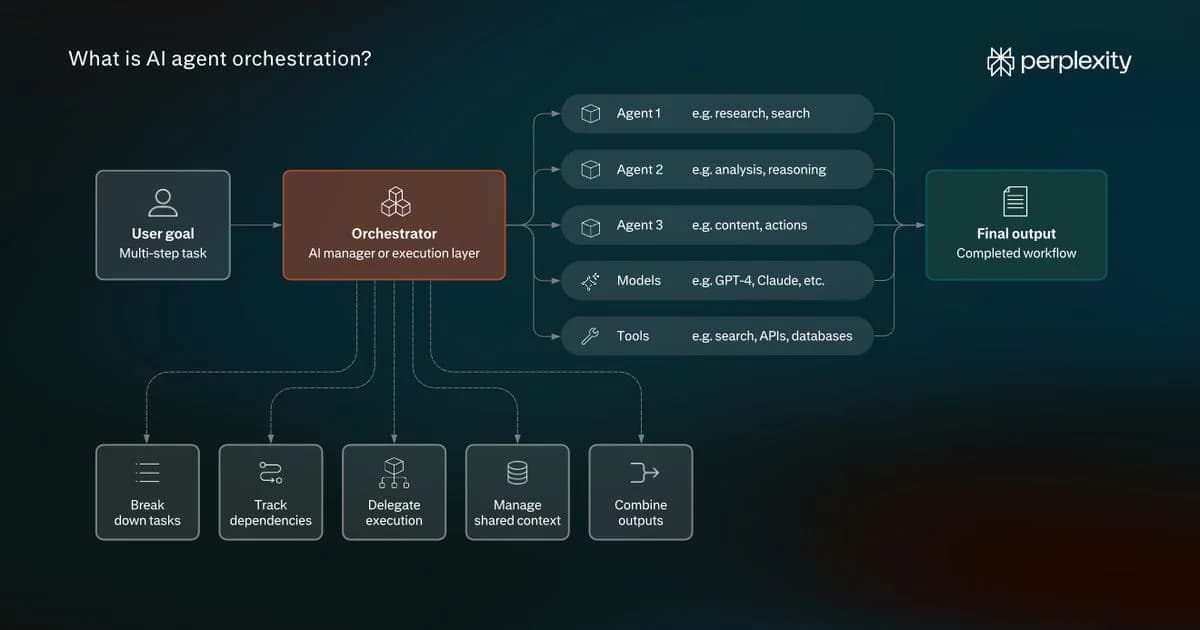
Память ИИ-ассистента и память ИИ-агента относятся к долговременной памяти. Память ассистента — это в основном семантическая память, она хранит факты о вас, чтобы ответы соответствовали вашим запросам. Память агента, такая как Brain от Perplexity, хранит информацию о том, что агент сделал и как все прошло, включая то, что сработало и что вы исправили, чтобы он начинал каждую новую задачу с более выгодной позиции.
Память ИИ-ассистента
Память ИИ-агента
Что она запоминает
Вы
Задача и ее история
Для чего она предназначена
Ответы, которые подходят именно вам
Продолжение многоэтапной работы без начала сначала
Пример
Помнит, что вы предпочитаете километры
Помнит ваш план подготовки к марафону, внесенные изменения и выполненные сессии, чтобы лучше планировать будущие этапы
Память ИИ против контекстных окон, обучающих данных и пользовательских инструкций
Память ИИ легко перепутать с тремя другими вещами, которые формируют ответ: контекстным окном модели, обучающими данными и пользовательскими инструкциями. Каждая из них содержит разную информацию, длится разное время и управляется отдельной системой.
Контекстное окно — это объем текста, который большая языковая модель (LLM) может прочитать за один раз, оно охватывает текущую беседу. Оно сбрасывается при запуске нового чата.
Некоторые современные модели имеют большие контекстные окна размером в миллион токенов и более, поэтому технически вы можете вставлять ключевую информацию в каждый разговор. Но обработка всего этого объема добавляет задержки и увеличивает стоимость.
Многочисленные исследования также показали, что точность ответов снижается по мере роста объема входных данных, даже если ответ присутствует в контексте.
Исследование Иллинойсского университета и Amazon 2025 года показало это даже тогда, когда модели могли воспроизвести каждую деталь: точность падала на 13,9–85% по мере увеличения объема входных данных до 30 000 токенов, что намного ниже заявленных лимитов моделей. Исследование Adobe Research и ЛМУ Мюнхена 2025 года показало, что 11 из 13 протестированных моделей работали значительно хуже уже при 3000 токенах, если вопрос и ответ не имели общих ключевых слов. Это явление наблюдалось у 18 моделей, в том числе при ответах на основе истории чата объемом 113 000 токенов.
Обучающие данные — это информация, заложенная в веса модели до ее выпуска. Пользователи не могут ее изменить. Разработчики могут дообучить модель на новых данных, но это инженерный процесс, а не пользовательская настройка.
Пользовательские инструкции — это правила, сохраненные в настройках ассистента, которые вы пишете и редактируете самостоятельно для настройки поведения и ответов ИИ-ассистента. Например, вы можете использовать пользовательские инструкции, чтобы задать тон и стиль ответов или определить источники, которые ассистент может использовать.
Вот как соотносятся эти четыре компонента:
Контекстное окно
Память ИИ
Обучающие данные
Пользовательские инструкции
Что она содержит
Сообщения в текущем чате
Сохраненные факты и предпочтения о вас
То, чему модель научилась до релиза
Инструкции, написанные вами самостоятельно
Как долго она хранится
Только в этом чате
До обновления или удаления
Фиксирована до выпуска новой модели
Пока вы ее не отредактируете
Кто ею управляет
Вы, в пределах лимита, установленного провайдером модели
Вы и ассистент
ИИ-компания
Вы
Пример
Вопрос о темпе, заданный минуту назад
То, что вы предпочитаете километры
Как обычно структурируются планы тренировок к марафону
Инструкция форматировать планы тренировок в виде таблицы, где строки — это недели, а столбцы — дни недели
Что хранит память ИИ
Ассистенты сохраняют отдельные данные о вас, такие как факты, предпочтения и сводки, а некоторые также используют ваши прошлые чаты.
- Факты и предпочтения, которые вы просите запомнить: это детали, которые вы явно велите ассистенту сохранить, например «запомни, что я предпочитаю километры». Ассистент создает воспоминание по вашему запросу, и оно хранится до тех пор, пока вы его не удалите или пока последующая беседа не обновит его.
- Детали, которые ИИ улавливает из ваших разговоров: ассистент сохраняет их, когда эта функция включена. Perplexity «учитывает частоту задаваемых вопросов и информации, предоставляемой пользователем», поэтому то, что вы упоминаете часто, закрепится с большей вероятностью, чем то, что было упомянуто один раз. Память сохраняется до обновления или удаления.
- Ссылки на ваши прошлые чаты: ассистент обращается к более ранним беседам напрямую, а не к сохраненному списку. В Perplexity это называется историей поиска: ваши прошлые вопросы и ответы, которые используются для того, чтобы сделать новый ответ более релевантным.
Как работает память ИИ
ИИ-модель ничего не помнит между разговорами. Эту работу выполняет система памяти ИИ: она ведет отдельную запись о вас и добавляет релевантные части в каждый новый разговор. Хранение и извлечение происходят в фоновом режиме, поэтому модель считывает их одновременно с вашим вопросом.
Этот процесс состоит из пяти шагов:
- Сохранение: ассистент сохраняет воспоминание, когда вы просите его об этом или когда он считает какую-то деталь достойной сохранения.
- Хранение: воспоминания попадают в базу данных, которая хранится отдельно от модели. Во многих системах это векторная база данных, поэтому их можно искать по смыслу. Список, который вы видите в настройках, представляет собой представление этого хранилища воспоминаний.
- Извлечение: когда вы отправляете сообщение, ассистент определяет, какие воспоминания подходят. Многие системы делают это путем преобразования вашего сообщения и каждого воспоминания в эмбеддинги — числовые представления смысла — и выбора наиболее близких совпадений. Именно так они могут вспомнить воспоминание, даже если оно не имеет общих слов с вашим вопросом. Более простые системы загружают каждое сохраненное воспоминание в каждый диалог.
- Использование: извлеченные воспоминания вставляются в виде обычного текста во входные данные, обычно в блок инструкций, который модель читает перед вашим сообщением. Модель обрабатывает их как любой другой текст в этих входных данных.
- Обновление и удаление: ассистент извлекает факты из чатов, ищет существующие воспоминания и решает, добавить ли их как новые, обновить существующее воспоминание, объединить с одним из них или удалить старое воспоминание, которое противоречит новым данным. Некоторые ассистенты добавляют к каждому воспоминанию метку времени, чтобы отличать более свежую информацию от старой.
Проблемы и риски памяти ИИ
Память ИИ призвана улучшить качество ответов, но бенчмарки показывают, что извлечение воспоминаний не всегда выводит релевантную или актуальную информацию, особенно из больших баз данных. Это также создает риски для безопасности и конфиденциальности.
Распространенные проблемы надежности и безопасности, связанные с памятью ИИ, включают:
- Неправильно примененные воспоминания: воспоминание может быть добавлено в ответ, к которому оно не имеет никакого отношения. В исследовании протестировали 18 моделей на предмет того, просачивается ли сохраненное воспоминание из одной сферы жизни в ответ из другой. Средний показатель сбоев составил 53%. Исследование также показало, что как только память фиксировала убеждения пользователей или их предполагаемую экспертность, практически каждая модель повторяла их, даже если вопрос требовал нейтрального ответа.
- Устаревшие воспоминания: ассистент продолжает руководствоваться детальней после того, как более поздний разговор сделал ее неверной, особенно если вы никогда не говорили об этом прямо. В одном из исследований, в котором проверялось, замечают ли модели такие неявные изменения, лучший результат у модели составил в среднем 55,2%.
- Перегрузка памяти: чем большему количеству информации ассистент должен следовать, тем сложнее выделить то, что действительно важно. В исследовании 2024 года обнаружилось, что модели, читающие историю чата размером около 115 000 токенов, справлялись на 30–60% хуже, чем модели, которым предоставлялись только релевантные сеансы.
- Отравление памяти: ложная информация или скрытые инструкции попадают в память ассистента, например, через контент, который вы просите его прочитать, что приводит к предвзятым или небезопасным ответам либо утечкам данных.
- Риски конфиденциальности: память сохраняет личные данные за пределами чата, в котором они появились, иногда дольше, чем вы ожидаете. Например, Perplexity может хранить журнал удаленных воспоминаний до 30 дней в целях безопасности и отладки. Законодательство о защите данных рассматривает сохраненные воспоминания как персональные данные, поэтому у вас должна быть возможность просматривать и удалять их.
Как просматривать, редактировать и отключать память ИИ
Вы можете посмотреть, что сохранил ассистент, удалить это, отключить память или использовать приватный чат, который не создает воспоминаний.
Управление памятью сводится к нескольким элементам управления. Вот за что отвечает каждый из них и когда его использовать:
Элемент управления
Что он делает
Когда его использовать
Посмотреть сохраненное
Открывает ваш банк памяти, где вы можете искать, фильтровать и просматривать отдельные записи.
Когда в ответе содержится неожиданная деталь.
Удалить воспоминание
Удаляет запись, и ассистент перестает использовать ее в последующих ответах (ассистенты могут сохранять журнал очищенных воспоминаний в течение определенного периода времени).
Когда воспоминание неверно, устарело или содержит конфиденциальные данные.
Отключить память
Запрещает ассистенту ссылаться на память в будущих ответах (это может не очистить уже сохраненные воспоминания — проверьте настройки вашего ассистента).
Когда вам нужны ответы без персональной настройки
Отключить историю поиска
Запрещает ассистенту использовать ваши прошлые вопросы и ответы. Удаление сеанса из истории поиска стирает его влияние на последующие ответы.
Когда прошлые разговоры влияют на ответы, а вы хотите начать все сначала.
Использовать режим инкогнито
Память и история поиска всегда отключены, а заданные в этом режиме вопросы никогда не сохраняются и не используются в памяти.
Для разовых или конфиденциальных тем.
Для полной очистки отключите память и сотрите сохраненные данные.
Как Perplexity работает с памятью
Память Perplexity работает во всех предлагаемых ею моделях.
Perplexity персонализирует ответы на основе двух источников: воспоминаний (предпочтений и деталей, которыми вы делитесь) и вашей истории поиска. Когда воспоминание формирует ответ, оно появляется среди источников этого ответа, поэтому вы можете увидеть, какие воспоминания использовались, и удалить любое из них.
Вы также можете персонализировать свои ответы, предоставив информацию о себе и задав пользовательские инструкции для Проектов (у каждого Проекта есть свой собственный уровень памяти).
Perplexity может использовать содержимое памяти для улучшения своих моделей в потребительских аккаунтах (но никогда в корпоративных Enterprise-аккаунтах), если вы не отключите эту функцию («Хранение данных ИИ» в разделе Настройки → Предпочтения → Искусственный интеллект).
Подписчики Max и Enterprise Max также получают Brain — общий уровень памяти, который дополняет память, отслеживая ваши проекты и работу. У него есть собственный переключатель, и он игнорирует сеансы инкогнито.
Попробуйте Perplexity и проверьте, как воспоминания влияют на ваш следующий ответ.
Часто задаваемые вопросы о памяти ИИ
Что такое ограниченная память в ИИ?
IBM определяет ограниченную память в ИИ как способность ИИ вспоминать прошлые события и результаты, а также отслеживать ситуации с течением времени, но без возможности сохранять эти данные в долгосрочной библиотеке прошлого опыта. Это одна из четырех категорий в таксономии систем ИИ, и IBM относит к ней чат-ботов и виртуальных ассистентов.
Память ассистента — это внешняя память, которую такие системы добавляют поверх основного функционала. Она сохраняется между сеансами, поэтому ассистент может использовать детали, которыми вы поделились в предыдущем разговоре.
У какого ИИ-ассистента лучшая память?
Нет единого ассистента, который был бы лучшим для всех. Хорошая память — это та, которую вы можете контролировать, поэтому оценивайте инструменты ИИ, задавая четыре вопроса: можете ли вы видеть, что он сохранил? Можете ли вы удалить воспоминание отдельно от чата, в котором оно появилось? Является ли обучение отдельной настройкой от памяти? Есть ли временный режим или режим инкогнито, который не создает никаких воспоминаний?
Учится ли модель ИИ на том, что она помнит о вас?
Использование памяти в ответе — это процесс, отличный от обучения. Perplexity заявляет, что извлекает релевантный контекст из вашего хранилища воспоминаний, а не рассматривает вашу историю как обучающие данные. Возможность использования вашего контента для улучшения моделей — это отдельная настройка. В потребительских аккаунтах Perplexity может использовать содержимое памяти для этой цели, а параметр «Хранение данных ИИ» отключает ее.
Что не следует доверять памяти ИИ?
Не сохраняйте в памяти ИИ ничего из того, что вы не хотели бы хранить, использовать для составления вашего профиля или повторять в будущем: личные и финансовые данные, информацию о здоровье, пароли, информацию о других людях и любые данные о детях. Управление комиссара по информации Канады (май 2025 г.) и Национальный центр кибербезопасности Великобритании (март 2023 г.) рекомендуют избегать любых промптов, которые могут создать проблемы в случае их публичной огласки.
Фильтры снижают риски для конфиденциальности, но не гарантируют, что ваша медицинская или финансовая информация не будет сохранена вообще, поэтому проверяйте свой банк памяти и используйте режим инкогнито для единичных конфиденциальных вопросов.